Hello大家好!很高兴我们又见面啦!给生活添点passion,开始今天的编程之路!
我的博客: <但凡.
我的专栏: 《编程之路》、《数据结构与算法之美》、《C++修炼之路》、《Linux修炼:终端之内 洞悉真理》、《Git 完全手册:从入门到团队协作实战》
感谢您打开这篇博客!希望这篇博客能为您带来帮助,也欢迎一起交流探讨,共同成长。

目录
1、实现myshell的重定向功能
我们丰富以下myshell的功能,使他能够支持重定向。
我们定义四个宏,分别表示没有重定向,输出重定向,追加重定向,输入重定向。
#define NONE_REDIR 0
#define OUPUT_REDIR 1
#define APPEND_REDIR 2
#define INPUT_REDIR 3
在我们创建子进程并执行代码的过程中,如果检测到没有实现重定向,那就继续之前的操作。
我们定义两个全局变量,表示重定向后的文件名以及是否重定向的状态标识:
std::string filename;
int redir_type=NONE_REDIR;
接着我们实现主要的部分,检测是否实现重定向的函数:
void CheckRedir(char cmd[])
{
  char* start=cmd;
  char* end=cmd+strlen(cmd)-1;

  redir_type = NONE_REDIR;

  while(start<=end)
  {
    if(*start=='>')
    {
      //追加重定向
      if(*(start+1)=='>')
      {
        //追加重定向
        redir_type=APPEND_REDIR;
        *start='\0';
        start+=2;
        TrimSpace(start);
        filename=start;
        break;
      }
      else{
        *start='\0';
        start++;
        redir_type=OUPUT_REDIR;
        TrimSpace(start);//移除空格
        filename=start;
        break;
      }
    }
    else if(*start=='<')
    {
      //输入重定向
      redir_type=INPUT_REDIR;
      *start='\0';
      start++;
      TrimSpace(start);
      filename=start;
      break;
    }
    else{
      start++;
    }
  }
}
我们用start指针,在指令中查找'<'和'>'符号。如果找到'<'符号以后,还得继续判断是否是追加重定向。
当设定好状态后,我们需要清除>或<符号与文件名之间的空格。我们使用一个宏来实现:
#define TrimSpace(start) do{\
  while(isspace(*start))\
  {\
    start++;\
  }\
}while(0)//在宏定义中安全的包装多条语句其中,do while(0)是为了安全的包装多条语句,尽管看起来循环只执行一次,但其核心目的并非循环,而是利用 do-while 的语法特性。
避免宏展开时的语法错误
**在宏定义中使用多行代码时,直接换行可能导致语法问题。**例如:
c
#define MACRO() \
    statement1; \
    statement2;
如果这样使用:
c
if (cond)
    MACRO();
实际展开为:
c
if (cond)
    statement1;
    statement2; // 无论 cond 是否成立,statement2 都会执行,即statement2脱离了if的控制
用 do while(0) 包裹后:
c
#define MACRO() \
    do { \
        statement1; \
        statement2; \
    } while(0)
展开为:
c
if (cond)
    do { statement1; statement2; } while(0); // 完全符合预期
强制分号结尾
do while(0) 要求必须以分号结尾,即使调用时忘记写分号,编译器也会报错。例如:
c
#define MACRO() do { } while(0)
MACRO() // 漏写分号会报错
兼容性
do while(0) 是 C/C++ 中唯一能同时满足以下条件的结构:
- 允许包含多条语句。
- 在任意位置(如
if、else后)展开时不会引入语法错误。- 不会改变程序逻辑(
while(0)保证只执行一次)。
实际应用场景
- 宏定义中的多行代码:常见于日志打印、资源释放等操作。
- 条件语句中的代码块 :确保宏在
if-else中展开后逻辑正确。 - 避免空宏的警告 :用
do { } while(0)替代空宏可避免编译器警告。
需要注意,每次执行检测函数我们都需要将重定向标识符设置成NONE_REDIR。
当我们处理好重定向的判断后,接下来需要完善一下命令的执行:
void ForkAndExec()
{
  pid_t id=fork();
  if(id<0)
  {
    perror("fork");//讲解
    return;
  }
  else if(id==0)
  {
    //子进程
    int fd=0;
    if(redir_type==OUPUT_REDIR)
    {
      fd=open(filename.c_str(),O_CREAT|O_WRONLY|O_TRUNC,0666);
      (void)fd;//显示丢弃值,即告诉编译器我故意不使用这个值,不是强制类型转换,output仍然是int类型。
      dup2(fd,1);
    }
    else if(redir_type==INPUT_REDIR)
    {
      fd=open(filename.c_str(),O_RDONLY);
      (void)fd;
      dup2(fd,0);
    }
    else if(redir_type==APPEND_REDIR)
    {
      fd=open(filename.c_str(),O_CREAT|O_WRONLY|O_APPEND);
      (void)fd;
      dup2(fd,1);
    }
    else{
      //DO Nothing
    }


    execvp(gargv[0],gargv);


    exit(0);
  }
  else{
    //父进程等待子进程
    int status=0;
    pid_t rid=waitpid(id,&status,0);
    if(rid>0)
    {
       lastcode=WEXITSTATUS(status);
    }
  }
}
```
当id==0即子进程创建成功时,子进程要根据重定向标识符的状态去判断自己要执行哪些代码。
#include"myshell.h"

#define SIZE 1024

int main()
{
  char commandstr[SIZE];
  while(true)
  {
    //初始化操作
    InitGlobal();
    //输出命令行提示符
    PrintfCommandPrompt();

    //获取用户输入的命令
    if(!GetCommandString(commandstr,SIZE))
      continue;

    CheckRedir(commandstr);
    //解析命令
    ParseCommandString(commandstr);

    //如果是内建命令(如cd)要让shell自己执行
    if(BuiltInCommandExec())
    {
      continue;
    }
    //执行命令
    ForkAndExec();
  }
}
2、理解一切皆文件
通过之前的学习我们知道了,**标准输入,标准输出,都是文件,这些文件对于操作系统来说和在磁盘中存储的文件没什么两样。**那么输入输出的设备呢?显卡,显示器,键盘,网卡...这些看得见摸得着的设备对于操作系统来说是怎么抽象成文件的?
**依照先描述再组织的原则,再操作系统的内部,同样存在着描述各个硬件的数据结构,我们叫做struct device。在这个结构体内部,肯定包含着这个设备的属性,状态...这些结构体之间同样通过双链表进行连接。**但是对于系统来说,每个硬件的访问方式都是不一样的。那么是不是在每个描述硬件的文件中,也包含着不同的访问方式呢?
在Linux中,打开文件,创建struct file,包含三个核心:
1、文件属性,2、文件内和缓冲区,3、底层设备的文件操作表。
假设现在我们新建一个进程,这个进程通过files_struct里的文件操作符表访问到各个硬件的struct file,在struct file中保存着硬件的属性,文件内核缓冲区,和底层设备的文件操作表**。在文件操作表这个结构体(struct file_operations)中,存储着连接底层硬件访问接口的函数指针,而这些函数指针呢,又各自指向了由驱动程序提供的访问方法** 。对于这个进程来说,如果他想访问显示器,它只需要调用struct file中存储的void (*write)()函数指针,他并不关心底层的访问接口到底是什么样子的。我们把给进程封装的文件视角叫做虚拟文件系统,简称VFS。
当然,函数指针的数量,类型,以及底层硬件的访问方式很多,很复杂,不是一句两句能说清的,我们只是从大体上知道,进程到底是怎么访问硬件的。
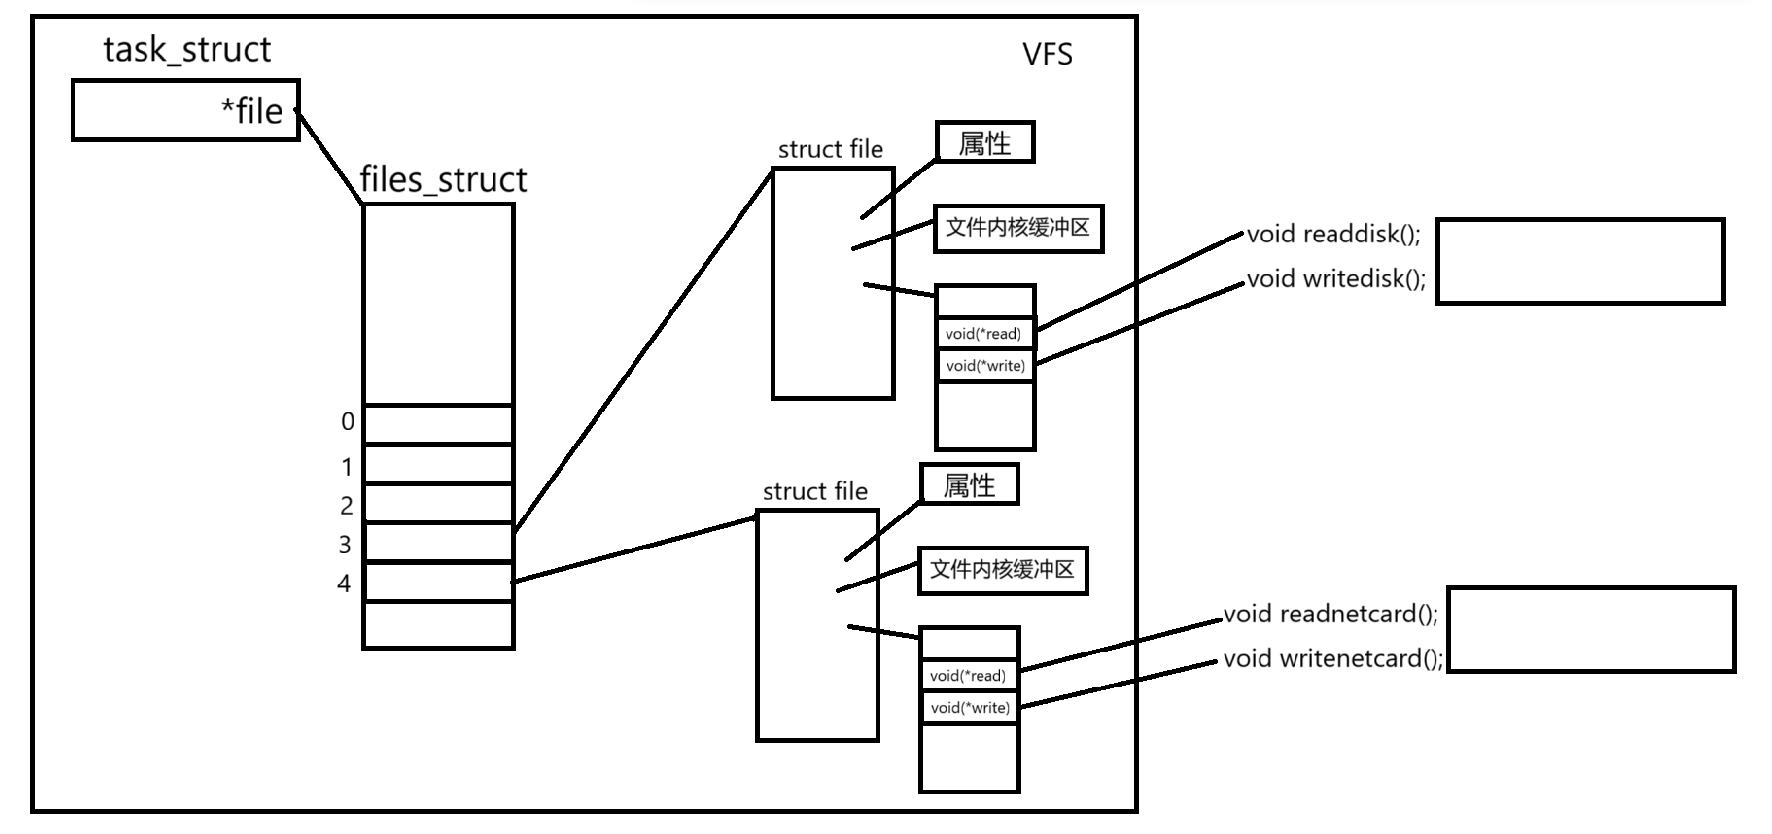
这种通过调用同样的接口,但是实现不同的效果,类似于我们在C++阶段学习的多态。
基于这种"一切皆文件"的管理方式,开发者仅需要一套API和开发工具,即可调取Linux系统中绝大部分的资源。几乎所有的读操作都可以用read来实现,几乎所有的写操作都可以用write来进行,极大的方便了开发者。
3、缓冲区
3.1、缓冲区的意义及刷新策略
**缓存的意义就是提高使用缓存的进程的效率。使用缓存的进程可以在单位时间内做更多工作,变相的提高了进程的效率。**比如说,向显示器输出一百个字符,先将一百个字符都存放在缓冲区中,一次性向显示器文件输出一百个字符,是要比连续一百次,每次向显示器文件中输出一个字符要省时间的。
并且,通过缓冲区,我们可以实现批量化处理数据,可以减少IO的次数,从而提高效率。
那么缓冲区什么时候刷新呢?有以下三种刷新策略:
1、无缓冲,立即刷新
2、有缓冲,行刷新(显示器中使用)
3、优化冲,写满再刷新(普通文件使用)
在进程退出时,会主动刷新缓存,除此之外,用户还能用过fflush强制刷新缓冲区。
3.2、语言级缓冲区
执行以下代码,我们发现字符串不会立刻打印出来,而是三秒之后再打印:
#include<stdio.h>
#include<unistd.h>

int main()
{
  printf("这是一个字符串");
  sleep(3);

  return 0;
}
在这三秒之中,这个字符串是存放在我们的缓冲区的,并且是语言级别的缓冲区空间。 这个语言级的缓冲区空间存放在struct FILE这个结构体中 ,也就是说,这个结构体内部除了文件描述符fd,还有语言级的输入缓冲区和输出缓冲区。需要注意,这个FILE是属于用户层的,而之前我们介绍的struct file是在内核中的。
也就是说,**缓冲区也分语言级缓冲区和内核文件缓冲区。**当我们想在文件中写入一串字符串是,首先进程打开文件,创建出FILE结构体,接着将文本写入FILE结构体里的语言级缓冲区。语言级缓冲区刷新之后,把这串字符串交给内核文件缓冲区,最后,操作系统自己决定什么时候刷新内核文件缓冲区,把字符串输出到磁盘中。
所以说,**我们在学习系统之前所说的缓冲区,都是语言级的缓冲区。**这个缓冲区就在FILE内部。而上面的例子中,我们的字符串存储在stdout指向的FILE内部的缓冲区,stdout是FILE*类型的。
那么为什么要有语言级的缓冲区呢 ?首先,系统调用是由成本的,很浪费时间,先加载到语言级缓存区中,再批量加载到内核文件缓冲区中,会减少很多次系统调用 。其次,C语言提供语言级别缓冲区,可以**提高IO函数的调用效率,**比如printf,如果我们每次调用printf是先把内容放到缓冲区,那么这时候printf就可以立即返回,继续执行下一行代码,从而提高单位时间内代码执行的行数。
现在再重新看一下我们格式化输出的过程,首先printf会把输出的内容进行格式化,接着把格式化后的内容写入到FILE的缓冲区中,然后检测是否需要刷新缓冲区,如果需要,调用系统接口write。
我们执行以下的代码,发现什么都没有输出:
#include<stdio.h>
#include<unistd.h>
#include<sys/types.h>
#include<fcntl.h>
#include<sys/stat.h>

int main()
{
  close(1);
  int fd=open("log.txt",O_CREAT|O_WRONLY|O_TRUNC,0666);

  printf("文本");

  close(fd);
  return 0;
}
这是因为,在我们关闭文件之前并没有刷新缓冲区,导致文本一直在缓冲区中存放着,我们需要手动刷新缓冲区。**close不会自动刷新缓冲区,而fclose会自动刷新缓冲区。**我们需要手动调用fflush刷新stdout,强制刷新缓冲区:
#include<stdio.h>
#include<unistd.h>
#include<sys/types.h>
#include<fcntl.h>
#include<sys/stat.h>

int main()
{
  close(1);
  int fd=open("log.txt",O_CREAT|O_WRONLY|O_TRUNC,0666);

  printf("文本");

  fflush(stdout);
  close(fd);

  return 0;
}
需要注意的是,在这使用\n是无法刷新缓冲区的。当输出到终端(如显示器)上时,默认是行缓冲模式,即遇到\n或者缓冲区满会刷新,而输出到普通文件时,默认模式为全缓冲模式,只有缓冲区满才会刷新,所以我们只能调用fflush强制刷新。
在C++中,cin,cout,cerr这三个类中同样包含了语言级缓冲区和fd。
我们执行以下代码:
#include<stdio.h>
#include<unistd.h>
#include<sys/types.h>
#include<fcntl.h>
#include<sys/stat.h>
#include<string.h>


int main()
{
  const char* s1="文本\n";
  printf(s1);

  const char* s2="文本2\n";
  fprintf(stdout,s2);

  const char* s3="文本3\n";
  fwrite(s3,strlen(s3),1,stdout);

  const char* s4="文本4\n";
  write(1,s4,strlen(s4));

  fork();
  return 0;
}
当我们把这个程序的输出结果重定向到一个普通文本文件中,发现打印结果如下:
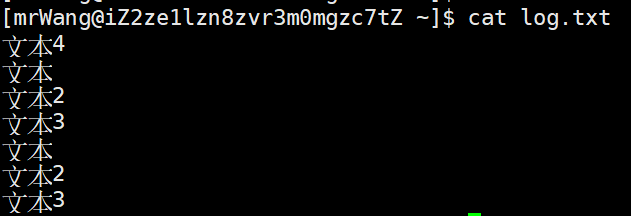
接下来我来解释一下这个现象。首先,由于我们重定向到了一个普通文件,缓冲区刷新模式会被隐式的转变成了全刷新。所以我们代码从上往下执行,文本123都被存放在了缓冲区,而文本4由于是系统调用,我们执行他,他会直接输出到文件中。接着,我们创建子进程,但是子进程不会执行任何操作。子进程会继承下来父进程的缓冲区内容,但是父子进程对于缓冲区的修改是独立的。所以说当父子进程结束的时候,父子进程都会刷新缓冲区,把缓冲区中的内容输出到文件中。
3.3、内核文件缓冲区
内核文件缓冲区的内容,可以通过fsync接口强制的刷新到外部硬件中:
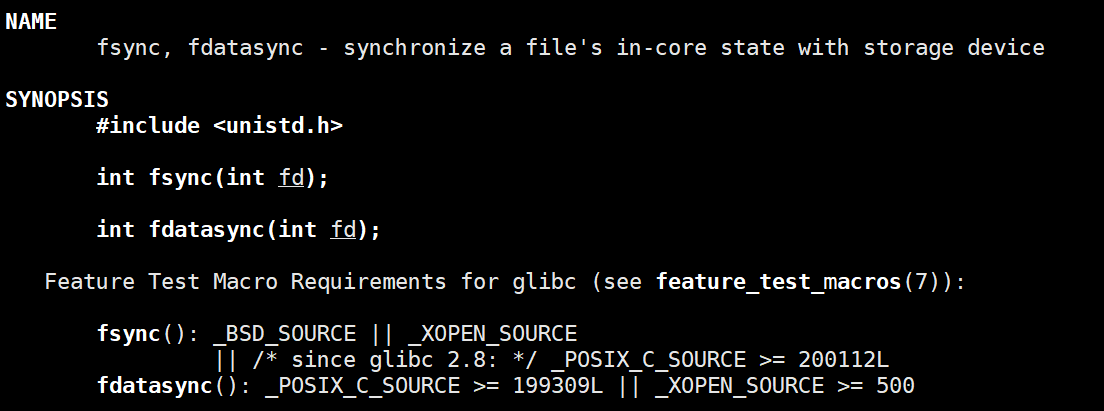
当然了这个接口一般不需要我们自己去调用,因为内核文件缓冲区是由操作系统来管理的。但是我们也可以通过这个接口,强制的把内核文件缓冲区的内容刷新到外部硬件。fflush由用户到内核,fsync由内核到外设。
3.4、总结
缓冲区是内存空间的一部分,这部分空间用来缓冲输入或输出的数据。缓冲区根据其对应的是输入设备还是输出设备分为输入缓冲区和输出缓冲区。
由于语言级缓冲区的存在,减少了磁盘的读写次数,计算机对于缓冲区的操作速度也大大快于磁盘的操作,所以缓冲区的存在可以极大的提高IO的效率。
4、标准错误
**标准错误(Standard Error,简称 stderr)是计算机系统中用于输出错误信息或诊断消息的标准数据流。**与标准输出(stdout)不同,标准错误专门用于传递程序运行时的错误或警告信息,通常默认输出到终端或日志文件。
也就是说,尽管标准错误和标准输出最后都打印到显示器,但是其实他们之间是分离的。而这个分离,也极大的方便了程序员做重定向的工作。
现在,我们执行以下代码,并把标准输出和标准错误重定向到两个不同的文件:
#include<iostream>
#include<stdio.h>

using namespace std;

int main()
{

  printf("文本1\n");
  perror("错误1");

  cout<<"文本2"<<endl;
  cerr<<"错误2"<<endl;

  return 0;
}
执行以下命令以重定向:
./test 1>log.txt 2>log1.txt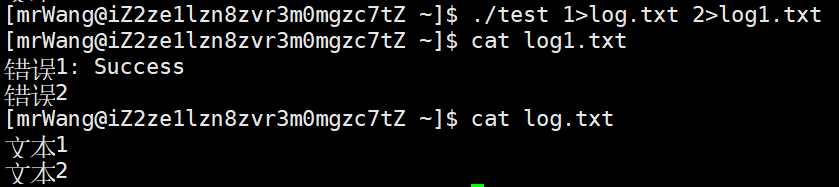
其实之前使用重定向时我们都省略了1,完整的写法应该是./test 1>log.txt。
5、模拟实现简易C标准库文件操作
首先我们还是三个文件,mystdio.h,mystdio.c,main.c。
mystdio.h:
mystdio.h中声明几个文件操作的函数,并且定义好MyFILE结构体,这个结构体中包含缓存区(outbuffer),指向缓存区最后一个字符下标的变量(curr),标识缓存区大小的变量(cap),标识刷新模式的变量(flag),文件描述符(fileno)。
#ifndef __MYSTDIO_H__
#define __MYSTDIO_H__

#define FLUSH_NONE 1
#define FLUSH_LINE 2
#define FLUSH_FULL 4

#define SIZE 4096
#define UMASK 0666

#define FORCE 1
#define NORMAL 2
typedef struct _MY_IO_FILE
{
  int fileno;
  int flag;
  char outbuffer[SIZE];
  int curr;
  int cap;
}MyFILE;

MyFILE * my_fopen(const char* filename,const char* mode);
void my_fclose(MyFILE* fp);
int my_fwrite(const char* s,int size,MyFILE* fp);
void my_fflush(MyFILE* fp);
#endif
mystdio.c:
这个文件中实现了各个函数:
#include"mystdio.h"
#include<stdlib.h>
#include<string.h>
#include<sys/types.h>
#include<sys/stat.h>
#include<fcntl.h>
#include<unistd.h>

MyFILE* my_fopen(const char* filename,const char* mode)
{
  int fd=-1;
  if(strcmp(mode,"w")==0)
  {
    fd=open(filename,O_CREAT|O_WRONLY|O_TRUNC,UMASK);
  }
  else if(strcmp(mode,"r")==0)
  {
    fd=open(filename,O_RDONLY);
  }
  else if(strcmp(mode,"a")==0)
  {
    fd=open(filename,O_CREAT|O_WRONLY|O_APPEND,UMASK);
  }
  else if(strcmp(mode,"a+")==0)
  {
    fd=open(filename,O_CREAT|O_RDWR|O_APPEND,UMASK);
  }
  else{

  }

  if(fd<0)
  {
    return NULL;
  }
  MyFILE* fp=(MyFILE*)malloc(sizeof(MyFILE));
  if(!fp)
  {
    return NULL;
  }

  fp->fileno=fd;
  fp->flag=FLUSH_LINE;
  fp->curr=0;
  fp->cap=SIZE;
  fp->outbuffer[0]=0;

  return fp;
}


static void my_fflush_core(MyFILE* fp,int force)
{
  if(fp->curr<=0)
  {
    return ;
  }

  if(force==FORCE)
  {

      write(fp->fileno,fp->outbuffer,fp->curr);
      fp->curr=0;
  }
  else{
    if((fp->flag&FLUSH_LINE)&&fp->outbuffer[fp->curr-1]=='\n')
    {
      write(fp->fileno,fp->outbuffer,fp->curr);
      fp->curr=0;
    }
    else if((fp->flag&FLUSH_FULL)&&fp->curr==fp->cap)
    {
      write(fp->fileno,fp->outbuffer,fp->curr);
      fp->curr=0;
    }
    else{

    }
  }

}

void my_fflush(MyFILE* fp)
{
  my_fflush_core(fp,NORMAL);
}

int my_fwrite(const char* s,int size,MyFILE* fp)
{
  memcpy(fp->outbuffer+fp->curr,s,size);
  fp->curr+=size;
  my_fflush(fp);
  return size;
}

void my_fclose(MyFILE* fp)
{
  if(fp->fileno>=0)
  {
    my_fflush(fp);
    fsync(fp->fileno);//fclose会刷新用户缓冲区到内核文件缓冲区
    close(fp->fileno);
    free(fp);
  }
}
main.c:
这个文件中包含了主要的程序,我们打开一个文件,并往其中打印20行文本。
#include"mystdio.h"
#include<string.h>
#include<unistd.h>

int main()
{
  MyFILE* fp=my_fopen("log.txt","w");
  if(fp==NULL)
  {
    return 1;
  }

  const char* s="hello myfile\n";
  int cnt=20;
  while(cnt--)
  {
    my_fwrite(s,strlen(s),fp);
    sleep(1);
  }
  my_fclose(fp);

  return 0;
}
通过简易文件操作的模拟实现,我们可以学习到,C语言中的文件操作,无非就是对底层系统调用做了封装,并加入了语言级缓冲区。并且,我们还学习到了,进程是如何找到被打开的文件的,写入文件时进程都做了哪些操作。
好了,今天的内容就分享到这,我们下期再见!