概念
是一种分类和回归方法,是基于各种情况发生的所需条件构成决策树
问题是:当目标数据的特征较多时,构建的具有不同规则的决策树也相当庞大,那么该如何判断哪种决策树更好呢
一种思路是:如果按照某个特征对数据进行划分时,它能最大程度地将原本混乱的结果尽可能划分为几个有序的大类,则就应该先以这个特征为决策树中的根结点。接着,不断重复这一过程,直到整棵决策树被构建完成为止。
由此引入"熵"
熵
熵(Entropy)是表示随机变量不确定性的度量。说简单点就是物体内部的混乱程度。
熵越大,混乱程度越大。
在决策树中,目标是在某个特征在被用于分类后,能最大程度地降低样本数据的熵。
划分选择
决定如何使得决策树各分支结点所包含的样本尽可能属于同一类别
信息增益
某特征 𝑋 使得整体的熵减少程度
例子:集合 𝐷 的熵 𝐻(𝐷) = 0.6931 ,特征 "天气"、"温度"、"风速"、"湿度" 的条件熵分别为 𝐻(D | X天气) = 0.3961 、𝐻(D | X温度) = 0.6931、𝐻(D | X风速) = 0.5983、𝐻(D | X湿度) = 0.6315。
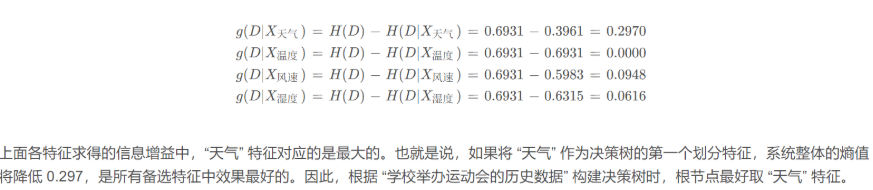
应用:ID3 算法用此评估标准
信息增益率
信息增益 𝑔(𝐷, 𝑋) 与数据集 𝐷 在特征 𝑋 上值的熵 𝐻𝑋(𝐷) 之比,可以降低了 "偏向取值较多的特征" 这一影响
应用:C4.5 算法选用的评估标准
基尼系数
基尼系数评估了数据集的不纯度,其取值越小表示不纯度越低。
由于基尼系数Gini(D) 表示集合 D 的不确定性,则基尼系数Gini(D,X) 表示 "基于指定特征 X 进行划分后,集合 𝐷 的不确定性"。该值越大,就表示数据集 D 的不确定性越大,也就说明以该特征进行划分越容易分乱。
应用: CART(分类回归树) 算法选用的评估标准
决策树中的连续值处理
连续性数值如何转变成离散化
-
按某些属性分区(eg:温度的一个范围为一个区间)
-
对原数据进行排序,再取任意相邻值的中位点作为划分点
决策树中的预剪枝
将所有数据全部区分开会,导致决策树的过拟合风险非常大
-
限制树的深度
-
叶子结点个数
-
叶子结点含样本数