1.准备工作,必须安装jdk,zookeeper可以不安装,高版本不用安装
2.下载kafka
wget https://downloads.apache.org/kafka/3.8.0/kafka_2.13-3.8.0.tgz
3.修改配置文件
tailweb@hadoop2 kafka$ cd config/
tailweb@hadoop2 config$ vi server.properties
修改内容
#broker 的全局唯一编号,不能重复,只能是数字。
broker.id=0
#处理网络请求的线程数量
num.network.threads=3
#用来处理磁盘 IO 的线程数量
num.io.threads=8
#发送套接字的缓冲区大小
socket.send.buffer.bytes=102400
#接收套接字的缓冲区大小
socket.receive.buffer.bytes=102400
#请求套接字的缓冲区大小
socket.request.max.bytes=104857600
#kafka 运行日志(数据)存放的路径,路径不需要提前创建,kafka 自动帮你创建,可以
配置多个磁盘路径,路径与路径之间可以用","分隔
log.dirs=/opt/module/kafka/datas
#topic 在当前 broker 上的分区个数
num.partitions=1
#用来恢复和清理 data 下数据的线程数量
num.recovery.threads.per.data.dir=1
# 每个 topic 创建时的副本数,默认时 1 个副本
offsets.topic.replication.factor=1
#segment 文件保留的最长时间,超时将被删除
log.retention.hours=168
#每个 segment 文件的大小,默认最大 1G
log.segment.bytes=1073741824
# 检查过期数据的时间,默认 5 分钟检查一次是否数据过期
log.retention.check.interval.ms=300000
#配置连接 Zookeeper 集群地址(在 zk 根目录下创建/kafka,方便管理)
zookeeper.connect=hadoop102:2181,hadoop103:2181,hadoop104:2181/kafka   # 没有集成zookeeper不用写
4.分发到不同的服务器
broker.id=1、broker.id=2
注:broker.id 不得重复,整个集群中唯一。每台服务器的broker.id不同
5.配置环境变量
sudo vim /etc/profile.d/my_env.sh
增加内容
#KAFKA_HOME
export KAFKA_HOME=/opt/module/kafka
export PATH=$PATH:$KAFKA_HOME/bin
6.刷新环境变量
source /etc/profile
第5步跟6步每台服务器都要进行操作
7.启动服务器,如果没有集成zookeeper不用启动zookeeper,集成了必须要启动。
[tailweb@hadoop3 kafka]$ bin/kafka-server-start.sh -daemon config/server.properties
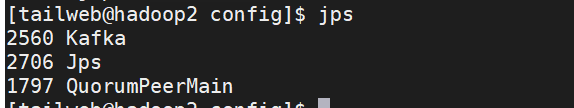
8.查看是否启动成功
9.查看日志
tail -f logs/server.log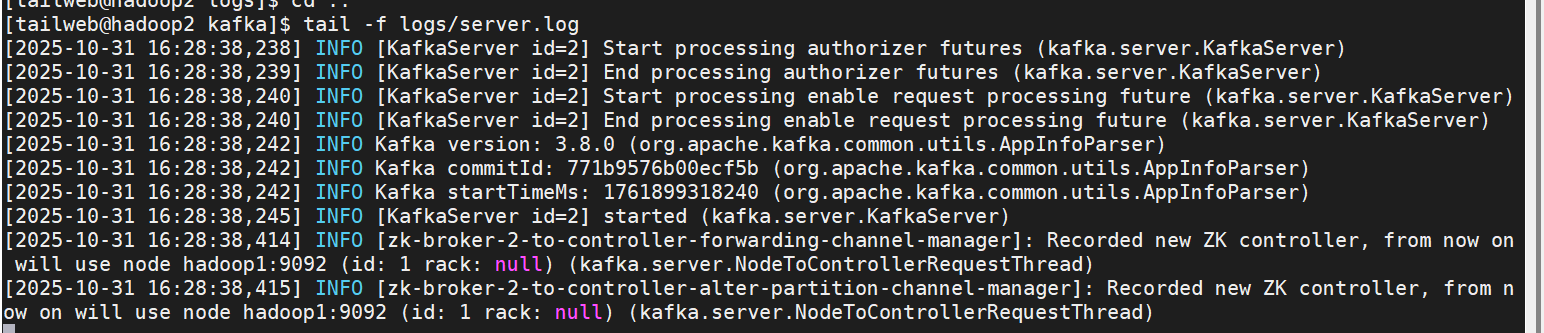
10.集群启动脚本
在当前用户下面
cd /home/tailweb/bin/
vim kf.sh
#! /bin/bash
case $1 in
"start"){
        for i in hadoop1 hadoop2 hadoop3
        do
           echo " --------启动 $i Kafka-------"
       ssh $i "/data/software/kafka/bin/kafka-server-start.sh -daemon /data/software/kafka/config/server.properties"
        done
};;
"stop"){
        for i in hadoop1 hadoop2 hadoop3
        do
        echo " --------停止 $i Kafka-------"
        ssh $i "/data/software/kafka/bin/kafka-server-stop.sh "
        done
};;
esac
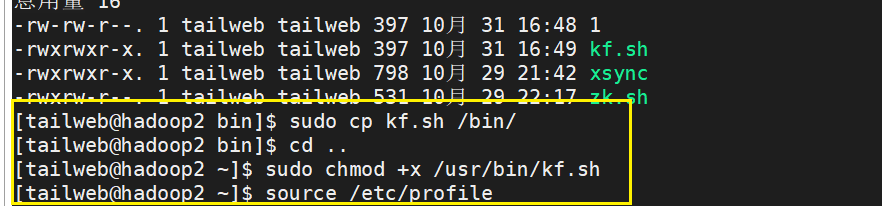
对脚本进行授权