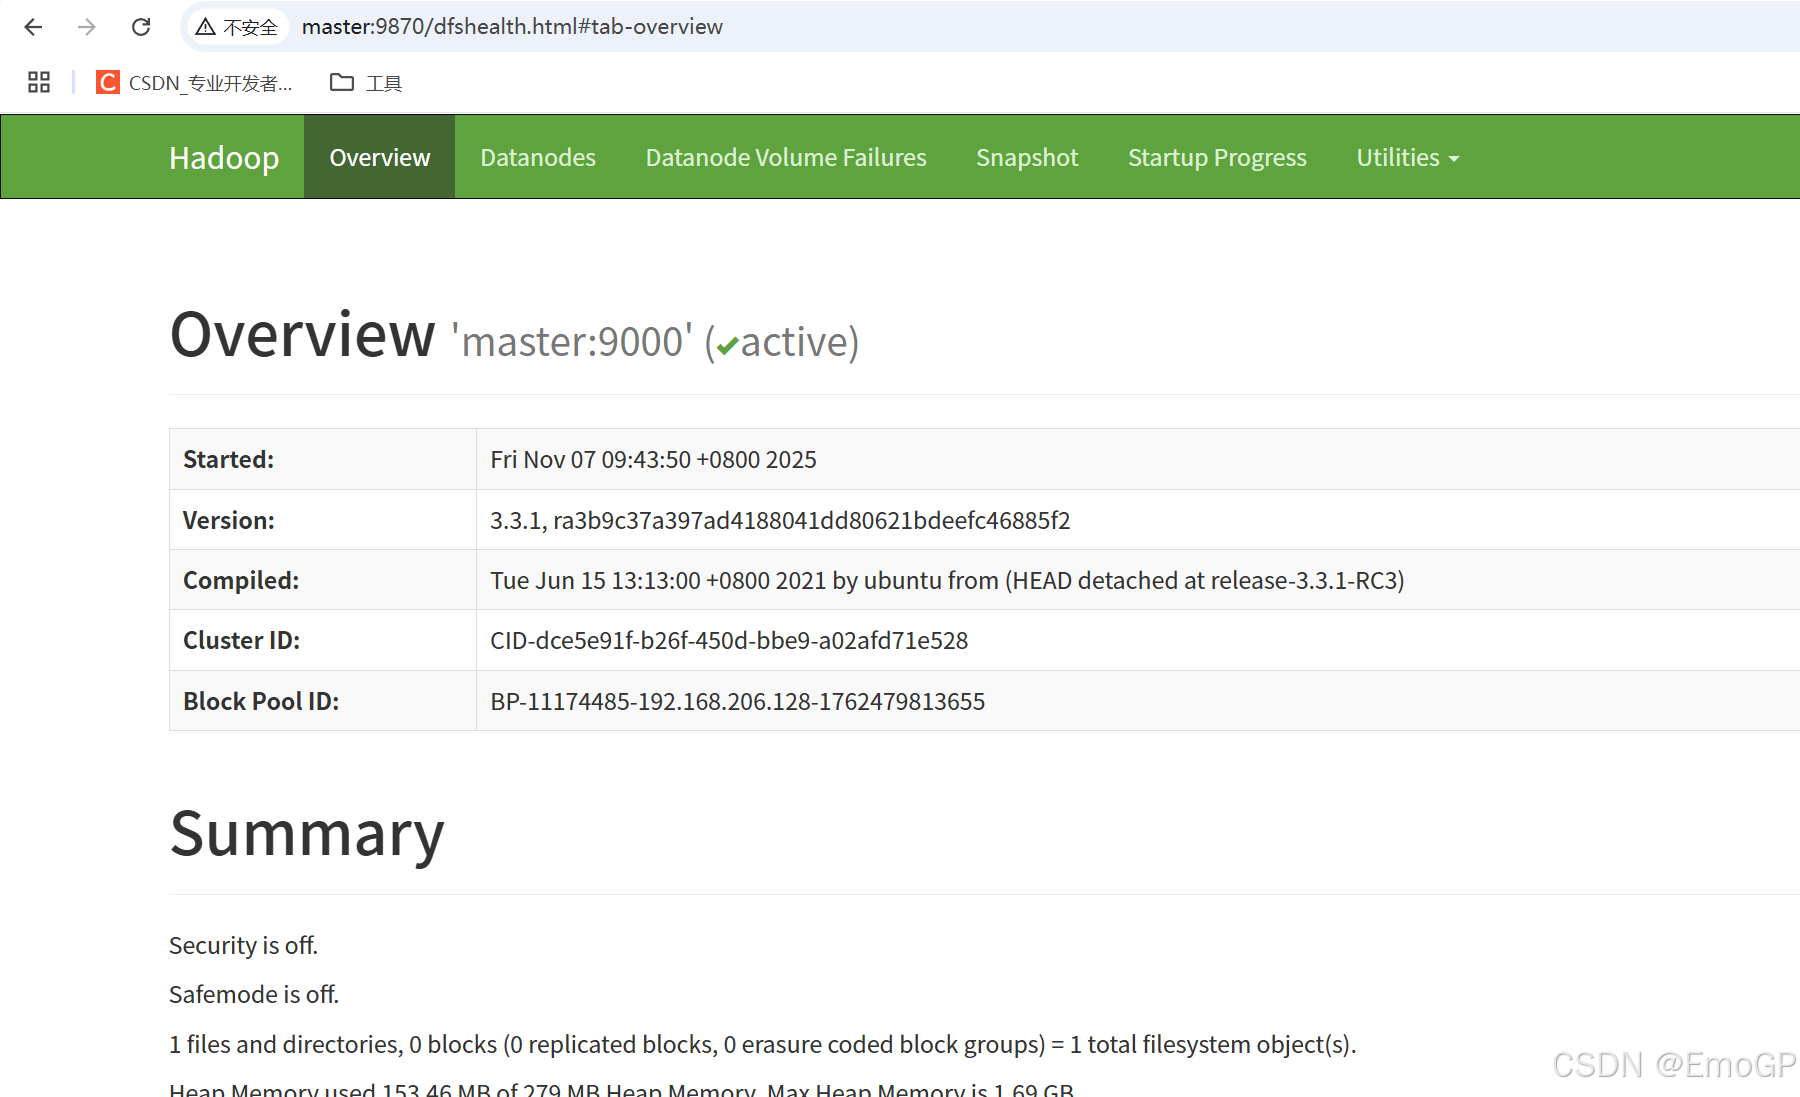
目录
- [1 主机映射](#1 主机映射)
- [2 免密](#2 免密)
- [3 防火墙](#3 防火墙)
- [4 安装jdk和hadoop](#4 安装jdk和hadoop)
- [5 配置集群环境](#5 配置集群环境)
1 主机映射
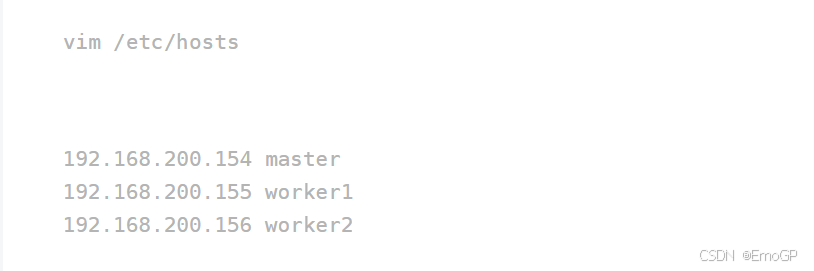
2 免密
ssh-keygen
ssh-copy-id master
ssh-copy-id worker1
ssh-copy-id worker2
3 防火墙
systemctl stop firewalld
systemctl disable firewalld
setenforce 0
4 安装jdk和hadoop
解压缩
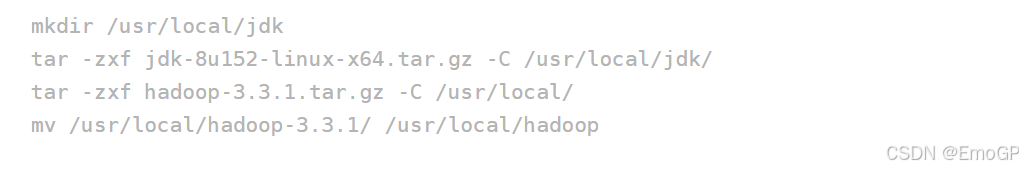
修改环境变量
vim /etc/profile
#JAVA HOME
export JAVA_HOME=/usr/local/jdk/jdk1.8.0_152/
export PATH=$PATH:$JAVA_HOME/bin

#Hadoop
export HADOOP_HOME=/usr/local/hadoop/
export PATH=$PATH:$HADOOP_HOME/bin
export PATH=$PATH:$HADOOP_HOME/sbin
让环境变量生效与验证
source /etc/profile
java -version
hadoop version
5 配置集群环境
hadoop-env.sh
vim /usr/local/hadoop/etc/hadoop/hadoop-env.sh
export JAVA_HOME=/usr/local/jdk/jdk1.8.0_152/
export HDFS_NAMENODE_USER=root
export HDFS_DATANODE_USER=root
export HDFS_SECONDARYNAMENODE_USER=root
export YARN_RESOURCEMANAGER_USER=root
export YARN_NODEMANAGER_USER=root
core-site.xml
cd /usr/local/hadoop/etc/hadoop/
vim core-site.xm
<configuration>
<property>
        <name>fs.defaultFS</name>
    <value>hdfs://master:9000</value>
</property>
<!-- 临时文件存放位置 -->
<property>
        <name>hadoop.tmp.dir</name>
    <value>/usr/local/hadoop/tmp</value>
</property>
</configuration>
hdfs-site.xml
vim hdfs-site.xml
<property>
        <name>dfs.replication</name>
    <value>2</value>
</property>
<!-- namenode存放的位置,老版本是用dfs.name.dir -->
<property>
        <name>dfs.namenode.name.dir</name>
    <value>/usr/local/hadoop/name</value>
</property>
<!-- datanode存放的位置,老版本是dfs.data.dir -->
<property>
        <name>dfs.datanode.data.dir</name>
    <value>/usr/local/hadoop/data</value>
</property>
<!-- 关闭文件上传权限检查 -->
yarn-site.xml
vim yarn-site.xml
<property>
        <name>yarn.resourcemanager.hostname</name>
    <value>master</value>
</property>
<!-- nodemanager获取数据的方式 -->
<property>
        <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
</property>
<!-- 关闭虚拟内存检查 -->
<property>
        <name>yarn.nodemanager.vmem-check-enabled</name>
    <value>false</value>
</property>
mapred-site.xml
vim mapred-site.xml
<property>
        <name>mapreduce.framework.name</name>
    <value>yarn</value>
</property>
<!-- 配了上面这个下面这个也得配, 不然跑mapreduce会找不到主类。MR应用程序的CLASSPATH-->
<property>
        <name>mapreduce.application.classpath</name>
    <value>/usr/local/hadoop/share/hadoop/mapreduce/*:/usr/local/hadoop/share/hadoop/mapreduce/lib/*</value>
</property>
workers
vim workers
worker1
worker2
scp至其他节点
格式化
hdfs namenode -format启动服务(在第一台)
start-all.sh访问ip:9870