从傅里叶变换到 RoPE:解构位置编码的数学灵魂
旋转位置编码 (RoPE) 的天才之处,并不仅仅在于它使用了 sin 和 cos 函数。它真正的革命性在于,它将傅里叶变换的"时移定理" (Time-Shift Theorem)从一个分析工具,转变成了 Transformer 注意力机制的内建架构。
与原始 Transformer 将位置信息"相加"不同,RoPE 通过"旋转"(即复数乘法)来注入位置。这种设计在数学上强行保证 了注意力分数只 依赖于词符间的相对位置 (m-n) ,从而从根本上解决了绝对位置编码的诸多弊端。
1. 问题的根源:注意力机制的"位置色盲"
Transformer 的核心------自注意力机制(Self-Attention)------天生具有"置换不变性"。这意味着,对于模型来说,["我", "打", "你"] 和 ["你", "打", "我"] 在计算注意力时是完全等价的,因为它只关心词符之间的"内容"互动,而不关心它们的"顺序"。
为了解决这个"位置色盲",我们必须以某种方式将"位置 m"和"位置 n"的信息注入模型。
1.1 原始方案:加性的绝对编码 (APE)
原始论文《Attention Is All You Need》提出了一种精妙的方案:
- 为每个绝对位置 pos 计算一个基于多频率
sin/cos的向量 PEpos。 - 将这个位置向量**"加"**到词嵌入向量上: Xfinal=Xword+PEpos。
这个方案(我们称之为 APE)是有效的,但它把一个难题留给了模型:
- 模型看到的是一个"混合"向量 Xfinal。
- 它必须**自行"学习"**如何从 Xfinal 中解耦出词义 Xword 和位置 PEpos。
- 更重要的是,它必须**"学习"出 ⟨Xm+PEm,Xn+PEn⟩ 这个复杂的点积中蕴含的"相对位置 (m−n)"信息。这是一种间接且低效**的方式。
- 它在训练中只见过 PE0 到 PE4095,当 PE5000 出现时,模型会彻底"崩溃",因为它从未见过这个位置的编码,导致外推性 (Extrapolation) 极差。
2. 傅里叶变换的启示:时移即"相旋"
为了找到更好的方案,我们必须回到信号处理的本源------傅里叶变换。
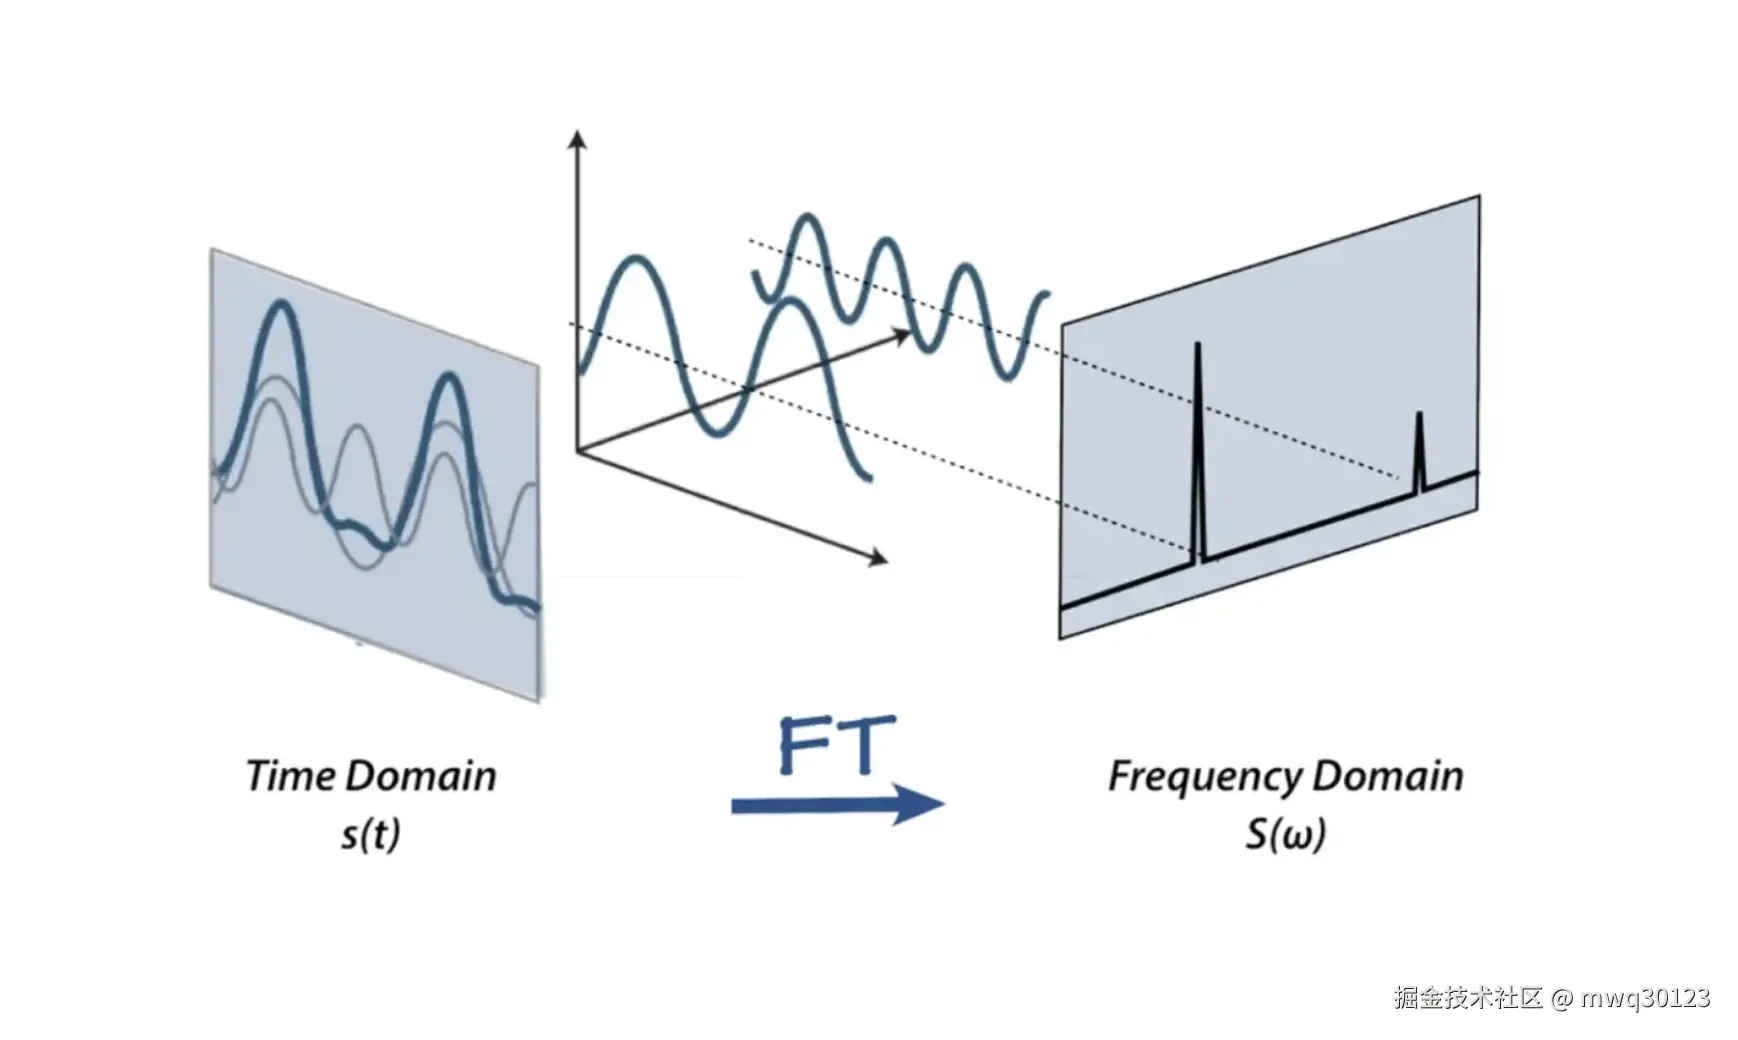
傅里叶变换的核心思想是:任何时域信号 f(t) 都可以分解为不同频率 (ω) 的 sin 和 cos 波的叠加。
而在所有特性中, "时移定理" (Shift Theorem) 是我们的关键:
时移定理(简易版):
一个信号在时域的平移 f(t+n),对应到频域上是一个相位的旋转。
让我们用最纯粹的数学形式(复数)来表达:
-
一个单一频率 ω 的波,在时间 t 的"编码"是 f(t)=eiωt。
-
那么,在时间 t+n(即平移了 n)的"编码"是什么?
f(t+n)=eiω(t+n)=eiωt⋅eiωn
-
我们得到了一个惊人的公式: f(t+n)=f(t)⋅f(n) (注:这里 f(n)=eiωn)
这个公式告诉我们: "平移后"的编码 = "原始编码" 乘以 "平移量对应的旋转因子" 。
这种关系是乘性的 (Multiplicative) ,而不是加性的。
3. RoPE:将"时移定理"注入注意力
RoPE 的设计者(苏剑林)敏锐地抓住了这个点。我们希望注意力 Attention(m,n) 只依赖于相对位置 (m−n)。我们如何利用上述的"乘性"关系呢?
3.1 目标重设
我们不再将 PE"加"到 X 上。我们定义一种新的 Query 和 Key,它们是位置的函数。
我们希望: ⟨qm,kn⟩ 能够只由 q,k 和 (m−n) 决定。
3.2 傅里叶"旋转"的实现
RoPE 正是傅里叶时移定理的直接应用。为了简化,我们暂时使用复数(RoPE 的实际实现就是 2D 旋转,与复数乘法等价)。
RoPE 将 d 维向量 q 分解为 d/2 个复数 qj。对每一个复数(代表一个特定的频率 θj):
-
定义 qm(Query 在位置 m): qm=qj⋅eimθj (这就是 f(t) 乘以 f(m))
-
定义 kn(Key 在位置 n): kn=kj⋅einθj (这就是 f(t) 乘以 f(n))
现在,让我们计算 qm 和 kn 之间的(复数)点积,这对应于注意力分数:
Attention(m,n)∝qm⋅kn∗(* 表示共轭)=(qj⋅eimθj)⋅(kj⋅einθj)∗=(qj⋅eimθj)⋅(kj∗⋅e−inθj)=(qj⋅kj∗)⋅(eimθj⋅e−inθj)=(qj⋅kj∗)⋅ei(m−n)θj
这就是 RoPE 的魔法所在!
- (qj⋅kj∗):这部分只与内容 (content) 有关。
- ei(m−n)θj:这部分只与相对位置 (m−n) 有关。
RoPE 通过乘性(旋转)操作,在数学上将内容和相对位置完美地解耦了。
3.3 频率的多尺度(类比"进制")
在 RoPE 中, θj 的值(即频率)也不是单一的,而是采用了和 APE 类似的多尺度设计:
θj=10000−2j/d
- 低 j 维度: θj 值大,频率高(旋转快,像时钟的"秒针"),捕捉精细的短程相对位置。
- 高 j 维度: θj 值小,频率低(旋转慢,像时钟的"时针"),捕捉粗粒度的长程相对位置。
用不同的"位"或"频率"来捕捉不同尺度的信息。
4. 结论:加法 vs 乘法
| 特性 | 原始 APE (加法) | RoPE (乘法/旋转) |
|---|---|---|
| 集成方式 | X+PEabs | Rm⋅q 和 Rn⋅k |
| 数学原理 | 线性叠加 | 傅里叶时移定理(复数乘法) |
| 模型负担 | 必须**"学习"**出相对位置 | 相对位置**"内建"**于数学结构 |
| 编码对象 | 绝对位置 m | 绝对位置 m 和 n |
| 解码结果 | ⟨qm,kn⟩ 中混杂着绝对和相对信息 | ⟨qm,kn⟩ 中只包含 相对位置 (m−n) |
| 外推性 | 极差 | 较好(为位置内插 PI 提供了基础) |
总结:
RoPE 与傅里叶变换的联系,远不止于"都用了 sin/cos"。
RoPE 是一种架构上的飞跃:它不再满足于给模型提供"绝对位置"的线索(加法 APE),而是利用傅里ye变换最核心的"时移-相旋"特性,将相对位置 (m−n) 的计算,变成了注意力机制的内生本能。这是一种远比加法更优雅、更符合数学原理的解决方案。