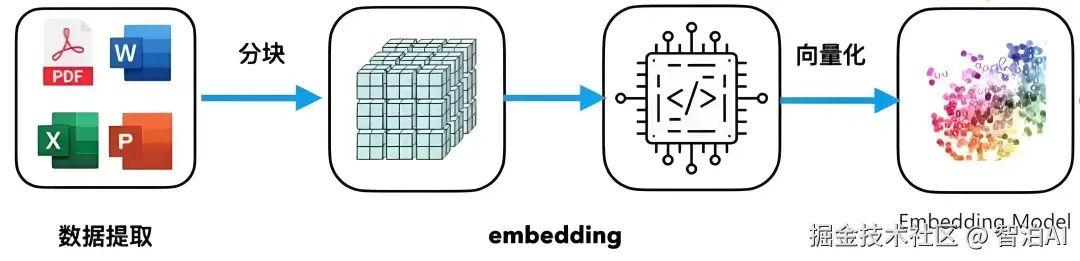
在RAG应用开发中,第一步就是对于文档进行chunking,chunk质量会直接决定整个RAG检索的质量。
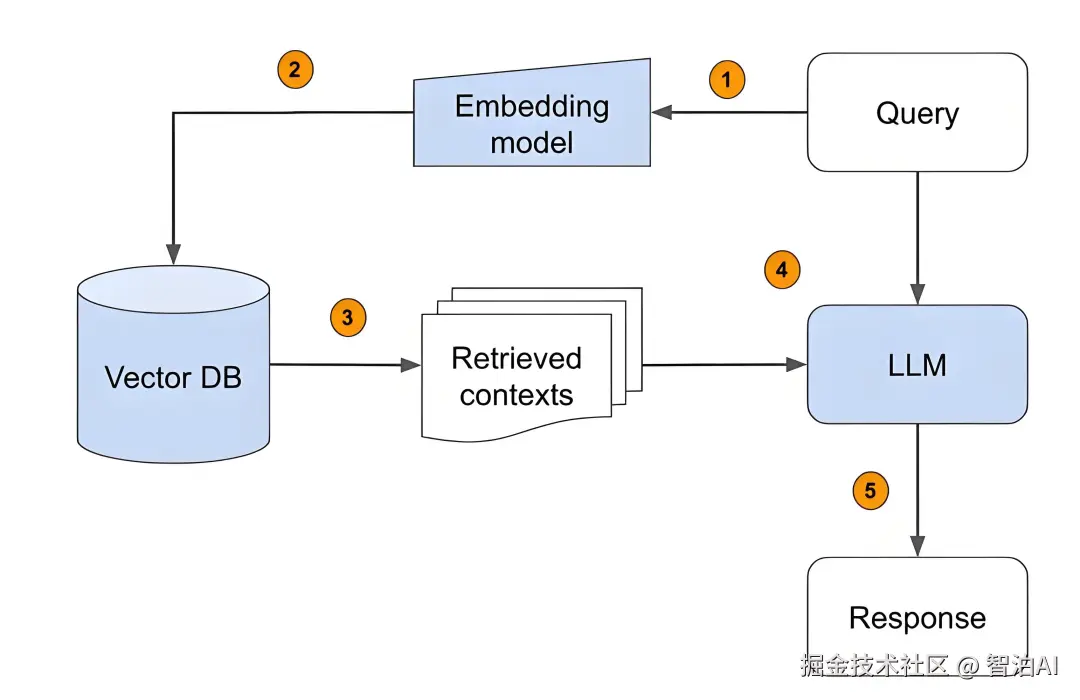
过去,行业通常会采用先chunking再embedding,最后检索、生成的思路进行。
但这个思路中,在chunking环节,无论是固定长度分块,还是递归分块,其实都解决不了精度和上下文的平衡的问题。
在此背景下,先embedding再chunking的思路逐渐被更多人接受。典型代表是Jina AI提出的Late Chunking策略,以及Max--Min semantic chunking。
一起来开个脑洞,如果诸葛亮穿越到《水浒传》的世界,他会成为谁?武松、宋江、还是吴用?这看似是一道文学题,但我们可以用数学方法来求解:诸葛亮 + 水浒传 - 三国演义 = ?
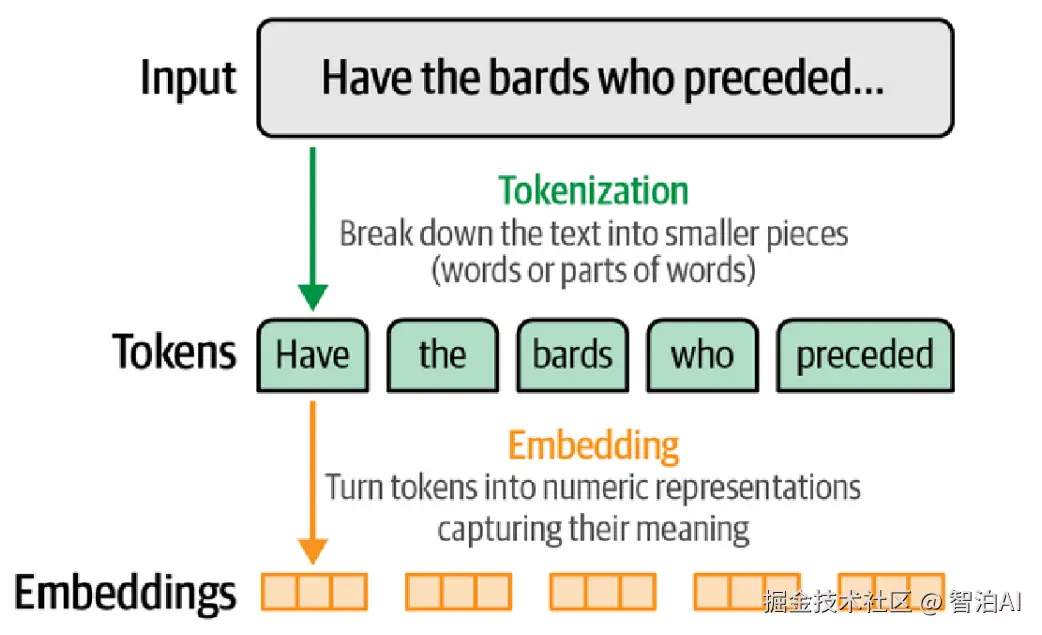
文字本身无法直接运算,但是如果把文字转换成数字向量,就可以进行计算了。而这个过程,叫做"向量嵌入"。
在当今的人工智能(AI)领域,Embedding 是一个不可或缺的概念。如果你没有深入理解过 Embedding,那么就无法真正掌握 AI 的精髓。接下来,我们将深入探讨 Embedding 的基本概念。
一、什么是 Embedding?
如果要用一句话来解释:Embedding 就是把原本"看不懂"的符号,翻译成机器能理解的数字向量。
想象一下:
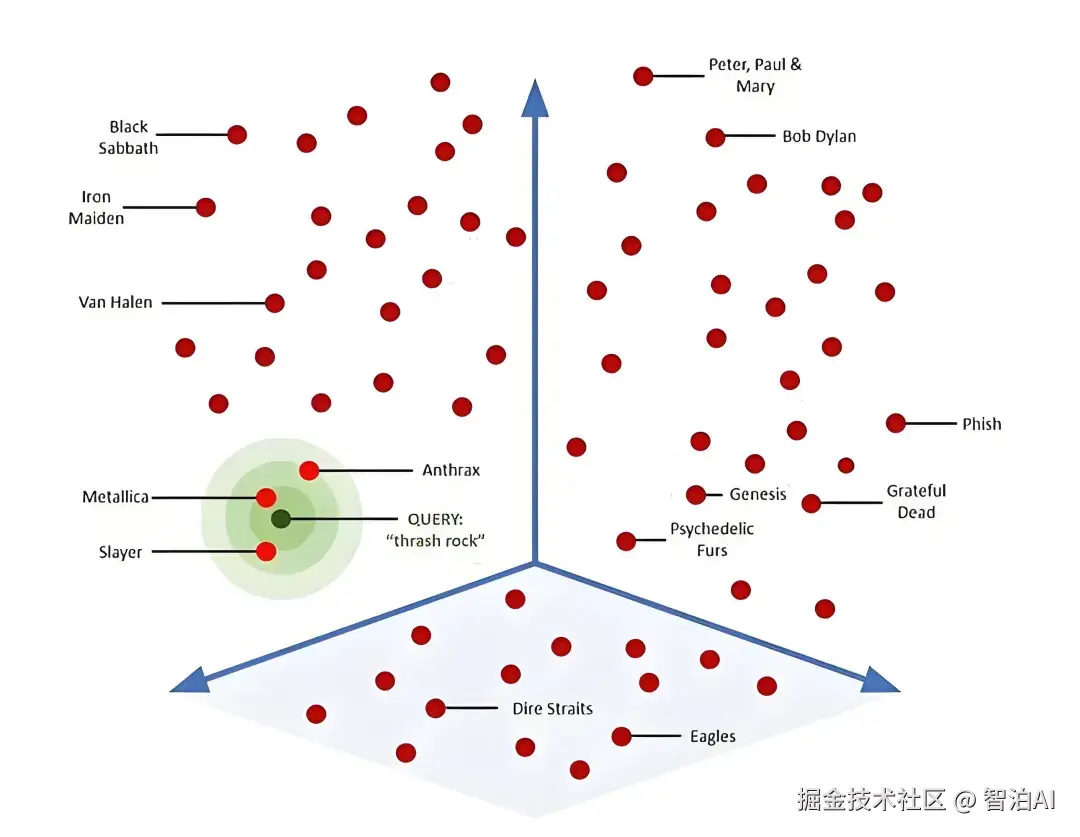
人类能理解"苹果"和"香蕉"相似,和"桌子"差得远,但在计算机眼里,词汇最初只是符号(例如 ID 编号),没有任何语义。于是我们需要一种方法,把这些符号变成"有意义的数字坐标",这套坐标体系就是 Embedding 空间。
Embedding 是一种将高维数据映射到低维空间的技术。简单来说,它就是把复杂的、难以处理的数据转换成便于计算的形式。
举个例子,假设我们有一个包含上千个词汇的文本数据,每个词汇可以看作是一个维度,这样的数据在计算机处理时会变得非常复杂。而 Embedding 则是通过数学模型将这些高维数据映射到一个低维空间,使得计算更加高效。
二、Embedding 的作用
在 AI 中,Embedding 扮演着极其重要的角色。首先,它能大大降低数据的维度,从而提高计算效率。其次,通过 Embedding,AI 模型能够捕捉到数据之间的隐含关系和结构。
例如,在自然语言处理(NLP)中,词向量(word embeddings)能够将语义相近的词汇映射到相邻的向量空间中,这样模型就可以更好地理解和处理语言数据。
因为具有语义意义的数据(如文本或图像),人类可以分辨它们的相关程度,但是无法量化,更不能直接计算。
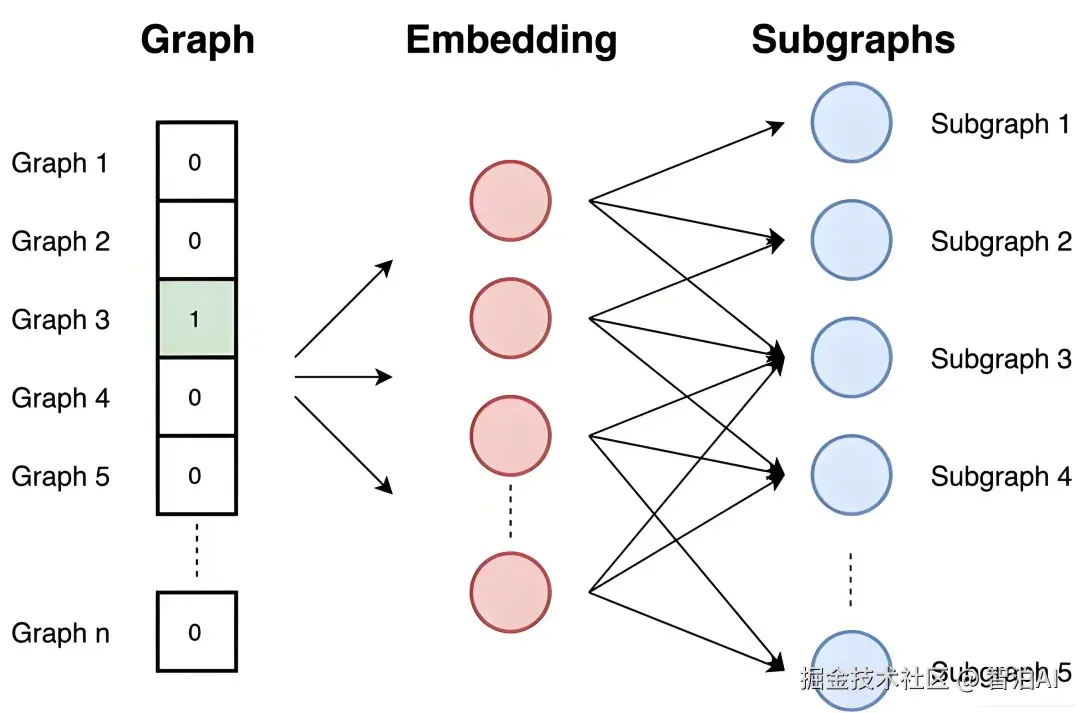
例如,对于一组词"诸葛亮、刘备、关羽、篮球、排球、羽毛球",我们可能会把"诸葛亮、刘备、关羽"分成一组,"篮球、排球、羽毛球"分成另外一组。
但如果进一步提问,"诸葛亮"是和"刘备"更相关,还是和"关羽"更相关呢?这很难回答。而把这些信息转换为向量后,相关程度就可以通过它们在向量空间中的距离量化。
甚至于,我们可以做 诸葛亮 + 水浒传 - 三国演义 = ? 这样的脑洞数学题。
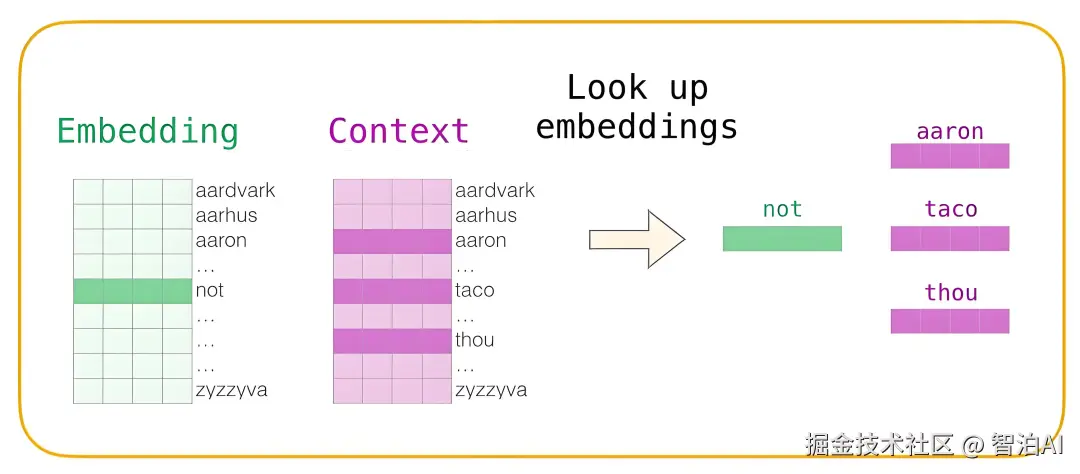
具体作用
1.压缩表示
例如用 one-hot 表示一个词,假如有 10 万个词,每个词都是一个长度 100,000 的向量,大部分位置都是 0,非常低效。
Embedding 可以把它压缩成 100~1,000 维的实数向量,既节省存储,又利于计算。
2.捕捉语义
相似的对象会被映射到相近的向量。
"苹果"和"香蕉"在空间里距离很近,而"苹果"和"电脑"距离更远。
3.通用特征
Embedding 可以作为"底层语言",被下游任务复用。
比如词向量可以用于机器翻译、情感分析、问答系统。

三、常见的 Embedding 类型
根据不同的应用场景,Embedding 的实现方法也有所不同。常见的 Embedding 类型包括:
词向量(Word Embedding):这是最常见的一种 Embedding,主要用于 NLP 领域。通过词向量模型,如 Word2Vec 和 GloVe,可以将词汇映射到一个固定维度的向量空间中,从而捕捉到词汇之间的语义关系
图像嵌入(Image Embedding):在计算机视觉(CV)领域,图像嵌入技术可以将图像数据转换为向量,从而用于图像分类、对象检测等任务
用户嵌入(User Embedding):在推荐系统中,通过对用户行为数据进行嵌入,可以有效地进行个性化推荐
四、总结
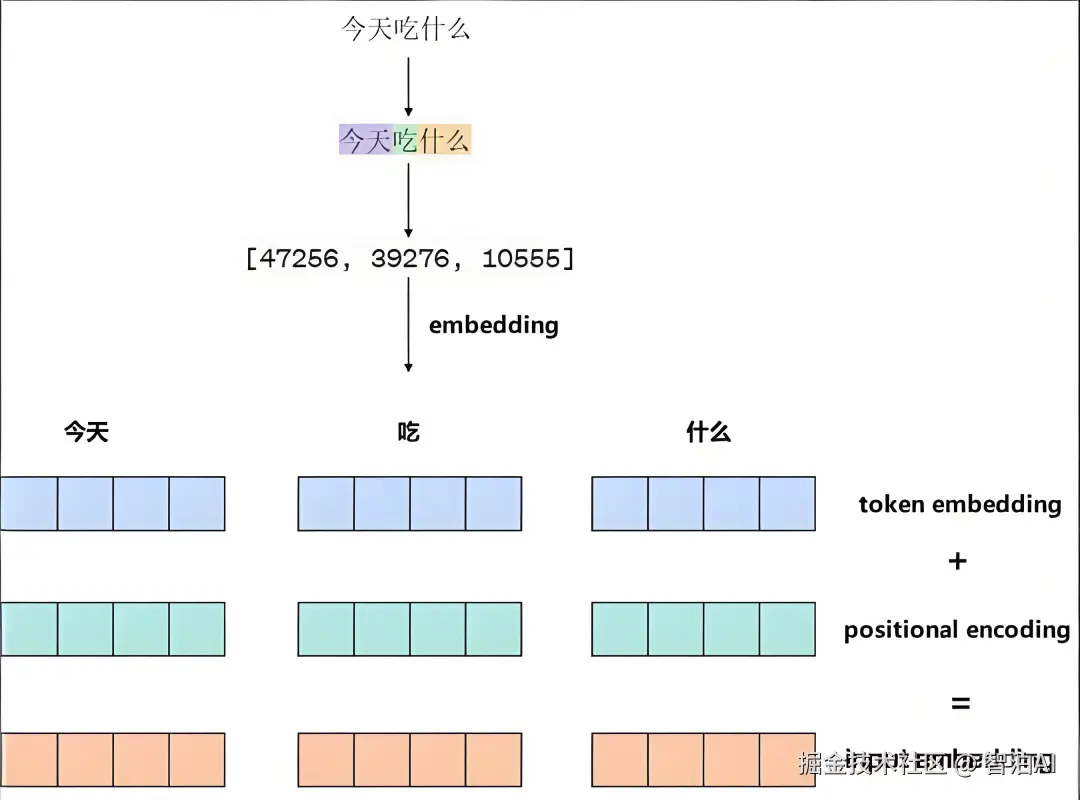
Embedding 可以理解为一种"翻译器",它把原本没有数值意义的离散符号(如词语、用户ID、商品、图片等)转化为低维、稠密的向量表示。
这样做的好处是既能压缩数据、提升计算效率,又能在向量空间中保留语义或特征上的相似性,使得相似的对象更接近,不相似的对象更远。
在传统深度学习中,Embedding 常见于词向量和推荐系统;在大模型时代,它是语言模型、图文匹配、多模态对齐等任务的基础。可以说,Embedding 是机器理解世界的一种"坐标系"。
Embedding 技术在人工智能领域中起着至关重要的作用,能够将复杂的高维数据映射到低维空间,提高数据处理和分析的效率。
通过全面了解和应用 Embedding 技术,我们可以在各种 AI 任务中实现更高效和准确的数据处理,从而推动人工智能的发展和应用。
更多AI大模型学习视频及资源,都在智泊AI。