作者:来自 Elastic Daniel Rubinstein
了解如何在 Elasticsearch 中使用分块大小、分隔符组和自定义分隔符列表来配置递归分块,以实现最佳的结构化文档索引。
刚接触 Elasticsearch 吗?加入我们的 "Elasticsearch 入门" 网络研讨会吧。你也可以现在开始免费云端试用,或在你的机器上体验 Elastic。
从 8.16 版本开始,用户可以在将长文档导入语义文本字段时配置分块策略。从 9.1 / 8.19 版本起,我们引入了一种新的可配置递归分块策略,它使用正则表达式列表对文档进行分块。分块的目标是将长文档拆分成包含相关内容的部分。我们现有的策略会按词或句子的粒度拆分文本,但使用结构化格式(例如 Markdown)编写的文档通常在由某些分隔字符串(例如标题)定义的部分中包含相关内容。对于这类文档,我们引入了递归分块策略,以利用结构化文档的格式创建更优质的分块!
什么是递归分块?
递归分块会遍历一组提供的分区分隔模式,逐步将文档拆分成更小的段,直到它们符合所需的最大分块大小。
如何配置递归分块?
以下是用户为递归分块可配置的参数:
-
(必需)max_chunk_size:每个分块中允许的最大单词数。
-
以下两者之一:
-
separators:用于将文档拆分成分块的正则表达式字符串列表。
-
separator_group:一个字符串,用于映射到由 Elastic 定义的默认分隔符列表,以便针对特定类型的文档使用。目前支持 markdown 和 plaintext。
-
递归分块如何工作?
当给定输入文档、max_chunk_size(以单词为单位)和分隔符字符串列表时,递归分块的处理过程如下:
-
如果输入文档已在最大分块大小范围内,则返回一个覆盖整个输入的单个分块。
-
根据分隔符出现的位置将文本拆分为潜在分块。对每个潜在分块执行以下操作:
-
如果潜在分块在最大分块大小范围内,将其添加到要返回给用户的分块列表中。
-
否则,从第 2 步重新开始,仅使用潜在分块的文本,并使用下一个分隔符进行拆分。
-
如果没有更多分隔符可用,则退回到基于句子的分块。
-
配置递归分块的示例
除了分块大小之外,递归分块的主要配置是选择用于拆分文档的分隔符。如果你不确定从哪里开始,Elasticsearch 提供了一些默认的分隔符组,可用于常见的使用场景。
使用分隔符组
要使用分隔符组,只需在配置分块设置时提供你想使用的组名即可。例如:
json
`

1.  "chunking_settings": {
2.      "strategy": "recursive",
3.      "max_chunk_size": 25,
4.      "separator_group": "plaintext"
5.  }

`AI写代码
这将为你提供一种递归分块策略,使用的分隔符列表为 "(?\。这对通用纯文本应用非常有效,先按两个换行符拆分,然后按一个换行符拆分。
我们还提供了一个名为 markdown 的分隔符组,它使用的分隔符列表为:
swift
`
1. [
2. "\n# ",
3. "\n## ",
4. "\n### ",
5. "\n#### ",
6. "\n##### ",
7. "\n###### ",
8. "\n^(?!\\s*$).*\\n-{1,}\\n",
9. "\n^(?!\\s*$).*\\n={1,}\\n"
10. ]
`AI写代码这个分隔符列表非常适用于通用的 markdown 使用场景,会根据 6 个标题级别和分段字符进行拆分。
在创建资源(推理端点 / 语义文本字段)时,与分隔符组对应的分隔符列表会存储在你的配置中。如果分隔符组在之后被更新,它不会改变你已创建资源的行为。
使用自定义分隔符列表
如果预定义的分隔符组不适合你的使用场景,你可以定义一个符合需求的自定义分隔符列表。请注意,分隔符列表中可以使用正则表达式。以下是一个使用自定义分隔符配置分块设置的示例:
swift
`

1.  "chunking_settings": {
2.      "strategy": "recursive",
3.      "max_chunk_size": 25,
4.      "separators": ["\n\n", "\n", "<my-custom-separator>"]
5.  }

`AI写代码
上面的分块策略会先按两个换行符拆分,然后按一个换行符拆分,最后按字符串 "" 拆分。
递归分块示例
让我们来看一个递归分块的实际示例。在这个例子中,我们使用以下分块设置,通过自定义分隔符列表按 markdown 文档的前两个标题级别进行拆分:
swift
`

1.  "chunking_settings": {
2.      "strategy": "recursive",
3.      "max_chunk_size": 25,
4.      "separators": ["\n# ", "\n## "]
5.  }

`AI写代码
让我们来看一个未分块的简单 Markdown 文档:

现在让我们使用上面定义的分块设置来对文档进行分块:

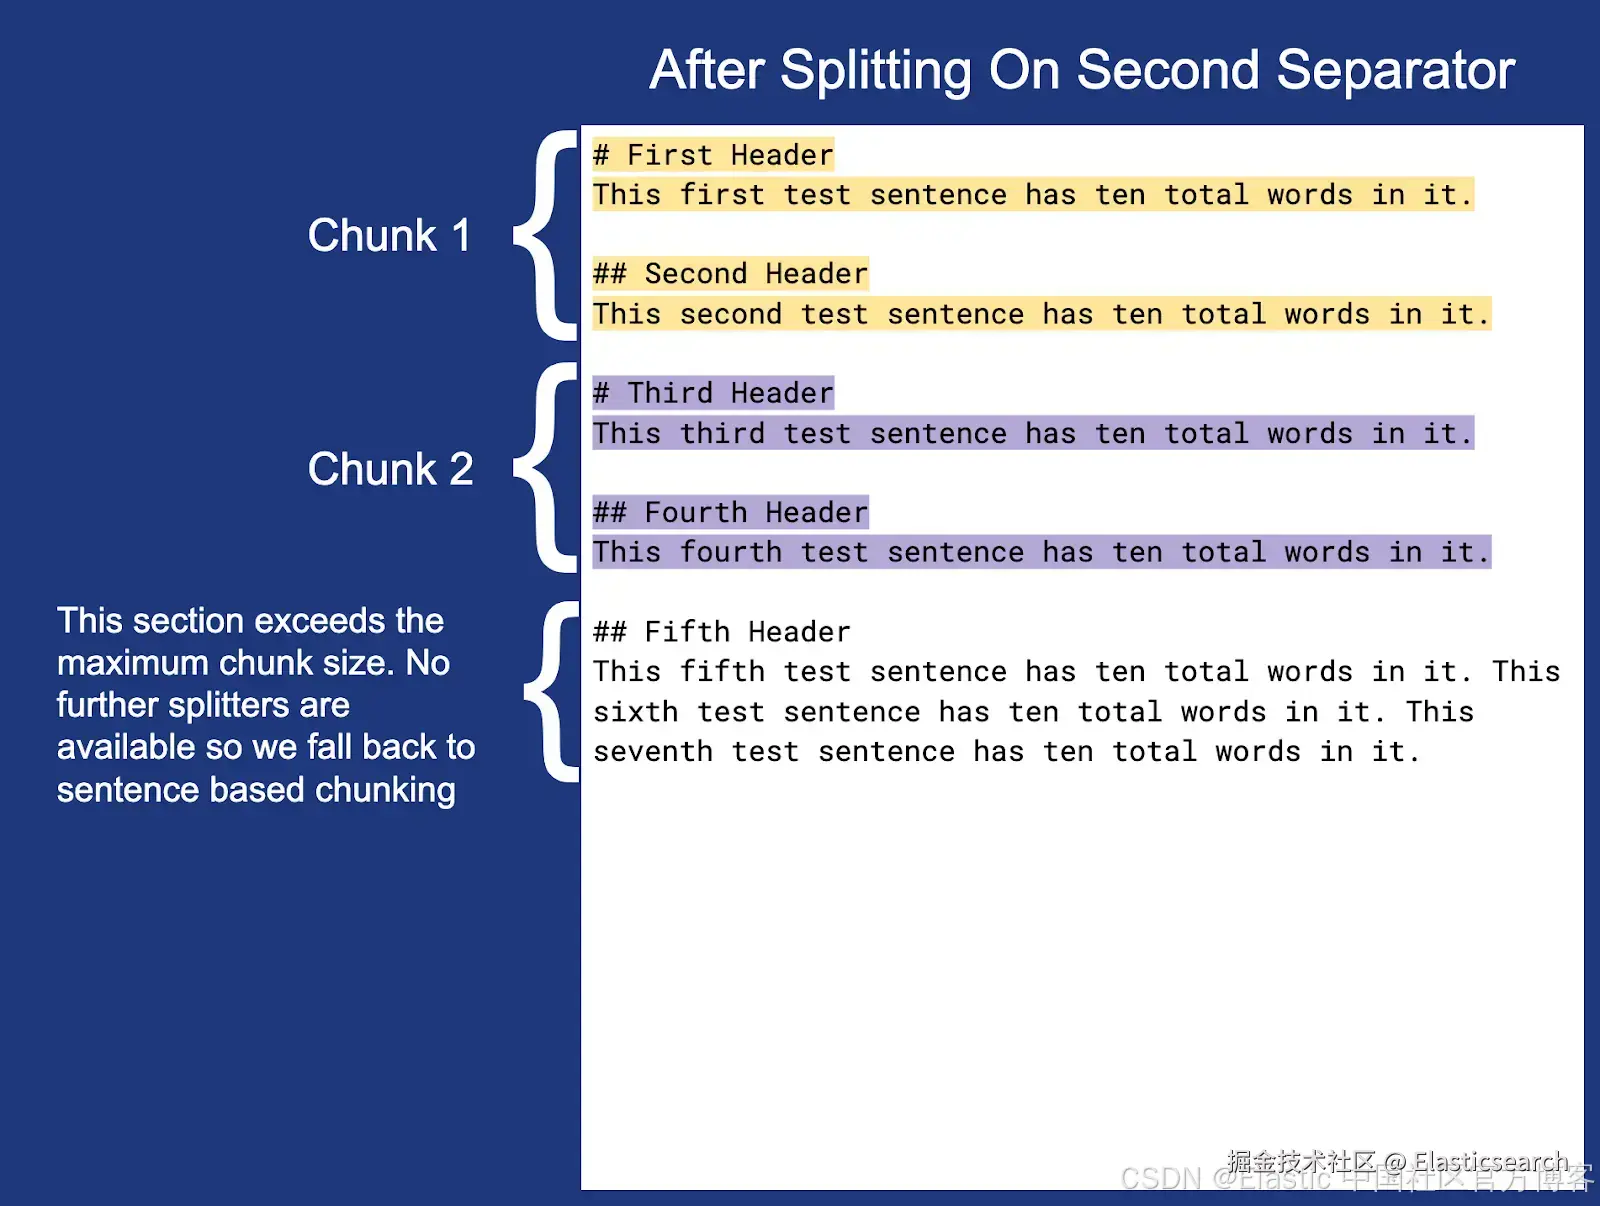
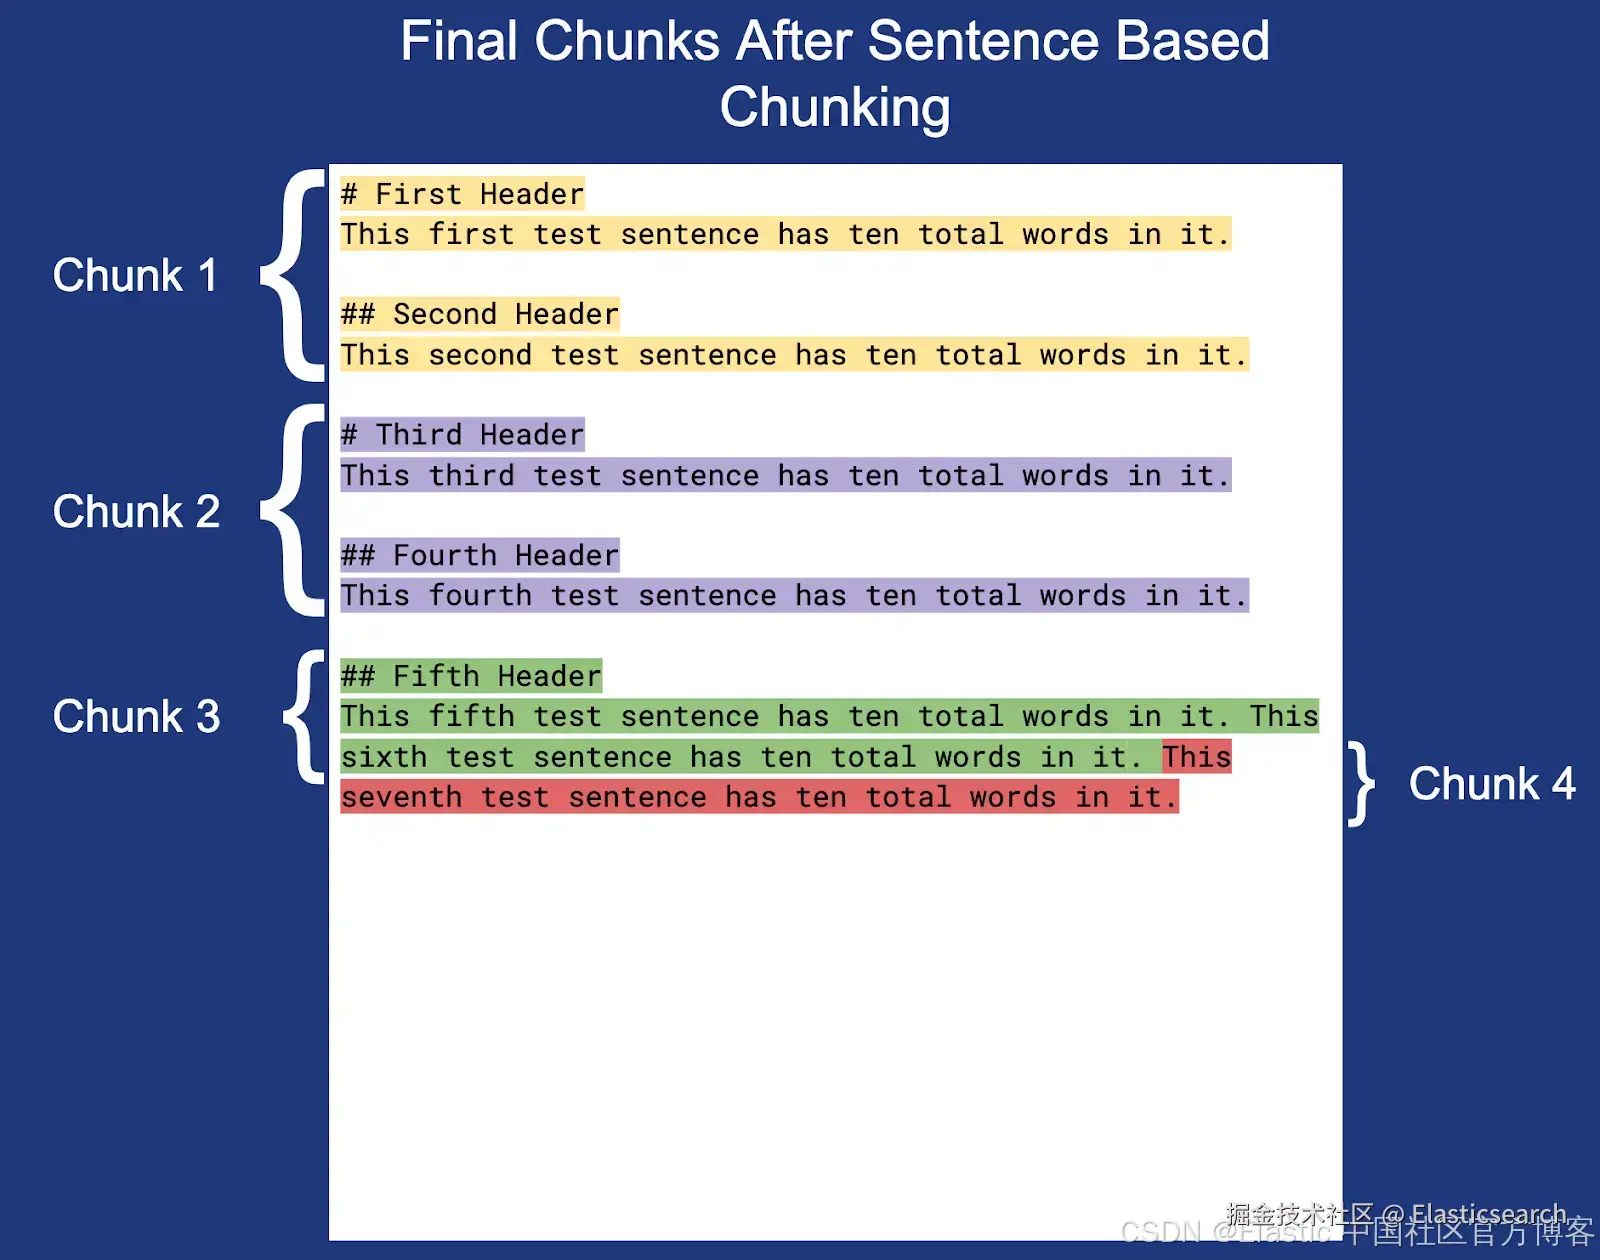
注意:每个分块末尾的换行符(除了分块 3)未高亮显示,但包含在实际的分块边界内。
今天就开始使用递归分块吧!
有关如何使用此功能的更多信息,请查看配置分块设置的文档。