这篇论文《FCAF3D: Fully Convolutional Anchor-Free 3D Object Detection 》提出了一种全新的、完全卷积且无锚框的室内3D目标检测方法。下面我将从问题背景、方法设计、核心创新、实验结果等方面进行详细解析。
🧠 一、解决的问题
1. 传统3D检测方法的局限性
- 内存与计算效率低:传统体素化方法使用密集3D卷积,内存消耗大,难以处理大场景。
- 依赖几何先验:许多方法(如GSDN)使用锚框或预设的物体尺寸、长宽比,限制了模型的泛化能力,并引入大量超参数。
- 推理速度慢:投票类方法(如VoteNet)和Transformer方法在大场景中速度下降明显。
- 对小物体和扁平物体检测效果差:传统方法容易漏检如门、画、白板等薄型物体。
2. FCAF3D的目标
- 提出一个无需锚框、不依赖几何先验的纯数据驱动的3D检测方法。
- 实现高精度、高速度、低内存的室内3D目标检测。
- 在ScanNet V2、SUN RGB-D、S3DIS等主流数据集上实现SOTA。
🛠️ 二、方法详解
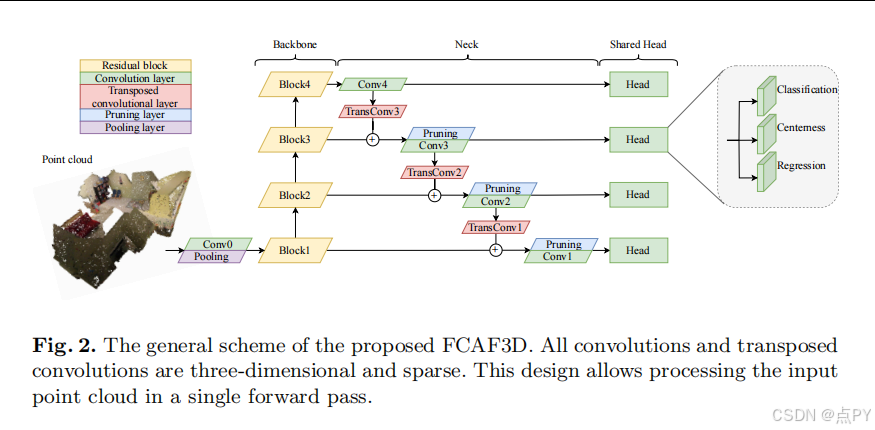
1. 整体架构
FCAF3D采用经典的Backbone-Neck-Head 结构,全部基于稀疏3D卷积,适用于大规模点云场景。
| 组件 | 说明 |
|---|---|
| Backbone | 使用稀疏3D版本的ResNet(HDResNet) |
| Neck | 简化的GSDN解码器,使用稀疏转置卷积 + 稀疏卷积 |
| Head | 无锚框设计,输出分类概率、边界框参数、中心度 |
2. 核心创新点
✅ 无锚框设计 & 多层级位置分配
- 不依赖锚框:直接在每个空间位置上回归边界框,减少超参数。
- 多层级分配策略 :
- 为每个真实框选择最适合的特征层级(覆盖至少 (N_{\text{loc}} = 3^3) 个位置)。
- 使用中心采样,只选择靠近真实框中心的点作为正样本。
✅ 新型OBB参数化:Mobius Strip 表示法
- 问题:对于无明确朝向的物体(如桌子、椅子),标注的朝向角 (\theta) 具有歧义(四个等效表示)。
- 解决方案 :将 ((q = \frac{w}{l}, \theta)) 映射到 Mobius Strip 上,提出一种新型嵌入表示:
\\delta_7 = \\ln\\frac{w}{l} \\cdot \\sin(2\\theta), \\quad \\delta_8 = \\ln\\frac{w}{l} \\cdot \\cos(2\\theta)
- 优点 :
- 四个等效的 ((q, \theta)) 表示映射到同一个嵌入点。
- 避免了角度分类,直接回归连续值,提升精度。
✅ 稀疏卷积与轻量级剪枝
- 使用稀疏3D卷积处理大规模点云。
- 剪枝策略:保留最多 (N_{\text{vox}} = N_{\text{pts}}) 个体素,控制内存增长。
- 使用分类概率作为剪枝依据,而非额外训练一个评分层。
3. 损失函数
总损失为:
L = \\frac{1}{N_{\\text{pos}}} \\sum \\left\[ L_{\\text{cls}} + \\mathbb{1}*{\\text{pos}} \\cdot L* {\\text{reg}} + \\mathbb{1}*{\\text{pos}} \\cdot L* {\\text{centerness}} \\right
]
- (L_{\text{cls}}):Focal Loss
- (L_{\text{reg}}):IoU Loss(支持旋转IoU)
- (L_{\text{centerness}}):Binary Cross-Entropy
📊 三、实验结果
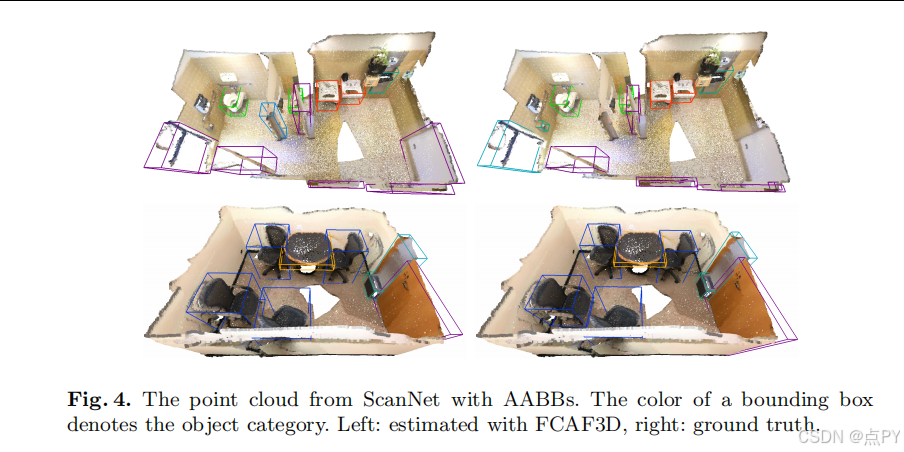
1. 主要结果(SOTA)
| 数据集 | mAP@0.25 | mAP@0.5 |
|---|---|---|
| ScanNet | 71.5 | 57.3 |
| SUN RGB-D | 64.2 | 48.9 |
| S3DIS | 66.7 | 45.9 |
在所有数据集上均显著超越之前的SOTA方法(如GroupFree、GSDN等)。
2. 消融实验
| 模块 | 说明 | 效果 |
|---|---|---|
| Mobius参数化 | 替代传统角度分类+回归 | 提升约4% mAP@0.5 |
| 中心度(centerness) | 是否使用中心度预测 | 轻微提升(~1%) |
| 体素大小 | 0.01m vs 0.02m | 0.01m 显著更优 |
| 点数 (N_{\text{pts}}) | 100k vs 20k/40k | 100k 最佳 |
| 中心采样点数 | 9 vs 18 vs 27 | 18 最佳 |
3. 速度与精度平衡
| 模型配置 | 速度 (scenes/sec) | mAP@0.5 |
|---|---|---|
| FCAF3D(准确型) | 8.0 | 56.0 |
| FCAF3D(平衡型) | 22.9 | 43.9 |
| FCAF3D(快速型) | 31.5 | 46.8 |
| GSDN(对比) | 20.1 | 34.8 |
即使在最快配置下,FCAF3D仍显著优于GSDN。
✅ 四、总结与贡献
| 贡献 | 说明 |
|---|---|
| 首个全卷积无锚框3D检测方法 | 适用于室内场景,简单高效 |
| Mobius OBB参数化 | 解决角度歧义,提升精度,减少先验 |
| 轻量级稀疏卷积设计 | 内存友好,适合大场景 |
| SOTA性能 | 在三大数据集上全面领先 |
| 代码开源 | 提供完整实现,便于复现 |
🧩 总结一句话:
FCAF3D通过无锚框设计 + Mobius朝向参数化 + 稀疏3D卷积 ,实现了高精度、高效率、强泛化的室内3D目标检测,显著减少了对几何先验的依赖,并在多个基准测试中达到SOTA。