最近做一个项目的时候,发现一个特别诡异的问题,kafka中有topicA,topicB两个主题,然后我通过flume抽取kafka中topicA中的数据,能够成功,flume的conf如下:
tier1.sources = source1
tier1.channels = c1
tier1.sinks = k1
tier1.sources.source1.type = org.apache.flume.source.kafka.KafkaSource
tier1.sources.source1.channels = c1
tier1.sources.source1.batchSize = 100
tier1.sources.source1.kafka.bootstrap.servers = bigdata01:9092
tier1.sources.source1.kafka.topics = topicA
tier1.sources.source1.kafka.consumer.group.id = yuekao

tier1.sources.source1.kafka.consumer.auto.offset.reset=earliest

tier1.sources.source1.interceptors = i1
tier1.sources.source1.interceptors.i1.type = com.bigdata.YueKaoInterceptor$BuilderEvent

tier1.channels.c1.type = memory
tier1.channels.c1.capacity = 10000
tier1.channels.c1.transactionCapacity = 1000


tier1.sinks.k1.type = logger
tier1.sinks.k1.channel = c1
然后,接着将结果抽取到topicB中,配置文件如下:
tier1.sources = source1
tier1.channels = c1
tier1.sinks = k1
tier1.sources.source1.type = org.apache.flume.source.kafka.KafkaSource
tier1.sources.source1.channels = c1
tier1.sources.source1.batchSize = 100
tier1.sources.source1.kafka.bootstrap.servers = bigdata01:9092
tier1.sources.source1.kafka.topics = topicA
tier1.sources.source1.kafka.consumer.group.id = yuekao3

tier1.sources.source1.kafka.consumer.auto.offset.reset=latest


tier1.channels.c1.type = memory
tier1.channels.c1.capacity = 100000
tier1.channels.c1.transactionCapacity = 10000
tier1.channels.c1.byteCapacityBufferPercentage = 20
tier1.channels.c1.byteCapacity = 800000

tier1.sinks.k1.channel = c1
tier1.sinks.k1.type = org.apache.flume.sink.kafka.KafkaSink
tier1.sinks.k1.kafka.topic = topicB
tier1.sinks.k1.kafka.bootstrap.servers = bigdata01:9092
发现一个问题:
flume将topicA中的数据抽取出来之后,继续发送给topicA,topicA自循环啦,topicB中压根没数据,于是发现官网中有这么一段解释:
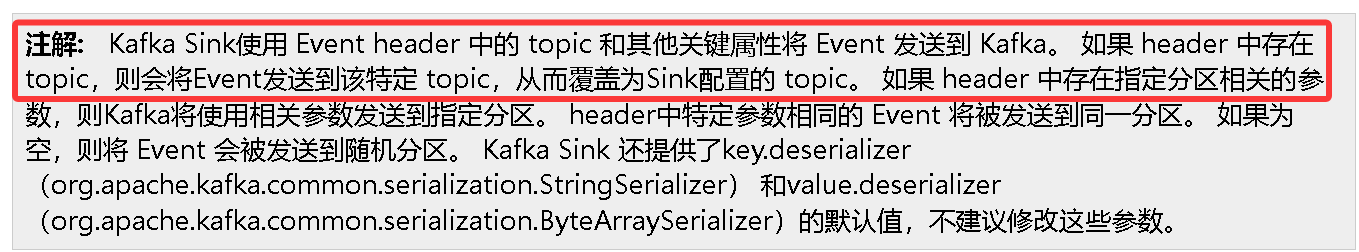
也就是说如果想把结果发送topicB, 可以在event的header中添加 topic=topicB,
那就只剩两个办法啦,一个是自定义拦截器,一个是使用静态拦截器,自定义拦截器,步骤长,麻烦,可以使用静态拦截器,于是conf修改如下:
tier1.sources = source1
tier1.channels = c1
tier1.sinks = k1
tier1.sources.source1.type = org.apache.flume.source.kafka.KafkaSource
tier1.sources.source1.channels = c1
tier1.sources.source1.batchSize = 100
tier1.sources.source1.kafka.bootstrap.servers = bigdata01:9092
tier1.sources.source1.kafka.topics = topicA
tier1.sources.source1.kafka.consumer.group.id = yuekao3

tier1.sources.source1.kafka.consumer.auto.offset.reset=latest

tier1.sources.source1.interceptors = i1
tier1.sources.source1.interceptors.i1.type = static
tier1.sources.source1.interceptors.i1.key = topic
tier1.sources.source1.interceptors.i1.preserveExisting = false
tier1.sources.source1.interceptors.i1.value = topicB

tier1.channels.c1.type = memory
tier1.channels.c1.capacity = 100000
tier1.channels.c1.transactionCapacity = 10000
tier1.channels.c1.byteCapacityBufferPercentage = 20
tier1.channels.c1.byteCapacity = 800000

tier1.sinks.k1.channel = c1
tier1.sinks.k1.type = org.apache.flume.sink.kafka.KafkaSink
tier1.sinks.k1.kafka.topic = topicB
tier1.sinks.k1.kafka.bootstrap.servers = bigdata01:9092
相当于添加了如下方法:
tier1.sources.source1.interceptors = i1
tier1.sources.source1.interceptors.i1.type = static
tier1.sources.source1.interceptors.i1.key = topic
tier1.sources.source1.interceptors.i1.preserveExisting = false
tier1.sources.source1.interceptors.i1.value = topicB
问题解决!!!!