RowKindExtractor 是 Apache SeaTunnel 的一个转换插件,它能将 CDC 数据流转为 Append-Only 模式,并提取原始 RowKind 信息为新字段。本文将介绍 RowKindExtractor 的核心功能,其在 CDC 数据同步场景下的使用方法,以及配置选项、注意事项及多种应用示例。
RowKindExtractor
RowKindExtractor 转换插件用于将 CDC(Change Data Capture)数据流转换为 Append-Only(仅追加)模式,同时将原始的 RowKind 信息提取为一个新的字段。
核心功能:
- 将所有数据行的 RowKind 统一改为 +I(INSERT),实现 Append-Only 模式
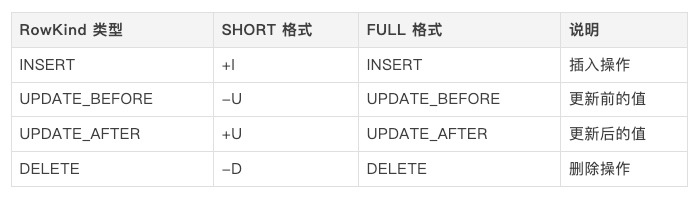
- 将原始的 RowKind 信息(INSERT、UPDATE_BEFORE、UPDATE_AFTER、DELETE)保存到新增的字段中
- 支持短格式和完整格式两种输出方式
为什么需要这个插件?
在 CDC 数据同步场景中,数据行带有 RowKind 标记(+I、-U、+U、-D),表示不同的变更类型。但某些下游系统(如数据湖、分析系统)只支持 Append-Only 模式,不支持 UPDATE 和 DELETE 操作。此时需要:
- 将所有数据转换为 INSERT 类型(Append-Only)
- 将原始的变更类型保存为普通字段,供后续分析使用
转换示例:
输入(CDC 数据):
  RowKind: -D (DELETE)
  数据: id=1, name="test1", age=20

输出(Append-Only 数据):
  RowKind: +I (INSERT)
数据: id=1, name="test1", age=20, row_kind="DELETE"典型应用场景:
- 将 CDC 数据写入只支持 Append 的数据湖
- 需要在数据仓库中保留完整的变更历史记录
- 需要对不同类型的变更进行统计分析
配置选项
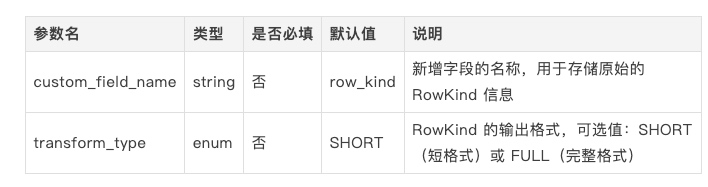
custom_field_name string
指定新增字段的名称,该字段用于存储原始的 RowKind 信息。
默认值:row_kind
注意事项:
- 字段名不能与原有字段重名,否则会报错
- 建议使用有意义的名称,如 operation_type、change_type、cdc_op 等
示例:
custom_field_name = "operation_type" # 使用自定义字段名transform_type enum
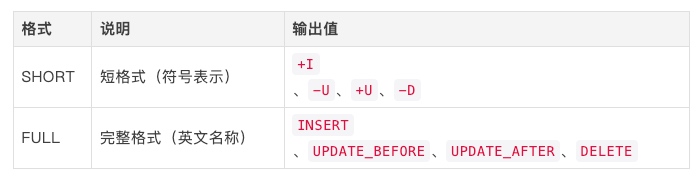
指定 RowKind 字段值的输出格式。
可选值:
默认值:SHORT
各值含义:
选择建议:
- SHORT 格式:节省存储空间,适合对存储敏感的场景
- FULL 格式:可读性更好,适合需要人工查看或分析的场景
示例:
transform_type = FULL # 使用完整格式完整示例
- 示例 1:使用默认配置(SHORT 格式)
使用默认配置,将 CDC 数据转换为 Append-Only 模式,RowKind 以短格式保存。
env {
  parallelism = 1
  job.mode = "STREAMING"
}

source {
  MySQL-CDC {
    plugin_output = "cdc_source"
    server-id = 5652
    username = "root"
    password = "your_password"
    table-names = ["mydb.users"]
    url = "jdbc:mysql://localhost:3306/mydb"
  }
}

transform {
  RowKindExtractor {
    plugin_input = "cdc_source"
    plugin_output = "append_only_data"
    # 使用默认配置:
    # custom_field_name = "row_kind"
    # transform_type = SHORT
  }
}

sink {
  Console {
    plugin_input = "append_only_data"
  }
}
数据转换过程:
输入数据(CDC 格式):
  1. RowKind=+I, id=1, name="张三", age=25
  2. RowKind=-U, id=1, name="张三", age=25
  3. RowKind=+U, id=1, name="张三", age=26
  4. RowKind=-D, id=1, name="张三", age=26

输出数据(Append-Only 格式):
  1. RowKind=+I, id=1, name="张三", age=25, row_kind="+I"
  2. RowKind=+I, id=1, name="张三", age=25, row_kind="-U"
  3. RowKind=+I, id=1, name="张三", age=26, row_kind="+U"
4. RowKind=+I, id=1, name="张三", age=26, row_kind="-D"- 示例 2:使用 FULL 格式和自定义字段名
使用完整格式输出 RowKind,并自定义字段名称。
env {
  parallelism = 1
  job.mode = "STREAMING"
}

source {
  MySQL-CDC {
    plugin_output = "cdc_source"
    server-id = 5652
    username = "root"
    password = "your_password"
    table-names = ["mydb.orders"]
    url = "jdbc:mysql://localhost:3306/mydb"
  }
}

transform {
  RowKindExtractor {
    plugin_input = "cdc_source"
    plugin_output = "append_only_data"
    custom_field_name = "operation_type"  # 自定义字段名
    transform_type = FULL                 # 使用完整格式
  }
}

sink {
  Iceberg {
    plugin_input = "append_only_data"
    catalog_name = "iceberg_catalog"
    database = "mydb"
    table = "orders_history"
    # Iceberg 表会包含 operation_type 字段,记录每条数据的变更类型
  }
}

数据转换过程:

输入数据(CDC 格式):
  1. RowKind=+I, order_id=1001, amount=100.00
  2. RowKind=-U, order_id=1001, amount=100.00
  3. RowKind=+U, order_id=1001, amount=150.00
  4. RowKind=-D, order_id=1001, amount=150.00

输出数据(Append-Only 格式,FULL 格式):
  1. RowKind=+I, order_id=1001, amount=100.00, operation_type="INSERT"
  2. RowKind=+I, order_id=1001, amount=100.00, operation_type="UPDATE_BEFORE"
  3. RowKind=+I, order_id=1001, amount=150.00, operation_type="UPDATE_AFTER"
4. RowKind=+I, order_id=1001, amount=150.00, operation_type="DELETE"- 示例 3:完整的测试示例(使用 FakeSource)
使用 FakeSource 生成测试数据,演示各种 RowKind 的转换效果。
env {
  parallelism = 1
  job.mode = "BATCH"
}

source {
  FakeSource {
    plugin_output = "fake_cdc_data"
    schema = {
      fields {
        pk_id = bigint
        name = string
        score = int
      }
      primaryKey {
        name = "pk_id"
        columnNames = [pk_id]
      }
    }
    rows = [
      {
        kind = INSERT
        fields = [1, "A", 100]
      },
      {
        kind = INSERT
        fields = [2, "B", 100]
      },
      {
        kind = UPDATE_BEFORE
        fields = [1, "A", 100]
      },
      {
        kind = UPDATE_AFTER
        fields = [1, "A_updated", 95]
      },
      {
        kind = UPDATE_BEFORE
        fields = [2, "B", 100]
      },
      {
        kind = UPDATE_AFTER
        fields = [2, "B_updated", 98]
      },
      {
        kind = DELETE
        fields = [1, "A_updated", 95]
      }
    ]
  }
}

transform {
  RowKindExtractor {
    plugin_input = "fake_cdc_data"
    plugin_output = "transformed_data"
    custom_field_name = "change_type"
    transform_type = FULL
  }
}

sink {
  Console {
    plugin_input = "transformed_data"
  }
}
预期输出:
+I, pk_id=1, name="A", score=100, change_type="INSERT"
+I, pk_id=2, name="B", score=100, change_type="INSERT"
+I, pk_id=1, name="A", score=100, change_type="UPDATE_BEFORE"
+I, pk_id=1, name="A_updated", score=95, change_type="UPDATE_AFTER"
+I, pk_id=2, name="B", score=100, change_type="UPDATE_BEFORE"
+I, pk_id=2, name="B_updated", score=98, change_type="UPDATE_AFTER"
+I, pk_id=1, name="A_updated", score=95, change_type="DELETE"