爬虫逆向:国家信息安全漏洞(加速乐),cookie反爬

本案例仅供学习和参考

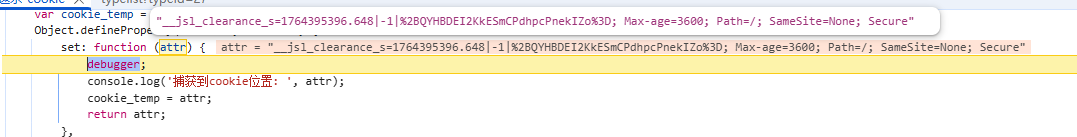
逆向参数:__jsluid_s、__jsl_clearance_s

注意:__jsluid_s由服务器下发,而__jsl_clearance_s需通过客户端执行JS代码生成

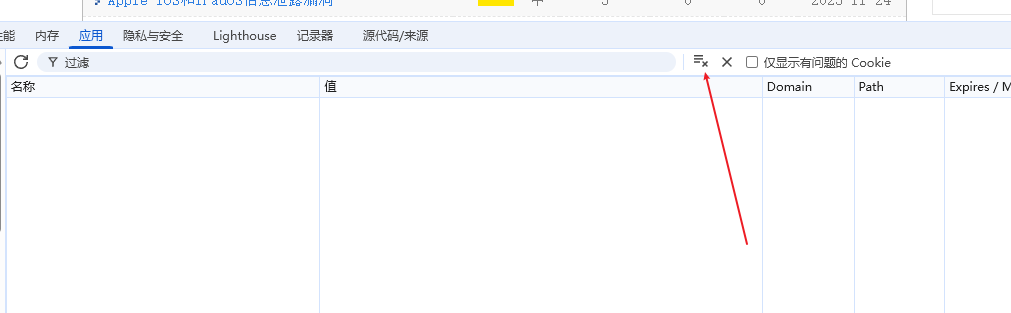
1,在应用这里将cookie清空
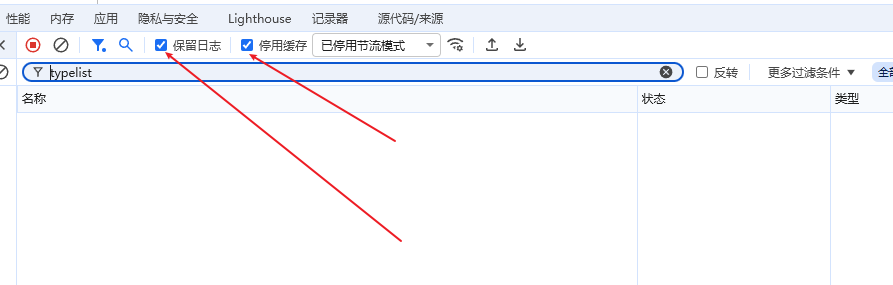
2,在网络这里打开保留日志,停用缓存
3,刷新网页,可以看到有三个请求,第三个是基于前面两个生成出来的
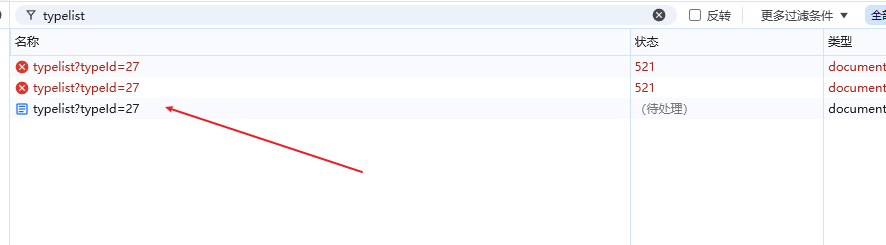
4,说明我们的代码需要获取两次cookie,第三次才能拿到我们的页面数据

第一次
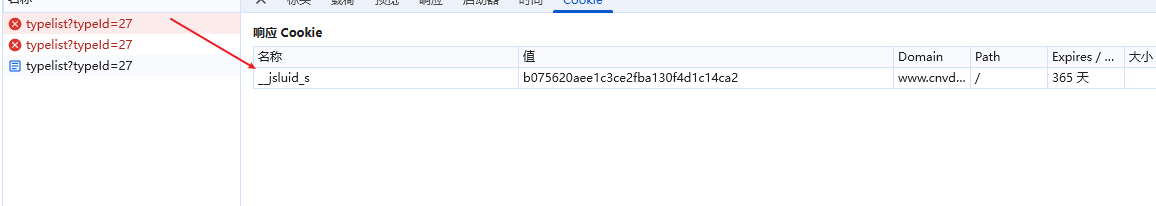
第二次
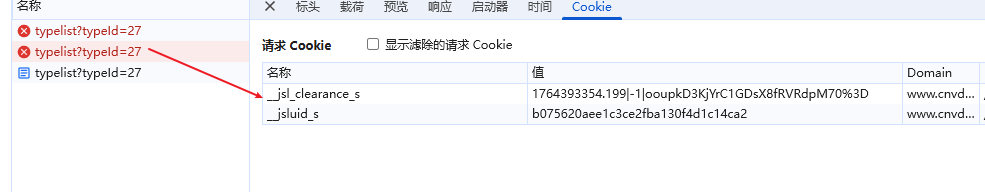
第三次
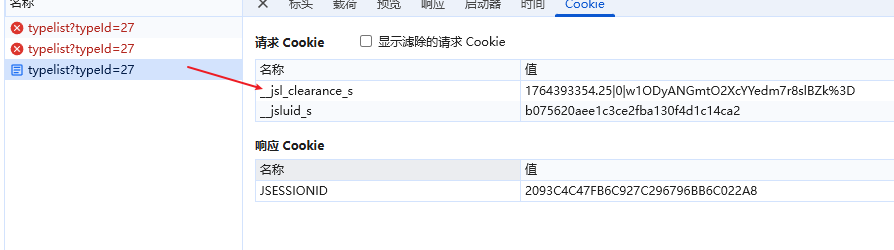
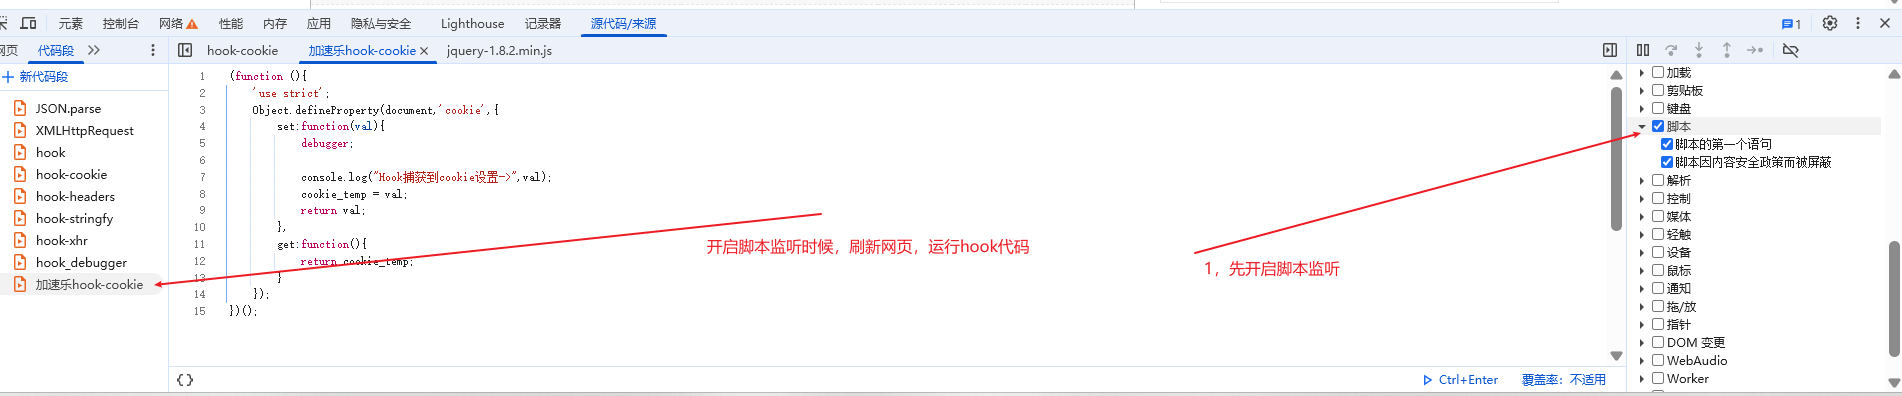
5,来到网络源代码里面具体分析一下

第一次
第二次
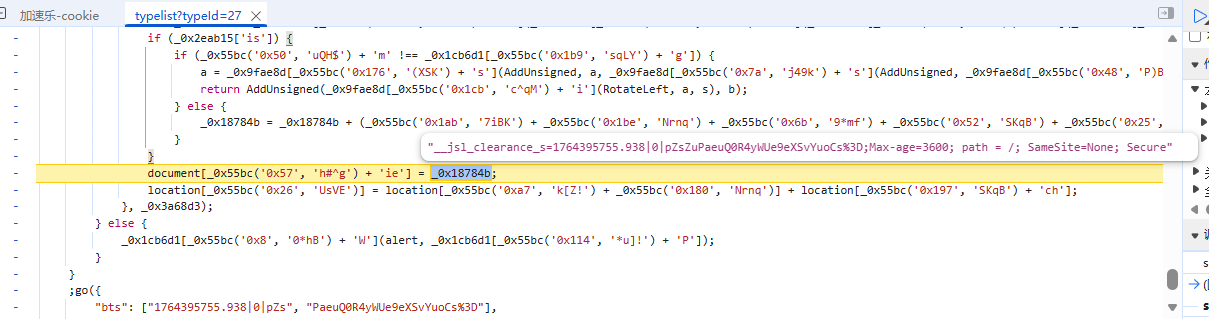
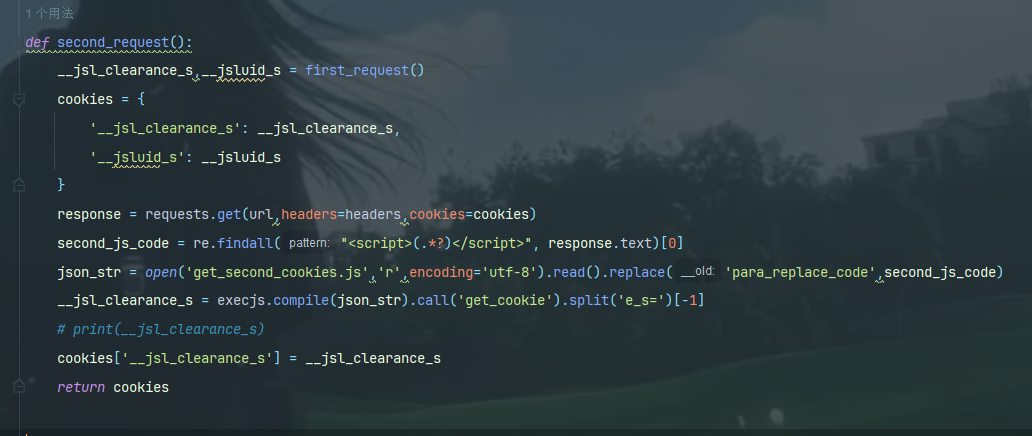
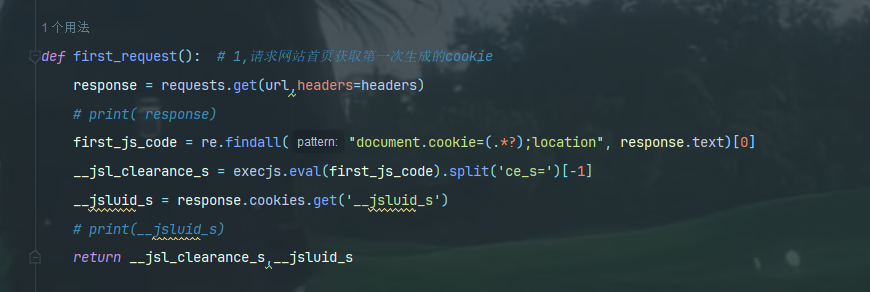
所以在py代码里面可以这样写

第一次的
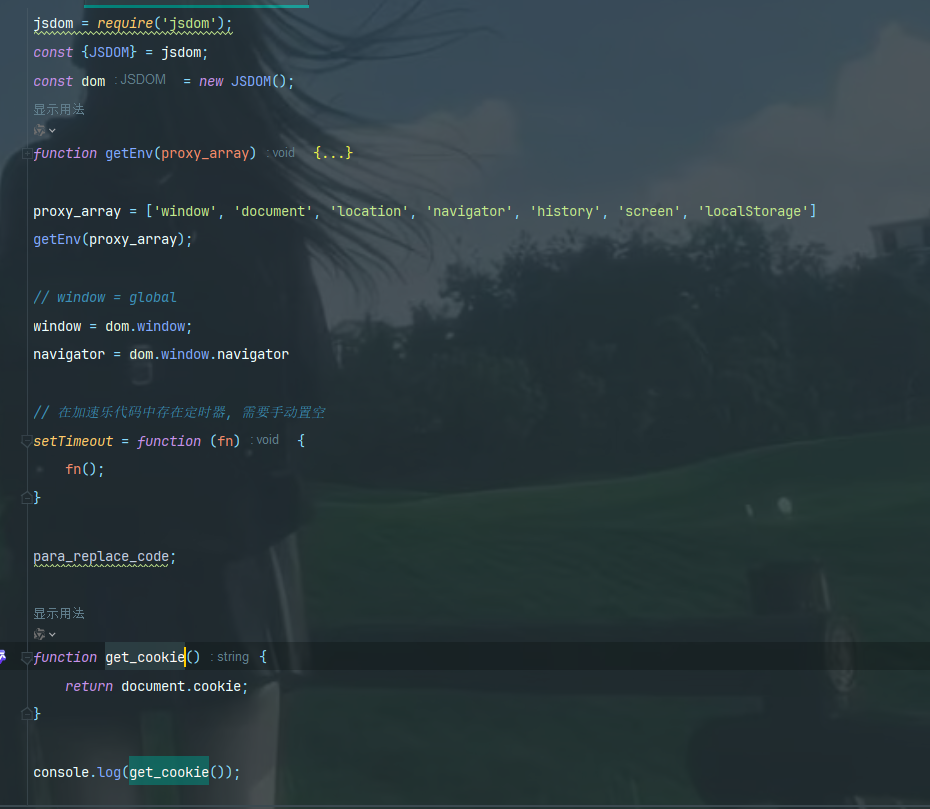
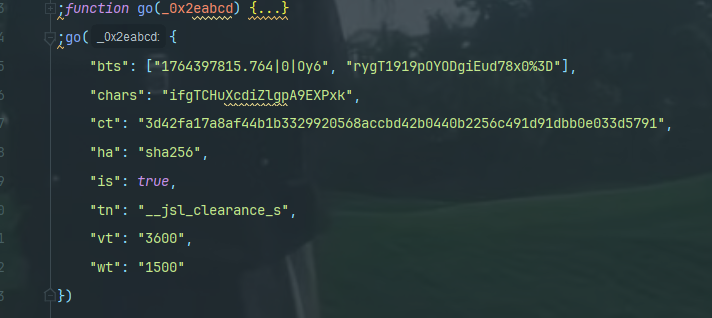
第二次的因为这些go里面的参数会变所以需要替换代码
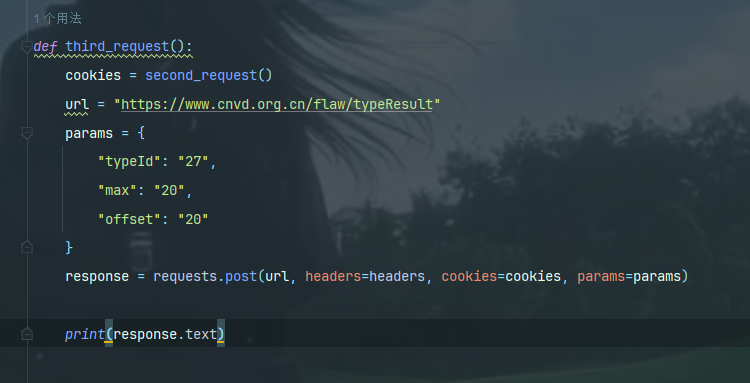
第三次
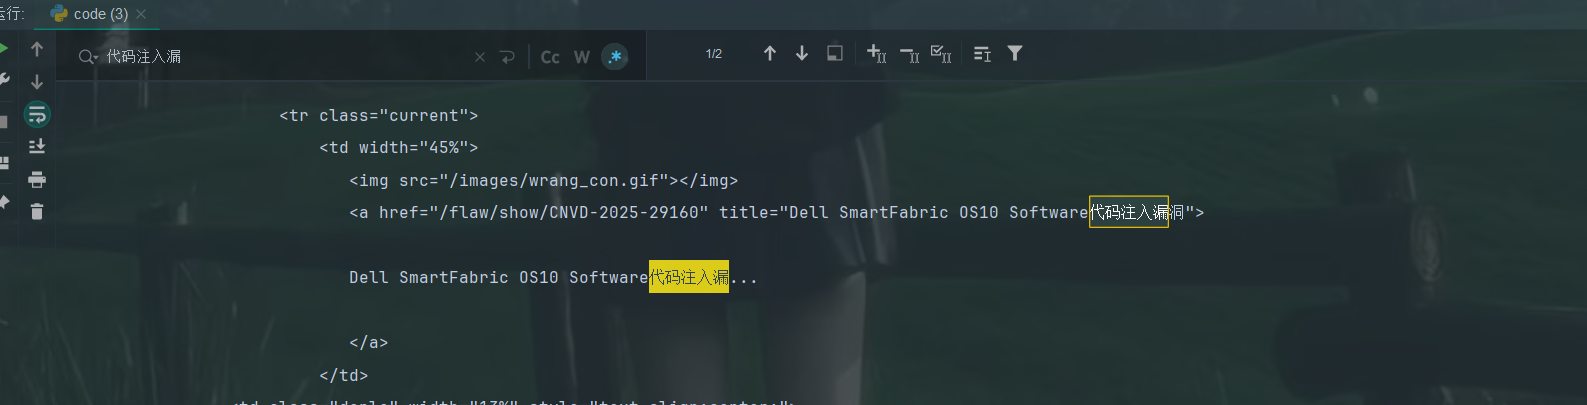
经过三次的请求就可以批量拿数据了
总结:这个案例非常锻炼人的思维逻辑,很有意思的,很适合正在学习爬虫的小伙伴们练习cookies的反爬

相关推荐
xyzzklk3 天前
在Open-WebUI中提升向量化速度
网络·人工智能·爬虫·ai·语言模型·自然语言处理·安卓
严肃小白兔3 天前
Cloudflare 开始区分 AI 爬虫与个人 Agent:网站访问控制应该怎样设计?
人工智能·爬虫
傻啦嘿哟6 天前
高德地图POI爬虫:爬取商户与景点数据,做LBS应用
爬虫
weixin199701080166 天前
官方授权通道和灰色爬虫,做数据服务该选哪条路(附 python 源码)
c++·爬虫·python
正飞信息技术7 天前
llms.txt部署指南:给AI爬虫一张清晰的网站地图
人工智能·爬虫
NeoGressAI外贸数字化9 天前
外贸独立站robots.txt怎么写:6个AI爬虫放行规则
人工智能·爬虫
OnlineProxy9 天前
移动应用数据爬取:通过模拟器与流量嗅探对 API 进行逆向工程
爬虫·python·httpx
傻啦嘿哟9 天前
分布式爬虫架构:Redis+Scrapy打造企业级爬虫系统
分布式·爬虫·架构
梯度下降者10 天前
零基础入门Python 爬虫
爬虫·python·数据分析·入门指南·webcrawler
2601_9679791210 天前
0 到 1 学爬虫:用 Python 爬取网页数据指南一(附实战案例)
爬虫·python·实战案例·html解析·网页数据