在智能语音处理领域,"双人同时说话"的重叠语音分离一直是一个高难度问题。很多企业应用,如智能客服、会议纪要、多麦克风设备,都需要把混在一条音轨里的两个人声音拆开,分别保存为独立的 wav 文件。
本文将手把手教你:
📌 一条混合的"双人同时说话"语音 → 输出为两条干净语音
【🚀🚀🚀如果你对人工智能的学习有兴趣可以看看我的其他博客,对新手很友好!🚀🚀🚀】
【🚀🚀🚀本猿定期无偿分享学习成果,欢迎关注一起学习!🚀🚀🚀】
一.🚀 为什么选 ClearVoice?
ClearVoice(ClearerVoice-Studio)是阿里云 ModelScope 团队开源的语音处理工具箱,具备:
| 能力模块 | 说明 |
|---|---|
| 降噪(Enhancement) | FRCRN、MossFormer 等顶级模型 |
| 多说话人分离(Separation) | MossFormer2_SS_16K 直接支持单通道重叠语音分离 |
| 目标说话人抽取(TSE) | 可基于参考音频抽取指定人物声音 |
| 授权 | Apache-2.0 友好商用许可 |
其中的 MossFormer2_SS_16K 专为单通道多说话人语音重叠分离设计,非常契合本文场景:
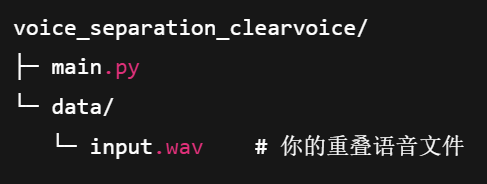
二.📂 工程目录结构
三.🔧 环境准备
推荐新环境安装:
bash
conda create -n sep_env python=3.10 -y
conda activate sep_env
安装依赖:
bash
pip install clearvoice soundfile⚠️注意
如果输入不是 WAV,确保已安装 ffmpeg:
bash
# Windows: 推荐 choco 安装(管理员 PowerShell)
choco install ffmpeg
如果你的机器带 GPU,并安装了 CUDA 版 PyTorch,分离速度会提升 3~10 倍。
四.🧠 核心代码
完整 main.py 如下👇
python
# main.py
# 功能:用 ClearVoice 的 MossFormer2_SS_16K 把一条混合男女声,分离为两条独立人声音频

import os
from pathlib import Path

from clearvoice import ClearVoice  # 来自 ClearerVoice-Studio

BASE_DIR = Path(__file__).resolve().parent
DATA_DIR = BASE_DIR / "data"
INPUT_WAV = DATA_DIR / "input.wav"          # 你的混合音频
OUTPUT_DIR = BASE_DIR / "output_separated"  # 输出目录

def main():
    if not INPUT_WAV.exists():
        raise FileNotFoundError(f"找不到输入文件: {INPUT_WAV}")

    os.makedirs(OUTPUT_DIR, exist_ok=True)

    print("======= ClearVoice 多说话人分离(MossFormer2_SS_16K)=======")
    print(f"[INFO] 输入文件: {INPUT_WAV}")
    print(f"[INFO] 输出目录: {OUTPUT_DIR}")

    # 初始化分离模型:任务 = speech_separation,模型 = MossFormer2_SS_16K
    separator = ClearVoice(
        task="speech_separation",
        model_names=["MossFormer2_SS_16K"]
    )

    # online_write=True 表示:直接把分离后的每个通道写到 OUTPUT_DIR 里
    separator(
        input_path=str(INPUT_WAV),
        online_write=True,
        output_path=str(OUTPUT_DIR)
    )

    # 列出输出结果,方便你看到文件名
    wavs = sorted(OUTPUT_DIR.glob("*.wav"))
    print("\n[RESULT] 分离完成,生成的文件:")
    for i, w in enumerate(wavs):
        print(f"  [{i}] {w.name}")

if __name__ == "__main__":
    main()
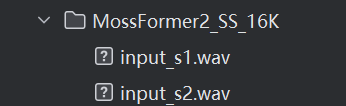
五.🚀分离结果
【非常清晰干净的两条人声】🚀🚀🚀🚀🚀
六.🚀传送门🚀
【企业级对话处理】自动估计说话人数 + 声纹聚类 + ASR 转写(FunASR + ModelScope + ClearVoice)-CSDN博客
搭配本猿的这篇博客,效果更佳哦!🚀🚀🚀