检索增强VS知识蒸馏VS伪标签扩展

(自用,希望对您也产生一点帮助)

这三种技术都可以让模型具备识别未知/未标注事物的能力

检索增强(查资料):不仅仅依赖于模型本身的参数(参数化模型),还可以通过检索外部知识库(非参数化记忆)的相关信息,提高模型表现。

知识蒸馏 (拜师学艺):是让一个轻量级的"学生模型"去学习一个"重量级"的教师模型。精髓在于让学生模型去学习教师模型输出的富含"暗知识"的概率分布。但教师模型输出的概率分布往往比较"硬",例如0.01,0.12,0,0,0,0.87这种,为了让隐藏在极小概率值中的"暗知识"更容易被学生学习,需要将其软化,例如0.1,0.3,0.07,0,0.03,0.5这种。通过引入温度T即可解决这个问题。
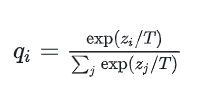
当T=1时,是标准的softmax函数,T>1时,软化过程,0<T<1时,硬化过程。

学生模型的损失函数由两部分组成,第一部分保证模型具备独立解决问题的能力(当T=1时,模型的预测结果与真实标签的交叉熵损失),第二部分是为了保证模型能学习到教师模型的暗知识(当T1=T2>1时,教师模型与学生模型预测结果概率分布的KL散度,衡量两个分布之间的差异)
知识蒸馏

伪标签扩展(自学成才):用模型去对未标注数据进行预测,预测的类别可能来源于一个大的词汇表(之前可能都没见过),选择置信度高的预测,将它们视为这批数据的伪标签,用这些带有伪标签的新数据来重新训练或微调检测器

相关推荐
Solange__10 分钟前
Blender 3D模型优化:普通复制、共享网格、实例、合并怎么选?
人工智能·3d·ai·自然语言处理·编辑器·blender·材质
师夷长技以自愈13 分钟前
手搓 AI Agent 第 8 篇:从手写循环到画流程图——LangGraph 封装
人工智能·python
数据治理自习室27 分钟前
2026最新:MCP开发与使用指南
人工智能
小小疯狐狸30 分钟前
我踩过的Agent harness几个坑:上下文越跑越慢
人工智能
kaixin_啊啊1 小时前
【零基础学AI】第 30 章——对话记录与结构化输出
人工智能
aifannihao1 小时前
Rust 1.100 的 DropGuard:用 Python 实测失败回滚与吞异常
python·rust·异常处理·标准库·contextlib
泯泷2 小时前
让知识"长骨架"——RAPTOR、GraphRAG 与 OpenViking(四)
人工智能·llm
kaixin_啊啊2 小时前
【零基础学AI】第 30 章课后练习与答案
人工智能
电科_银尘2 小时前
【深度学习项目实战·33】自定义数据集:把自己的图片接入PyTorch
人工智能·pytorch·深度学习
武子康3 小时前
单卡 A6000 跑 Qwen-Drive:怎样留下可比较的第一条基线?
linux·人工智能·深度学习