https://github.com/stefanokratzdisteln-hash/Web-Crawler-Steamdt
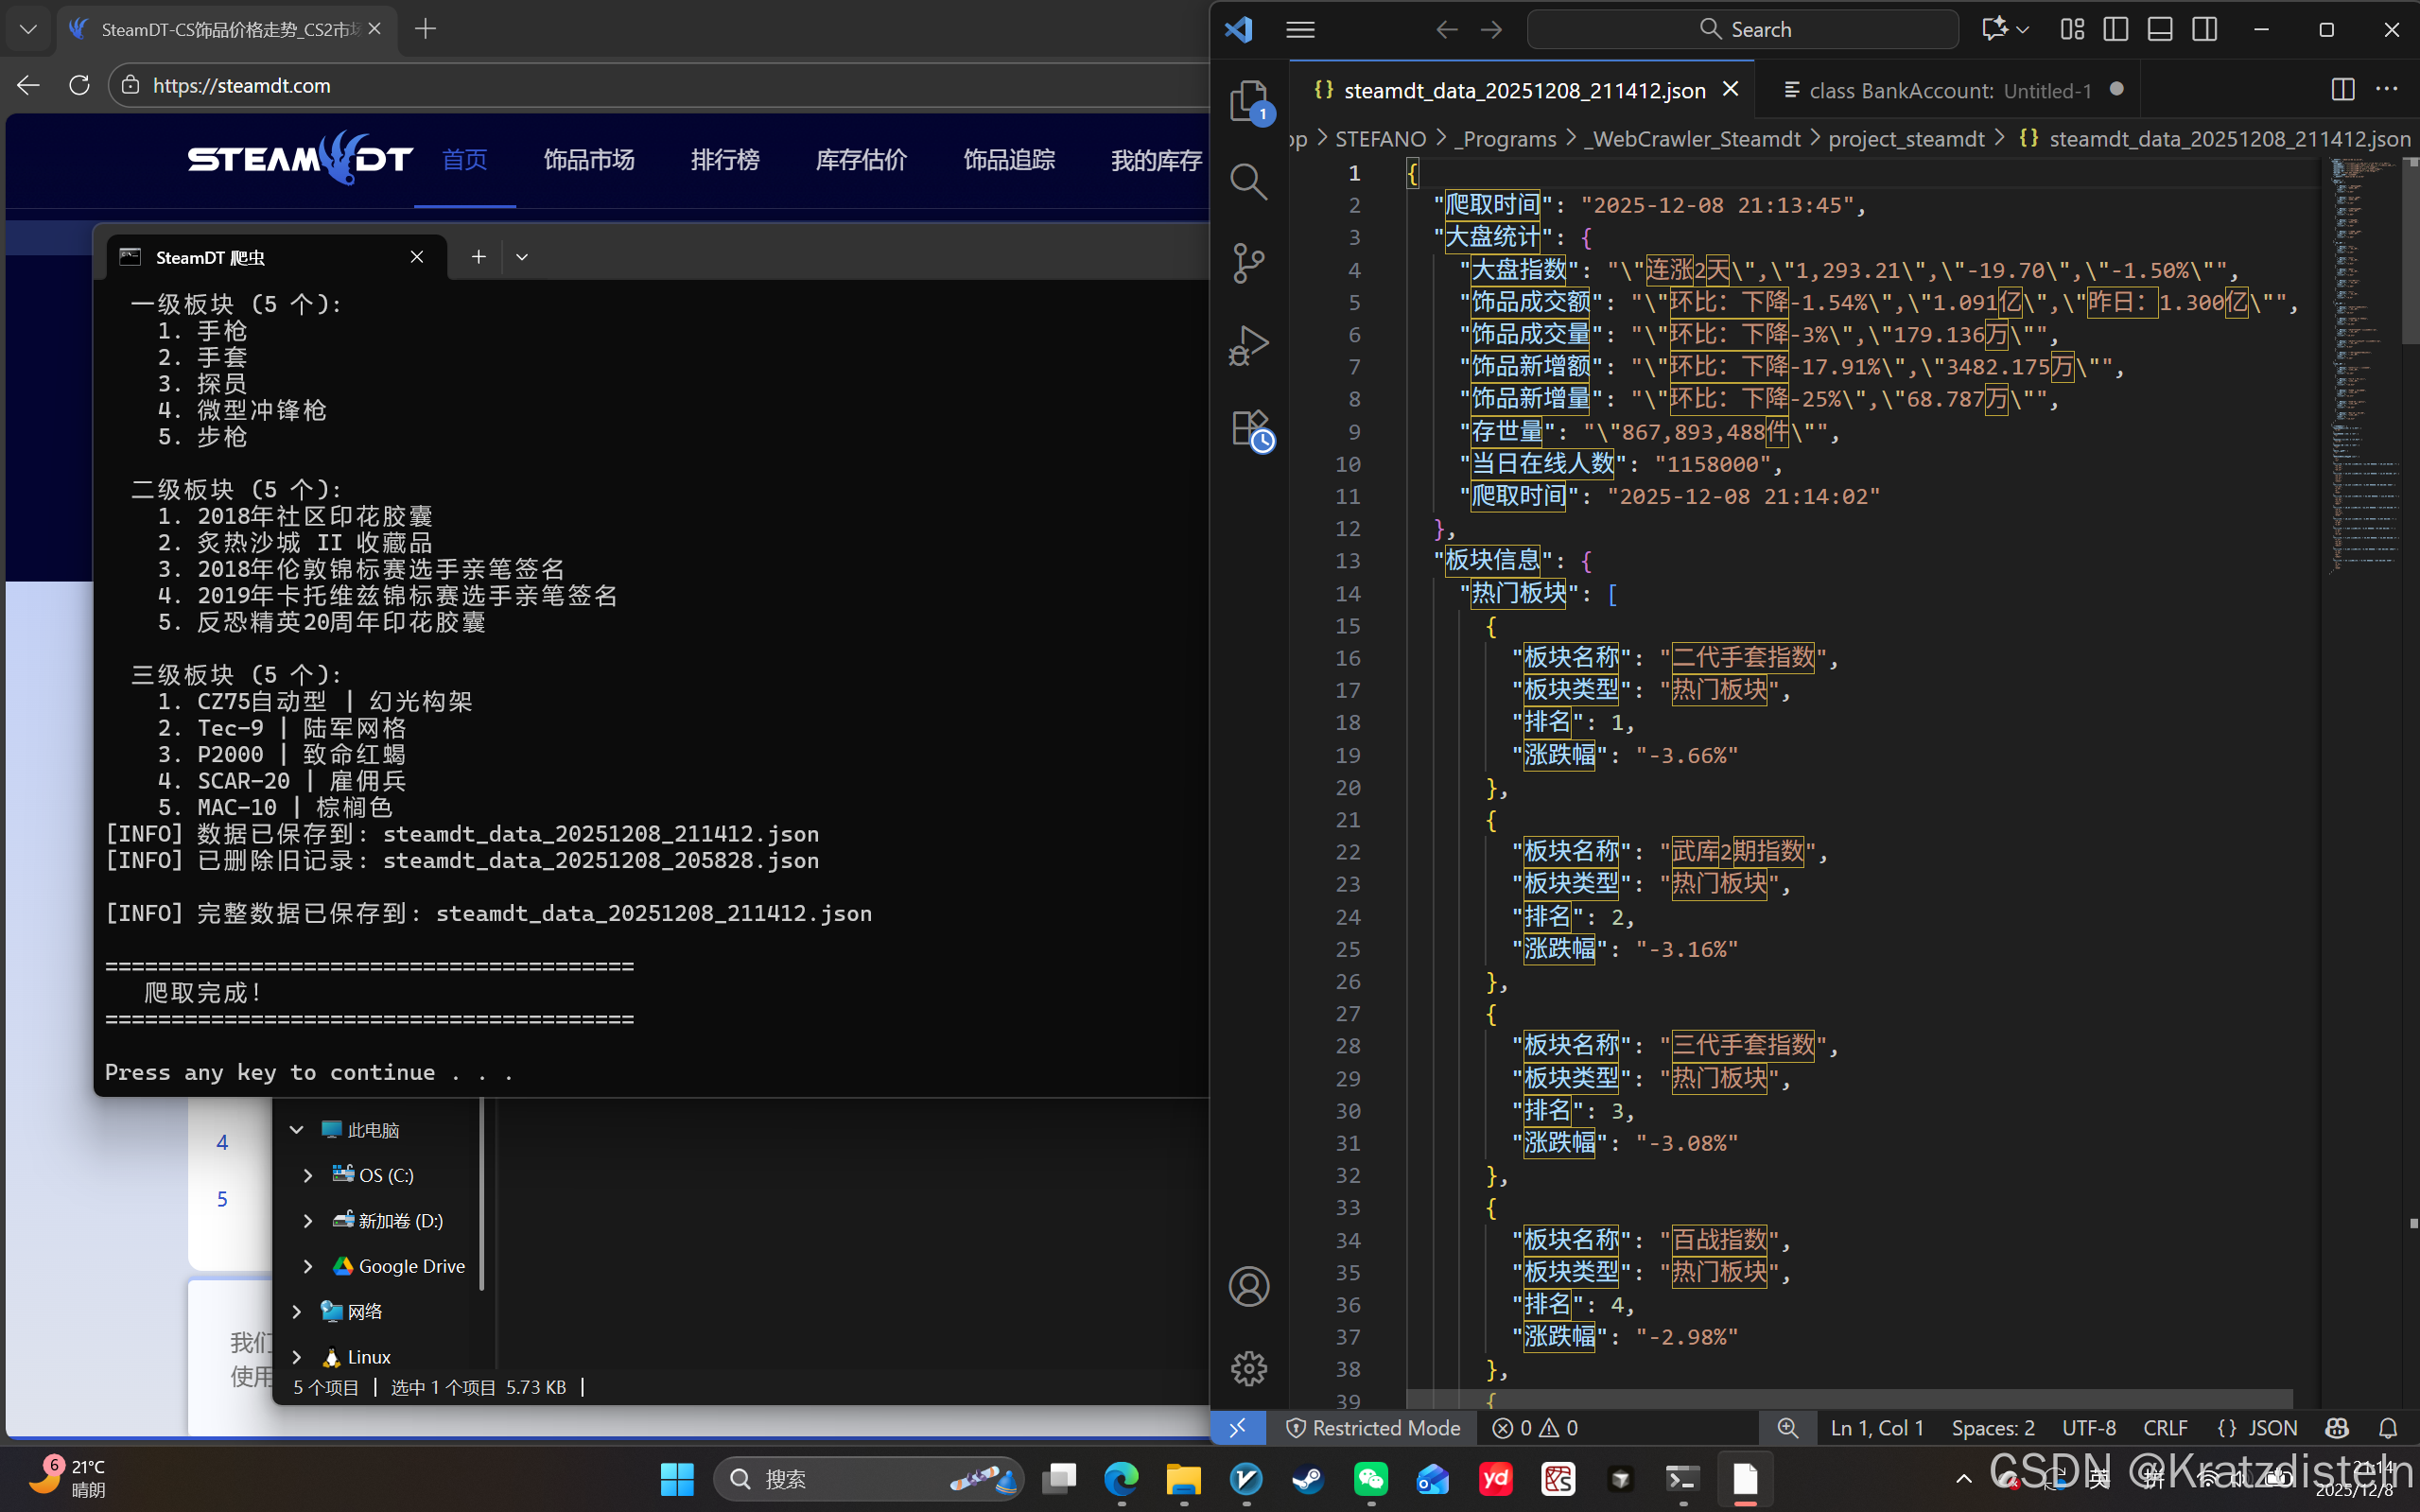
以下是 steamdt_crawler.py 中的主要知识点整理,适合有 Python 基础的学习者学习爬虫:
一、爬虫基础与工具选择
1. 动态 vs 静态网页爬取
- Playwright:用于处理 JavaScript 动态渲染的网页(现代 SPA 应用)
- Requests + BeautifulSoup:用于静态 HTML 页面(传统网页)
- 代码中通过
PLAYWRIGHT_AVAILABLE判断并自动降级
2. 环境与编码处理
python
# Windows 控制台编码修复
if sys.platform == 'win32':
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8')- 解决 Windows 下中文乱码问题
- 使用
io.TextIOWrapper重定向标准输出编码
二、Playwright 爬虫框架
1. 基本使用流程
python
with sync_playwright().start() as playwright:
    browser = playwright.chromium.launch(headless=True)
    page = browser.new_page()
page.goto(url)- 无头浏览器 :
headless=True - 模拟用户代理 :设置
user_agent - 页面等待策略 :
wait_for_load_state('networkidle')
2. 元素定位与交互
page.inner_text('body'):获取页面文本page.query_selector_all('tr, div'):CSS 选择器查找元素page.evaluate():执行 JavaScript 代码
三、数据提取与解析
1. 正则表达式(re 模块)
- 提取数字模式:
r'([\d,]+\.\d+)' - 提取百分比:
r'([+-]?\d+\.?\d*%)' - 提取带单位的值:
r'([\d,]+\.\d+[万亿])'
2. 数据清洗与验证
python
def _extract_numeric_candidates(self, text: str) -> List[str]:
    # 过滤干扰项(如百分比)
    if '%' in before or '%' in after:
continue- 避免提取到环比数据等干扰项
- 通过位置判断数据类型
3. 多级板块数据解析
- 板块结构:热门板块 → 一级板块 → 二级板块 → 三级板块
- 数据格式:排名 + 名称 + 涨跌幅
- 去重机制 :使用
set()避免重复数据
四、错误处理与调试
1. 异常捕获
python
try:
    # 可能出错的操作
except PlaywrightTimeoutError:
    print("[WARNING] 页面加载超时")
except Exception as e:
    print(f"[ERROR] 其他错误: {e}")
traceback.print_exc()- 区分不同类型的异常
- 使用
traceback.print_exc()打印完整堆栈
2. 调试信息输出
python
debug_filename = f"debug_page_{datetime.now().strftime('%Y%m%d_%H%M%S')}.txt"
with open(debug_filename, 'w', encoding='utf-8') as f:
f.write(page_text)- 将页面内容保存到文件,便于分析网页结构
- 使用时间戳命名,避免覆盖
五、数据存储与管理
1. JSON 格式存储
python
with open(filename, 'w', encoding='utf-8') as f:
json.dump(data, f, ensure_ascii=False, indent=2)ensure_ascii=False:保留中文字符indent=2:格式化输出,便于阅读
2. 文件管理
python
old_files = glob.glob("steamdt_data_*.json")
old_files.sort(key=os.path.getmtime, reverse=True)- 使用
glob查找匹配的文件 - 按修改时间排序,保留最新文件
- 自动清理旧数据文件
六、代码结构与设计模式
1. 面向对象编程
- 类封装 :
SteamDTCrawler类封装所有爬虫功能 - 上下文管理器 :
__enter__和__exit__管理资源 - 类型注解:提高代码可读性和 IDE 提示
2. 模块化设计
- 分离关注点 :
extract_market_stats():提取大盘数据extract_sections():提取板块数据save_to_json():保存数据
- 辅助方法 :
_extract_numeric_candidates()等私有方法
七、高级技巧与最佳实践
1. 多策略数据提取
python
# 方法1:正则表达式匹配
# 方法2:DOM 元素查找
# 方法3:JavaScript 执行
# 方法4:文本行分析- 多种方法互补,提高爬虫健壮性
- 逐步降级策略
2. 等待与加载策略
wait_for_load_state('networkidle'):等待网络空闲time.sleep(3):显式等待 JS 执行window.scrollTo():滚动页面触发懒加载
3. 防反爬虫策略
python
args=['--disable-blink-features=AutomationControlled']- 禁用自动化控制特征
- 模拟真实浏览器行为
学习建议
- 先掌握基础:Requests + BeautifulSoup 处理静态页面
- 再学动态爬虫:Playwright/Selenium 处理 JS 渲染页面
- 重视正则表达式:数据清洗的关键工具
- 学会调试:保存页面内容,分析网页结构
- 注意反爬虫:合理设置请求间隔,尊重 robots.txt
代码亮点总结
| 知识点 | 应用场景 | 学习价值 |
|---|---|---|
| Playwright | 动态网页爬取 | 现代爬虫必备技能 |
| 正则表达式 | 数据提取与清洗 | 文本处理核心能力 |
| 错误处理 | 爬虫稳定性 | 生产级代码要求 |
| 数据存储 | 结果持久化 | 数据处理完整流程 |
| 模块化设计 | 代码可维护性 | 工程化思维培养 |
这份代码是一个完整的生产级爬虫示例,涵盖了从爬取、解析、清洗到存储的全流程,非常适合作为学习爬虫的进阶案例。