机器学习——交叉熵损失函数

调用示例

python 复制代码
loss_fun = F.cross_entropy()

loss = loss_fun(y_pred, labels)

一句话描述

交叉熵损失函数是描述:预测的概率分布 和真实概率分布之间差异的损失函数。差异越大,损失值越高;差异越小,损失值越低。

举例说明

假设有一只猫的图片,我们采用一个三分类(猫,狗,鸟)的模型进行预测

真实标签(one-hot 编码):1, 0, 0

表示 100% 是猫。

模型预测概率(经过 softmax 后):

0.7, 0.2, 0.1

模型认为 70% 可能是猫,20% 狗,10% 鸟。

公式

对于二分类任务
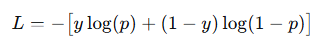
对于多分类任务
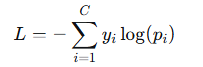
带入例子

真实标签:y=1,0,0

预测概率:p=0.7,0.2,0.1

则有:
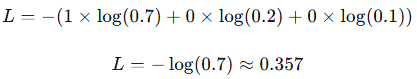
总结

假设预测概率特别低(比如 0.01),那么根据log函数的特性,可以知道,越接近0其损失值会越大。越接近1损失越小。
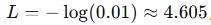
相关推荐
独码侠1 小时前
第 04 篇·DeepSeek Harness 沙箱实测:AI 替代测试开发 3.4→4.6,差距只在一个权限模式
人工智能
java资料站1 小时前
十四、SpringAi-RAG《知识库AI问答系统》实战项目介绍
人工智能
当下新鲜事1 小时前
皮尔磁纸板进料安全方案怎么选:myPNOZ与O300组合使用经验分享
网络·人工智能·安全
染指11101 小时前
139.Agent-多Agent框架-Skills渐进式加载文档
数据库·人工智能·langchain·agents
知几蜗牛1 小时前
Java 17实现Agent工具调用的白名单、预算与审计门禁
人工智能
橘和柠1 小时前
vLLM高吞吐推理引擎:本地高并发推理服务
人工智能
小林ixn1 小时前
别再手写 Agent 基建了:用 deepagents 中间件,30 行代码搞定文件系统 / 记忆 / 上下文压缩
人工智能·langchain
云和数据.ChenGuang1 小时前
langchain4j InMemoryEmbeddingStore常用的方法
java·人工智能·windows·java-ee·fastapi·springai
小天源1 小时前
GEO 品牌监测系统实战:基于 Node.js + Playwright 实现多平台采集与报告导出
人工智能·node.js·geo·品牌检测·ai诊断
skywalk81632 小时前
光明语言入榜计划:GitHub Linguist 注册指南・光明语言模块参考
人工智能·编程·光明