优化内容
核心优化点:
将一个循环规约变成rvv形式的
原代码:
cpp
ggml_float sum = 0.0;
for (int64_t i00 = 0; i00 < ne00; i00++) {
    sum += (ggml_float)(x[i00] * x[i00]);
}

const float mean = sum/ne00;
优化后:
cpp
size_t vl = __riscv_vsetvl_e32m4(ne00);
vfloat64m8_t sum_vec = __riscv_vfmv_v_f_f64m8(0.0, __riscv_vsetvl_e64m8(ne00));

int64_t i00 = 0;
for (; i00 <= ne00 - (int64_t)vl; i00 += (int64_t)vl) {
   vl = __riscv_vsetvl_e32m4(ne00 - i00);

   // 加载fp32数据
   vfloat32m4_t x_vec_f32 = __riscv_vle32_v_f32m4(&x[i00], vl);

   // 将fp32扩展为fp64 - 使用正确的类型转换
   vfloat64m8_t x_vec_f64 = __riscv_vfwcvt_f_f_v_f64m8(x_vec_f32, vl);

   // 在fp64精度下计算平方
   vfloat64m8_t square_vec = __riscv_vfmul_vv_f64m8(x_vec_f64, x_vec_f64, vl);

   // fp64精度累加
   sum_vec = __riscv_vfadd_vv_f64m8(sum_vec, square_vec, vl);
}

// 规约求和(fp64精度)
vfloat64m1_t vec_sum = __riscv_vfmv_v_f_f64m1(0.0f, vl);
vec_sum = __riscv_vfredusum_vs_f64m8_f64m1(sum_vec, vec_sum, vl);

double sum = __riscv_vfmv_f_s_f64m1_f64(vec_sum);
效果评估
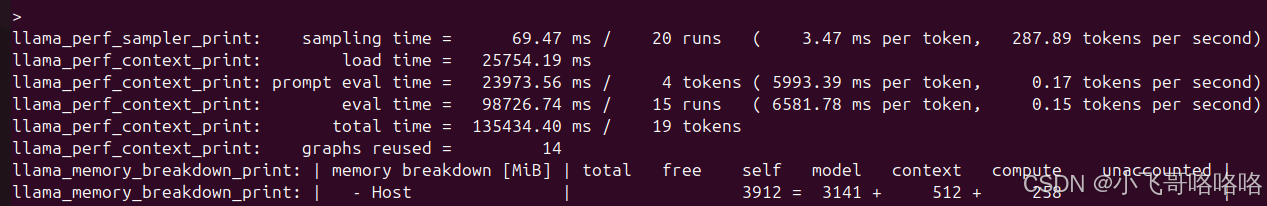
不适用RVV
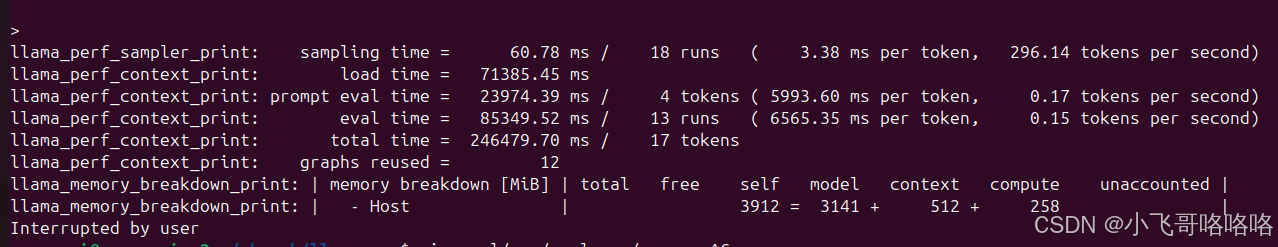
开启RVV,但使用redosum(效率较低)
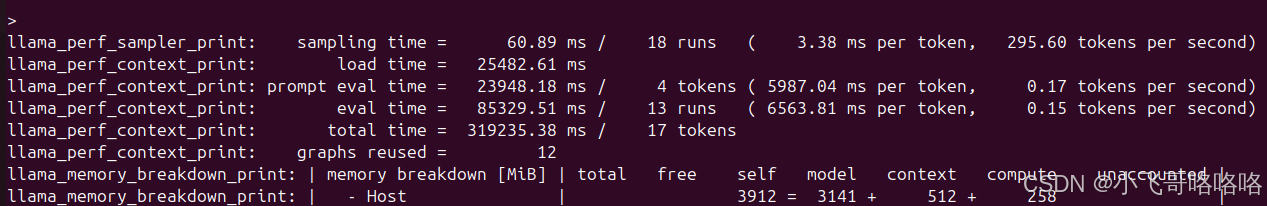
开启RVV,使用redusum
开RVV基础上使用redusum同时使用float32进行
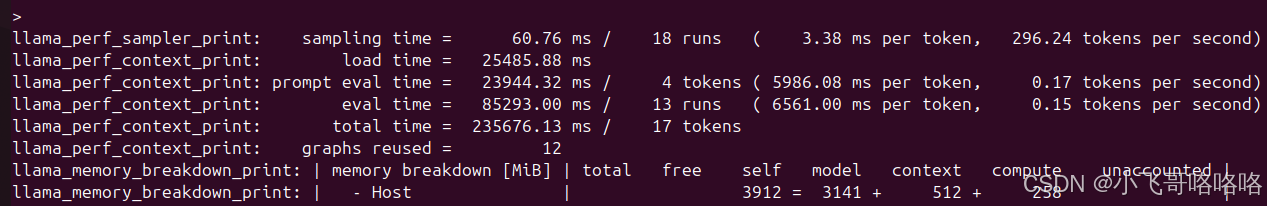
使用到rms_norm的部分,主要包含在prompt eval 和 eval两个阶段,可以看到,二者对应的时间也是在减小的,优化比在0.12%和0.31%