文章目录
-
-
- [1、Kafka 为什么能高效读写数据](#1、Kafka 为什么能高效读写数据)
- 2、副本数设定
- 3、如何提升吞吐量
- 4、Kafka丢不丢数据
- 5、Kafka数据重复
-
1、Kafka 为什么能高效读写数据
-
1)Kafka 本身是分布式集群,可以采用分区技术,并行度高
-
2)读数据采用稀疏索引,可以快速定位要消费的数据
-
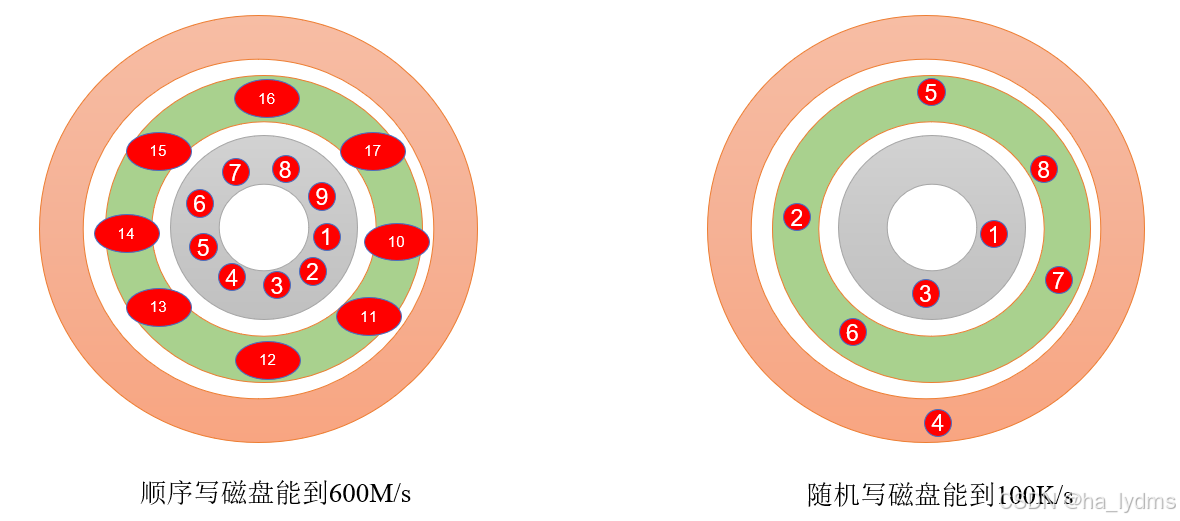
3)顺序写磁盘
Kafka 的 producer 生产数据,要写入到 log 文件中,写的过程是一直追加到文件末端,
为顺序写。官网有数据表明,同样的磁盘,顺序写能到 600M/s,而随机写只有 100K/s。这
与磁盘的机械机构有关,顺序写之所以快,是因为其省去了大量磁头寻址的时间。
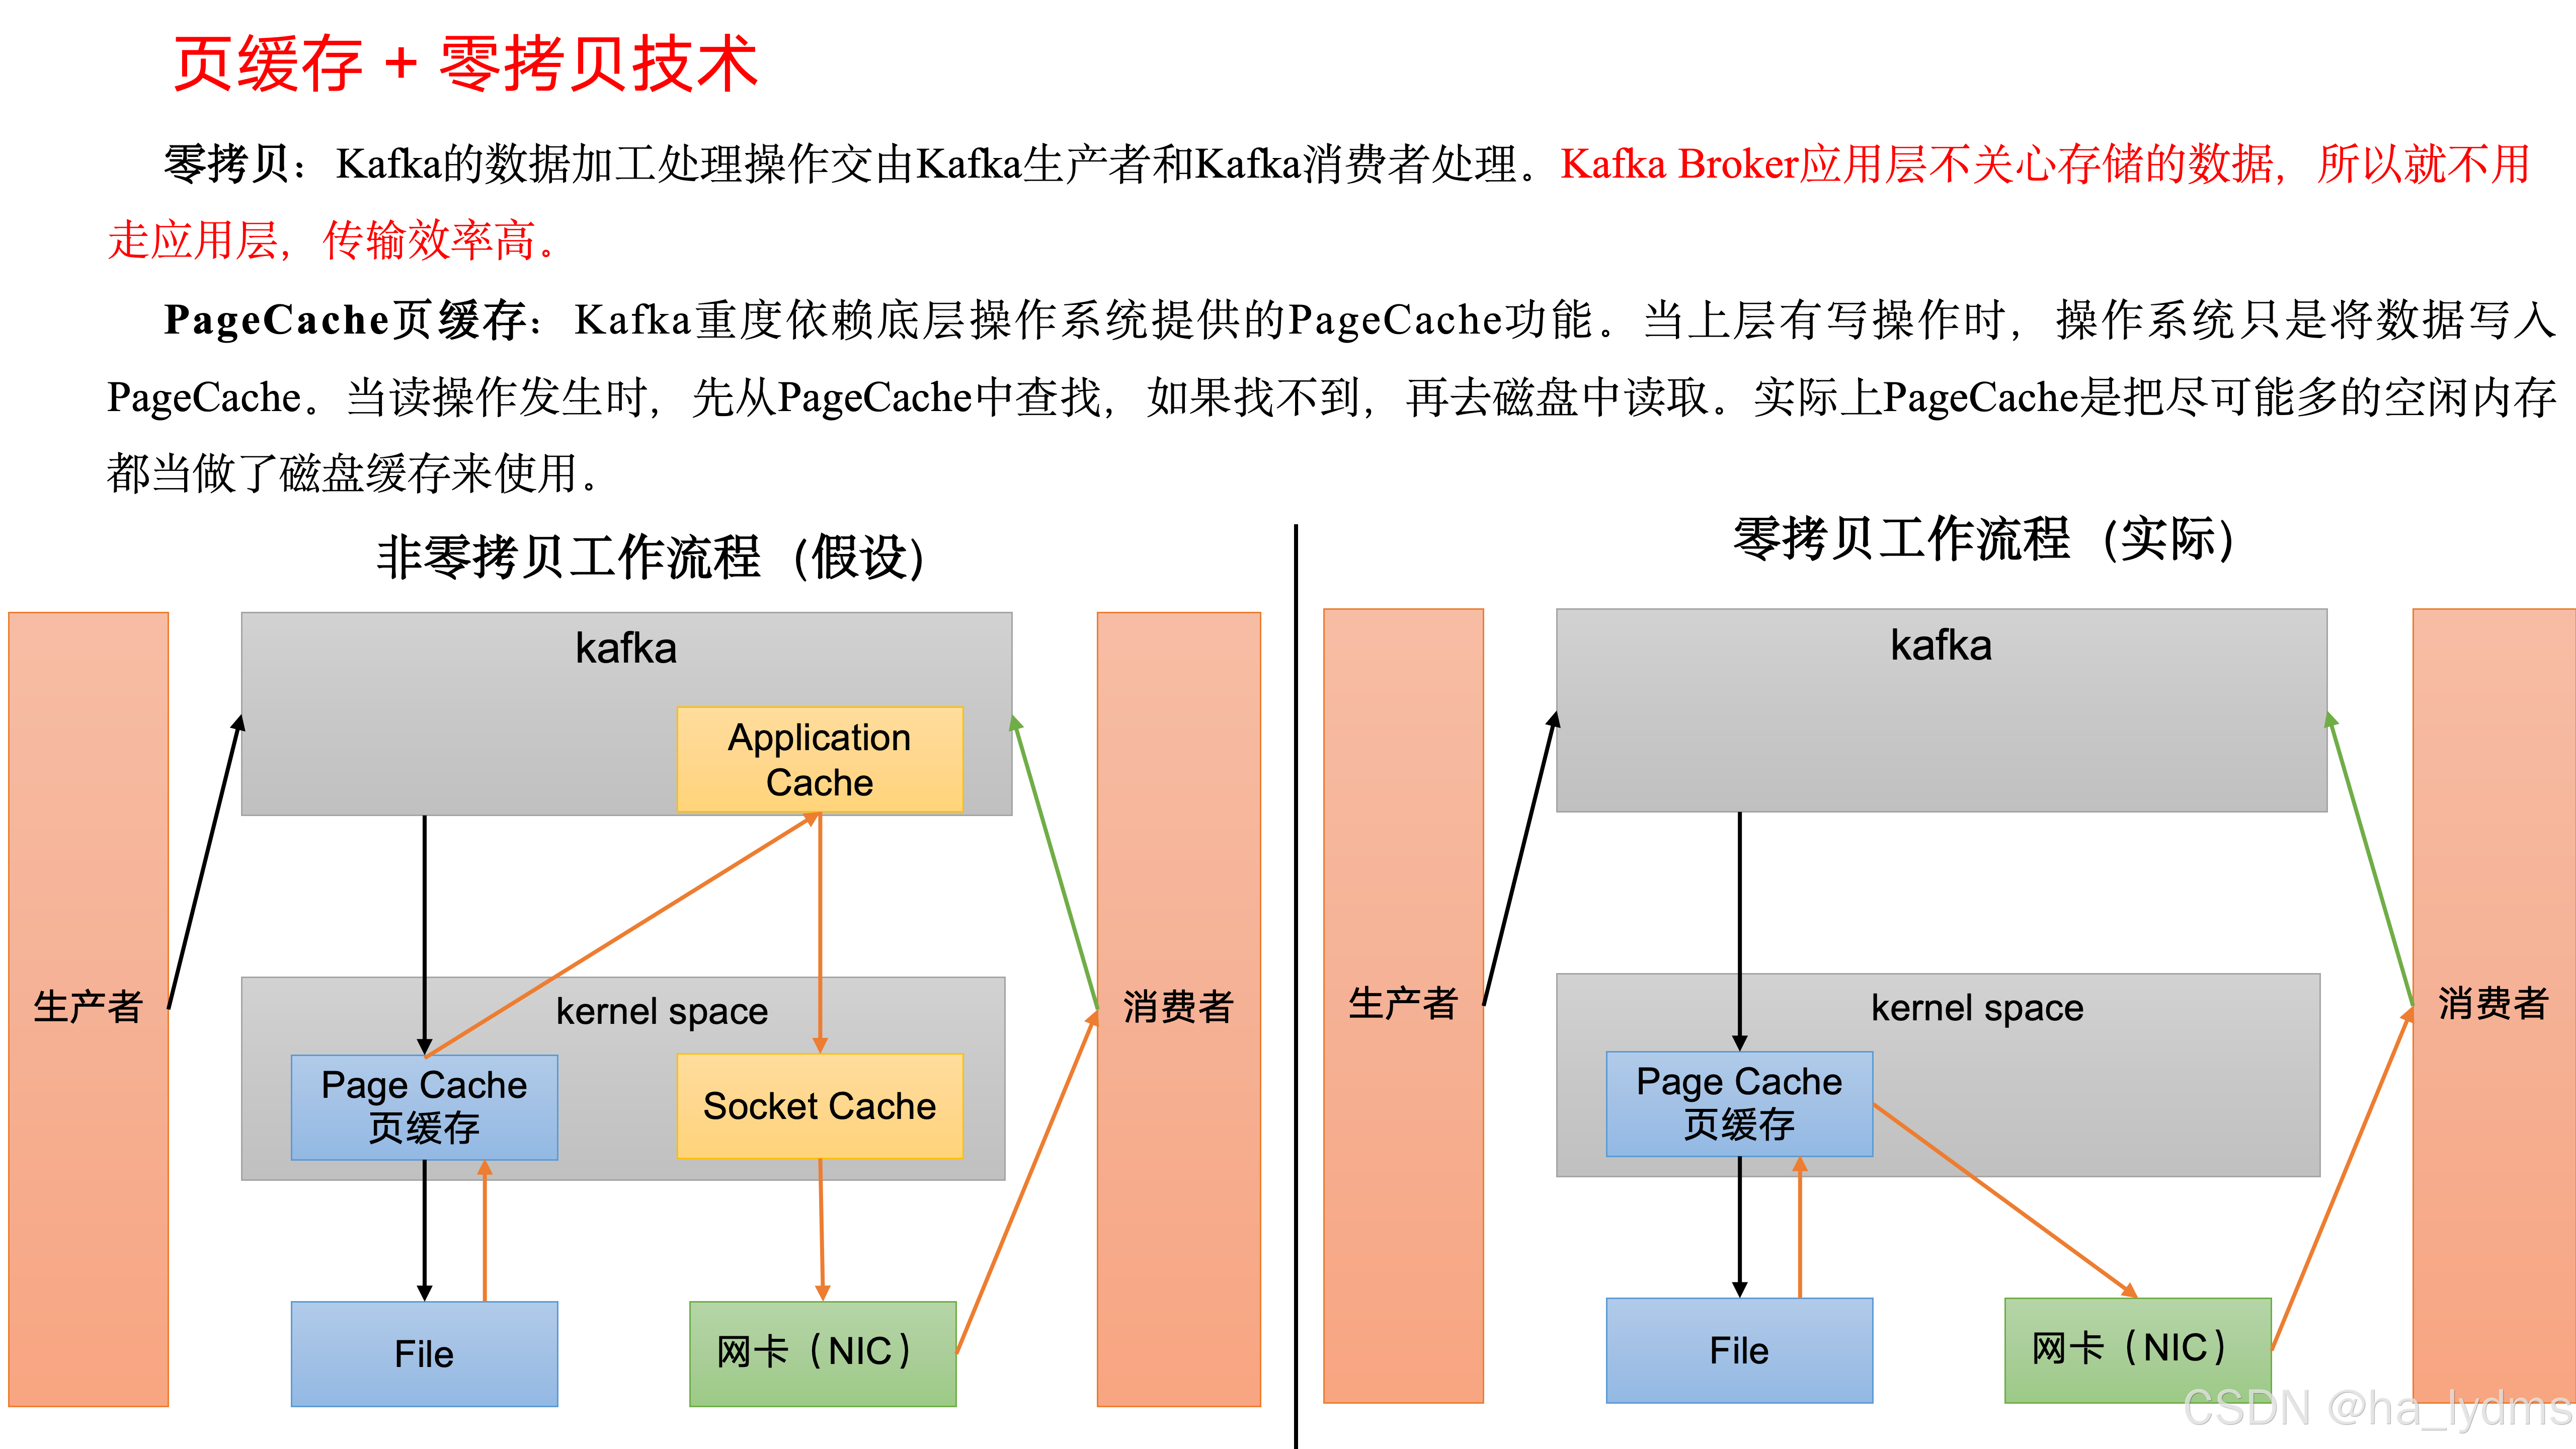
- 4)页缓存+ 零拷贝技术
2、副本数设定
一般我们设置成2个或3个,很多企业设置为2个。
副本的优势:提高可靠性;副本劣势:增加了网络IO传输。
3、如何提升吞吐量
如何提升吞吐量?
-
1)提升生产吞吐量
- (1)
buffer.memory:发送消息的缓冲区大小,默认值是32m,可以增加到64m。 - (2)
batch.size:默认是16k。如果batch设置太小,会导致频繁网络请求,吞吐量下降;如果batch太大,会导致一条消息需要等待很久才能被发送出去,增加网络延时。 - (3)
linger.ms,这个值默认是0,意思就是消息必须立即被发送。一般设置一个5-100毫秒。如果linger.ms设置的太小,会导致频繁网络请求,吞吐量下降;如果linger.ms太长,会导致一条消息需要等待很久才能被发送出去,增加网络延时。 - (4)
compression.type:默认是none,不压缩,但是也可以使用lz4压缩,效率还是不错的,压缩之后可以减小数据量,提升吞吐量,但是会加大producer端的CPU开销。
- (1)
-
2)增加分区
-
3)消费者提高吞吐量
- (1)调整fetch.max.bytes大小,默认是50m。
- (2)调整max.poll.records大小,默认是500条。
4、Kafka丢不丢数据
-
1)Producer角度
acks=0,生产者发送过来数据就不管了,可靠性差,效率高;acks=1,生产者发送过来数据Leader应答,可靠性中等,效率中等;acks=-1,生产者发送过来数据Leader和ISR队列里面所有Follwer应答,可靠性高,效率低;- 在生产环境中,
acks=0很少使用;acks=1,一般用于传输普通日志,允许丢个别数据;acks=-1,一般用于传输和钱相关的数据,对可靠性要求比较高的场景。
-
2)Broker角度
- 副本数大于等于2。
min.insync.replicas大于等于2。
5、Kafka数据重复
去重 = 幂等性 + 事务
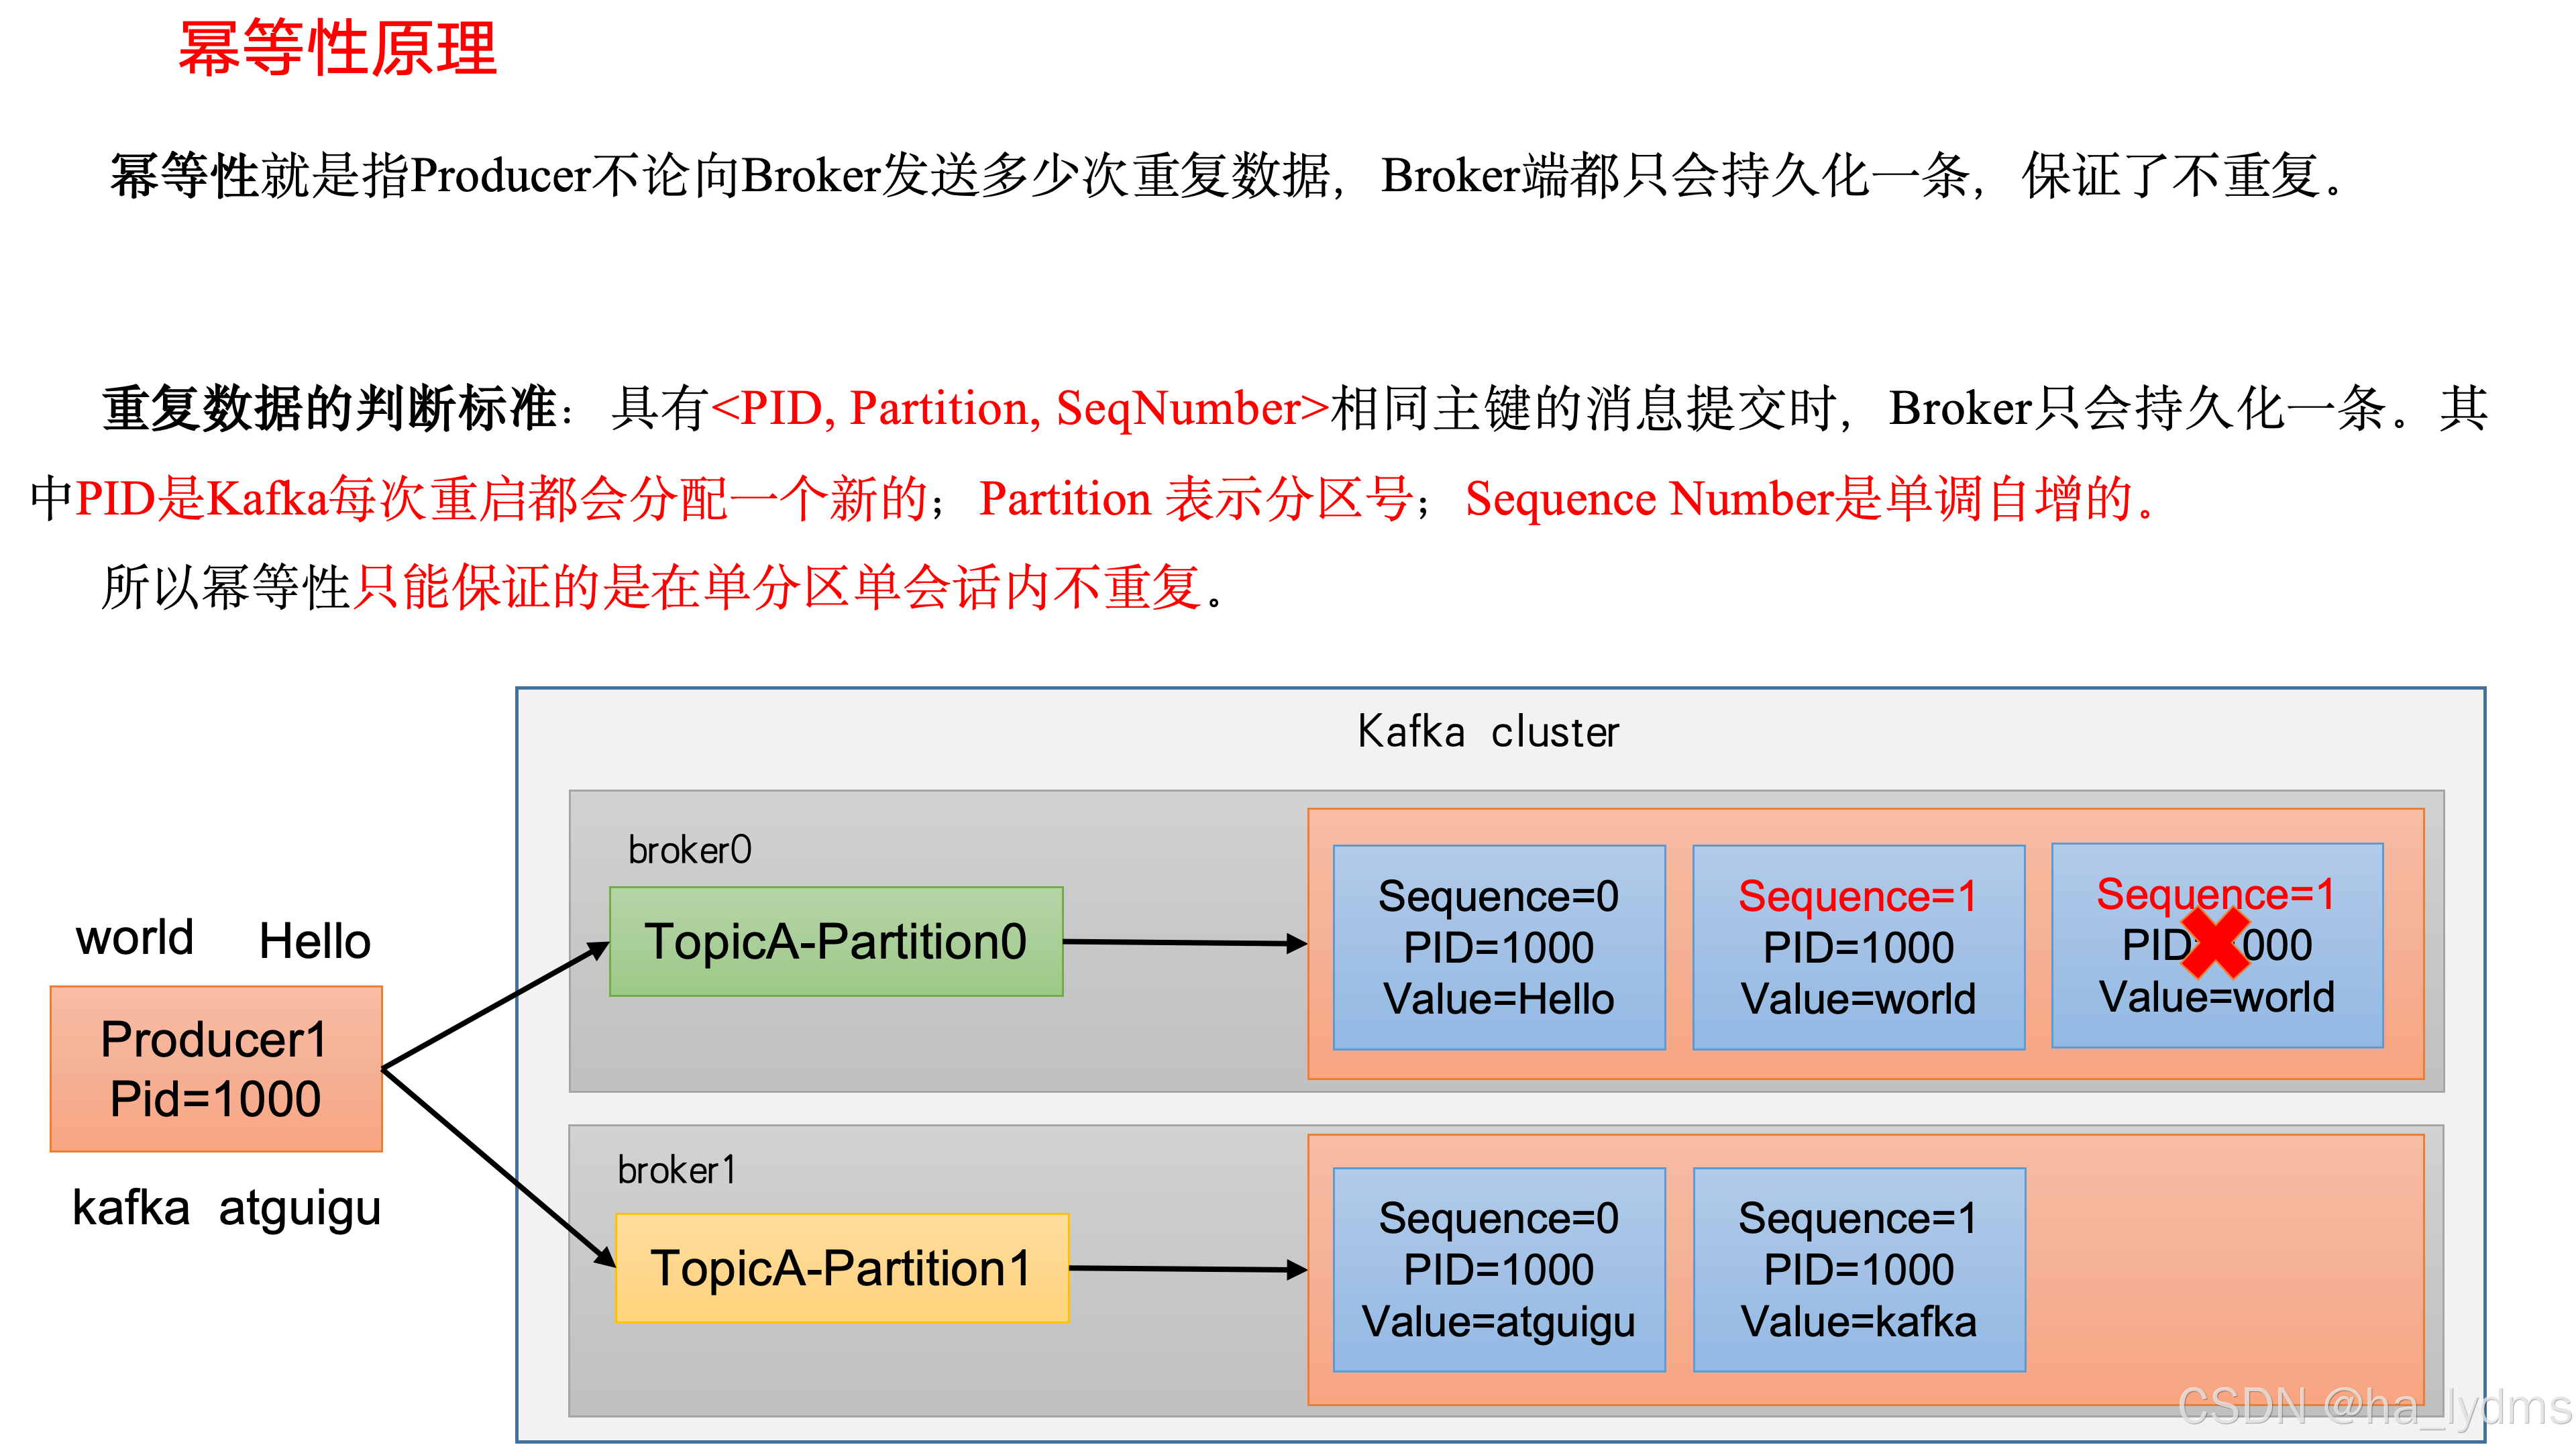
- 1)幂等性配置参数
| 参数名称 | 描述 |
|---|---|
| enable.idempotence | 是否开启幂等性,默认true,表示开启幂等性。 |
| max.in.flight.requests.per.connection | 1.0.X版本前,需设置为1,1.0.X之后,小于等于5 |
| retries | 失败重试次数,需要大于0 |
| acks | 需要设置为all |
- 2)Kafka的事务一共有如下5个API
java
// 1初始化事务
void initTransactions();

// 2开启事务
void beginTransaction() throws ProducerFencedException;

// 3在事务内提交已经消费的偏移量(主要用于消费者)
void sendOffsetsToTransaction(Map<TopicPartition, OffsetAndMetadata> offsets,
                              String consumerGroupId) throws ProducerFencedException;

// 4提交事务
void commitTransaction() throws ProducerFencedException;

// 5放弃事务(类似于回滚事务的操作)
void abortTransaction() throws ProducerFencedException;- 3)总结
- (1)生产者角度
- acks设置为-1 (acks=-1)。
- 幂等性(enable.idempotence = true) + 事务 。
- (3)broker服务端角度
-
分区副本大于等于2 (--replication-factor 2)。
-
ISR里应答的最小副本数量大于等于2 (min.insync.replicas = 2)。
-
(3)消费者
- 事务 + 手动提交offset (enable.auto.commit = false)。
- 消费者输出的目的地必须支持事务(MySQL、Kafka)。
-
- (1)生产者角度