十一、Flink基础环境实战

实验过程:

首先,拍快照

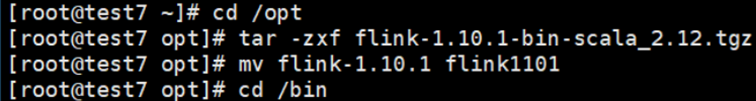
1、进入opt目录

cd /opt

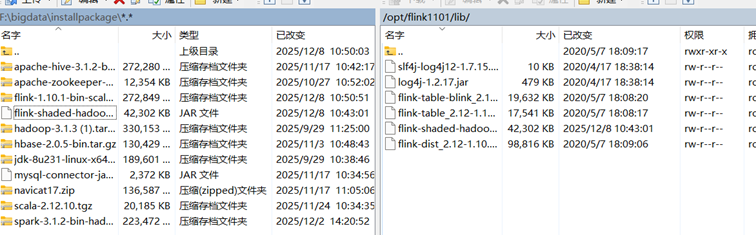
2、上传 flink 的 tgz 包到服务器
3.解压到当前路径

tar -zxf flink-1.10.1-bin-scala_2.12.tgz

4.改名字

mv flink-1.10.1 flink1101
5.将 flink-shaded-hadoop-2-uber-2.8.3-10.0.jar 放置到 lib 目录下

6.启动 flink

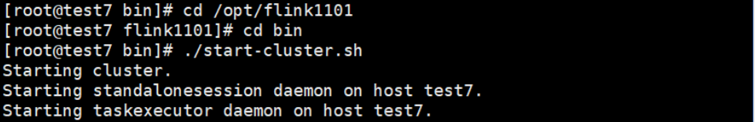
进入到 flink 的 bin 目录

./start-cluster.sh
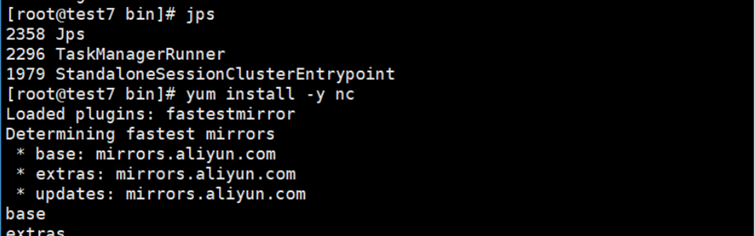
7.jps 测试 ==> 如果出现 StandaloneSessionClusterEntrypoint 说明成功
8.测试访问:http:// 服务器 ip 地址:8081
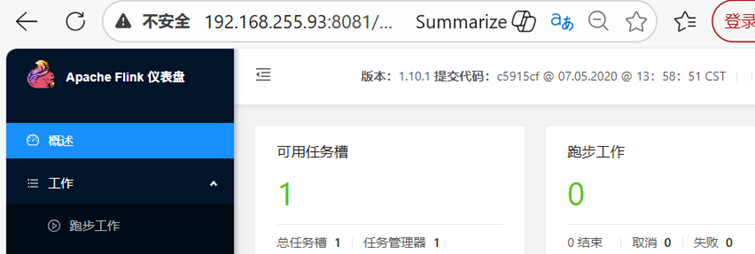
9.安装 nc 工具yum install -y nc
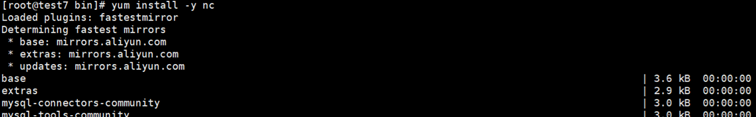
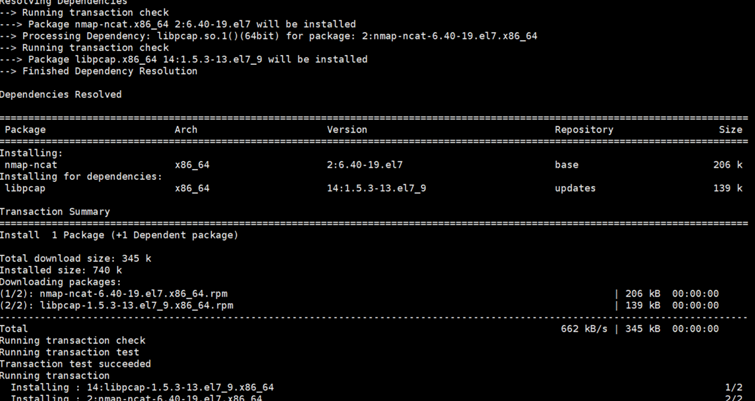
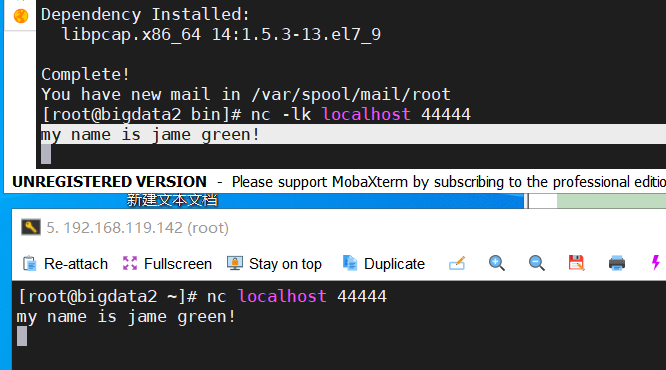
10.nc -lk localhost 4444

11.重新开一个终端(复制会话)

nc localhost 4444

12. 测试:

在新会话中输入一串内容,原会话中也会出现。
实验结束。

相关推荐
上海潭龙东海科技有限公司6 小时前
智慧堆场动态模型三维实时孪生重构智能管控
大数据·网络·数据库·算法·重构
尹文祥7 小时前
Apache Doris 2.1.10:存储结构、索引与查询优化详解
大数据
isfox9 小时前
Hadoop 序列化:为什么不用 Java 自带 Serializable?
大数据
字节跳动数据平台11 小时前
火山引擎 VeKnow 落地指南(下):从知识编译到价值渗透
大数据
AI源码12 小时前
基于Spark的期刊推荐系统的设计与实现
大数据·分布式·spark
玩美数据12 小时前
海外市场数据分析驱动下的产业趋势演变与竞争格局深度解读
大数据·人工智能
wuyk5551 天前
Spider-第16讲-线程池与竞态问题
大数据·爬虫·python·elasticsearch·搜索引擎
数字新视界1 天前
全国产化动环监控平台在机房智能化管理中的应用探索
大数据·人工智能·数据中心·机房管理·模块化机房
TDengine (老段)1 天前
TDengine IDMP 预测、异常检测与数据插补
大数据·数据库·人工智能·时序数据库·tdengine·涛思数据·idmp
字节跳动数据平台1 天前
火山引擎 VeKnow 落地指南(上):从选场景到知识治理
大数据