import sys
print(f'Python Version: {sys.version}')

import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler, OrdinalEncoder
from sklearn.decomposition import IncrementalPCA
from sklearn.cluster import MiniBatchKMeans
from sklearn.metrics import silhouette_score, davies_bouldin_score, calinski_harabasz_score
from sklearn.impute import SimpleImputer
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.feature_selection import VarianceThreshold
import matplotlib.pyplot as plt
import joblib

SMALL_DATASET_THRESHOLD = 1000
PLOT_RATIO = 0.008
BATCH_RATIO = 0.01
SAMPLE_RATIO = 0.05


def preprocess_fast(df, variance_threshold=1e-6, remove_outliers=False):
    numeric_cols = df.select_dtypes(include=['int', 'float']).columns.tolist()
    categorical_cols = df.select_dtypes(include=['object', 'category']).columns.tolist()

    if remove_outliers and numeric_cols:
        from scipy.stats import zscore
        z_scores = np.abs(zscore(df[numeric_cols], nan_policy='omit'))
        df = df.loc[(z_scores < 3).all(axis=1)]

    categorical_pipeline = Pipeline([
        ('imputer', SimpleImputer(strategy='most_frequent')),
        ('encoder', OrdinalEncoder(handle_unknown='use_encoded_value', unknown_value=-1))
    ]) if categorical_cols else None

    numeric_pipeline = Pipeline([
        ('imputer', SimpleImputer(strategy='median')),
        ('scaler', RobustScaler())
    ]) if numeric_cols else None

    transformers = []
    if numeric_cols:
        transformers.append(('numeric', numeric_pipeline, numeric_cols))
    if categorical_cols:
        transformers.append(('categorical', categorical_pipeline, categorical_cols))

    preprocessor = ColumnTransformer(transformers)
    X_processed = preprocessor.fit_transform(df)

    selector = VarianceThreshold(threshold=variance_threshold)
    X_processed = selector.fit_transform(X_processed)

    return X_processed, preprocessor, df


def incremental_pca(X, n_components=3):
    n_samples = X.shape[0]
    batch_size = n_samples if n_samples <= SMALL_DATASET_THRESHOLD else max(1, int(n_samples * BATCH_RATIO))
    n_components = min(n_components, X.shape[1])
    pca = IncrementalPCA(n_components=n_components, batch_size=batch_size)
    X_pca = pca.fit_transform(X)
    print(f"PCA reduced {X.shape[1]} features -> {X_pca.shape[1]} components (batch_size={batch_size})")
    return X_pca, pca


def determine_optimal_k(X, k_min=2, k_max=10):
    n_samples = X.shape[0]
    sample_size = n_samples if n_samples <= SMALL_DATASET_THRESHOLD else max(2, int(n_samples * SAMPLE_RATIO))
    batch_size = n_samples if n_samples <= SMALL_DATASET_THRESHOLD else max(1, int(n_samples * BATCH_RATIO))

    best_score = -1
    best_k = k_min

    for k in range(k_min, k_max + 1):
        model = MiniBatchKMeans(
            n_clusters=k,
            random_state=42,
            batch_size=batch_size,
            n_init=10
        )
        labels = model.fit_predict(X)
        if len(np.unique(labels)) > 1:
            score = silhouette_score(X, labels, sample_size=sample_size, random_state=42)
            if score > best_score:
                best_score = score
                best_k = k
    return best_k


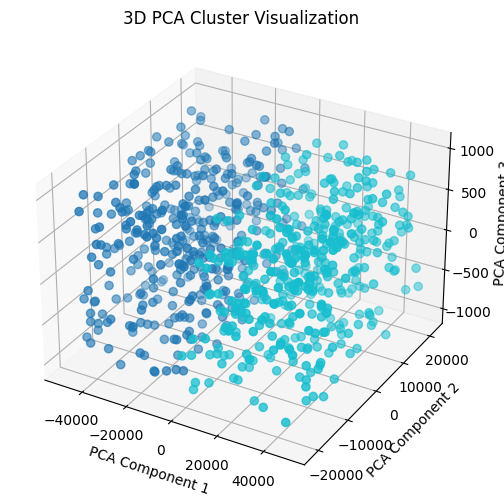
def plot_pca_clusters_3d(X_pca, labels, filename="Visualization_Clustering.png"):
    n_samples, n_components = X_pca.shape
    X_plot = X_pca if n_components >= 3 else np.hstack([X_pca, np.zeros((n_samples, 3 - n_components))])

    max_points = n_samples if n_samples <= SMALL_DATASET_THRESHOLD else int(n_samples * PLOT_RATIO)
    if n_samples > max_points:
        idx = np.random.choice(n_samples, max_points, replace=False)
        X_plot = X_plot[idx]
        labels = labels[idx]

    fig = plt.figure(figsize=(8,6))
    ax = fig.add_subplot(111, projection='3d')
    ax.scatter(X_plot[:,0], X_plot[:,1], X_plot[:,2], c=labels, cmap="tab10", s=35)
    ax.set_xlabel("PCA Component 1")
    ax.set_ylabel("PCA Component 2")
    ax.set_zlabel("PCA Component 3")
    ax.set_title("3D PCA Cluster Visualization")
    plt.savefig(filename, dpi=300, bbox_inches='tight')
    plt.show()
    print(f"PCA cluster visualization saved as '{filename}'")


def profile_clusters(df, cluster_col="cluster"):
    numeric_cols = [c for c in df.select_dtypes(include=['int', 'float']).columns if c != cluster_col]
    numeric_summary = df.groupby(cluster_col)[numeric_cols].agg(['mean', 'median']) if numeric_cols else pd.DataFrame()
    count_summary = df.groupby(cluster_col).size().rename("count")
    profile = numeric_summary.copy() if not numeric_summary.empty else count_summary.to_frame()
    if not numeric_summary.empty:
        profile['count'] = count_summary
    return profile


def pipeline_clustering(csv_path, remove_outliers=False):
    df = pd.read_csv(csv_path)

    X_processed, preprocessor, df_clean = preprocess_fast(df, remove_outliers=remove_outliers)
    X_pca, _ = incremental_pca(X_processed)
    X_final = np.hstack([X_processed, X_pca])

    best_k = determine_optimal_k(X_final)
    print(f"Optimal number of clusters determined: {best_k}")

    n_samples = X_final.shape[0]
    batch_size = n_samples if n_samples <= SMALL_DATASET_THRESHOLD else max(1, int(n_samples * BATCH_RATIO))

    kmeans = MiniBatchKMeans(
        n_clusters=best_k,
        random_state=42,
        batch_size=batch_size,
        n_init=10
    )
    labels = kmeans.fit_predict(X_final)

    silhouette_sample = n_samples if n_samples <= SMALL_DATASET_THRESHOLD else max(2, int(n_samples * SAMPLE_RATIO))
    sil = silhouette_score(X_final, labels, sample_size=silhouette_sample, random_state=42)
    dbi = davies_bouldin_score(X_final, labels)
    ch = calinski_harabasz_score(X_final, labels)

    print("\nCluster Evaluation Metrics")
    print(f"Silhouette Score: {sil:.4f}")
    print(f"Davies-Bouldin Index: {dbi:.4f}")
    print(f"Calinski-Harabasz Index: {ch:.4f}")

    df_out = df_clean.copy()
    df_out['cluster'] = labels
    df_out.to_csv("Result_Clustering.csv", index=False)
    print("Clustering results saved as 'Result_Clustering.csv'")

    plot_pca_clusters_3d(X_pca, labels)

    profile = profile_clusters(df_out)
    profile.to_csv("Profile_Clustering.csv")
    print("Cluster profile saved as 'Profile_Clustering.csv'")

    joblib.dump(kmeans, "Model_Clustering.pkl")
    print("MiniBatchKMeans model saved as 'Model_Clustering.pkl'")

    print("\nCluster Profiling Summary")
    print(profile)

    return df_out, kmeans, best_k, profile

if __name__ == "__main__":
    csv_path = "Amazon.csv"
    df_clustered, model, best_k, profile = pipeline_clustering(csv_path)