Day 36GPU的训练以及类的call方法

1.模型在 GPU 上训练,主要是将模型和数据迁移到 GPU 设备上。

GPU在计算的时候,相较于cpu多了3个时间上的开销

  1. 数据传输开销 (CPU 内存 <-> GPU 显存)

  2. 核心启动开销 (GPU 核心启动时间)

  3. 性能浪费:计算量和数据批次

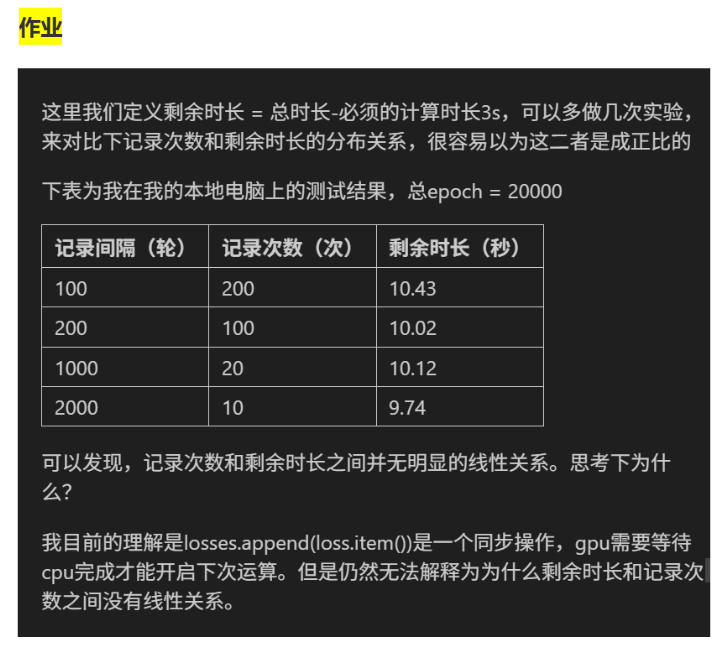
losses.append(loss.item()) 本身是轻量级操作(只是把一个数值存到列表里,耗时极短,可能只有微秒级)。而深度学习训练的主要耗时在:GPU 的前向 / 反向传播(占总耗时的 95% 以上);数据加载、内存拷贝等其他系统操作。且剩余时长本身是估算值,系统动态随机因素影响。

2.__call__方法让类的实例拥有了 "函数调用" 的能力

python 复制代码
# 定义一个类,实现__call__方法
class MyCalculator:
    def __init__(self, factor):
        self.factor = factor  # 初始化一个乘法因子
    
    def __call__(self, x):
        # 当实例被调用时,执行这个方法
        return x * self.factor
 
# 实例化:因子为2
calc = MyCalculator(2)
 
# 把实例当作函数调用
result = calc(5)
print(result)  # 输出10(5*2)

@浙大疏锦行

相关推荐
VIP_CQCRE6 小时前
GPT Image 2.6 商品图换背景后悬浮?接触阴影、透明区域与反射验收
图像处理·人工智能·ai·电商
泯泷7 小时前
别再傻傻地喂文件了,大厂都在偷偷给AI建这种“专属图书馆”
人工智能
oak隔壁找我7 小时前
一款运行在 DSH(DeepSeek Harness)中的类 Postman HTTP 接口调试插件
人工智能·程序员
高洁017 小时前
数字孪生与计算机视觉:让机器看懂现场
人工智能·python·机器学习·transformer·迁移学习
Csvn8 小时前
如果明天供应商涨价 3 倍?三层解耦,换模型只改一行配置(C05)
人工智能·aigc·agent
在所不辞兄9 小时前
为什么数字孪生驱动的产线标定需要在线更新机制,而不能一次标定后长期沿用?
人工智能·神经网络·其他·算法·机器学习
锋行天下9 小时前
langgraph 全栈项目(三)
前端·人工智能·后端
黄啊码10 小时前
【黄啊码】最近面了十几个想转 FDE 的程序员,一个都没招
人工智能
锋行天下10 小时前
langgraph 全栈项目(二)
前端·人工智能·后端
大模型真好玩10 小时前
用 Seedance 2.5 Flash 实现1分钟AI短剧,满足孩子的超级英雄对战梦
人工智能·aigc·deepseek