机器学习-非度量方法

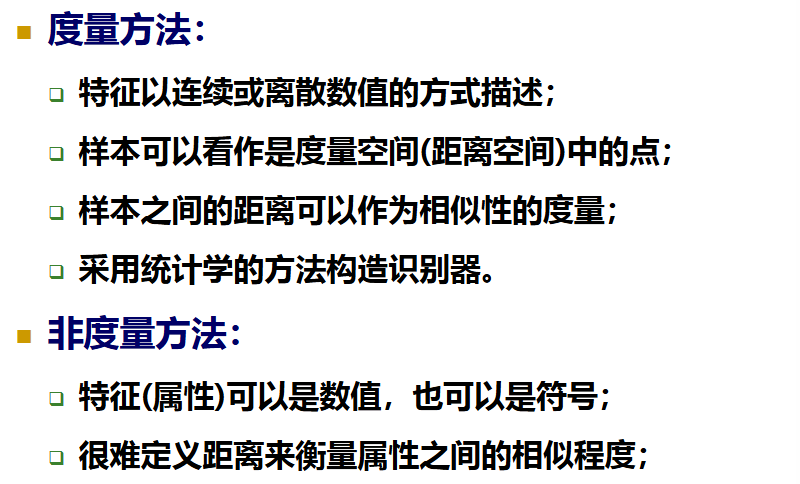
SVM NN等分类方法是基于连续实数或离散值的特征向量的模式识别问题,这类问题都涉及了向量间距离度量的问题,比如KNN中直接使用了点之间的距离,N中隐含了距离信息,如果两个输入向量足够接近,那么输出也会很相似,SVM让各个点离超平面的距离最远

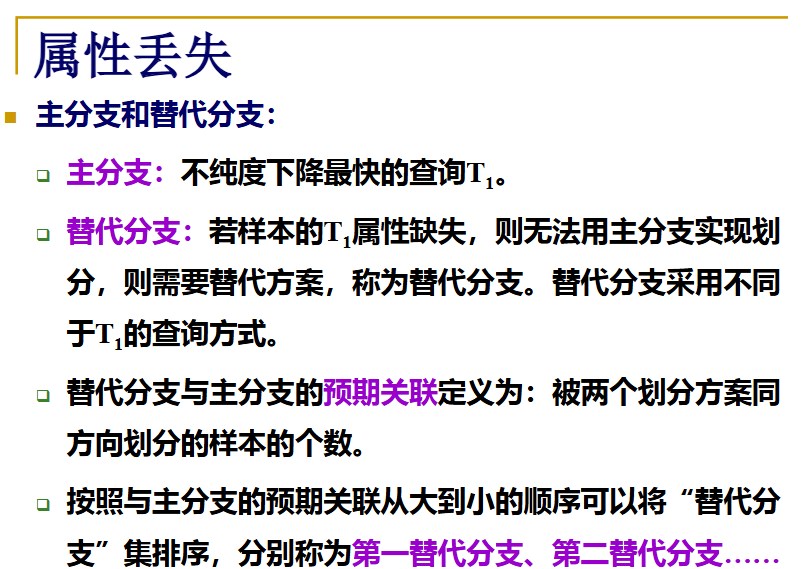
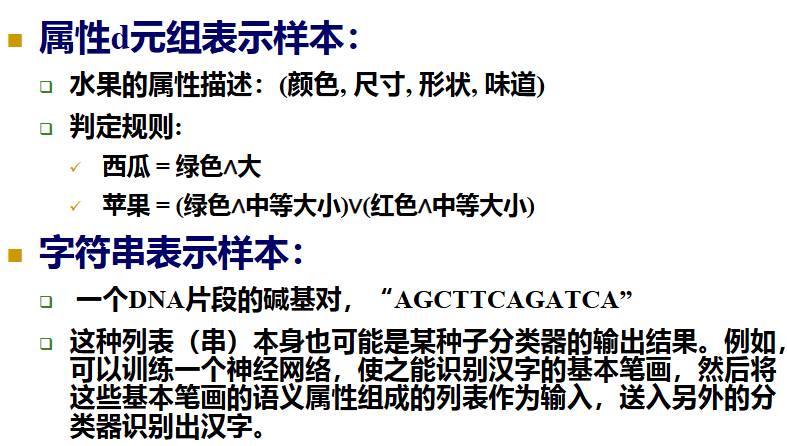
但是现实中的模式识别问题,样本属性不一定是可度量的,这种属性没有相似概念,也没有次序关系。非度量语义属性表示的模式常用属性d元组。另一种方式就是用不等长语义属性的列表
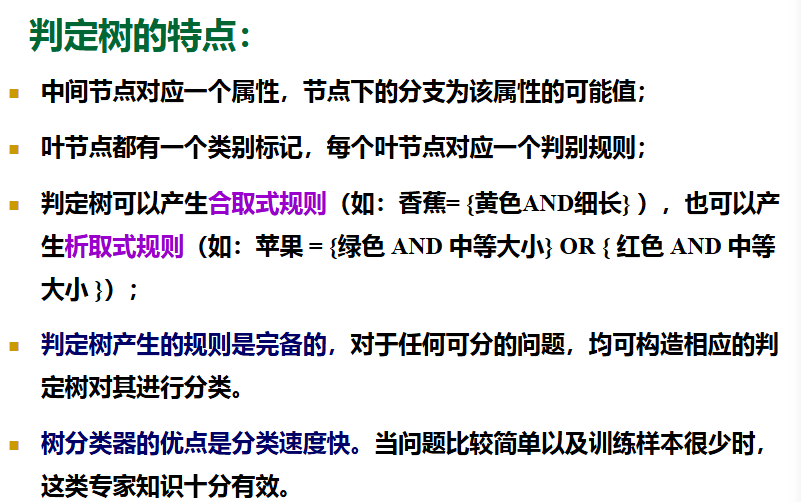
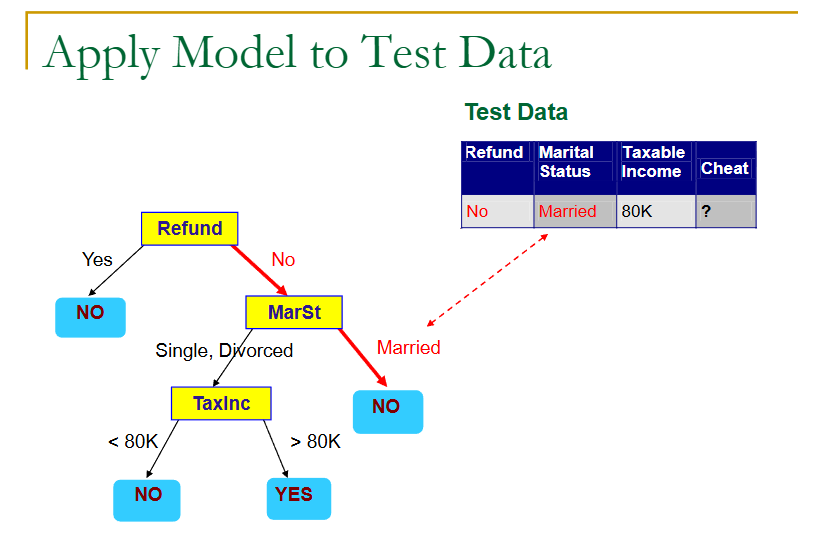
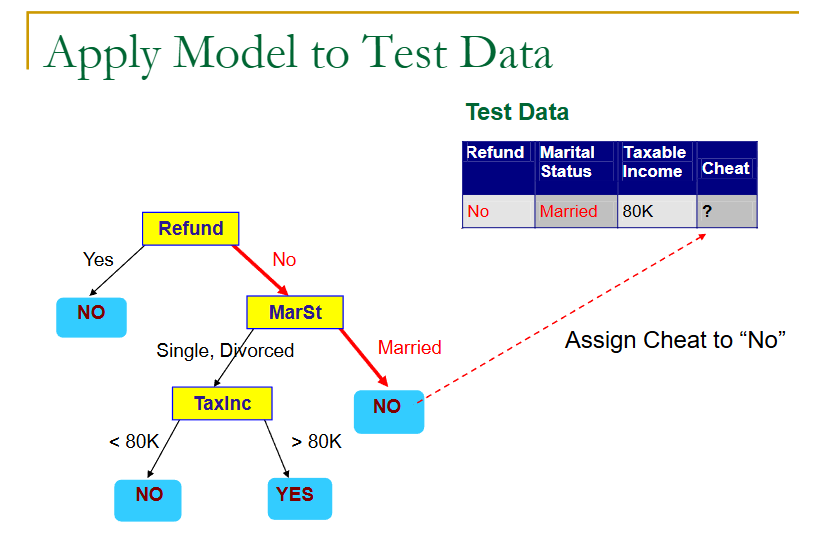
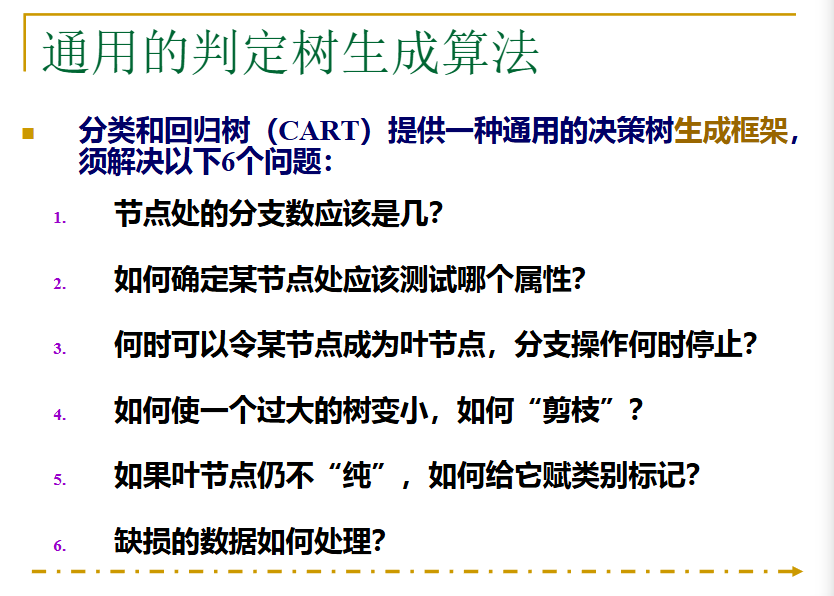
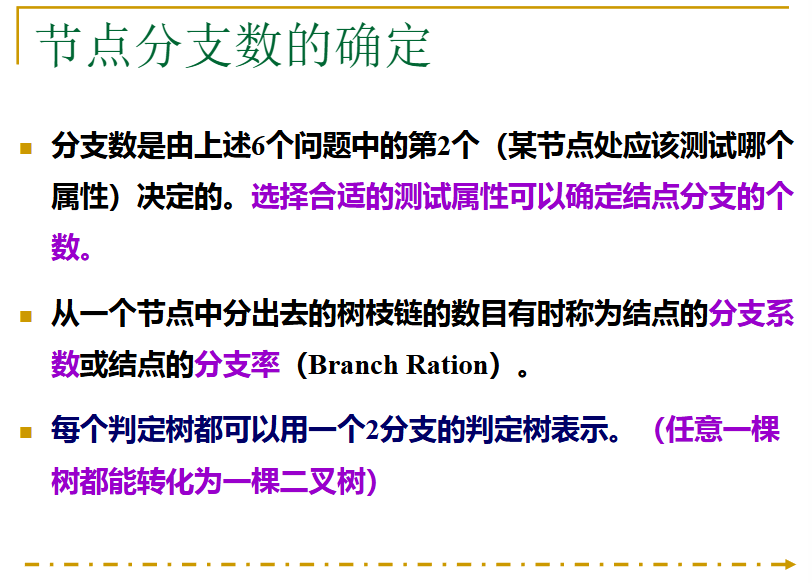
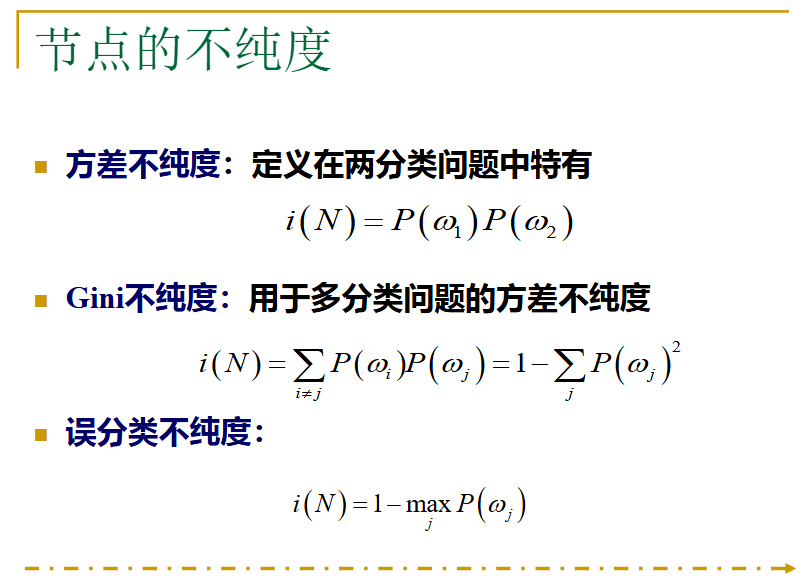
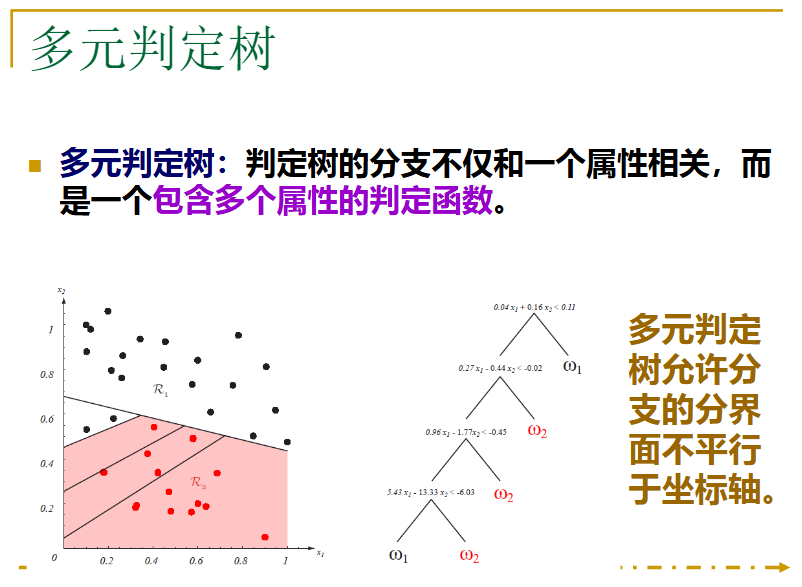
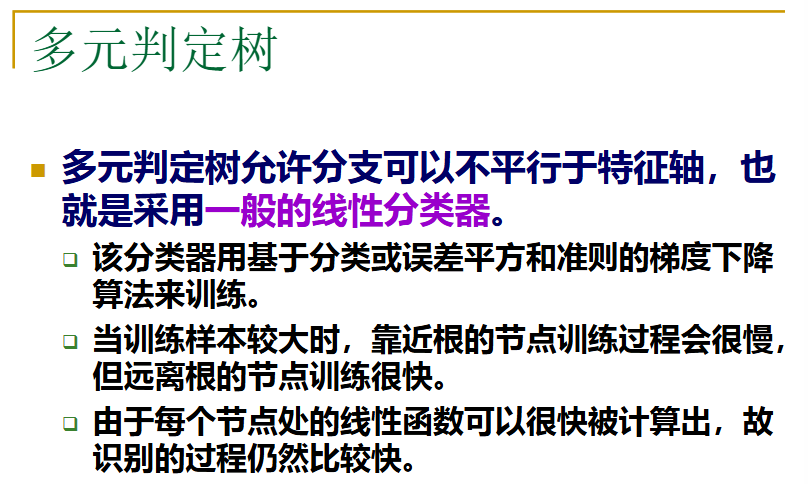
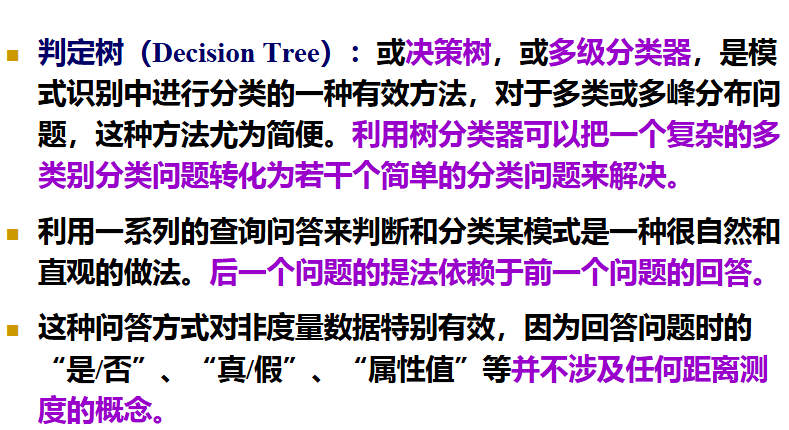
二、决策树
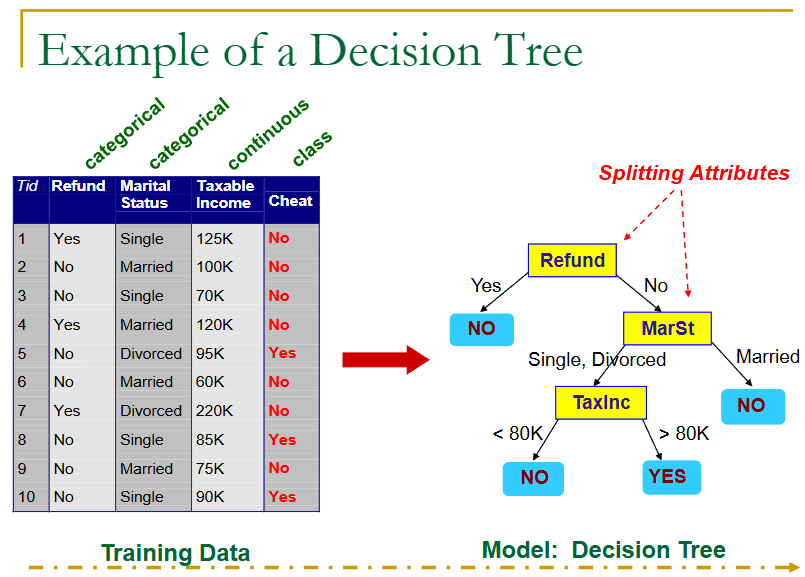
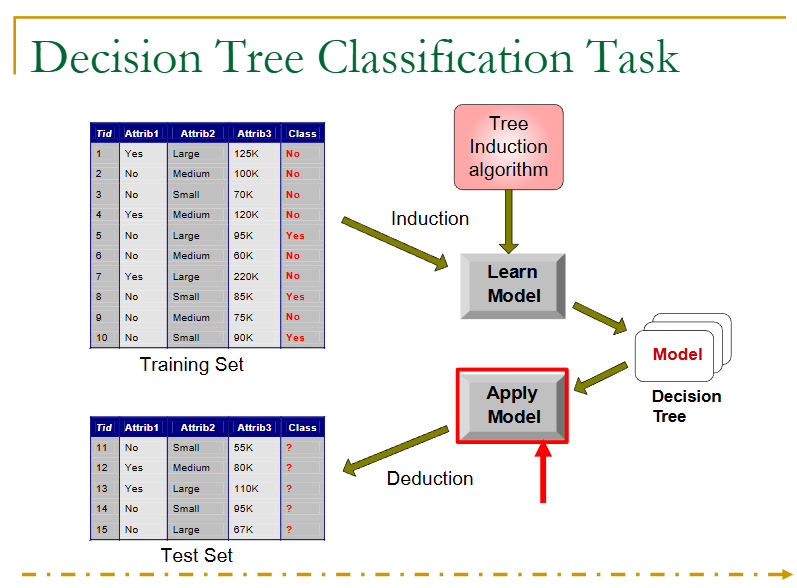
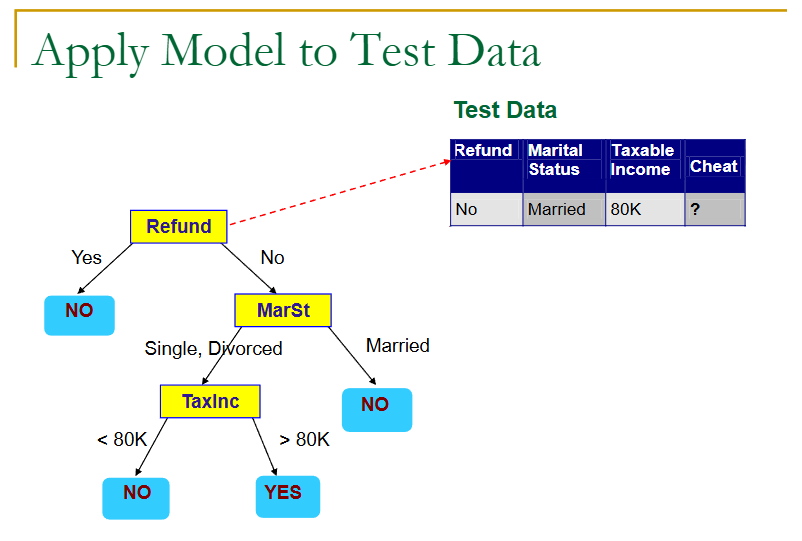
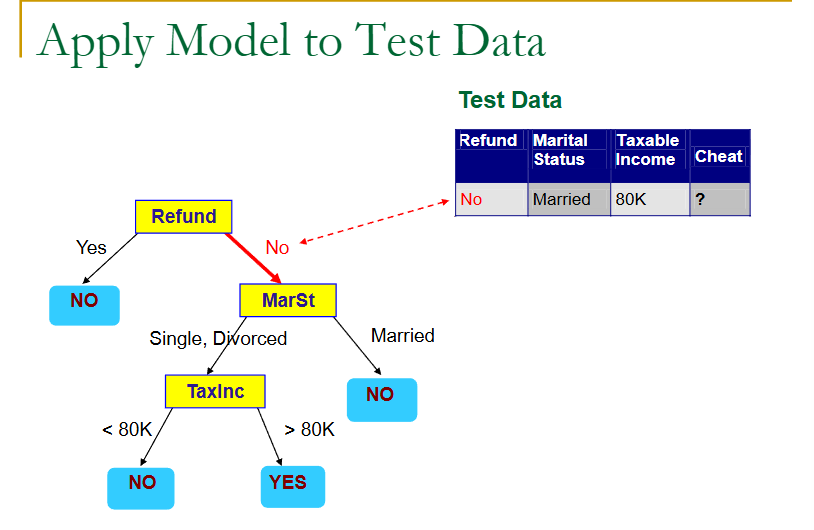
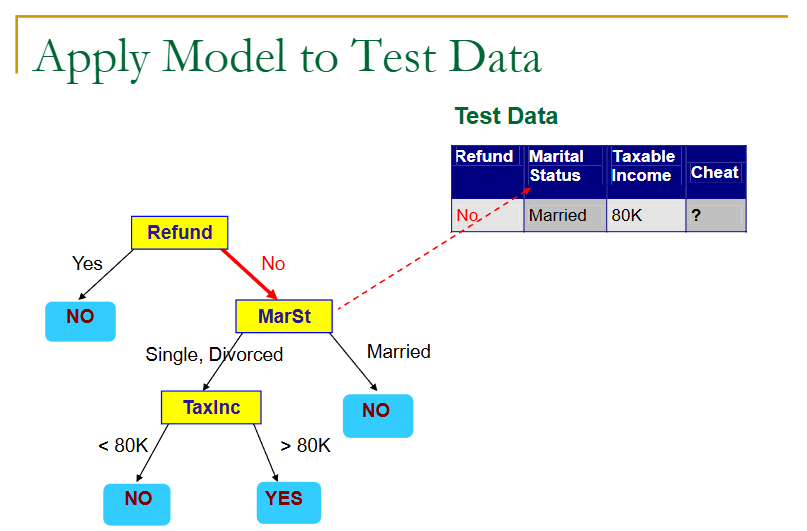
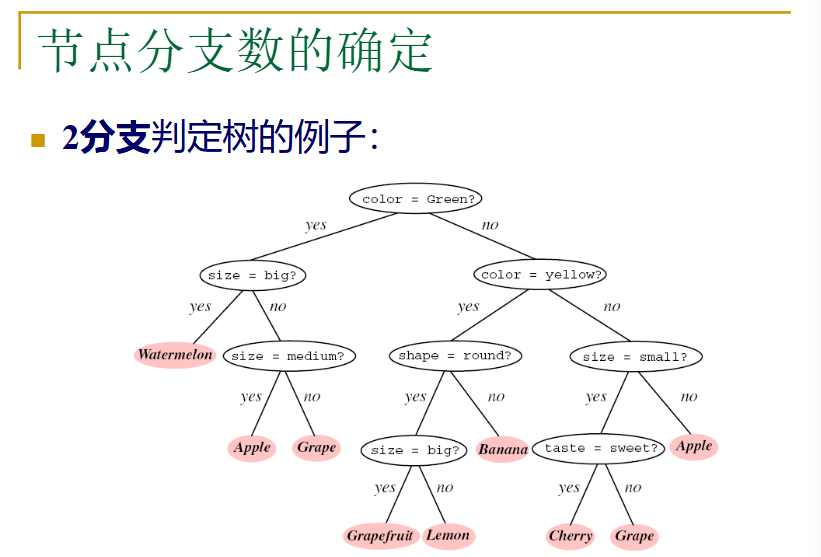
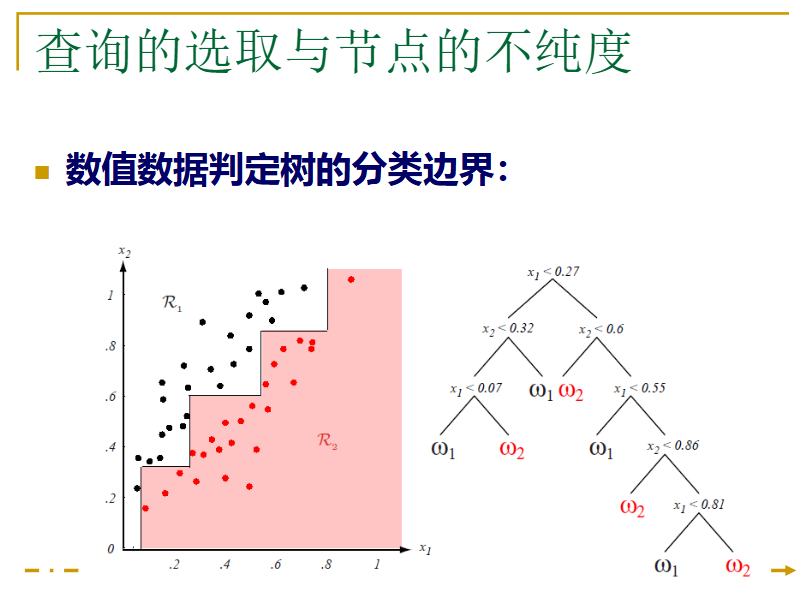
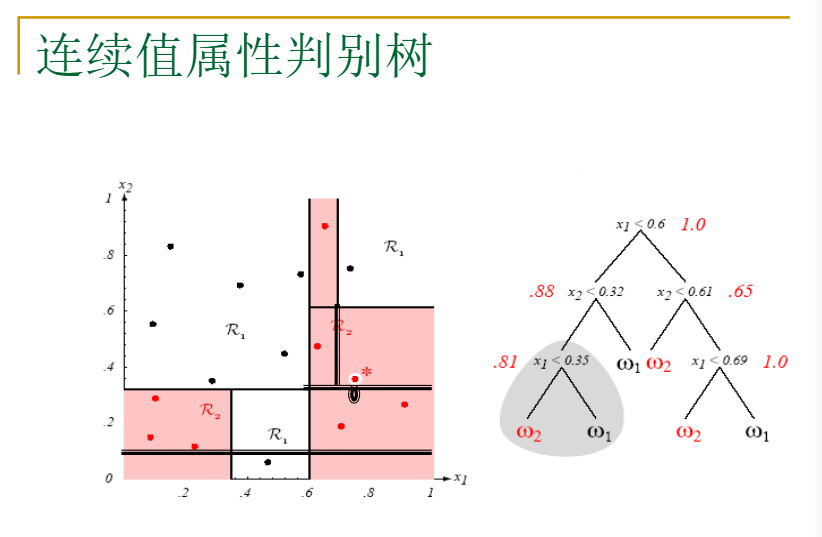
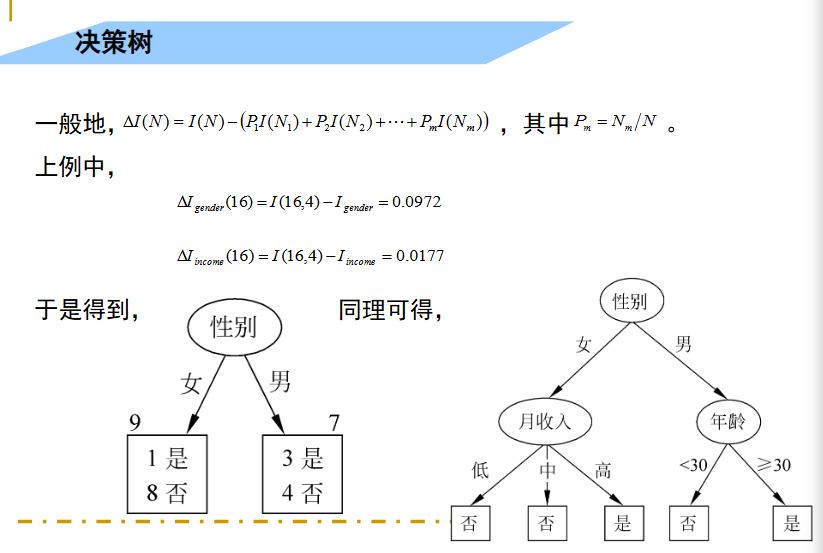
来看一个例子:
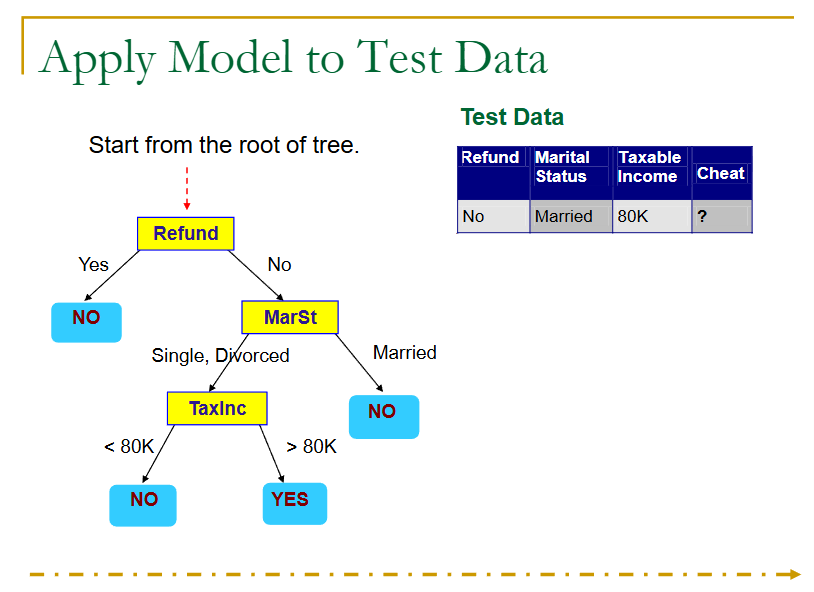
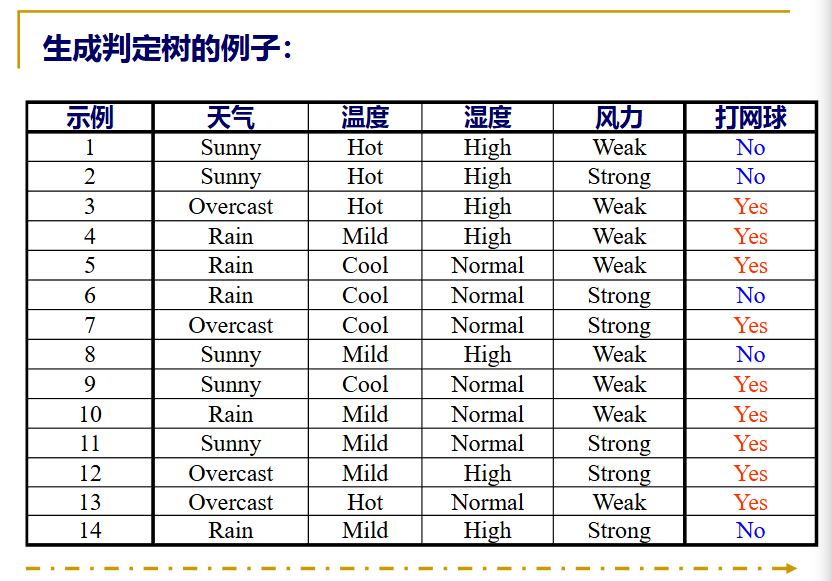
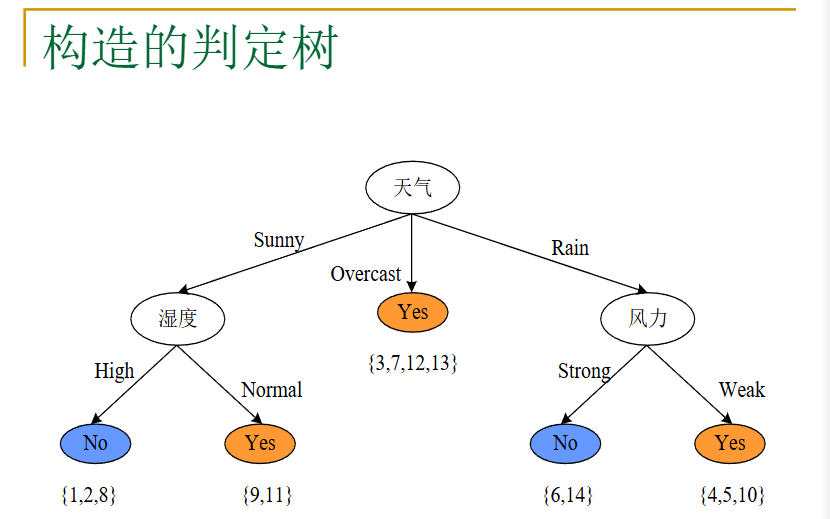
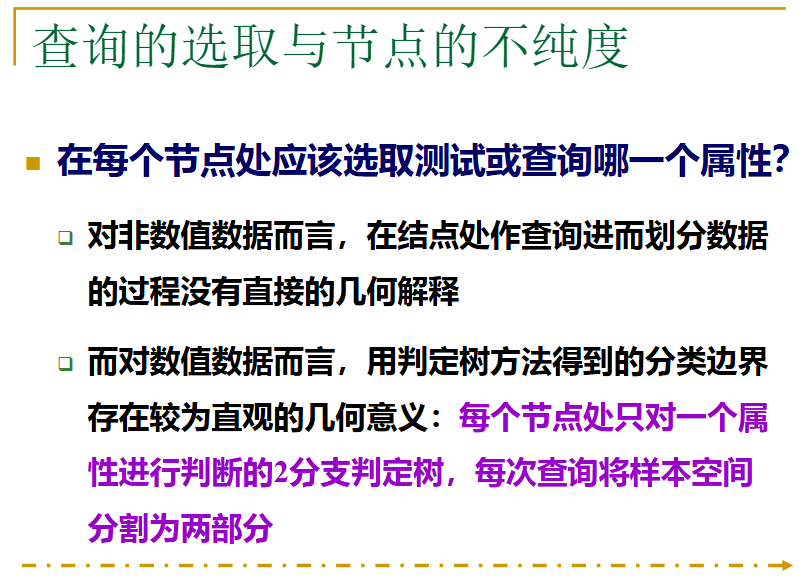
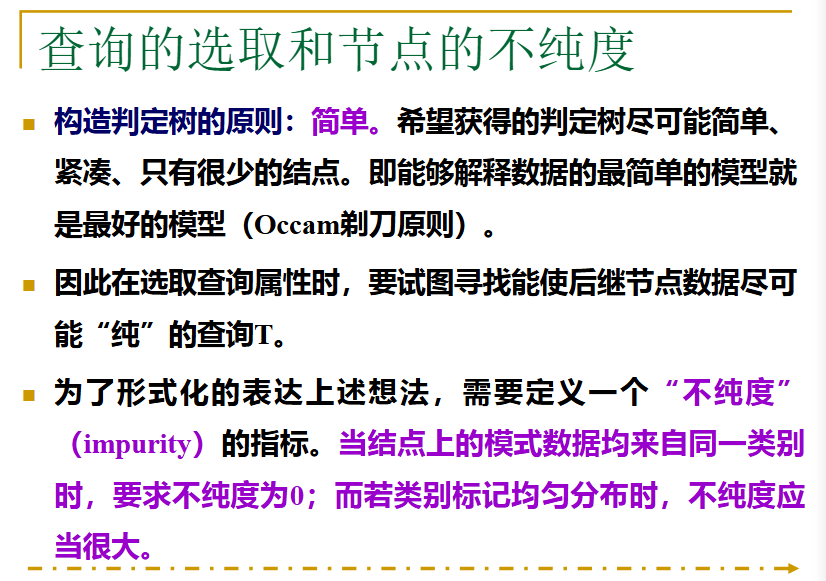
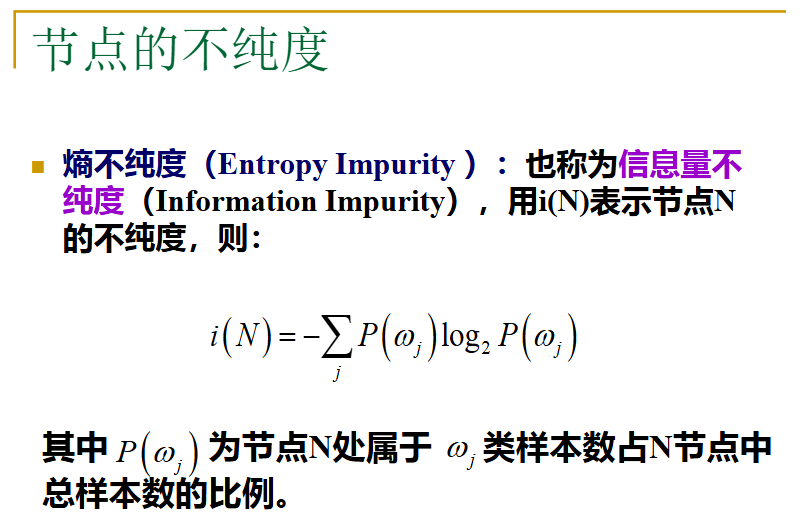
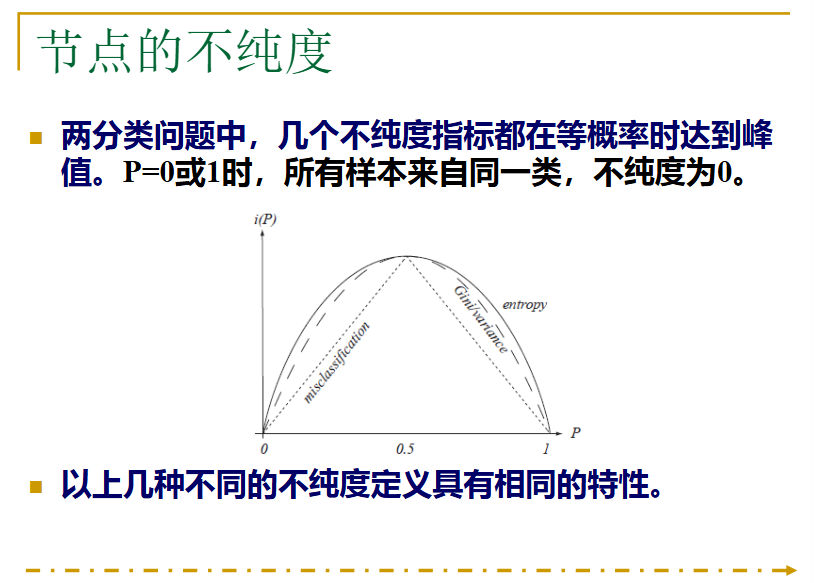
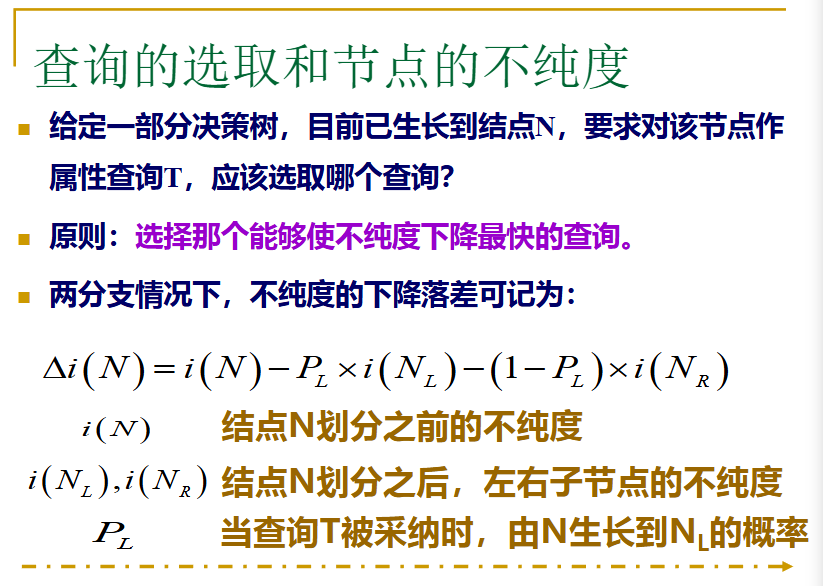
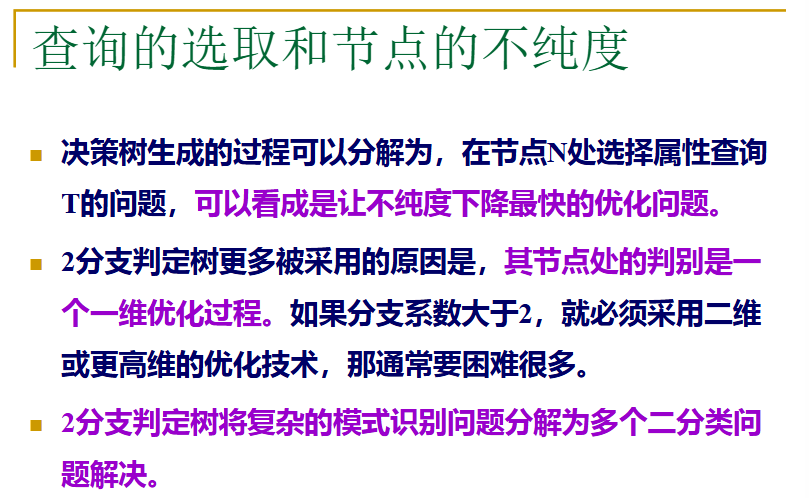
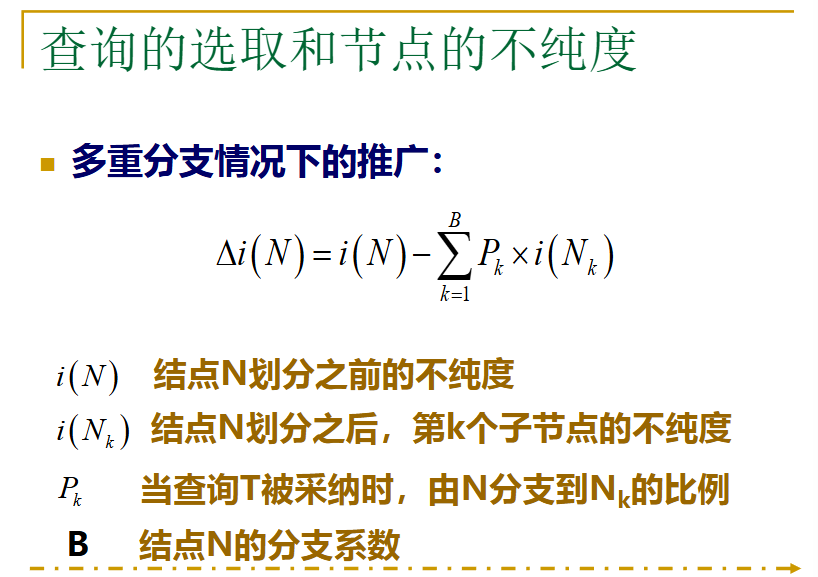
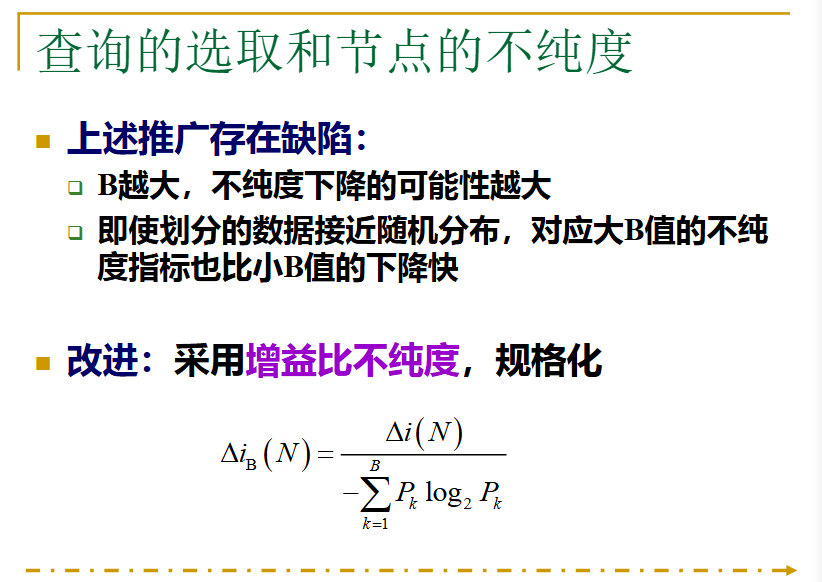
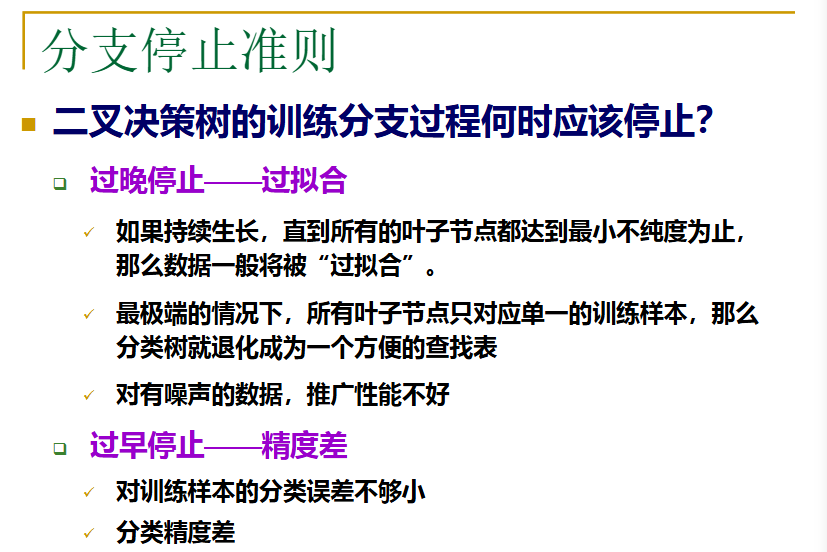
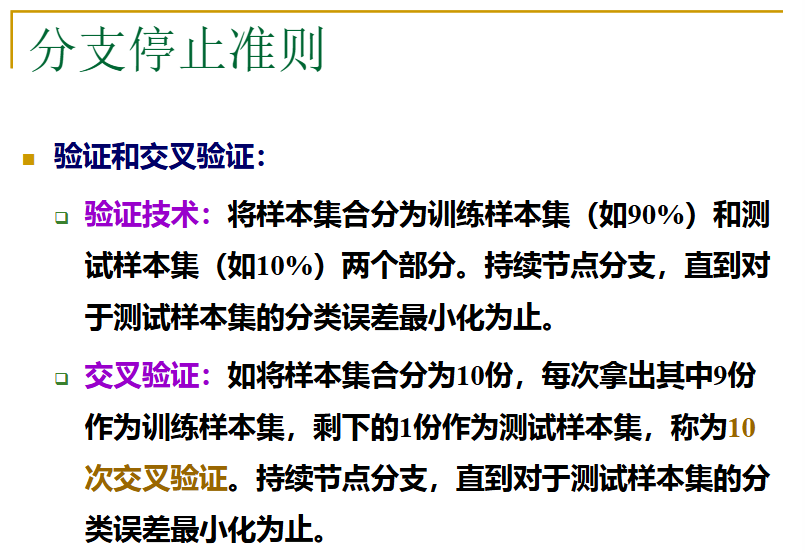
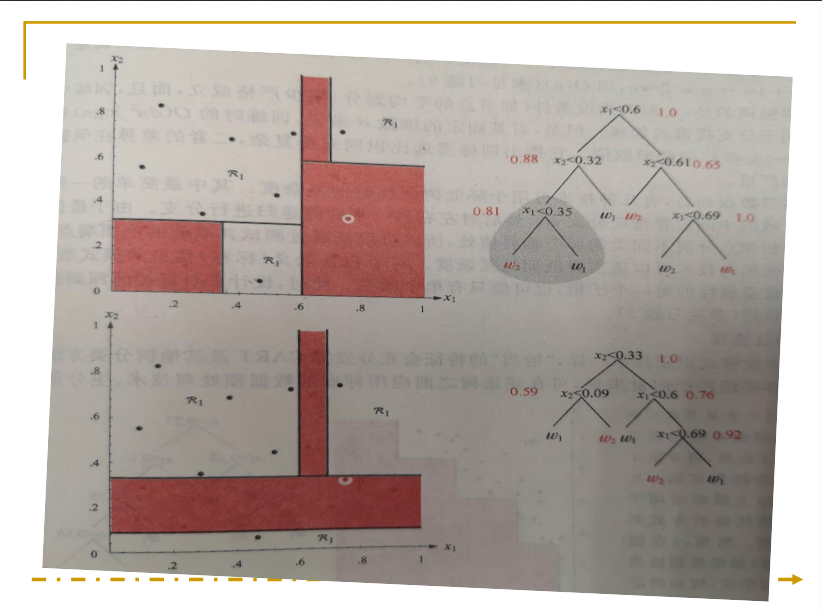
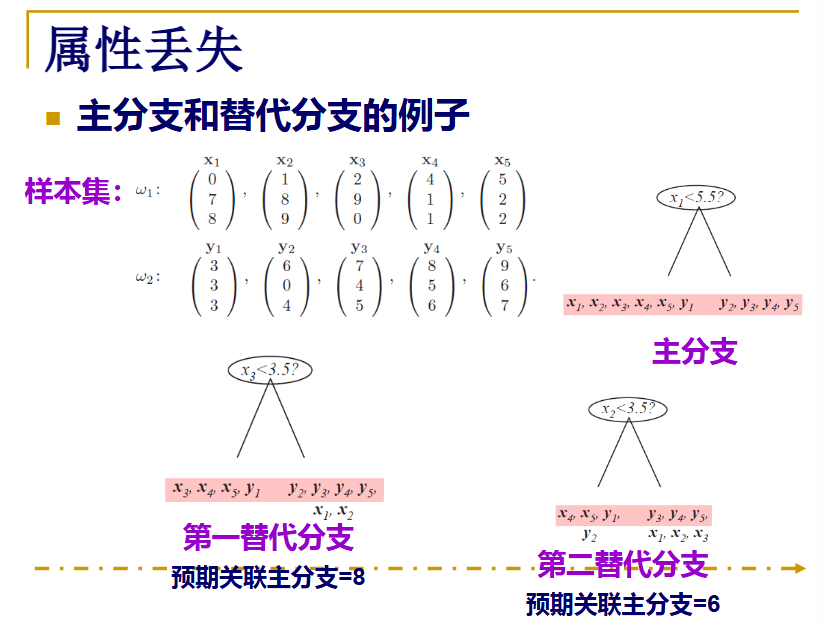
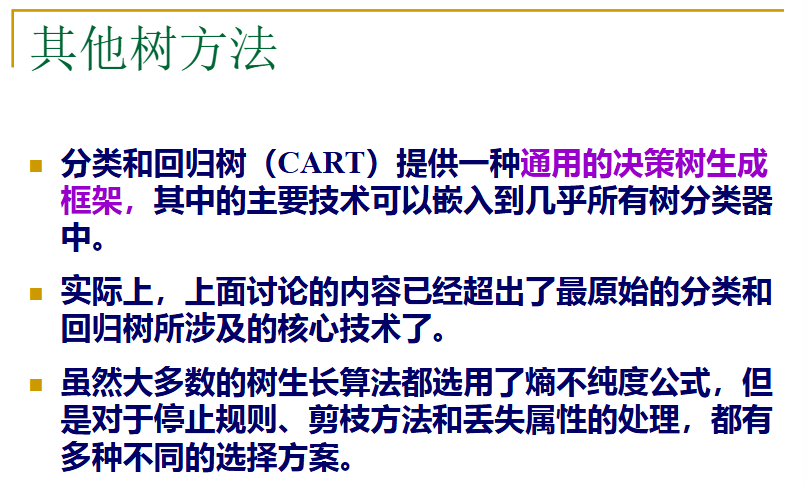
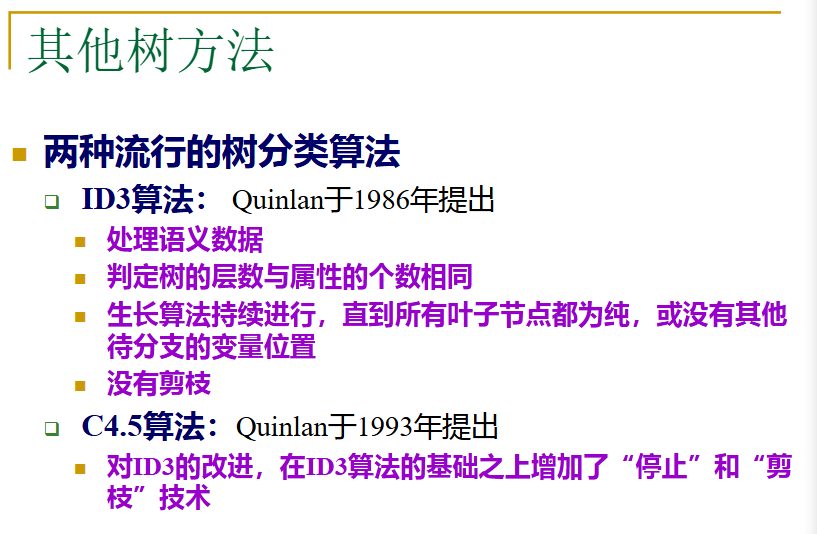
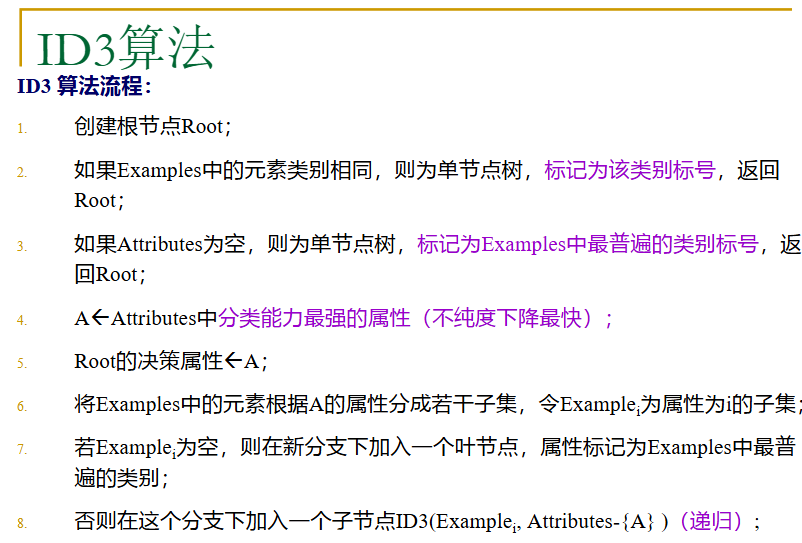
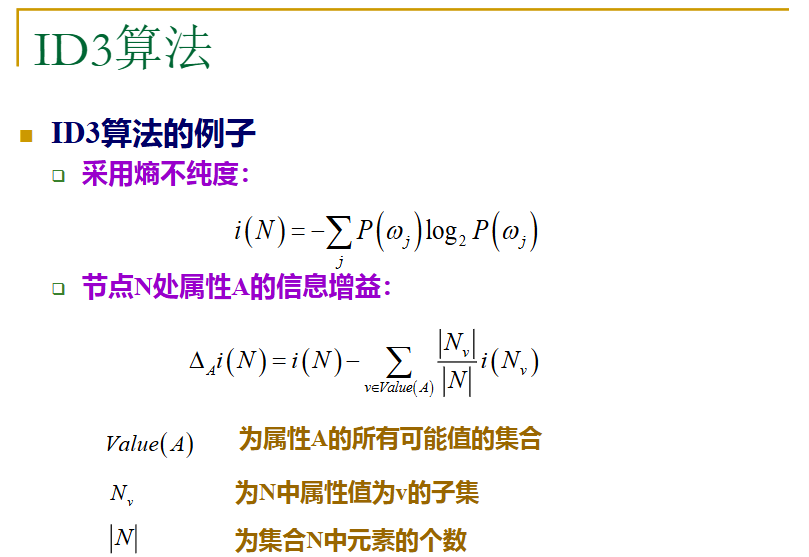
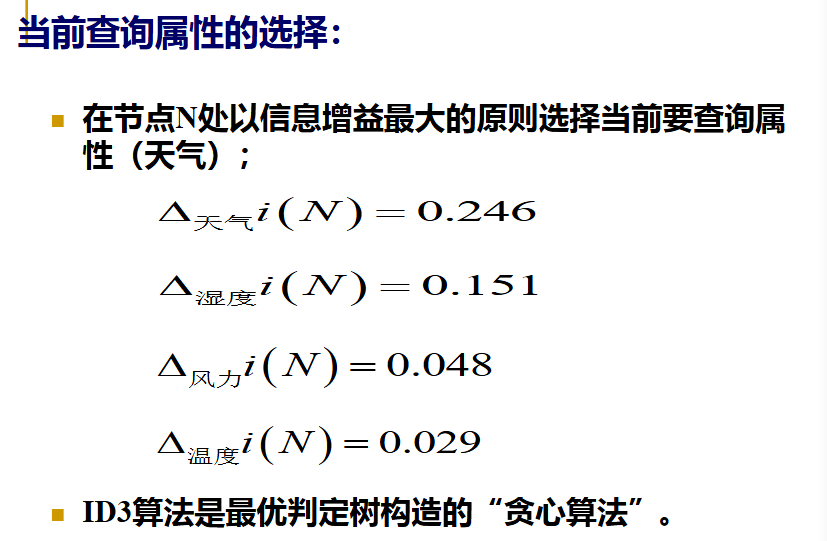
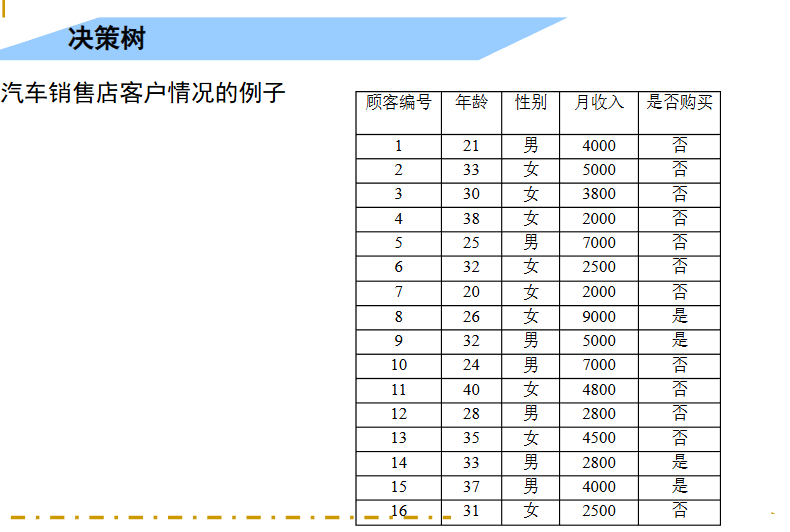
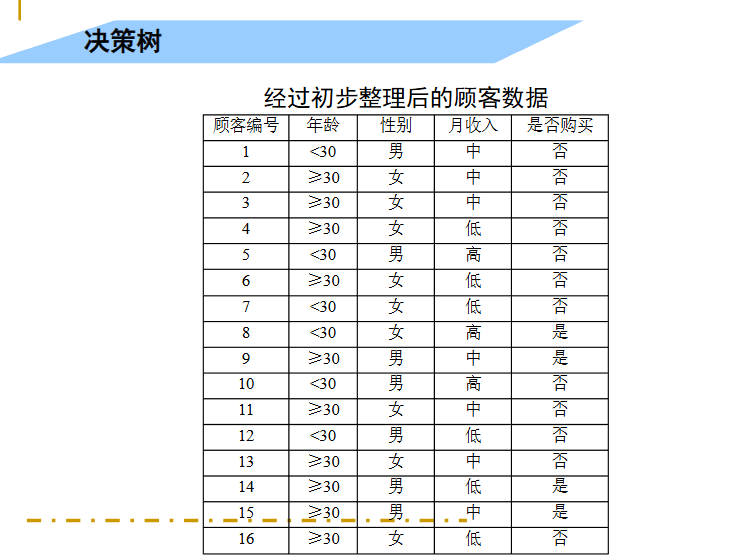
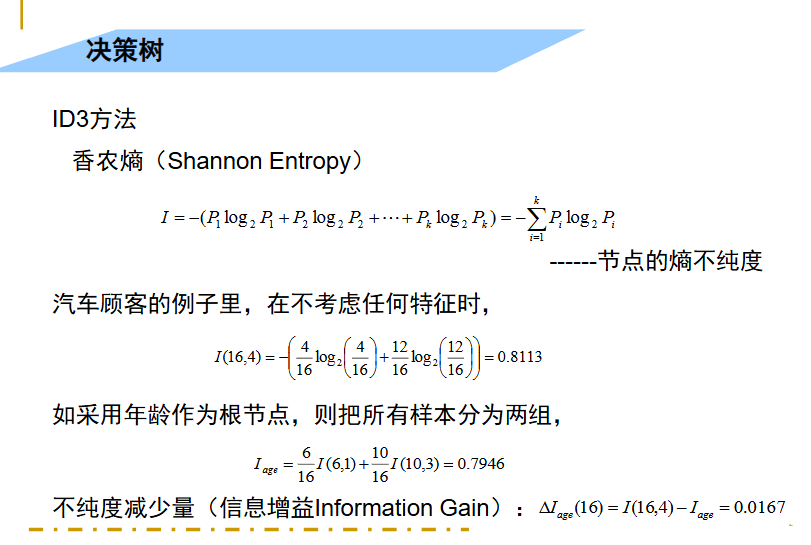
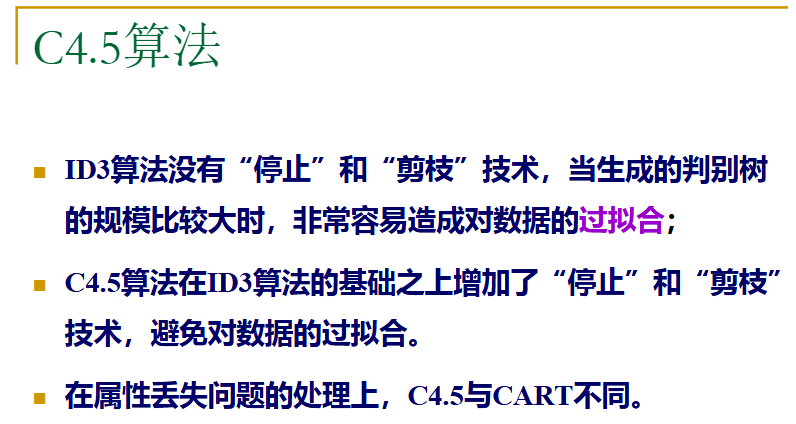
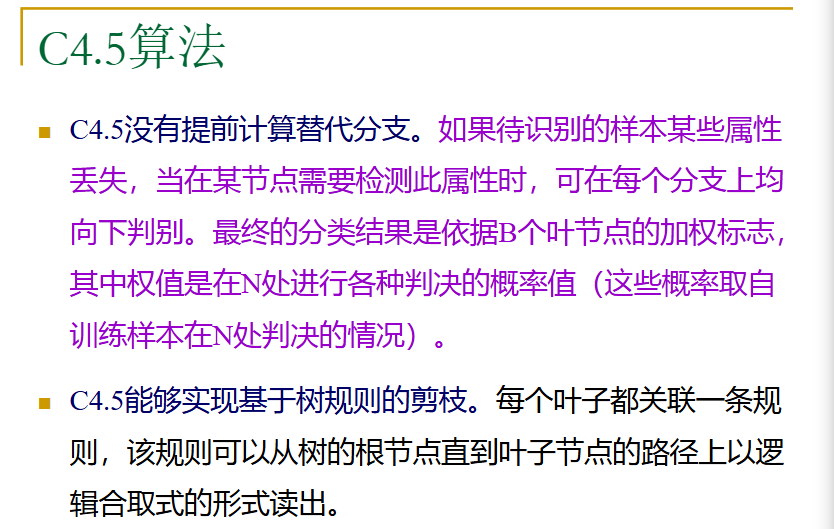
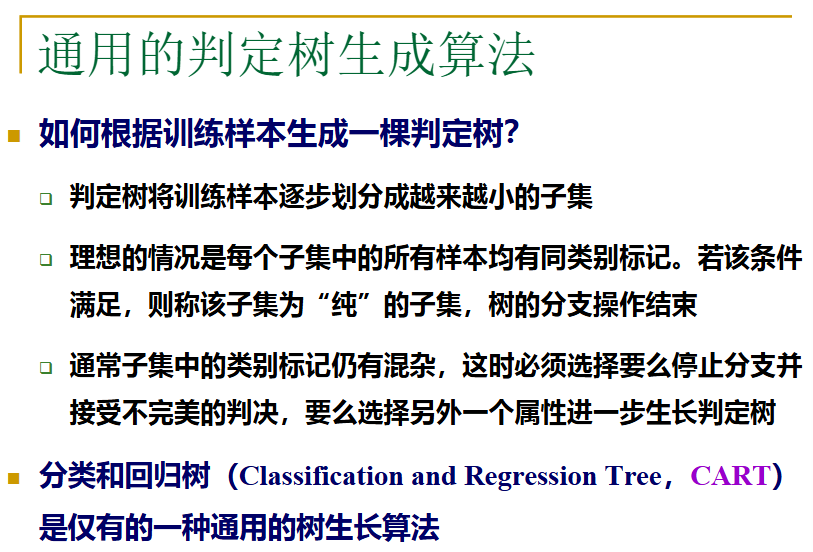
上面就是一个树的生成,但是用用的判定树生成,是如何根据训练样本来生成一棵树呢?
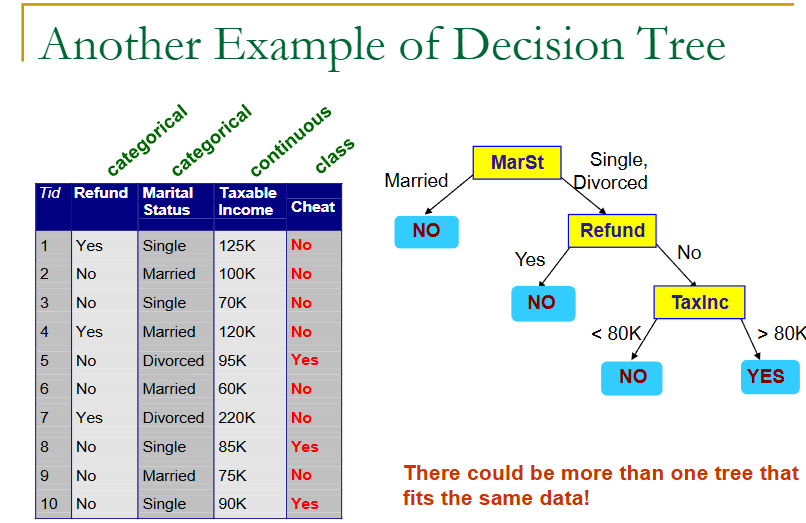
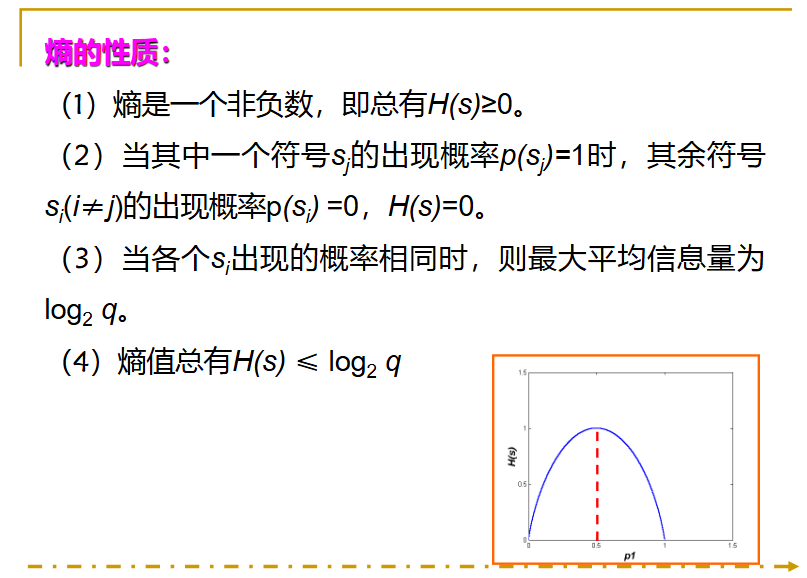
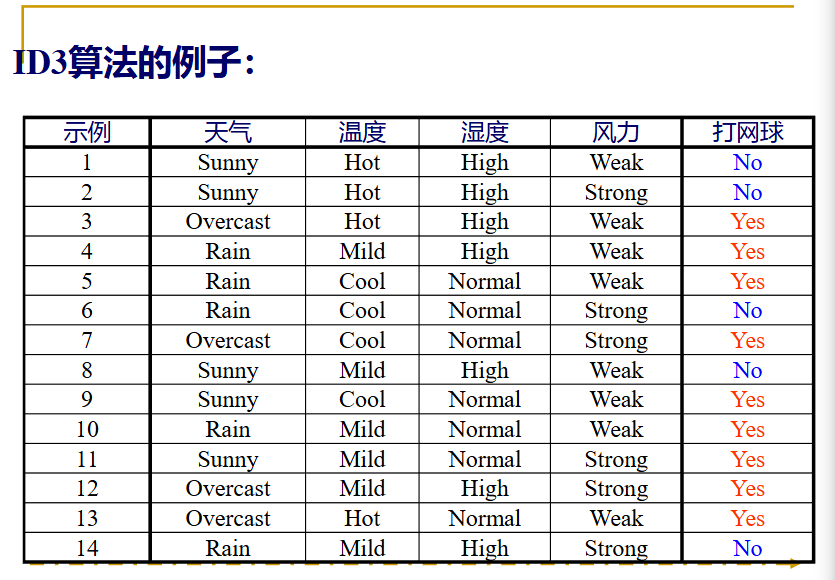
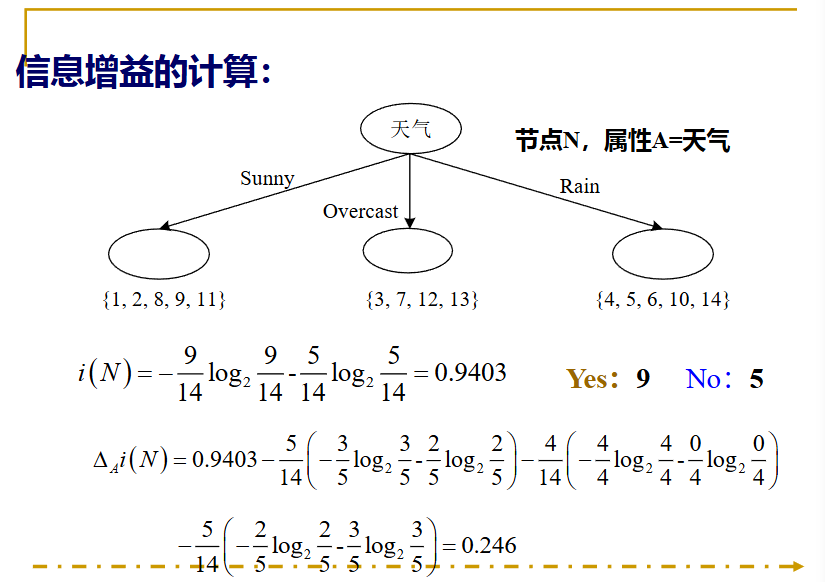
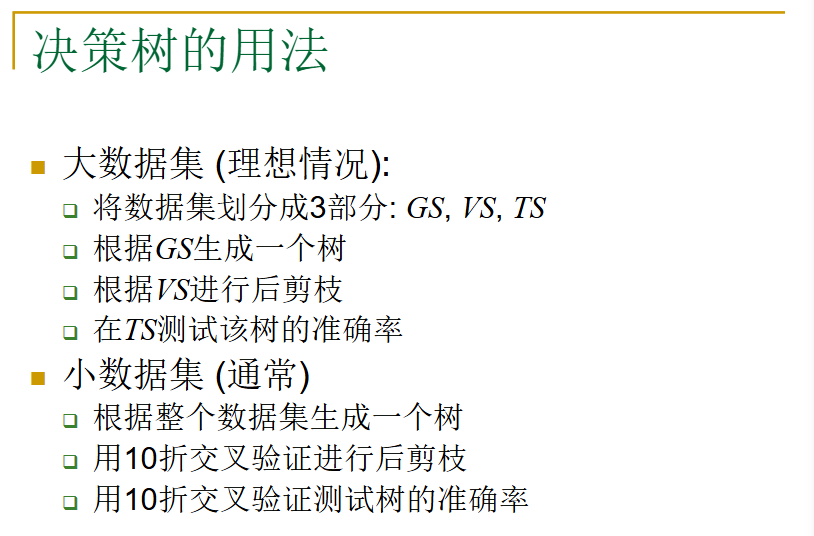
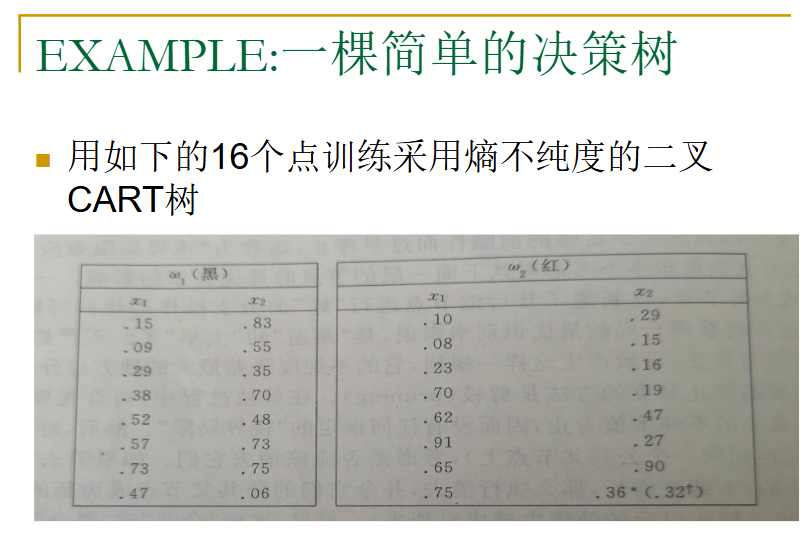
看下面一个例子:
相关推荐
吴佳浩5 小时前
我把 HAMi 摆回一台双卡机器上跑了一遍:GPU 编排的性能账,到底记在谁头上
人工智能·gpu
forest_099 小时前
《AI 编程 Harness 实战手册》04|审批这道门:点了一百次“允许”,还剩多少作用?
人工智能·算法·prompt·agi
火山引擎开发者社区10 小时前
当 RPA 遇上 Agent:MUA 混合执行 Workflow 深度拆解
人工智能
严肃小白兔11 小时前
第 10/24 期:深度神经网络的自动求导机制与梯度验证
人工智能·神经网络·dnn
火山引擎开发者社区11 小时前
定档12.16-12.18!FORCE原动力大会上海见!
人工智能
努力的MM12311 小时前
CAIE 二级和阿里云大模型 ACP 怎么选?企业 AI 工程与云平台开发能力对比
人工智能
老金带你玩AI11 小时前
Kling Image 4.0来了!8K和组图直出,电商人的提效神器?
人工智能
孟健11 小时前
用 unslop 拯救 AI 生成网页的塑料感,7 分钟重构落地实测
前端·人工智能·ai编程
stormzhangV12 小时前
Google 重返第一梯队
人工智能·google·aigc