在人工智能迈向"具身化"的关键阶段,如何让机器人真正理解指令、感知环境并自主执行任务,已成为全球科研界的核心挑战。近日,Trossen Robotics 正式发布全新教育视频系列,聚焦视觉-语言-动作(Vision-Language-Action, VLA)模型的训练逻辑与数据构建方法,为中国高校及科研团队提供兼具科普性与实操价值的入门路径。
Trossen具身智能实战①---机器人不是被编程的,是被教会的
一、VLA 模型:具身智能的核心
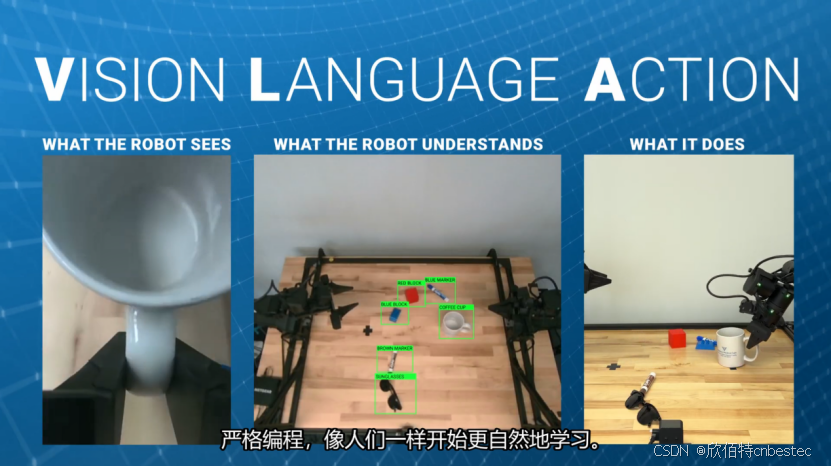
具身智能的核心魅力 ,在于机器人不再是单纯执行预设程序的机械体,而是能通过视觉、语言与动作的融合互动,像人类一样自然学习。这一被称为VLA(视觉 - 语言 - 动作)的模型架构,整合了机器人的 "所见""所闻" 与 "所为",打破了传统编程的局限,成为当前 AI 领域最具潜力的研究方向之一。
二、核心痛点:机器人专属数据稀缺
与 ChatGPT 依赖海量网络数据不同,机器人需要动作与现实结果配对的专属数据(视觉流、运动流、结果流),这类数据线上稀缺、采集成本高,成为 VLA 模型发展瓶颈。正如Trossen Robotics 所比喻:"只在单一场景下训练的机器人,就像只在晴天练车的司机,遇到雨天或复杂路口便会束手无策。"Trossen 所研发的Mobile AI正是通过攻克多环境数据采集,实现了移动场景稳定性能。
三、科研赋能:高质量数据采集指南
高质量数据需兼顾多样性与一致性。过于单一的训练数据会让机器人难以应对现实世界的突发状况,而杂乱无章的无效数据则会干扰模型的学习逻辑。Trossen 机器人 的系列内容,直击科研痛点,分享拾取物体、遵循指令等场景的数据采集最佳实践 ------ 这些经验来自Trossen Robotics 技术沉淀,更源于 ALOHA 机器人 、WidowX AI 等产品在真实科研场景中的反复验证。
四、助力科研突破创新瓶颈
对于高校科研团队而言,这份内容不仅解答了 "机器人机器学习是什么" 的核心疑问,更提供了 "如何正确实践" 的实操方案,为相关领域的课题研究、技术攻关提供了重要参考。
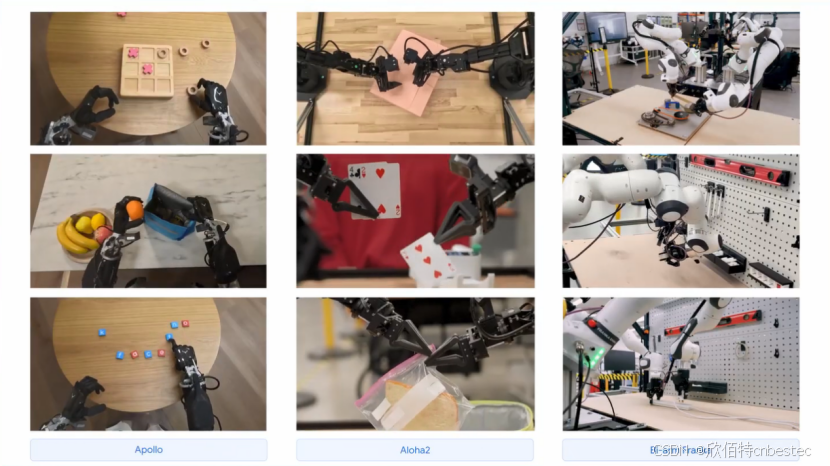
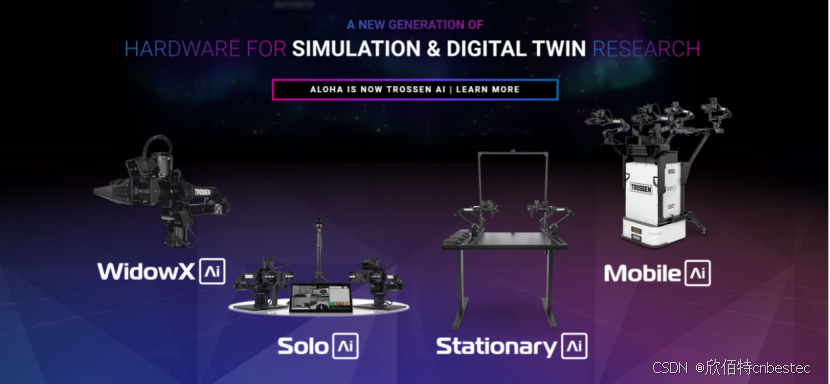
Trossen Robotics 始终致力于为创新者赋能,通过本系列内容的分享,结合 ALOHA 遥操作机器人系统 、Solo AI 便携式机器人等产品的实战优势,助力中国科研与高校用户在具身智能领域突破数据壁垒,开拓更多技术新可能。
跟随Trossen Robotics,探索机器人机器学习奥秘,让科研尝试精准发力、创新想法落地生根。
欢迎关注 "欣佰特科技 " ,持续为大家带来 "具身智能领域 "前沿技术及应用!详情可邮件咨询++++sales@cnbestec.com++++