一、传输层的理解
1.1. 传输层的服务和协议
-
为不同主机的进程之间提供 logical communication (运行在不同主机上)。
-
传输层协议运行在端系统:
-
send side : 将消息分为 segments,传递给网络层。
-
rcv side : 将 segments 重新组装成消息,传递给应用层。
-
在OSI参考模型中,自底向上第一个提供端到端传输服务的层次是传输层。
端到端通信是指在计算机网络中,数据从源主机到目的主机的传输过程中,数据的处理和传输只在源主机和目的主机之间进行,不经过中间节点的干预。这种通信方式是建立在点到点通信的基础上,是比点到点通信更高一级的通信方式,完成应用程序(进程)之间的通信。
-
Internet 中有两种传输层协议:
-
TCP(传输控制协议):可靠、有序交付
-
报文段: segment
-
拥塞控制: congestion control
-
可靠的数据传输
-
流量控制
-
-
UDP(用户数据报协议):不可靠、无序交付
-
报文: datagram
-
流量不可调节
-
不可靠传输
-
对比 IP 层的服务:尽力而为,不保证顺序和完整性
-
1.2. 传输层与网络层的关系
传输层依赖网络层服务,并扩展网络层服务。
-
网络层: 主机之间的逻辑通信。
-
传输层: 进程之间的逻辑通信。依赖并增强网络层服务。
类比:家庭通信模型
设想 A 家庭有 12 个孩子,B 家庭也有 12 个孩子,他们每周通过手写信件进行联系:
A 家庭推选 Ann,B 家庭推选 Bill,分别负责各自家庭的信件收发。
Ann 和 Bill 定期收集家庭中其他孩子的信件,投递到门口的邮筒里。
Ann 和 Bill 定期打开家庭邮箱,取出里面的信件,分发给其他孩子。
邮政系统负责将邮筒里的信件投递到收信人的家庭邮箱里。
类比关系:
进程 = 孩子
进程间通信 = 孩子之间通信
应用报文 = 信件
传输层 = Ann 和 Bill (提供人到人的服务)
终端 = 家庭住宅
网络层 = 邮政系统 (提供门到门的服务)
1.3. 数据封装过程 (由上至下)
-
应用层: data (消息)
-
传输层: segment/datagram (数据段/报文段)
注: TCP 叫 TCP 报文段, UDP 叫 UDP 数据报, 也有人叫 UDP 段。
-
网络层: packet (分组、数据包)
-
数据链路层: frame (帧)
-
物理层: bit (P-PDU)
二、多路复用和多路分解
multiplexing(多路复用) and demultiplexing(多路分解)
2.1. 核心概念
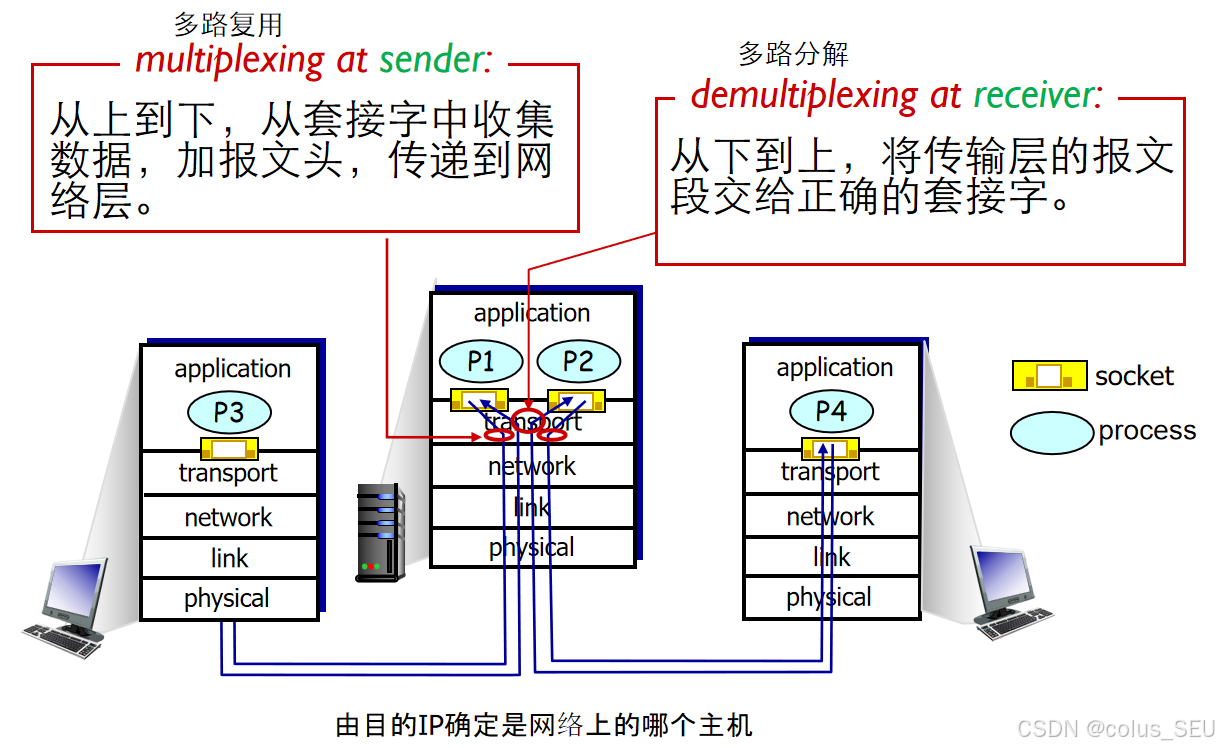
传输层的核心功能之一是 多路复用 (multiplexing) 和 多路分解 (demultiplexing) ,它实现了进程到进程的通信。
-
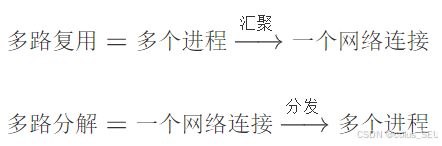
多路复用 (Multiplexing at Sender) : 从上到下
- 发送端将多个应用进程的数据汇聚成一个数据流,通过单一的网络连接发送出去。
-
多路分解 (Demultiplexing at Receiver) : 从下到上
- 接收端根据报文头中的信息,将收到的数据准确地分发给对应的应用进程。
关键点 : IP 层仅负责将数据包送到"哪个主机",而传输层通过端口号将数据精确投递到"主机上的哪个进程"。
2.2. 多路分解如何工作?
接收主机自下而上处理 IP 数据报:
-
每个 IP 数据报包含:
-
源 IP 地址、目的 IP 地址。
-
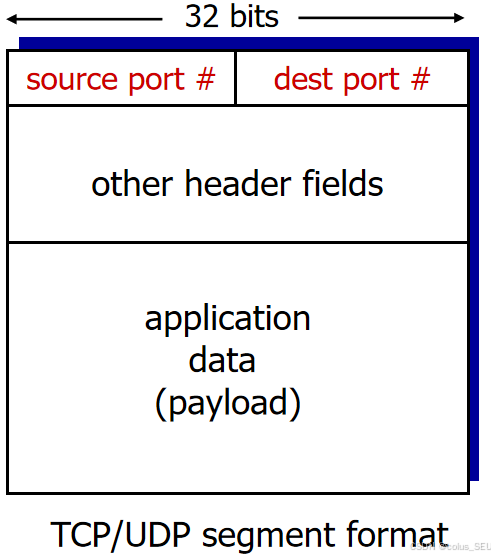
一个传输层报文段(segment/datagram)。该报文段包含源端口号和目的端口号。
注:
source port #和dest port #各占 16 位,共 32 位。
-
-
主机使用 IP 地址 + 端口号 的组合来定位并交付数据到正确的套接字(socket)。
2.3. 无连接协议 (UDP) 的多路复用与分解
(1) 基本原理
-
创建套接字时,会绑定一个本地端口号。
-
Java:
DatagramSocket mySocket1 = new DatagramSocket(12534); -
Python:
sock.sendto(MESSAGE, (UDP_IP, UDP_PORT))
-
-
发送数据时,必须指定目标 IP 地址和目标端口号。
-
接收数据时:
-
主机检查报文段中的 目的端口号。
-
将该报文段直接交给具有相同目的端口号的套接字。
-
重要特性: 具有相同目的端口号但不同源 IP 或源端口的数据报,会被送往同一个套接字。这使得服务器可以同时服务多个客户端。
(2) 端口号作用示例
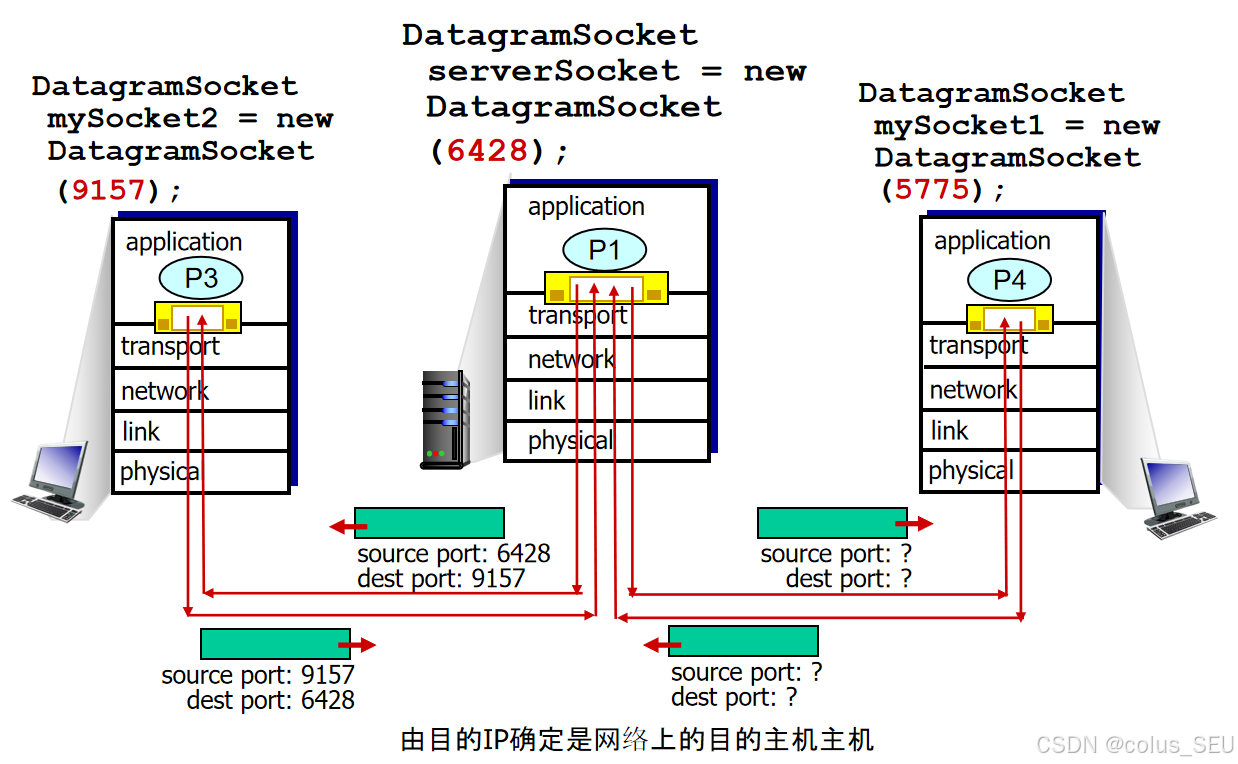
图示展示了三个主机通过 UDP 通信的过程:
-
服务器 : 创建
serverSocket,监听端口6428。 -
客户端 P3 : 创建
mySocket2,绑定本地端口9157,向服务器的6428发送数据。 -
客户端 P4 : 创建
mySocket1,绑定本地端口5775,也向服务器的6428发送数据。
数据流向:
(以P3和服务器之间的为例)
-
P3 → Server:
-
数据报头部:
source port: 9157,dest port: 6428 -
服务器收到后,将数据交给监听
6428的serverSocket。
-
-
Server → P3:
-
数据报头部:
source port: 6428,dest port: 9157 -
P3 收到后,将数据交给绑定
9157的mySocket2。
-
这种机制允许一个服务器进程(如 Web 服务器)通过一个端口(如 80)同时为成千上万个客户端提供服务。
总结
-
多路复用/分解 是传输层实现进程间通信的关键机制。
-
UDP 使用简单的"目的端口号"进行分解,不维护连接状态。
-
端口号 是区分同一主机上不同进程的唯一标识符。
-
IP 地址负责寻址主机,端口号负责寻址进程,两者结合构成完整的"套接字地址"。
2.4. 面向连接的多路分解 (TCP) 与 UDP 的对比
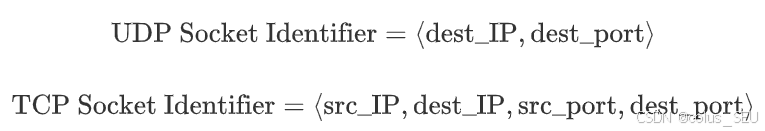
(1)核心区别:标识套接字的方式不同
传输层协议在进行多路分解时,识别目标套接字(socket)所依据的信息完全不同:
-
UDP : 使用 二元组
<目的IP地址, 目的端口号>。 -
TCP : 使用 四元组
<源IP地址, 目的IP地址, 源端口号, 目的端口号>。
这是面向连接协议和无连接协议在实现机制上的根本差异。
(2)面向连接的多路分解 (TCP)
1、原理
-
TCP 套接字由四元组唯一标识 :
<源IP地址, 目的IP地址, 源端口号, 目的端口号>。 -
多路分解过程:接收方使用这四个值来将收到的报文段精确地交付给对应的、已建立连接的套接字。
-
服务器支持并发连接:
-
一个服务器可以同时维护多个 TCP 套接字。
-
每个套接字由其独特的四元组标识。
-
例如,Web 服务器为每个连接的客户端(进程)(甚至每个非持久 HTTP 请求)都创建一个独立的套接字。
-
由于 TCP 是面向连接的,它需要区分"哪个客户端"与"哪个服务进程"的"哪一次会话",因此必须使用四元组。
2、实例演示
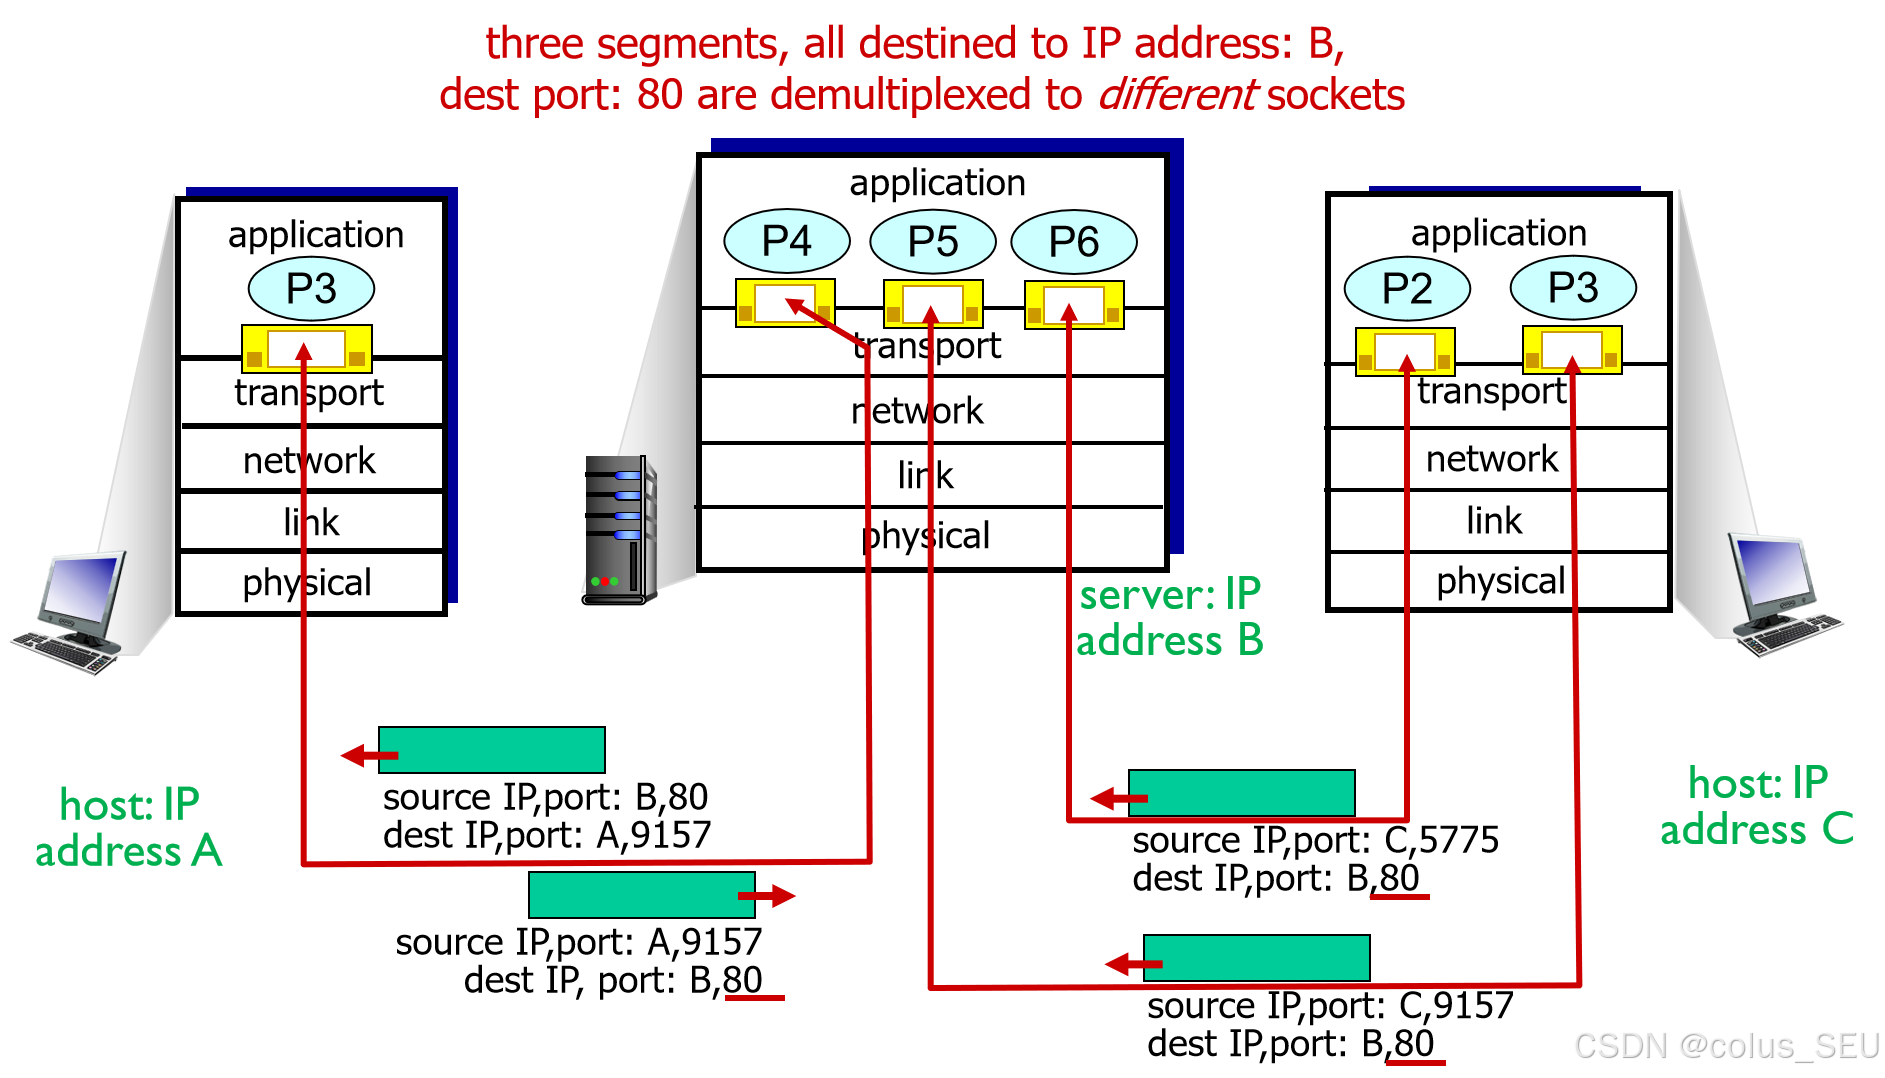
图示展示了服务器 B 如何处理来自不同客户端 A 和 C 的连接:
-
客户端 A (IP: A) : 发起连接,其本地端口为
9157,目标服务器端口为80。 -
客户端 C (IP: C) : 发起连接,其本地端口为
5775或9157,目标服务器端口也为80。
尽管所有数据报的目的 IP 地址都是 B,目的端口号都是 80,但它们被分发到了不同的套接字:
-
来自
A:9157的数据 → 交给服务器上代表A的连接套接字。 -
来自
C:5775的数据 → 交给服务器上代表C的另一个连接套接字。
这就是为什么一个 Web 服务器(如 Apache 或 Nginx)能同时为成千上万的用户提供服务------它为每个客户端连接创建了一个独立的"线程"或"进程"(即一个独立的套接字)。
3、线程化服务器 (Threaded Server)
在实际应用中,服务器通常采用"线程化"模型:
-
主线程监听一个固定的端口(如
80)。 -
当有新连接请求到达时,主线程接受该连接,并为其创建一个新的子线程。
-
每个子线程拥有一个唯一的四元组标识的套接字,负责与该特定客户端通信。
这样,即使多个客户端连接到同一个服务器端口,服务器也能通过四元组精确区分并服务每一个独立的连接。
小结
| 特性 | UDP 套接字 | TCP 套接字 |
|---|---|---|
| 标识方式 | 二元组 <目的IP, 目的端口> |
四元组 <源IP, 目的IP, 源端口, 目的端口> |
| 服务器模型 | 一个套接字服务所有客户端 | 一个监听套接字 + 多个连接套接字服务多个客户端 |
| 连接状态 | 无连接,不维护状态 | 有连接,维护会话状态 |
| 适用场景 | 简单、快速、广播/组播 | 可靠、有序、需要状态管理的应用 |
一句话总结: UDP 用"目的地"寻址,TCP 用"对话双方"寻址。这是两者在多路分解机制上的本质区别。
三、无连接的传输层协议:UDP
3.1. UDP 的核心特性
UDP 是一个"无花哨"、"骨架式"的传输层协议,提供"尽力而为"的服务。
-
无连接 (Connectionless):没有握手过程。每个 UDP 报文段独立处理,不维护连接状态。
-
不可靠 (Unreliable) :数据报可能丢失、重复或乱序到达。
-
轻量级:头部仅 8 字节,开销极小。无拥塞控制。
设计目标: 为需要低延迟、高吞吐量的应用提供最基础的传输服务。
3.2. UDP 的典型应用
由于其简单和快速的特性,UDP 常用于对可靠性要求不高,但对实时性要求高的场景:
-
流媒体应用 (Streaming Multimedia Apps):如视频会议、在线直播,能容忍少量丢包,但不能容忍延迟。
-
DNS (域名系统):查询请求通常很小,且可以重发。
-
DHCP (动态主机配置协议):用于网络初始化,广播通信。
如果应用还需要可靠性,必须在应用层自行实现(如添加重传、确认机制)。
3.3. UDP 校验和 (Checksum)
(1)目标
检测传输过程中报文段是否发生比特错误。
(2)计算方法:反码求和 (One's Complement Sum)
发送方步骤:
-
将校验和字段暂时置为
0。 -
将整个 UDP 报文段(包括首部和数据)视为一系列 16 位整数。
-
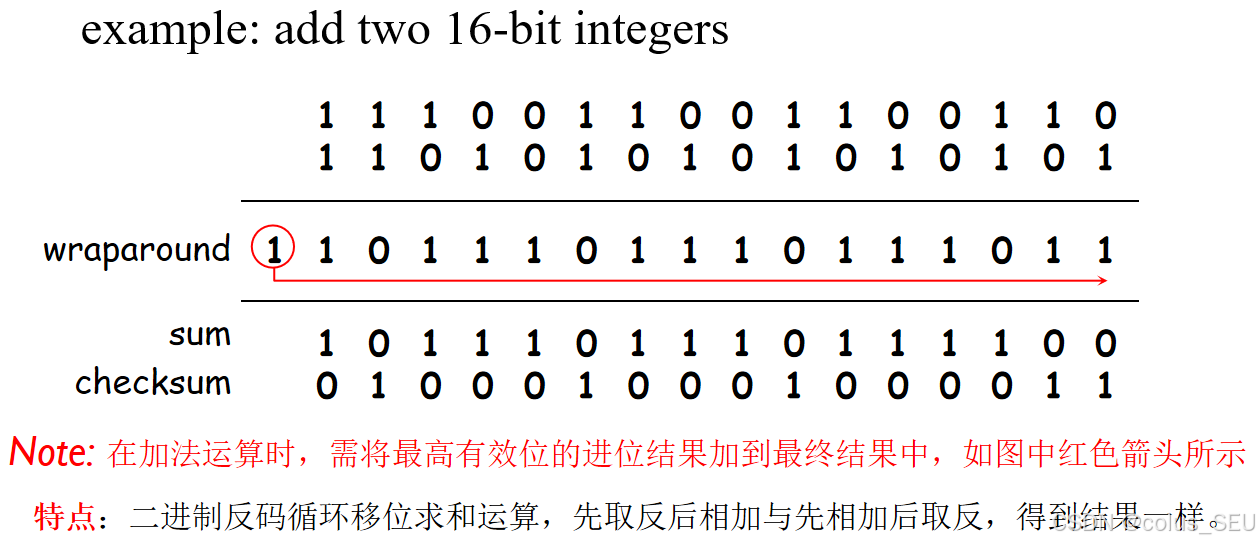
对所有 16 位整数进行二进制反码求和举例::
-
将溢出的进位(carryout)加回到最低位。
-
重复此操作,直到最高位没有进位。
-
-
将最终结果取反码,存入校验和字段。
接收方步骤:
-
将收到的整个 UDP 报文段(包括校验和字段)视为一系列 16 位整数。
-
进行同样的二进制反码求和举例:。
-
如果结果等于
0,则认为传输正确;否则,检测到错误,协议栈应丢弃该数据包。
注意 : 校验和计算是可选的。如果发送方将校验和字段设为
0,接收方会忽略校验。
二进制反码求和举例:
为什么校验和验证结果为 0?UDP/TCP 使用 16 位反码求和 计算校验和。
发送方:
将校验和字段置 0,对所有 16 位字(含首部和数据)做反码求和:
校验和为
(按位取反)。
接收方:对包括校验和在内的整个报文求反码和:
在反码系统中:
✅ 若结果为全 1(即逻辑 0),说明无比特错误。
📌 举例(简化为 4 位)
原始数据 :
0101和0011发送方计算:
和:
0101 + 0011 = 1000校验和:
~1000 = 0111发送报文:
0101,0011,0111接收方验证:
总和:
0101 + 0011 + 0111 = 1000 + 0111 = 1111结果
1111在反码中等于-0→ 无错误
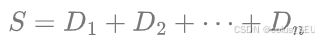
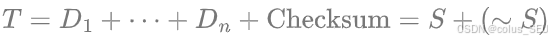
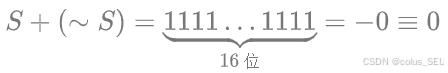
(3)为什么使用"反码"?
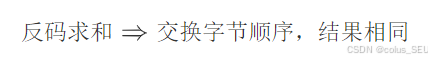
使用反码求和的主要优势在于其字节顺序无关性:
-
示例 : 对于一个 16 位数
ABCD,如果将其字节顺序交换为CDAB,再进行反码求和,最终得到的校验和值也仅仅是字节顺序相应交换,数值本身不变。 -
对比: 如果使用原码或补码求和,交换字节顺序会导致完全不同的结果。
这一特性使得校验和算法在不同字节序(大端序/小端序)的机器之间具有良好的兼容性,无需进行额外的字节序转换。
(4)UDP 校验和计算详解
1、校验和的组成:三部分求和
计算 UDP 校验和时,需对以下三部分进行 16 位反码求和:
-
伪首部 (Pseudo-header) ------ 来自 IP 层
-
UDP 首部 (UDP Header)
-
UDP 数据 (Data)
目的:确保数据不仅在传输层完整,还被正确投递到目标主机和端口。
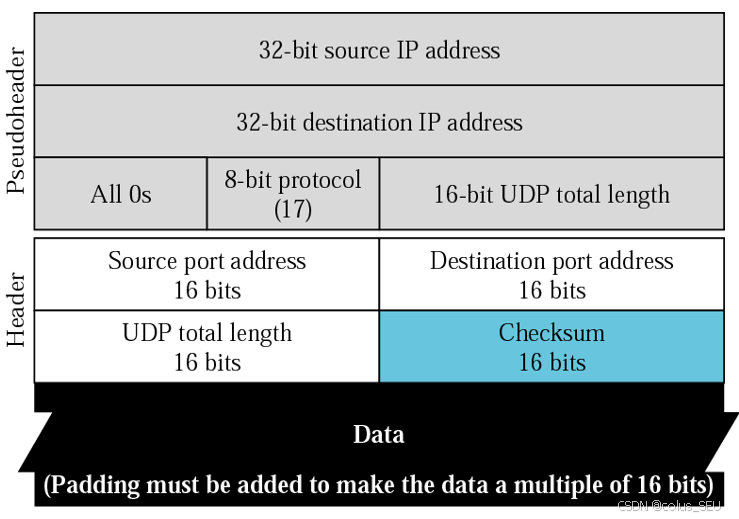
2、伪首部 (Pseudo-header) 内容
| 字段 | 大小 | 说明 |
|---|---|---|
| 源 IP 地址 | 32 位 | 取自 IP 报文头 |
| 目的 IP 地址 | 32 位 | 取自 IP 报文头 |
| 全 0 | 8 位 | 填充 |
| 协议号 | 8 位 | UDP 协议号为 17 |
| UDP 总长度 | 16 位 | 包含首部和数据 |
加入++伪首部可避免因 IP 路由错误导致数据被错误地交付给其他主机或进程。++
3、示例解析
假设发送数据 "TESTING",源 IP 153.18.8.105,目的 IP 171.2.14.10,源端口 1087,目的端口 13,UDP 长度 15。
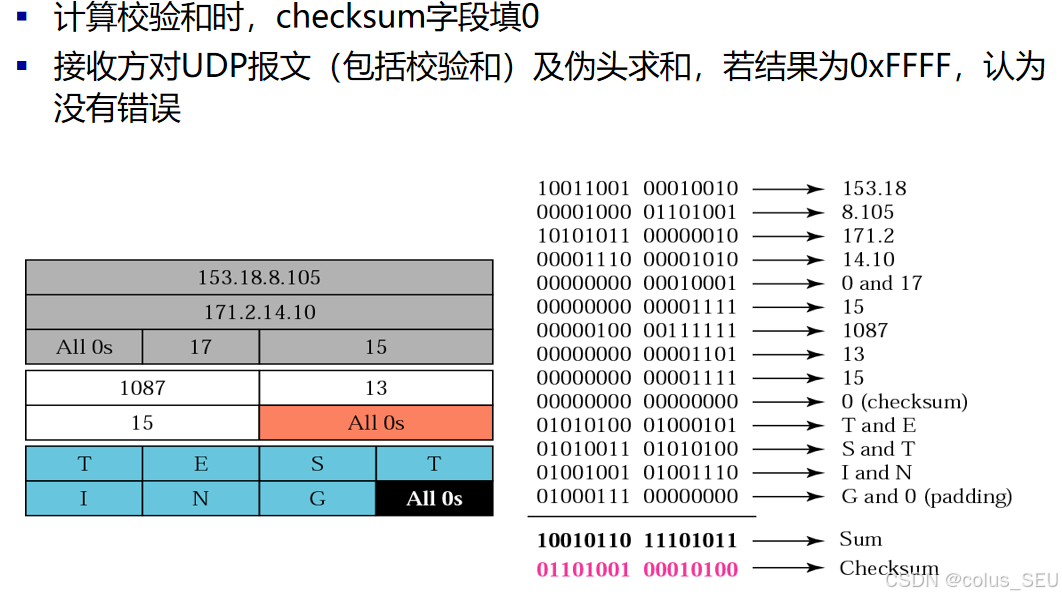
发送方计算校验和:
-
伪首部、UDP 首部、数据按 16 位分组。
-
所有字节(包括校验和字段置 0 后)进行反码求和。
-
最终得到
Sum = 10010110 11101011 -
校验和 =
~Sum = 01101001 00010100
接收方验证:
-
收到后,将所有部分(含刚计算出的校验和)再次求和。
-
结果应为
11111111 11111111(0xFFFF) → 无错误
(5)TCP 与 UDP 校验和的区别
| 特性 | TCP 校验和 | UDP 校验和 |
|---|---|---|
| 覆盖范围 | 覆盖 TCP 首部 + TCP 数据 + 伪首部 | 覆盖 UDP 首部 + UDP 数据 + 伪首部 |
| 必需性 | 必需 | 可选 (可设为 0) |
| 目的 | 端到端的可靠数据传输 | 检测传输错误 |
伪首部 (Pseudo-header): 包含源IP、目的IP、协议号和UDP长度,用于增强校验和的准确性,防止 IP 层路由错误导致的数据错投。
总结
-
UDP 校验和是 可选 的,但强烈建议启用。
-
它覆盖 伪首部、UDP 首部、数据,提供端到端完整性保护。
-
验证成功标志是结果为
0xFFFF。 -
++伪首部的设计使校验和能检测到 IP 地址错误或协议错误,提升了可靠性。++
四、可靠数据传输原理
Reliable Data Transfer, RDT
4.1. 简介
可靠数据传输(RDT)是应用层、传输层和链路层的核心研究课题,位列"网络十大重要主题"之一。
-
目标 :在不可靠信道 上,实现无差错、按序的数据交付。
-
关键挑战:底层信道可能丢包、乱序、损坏,协议必须克服这些缺陷。
✅ 服务 vs 实现:
提供的服务 (a): 应用层看到的是一个"可靠信道"。
服务的实现 (b): 底层通过复杂的 RDT 协议,在"不可靠信道"上模拟出可靠性。
RDT 的基本架构与接口:
| 函数 | 调用方 | 功能 |
|---|---|---|
rdt_send(data) |
应用层 | 发送数据给接收方应用层。 |
udt_send(packet) |
RDT 发送端 | 将报文经不可靠信道发送给接收端。 |
rdt_rcv(packet) |
RDT 接收端 | 当报文到达时被调用。 |
deliver_data(data) |
RDT 接收端 | 将数据递交给上层应用。 |
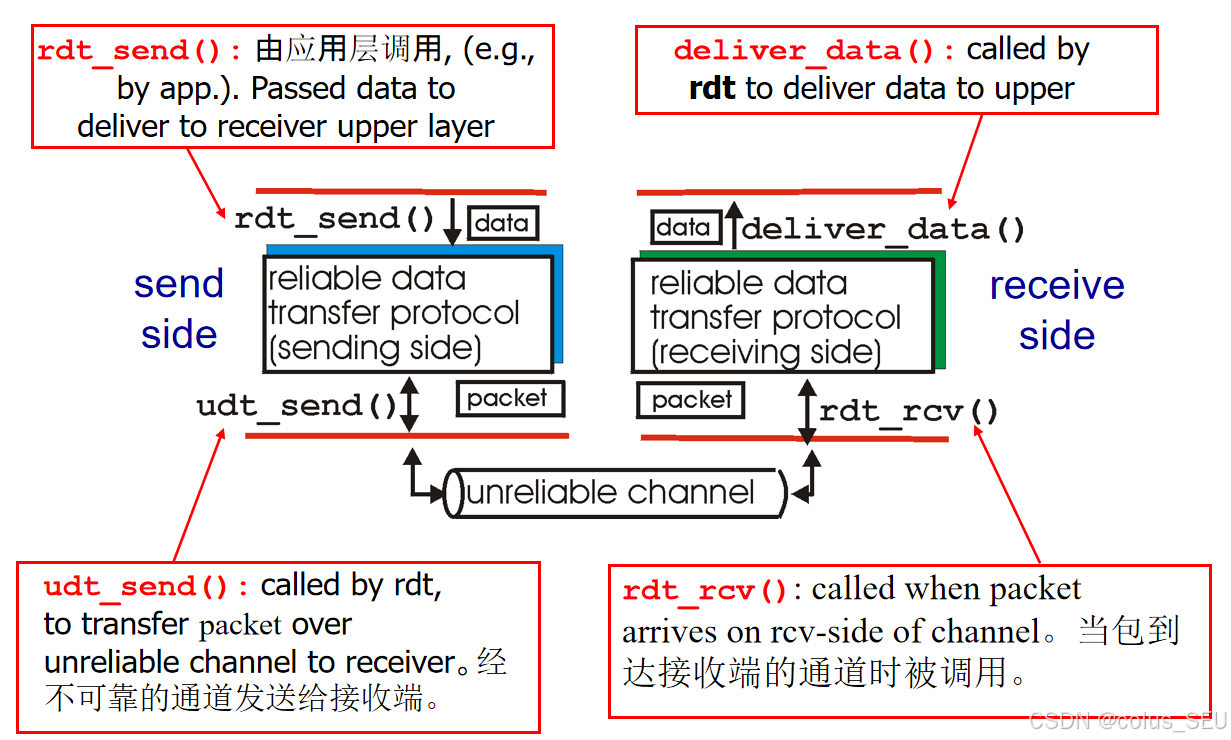
分层思想:
rdt_*是应用层可见的"可靠服务"接口。
udt_*是底层"不可靠信道"的实际传输接口。
4.2. RDT的设计(历程)
设计方法论
-
渐进式开发:从最简单的场景开始,逐步增加功能(如处理丢包、乱序、ACK丢失等)。
-
单向传输:为简化,先只考虑数据从发送方到接收方的单向流动。
⚠️ 但控制信息(如 ACK/NACK)会双向流动。
-
有限状态机 (FSM):使用 FSM 描述发送方和接收方的行为。
-
状态 (state): 协议当前所处的阶段。
-
事件 (event): 触发状态转换的条件(如收到数据包、超时)。
-
动作 (action): 状态转换时执行的操作(如发送 ACK、重传)。
-
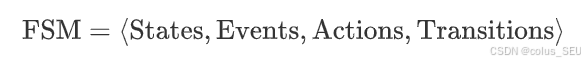
💡 这是设计所有复杂可靠协议(如 TCP)的基础模型。
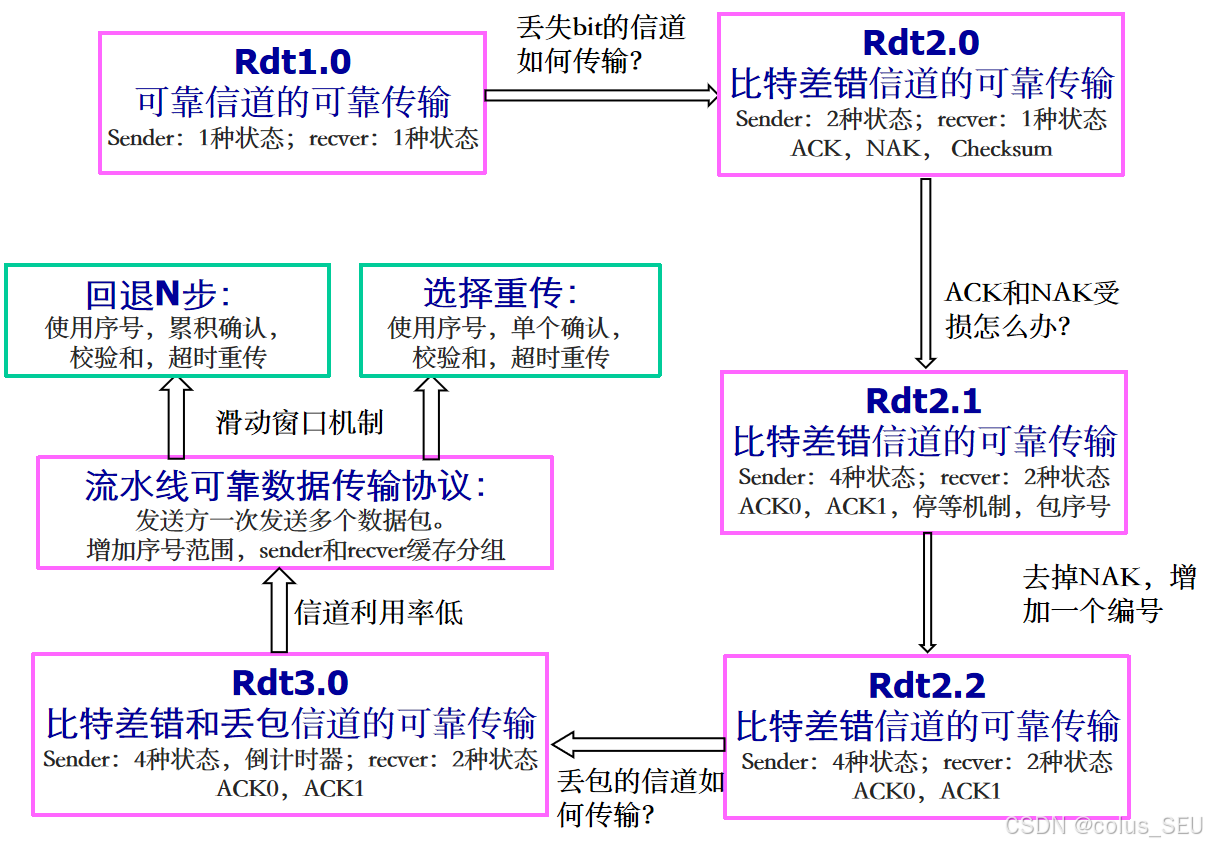
(1)RDT1.0
可靠信道上的可靠数据传输
1、核心假设
- 底层信道完美可靠:无比特错误 (no bit errors) + 无分组丢失 (no loss of packets)
2、协议设计
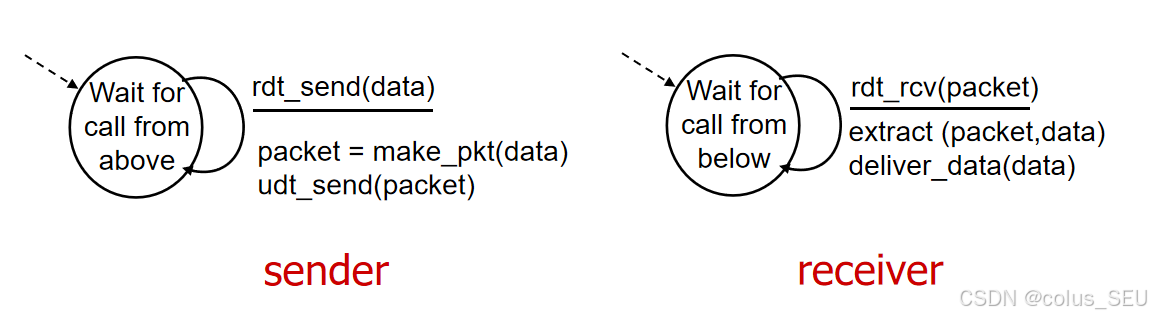
-
发送方与接收方使用独立的有限状态机 (FSMs)。
-
发送方行为:
-
等待上层调用
rdt_send(data)。 -
将数据封装成数据包:
packet = make_pkt(data)。 -
通过底层信道发送数据包:
udt_send(packet)。 -
返回等待下一个上层调用。
-
-
接收方行为:
-
等待底层信道传来数据包
rdt_rcv(packet)。 -
从数据包中提取数据:
extract(packet, data)。 -
将数据交付给上层应用:
deliver_data(data)。 -
返回等待下一个数据包。
-
3、关键特性
-
极简状态机:发送方和接收方均只有一种状态,协议流程简单直接。
-
无反馈机制:由于信道完美可靠,无需确认(ACK)或重传机制。
4、面临的问题与局限性
-
理论模型:rdt1.0 是一个理想化的起点,其"完美可靠"的假设在现实网络中不成立。
-
现实挑战:当信道出现比特错误或分组丢失时,该协议无法保证数据的可靠传输。
(2)RDT2.0
存在比特错误信道上的可靠数据传输
1、核心假设
- 底层信道不可靠:数据包在传输过程中可能发生比特翻转错误。如何从错误中恢复?
2、协议设计
新增机制 (相较于 rdt1.0)
rdt2.0 引入了三个关键新机制来应对比特错误:
-
错误检测 (Error Detection):使用 校验和 (Checksum) 来检测接收到的数据包是否发生比特错误。
-
消息反馈 (Feedback):接收方通过发送控制消息(ACK 或 NAK)向发送方提供明确的反馈。
-
重传 (Retransmission):发送方在收到 NAK 后,会重传当前数据包。
协议工作流程 (FSM Specification)
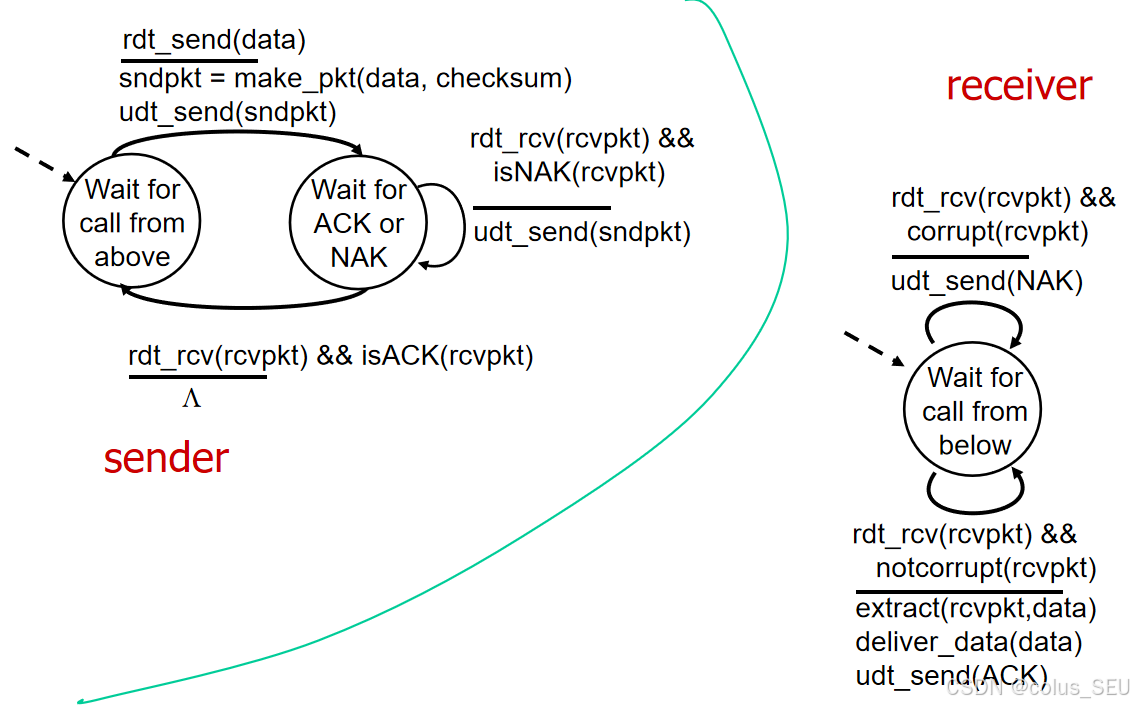
- 发送方 (Sender)
-
等待上层调用 :
Wait for call from above。 -
发送数据包 :收到
rdt_send(data)调用后,创建包含数据和校验和的数据包 (sndpkt = make_pkt(data, checksum)),并通过底层信道发送 (udt_send(sndpkt))。 -
等待确认 :进入
Wait for ACK or NAK状态。 -
处理反馈:
- 如果收到 ACK (
isACK(rcvpkt)),则认为数据包成功送达,返回Wait for call from above状态,准备发送下一个数据包。
- 如果收到 ACK (
-
如果收到 NAK (
isNAK(rcvpkt)),则认为数据包有误,重新发送当前数据包 (udt_send(sndpkt)),并继续等待反馈。 -
接收方 (Receiver)
-
等待数据包 :
Wait for call from below。 -
接收并校验 :收到数据包 (
rdt_rcv(rcvpkt)) 后,检查其是否损坏 (corrupt(rcvpkt))。 -
发送反馈:
- 如果数据包 损坏 (
corrupt(rcvpkt)),则发送 NAK (udt_send(NAK))。
- 如果数据包 损坏 (
- 如果数据包 未损坏 (
notcorrupt(rcvpkt)),则提取数据 (extract(rcvpkt, data)),交付给上层应用 (deliver_data(data)),然后发送 ACK (udt_send(ACK))。
3、关键特性
- "停等"协议 (Stop-and-Wait):发送方发送一个数据包后必须等待接收方的响应(ACK/NAK),才能进行下一步操作。
4、局限性与解决方案
局限 :ACK/NAK 本身也可能被损坏。如果 ACK/NAK 损坏,发送方无法得知接收方的真实状态,可能导致重复发送相同的数据包。
解决:为了解决 ACK/NAK 损坏导致的重复分组问题,后续协议(如 rdt2.1)将引入 序列号 (sequence number),使接收方能够识别并丢弃重复的数据包。
(3)RDT2.1
应对受损 ACK/NAK 的可靠数据传输
rdt2.1 是 rdt2.0 的改进版本,旨在解决其致命弱点:ACK 和 NAK 控制报文本身也可能在传输中被损坏 。rdt2.1 通过引入序列号 (sequence number) 来实现这一目标。
1、核心改进机制
-
引入序列号 (Sequence Number):
- 发送方为每个数据包添加一个序列号(
0或1)。
- 发送方为每个数据包添加一个序列号(
-
接收方根据序列号判断收到的数据包是否是期望的、以及是否为重复包。
2、协议设计
- 发送方 (Sender)
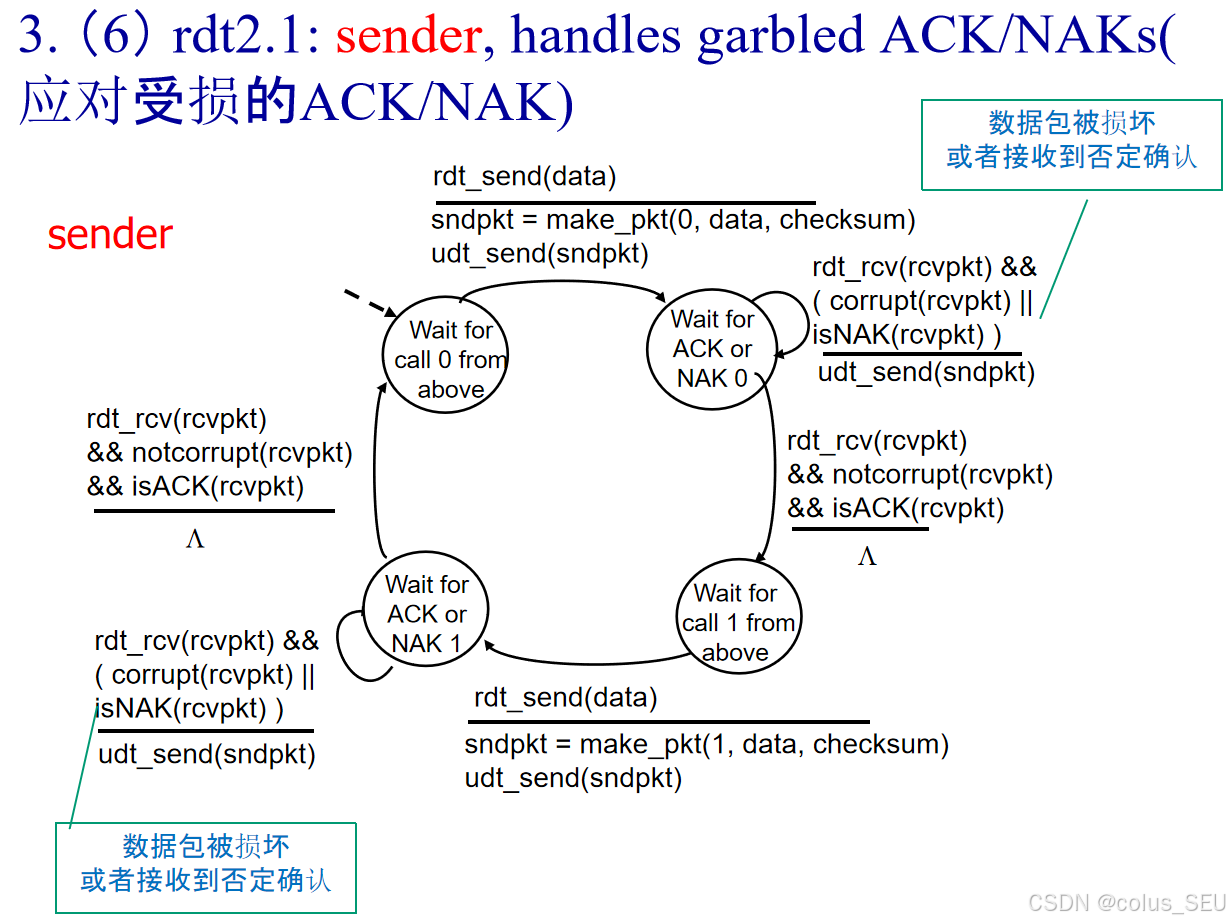
发送方的状态机比 rdt2.0 更复杂,增加了"等待 ACK/NAK 0"和"等待 ACK/NAK 1"两个状态。
-
初始状态 :
Wait for call 0 from above。 -
发送数据包 0 :收到上层调用后,创建并发送带序列号
0的数据包。 -
等待反馈 0 :进入
Wait for ACK or NAK 0状态。 -
处理反馈 0:
-
如果收到 未损坏的 ACK 0 ,则成功,进入
Wait for call 1 from above状态。 -
如果收到 损坏的 ACK/NAK 或 NAK 0 ,则重传数据包
0。
-
-
发送数据包 1 :收到上层调用后,创建并发送带序列号
1的数据包。 -
等待反馈 1 :进入
Wait for ACK or NAK 1状态。 -
处理反馈 1:
- 如果收到 未损坏的 ACK 1 ,则成功,返回
Wait for call 0 from above状态。
- 如果收到 未损坏的 ACK 1 ,则成功,返回
-
如果收到 损坏的 ACK/NAK 或 NAK 1 ,则重传数据包
1。 -
接收方 (Receiver)
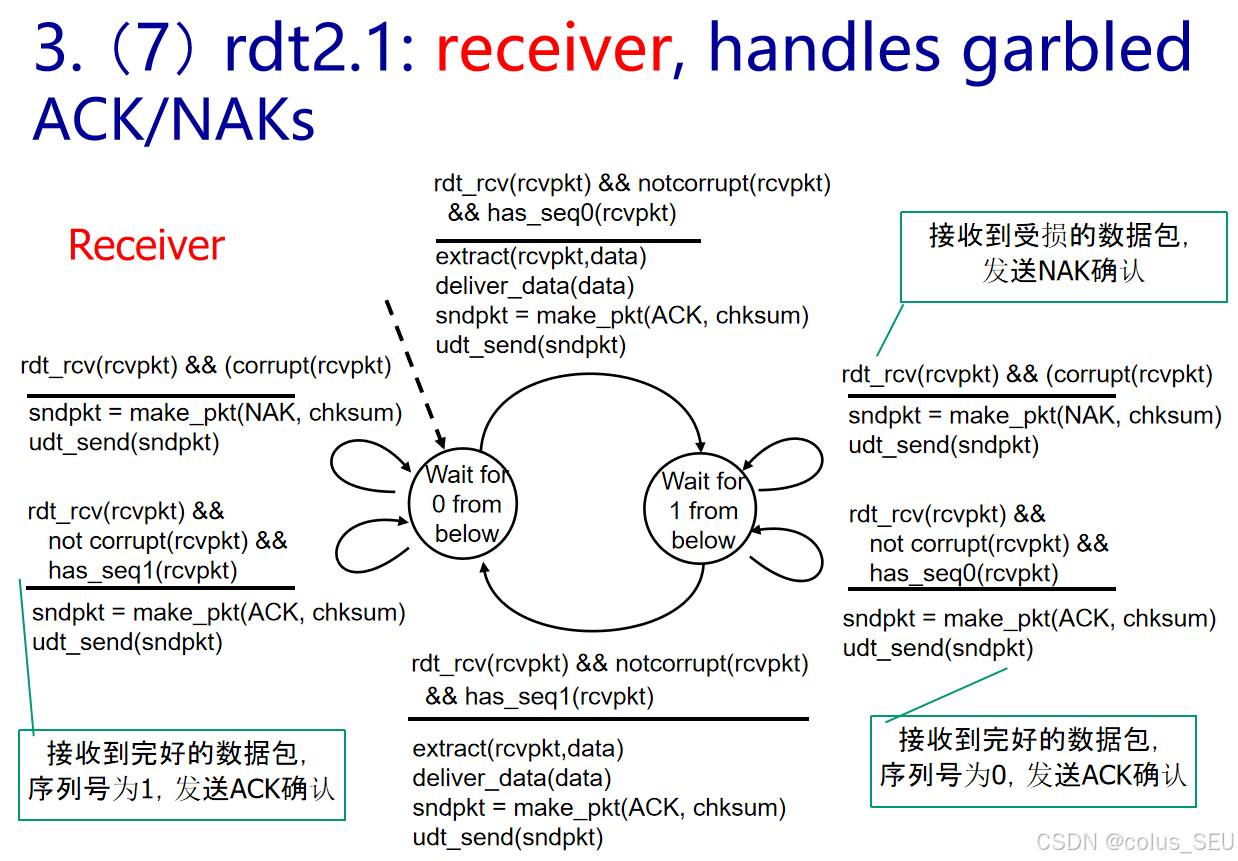
接收方的状态机也相应增加,分为"等待来自下方的 0 号包"和"等待来自下方的 1 号包"。
-
初始状态 :
Wait for 0 from below。 -
接收数据包:
-
如果收到 损坏的数据包 ,则发送 NAK。
-
如果收到 未损坏且序列号为 0 的数据包 ,则提取数据、交付给上层,并发送 ACK 0 ,然后进入
Wait for 1 from below状态。 -
如果收到 未损坏但序列号为 1 的数据包 (即重复包),则忽略该包,但仍发送 ACK 1 以确认已收到正确的包。
-
-
后续状态 :当处于
Wait for 1 from below状态时,逻辑与上述类似,只是期望的序列号变为1。
3、关键特性
-
仅需两位序列号 :使用
0和1两个序列号即可满足需求,因为协议是"停等"式的,一次只发送一个包。 -
状态数量翻倍:发送方和接收方的状态数从 rdt2.0 的 1 个增加到 2 个,用于跟踪当前期望的序列号。
-
接收方必须检查重复包:接收方需要根据当前状态判断收到的数据包是否是期望的,如果不是,则视为重复包并丢弃,但仍需发送对应的 ACK 以维持协议正常运行。
-
注意:接收方并不知道它最后发送的 ACK/NAK 是否被发送方成功接收,这是"停等"协议固有的特性。
(4)RDT2.2
无 NAK 的可靠数据传输协议
rdt2.2 是对 rdt2.1 的进一步优化,其核心思想是完全移除 NAK 机制,仅使用 ACK 来实现与 rdt2.1 相同的可靠性功能。
1、核心设计思想
-
摒弃 NAK:接收方不再发送否定确认(NAK)。
-
ACK 承担双重角色:接收方通过发送带有特定序列号的 ACK 来同时表示"成功接收"和"请求重传"。
- 当接收到一个正确的数据包时,接收方发送一个包含该数据包序列号的 ACK。
-
这个 ACK 不仅是对当前包的确认,也隐含地告诉发送方:"我已成功收到这个包,下一个我期望的是序列号为
1 - current_seq的包"。
2、协议工作流程 (FSM Specification)
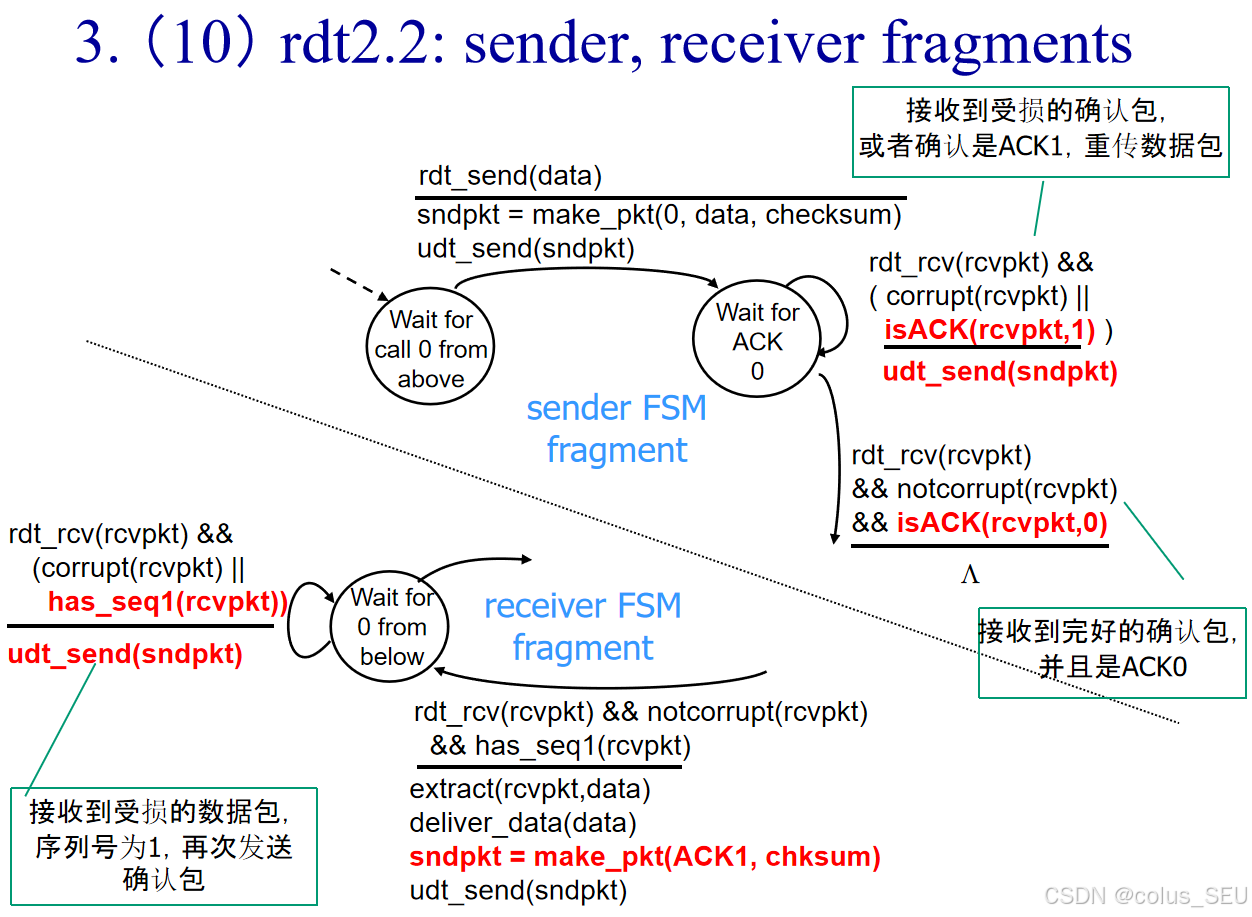
- 发送方 (Sender)
发送方的状态机与 rdt2.1 类似,但处理逻辑有所改变。
-
初始状态 :
Wait for call 0 from above。 -
发送数据包 0 :创建并发送带序列号
0的数据包。 -
等待 ACK 0 :进入
Wait for ACK 0状态。 -
处理反馈:
- 如果收到 未损坏的 ACK 0 ,则认为数据包
0成功送达,进入Wait for call 1 from above状态。
- 如果收到 未损坏的 ACK 0 ,则认为数据包
-
如果收到 损坏的 ACK 或 ACK 1 (即重复的 ACK),则说明接收方没有正确收到数据包
0,因此需要重传数据包0。 -
接收方 (Receiver)
接收方的行为与 rdt2.1 基本一致,只是不再发送 NAK。
-
初始状态 :
Wait for 0 from below。 -
接收数据包:
-
如果收到 损坏的数据包 ,则忽略该包,并再次发送上一个成功的 ACK (例如,如果之前成功收到了包
0,就再发一次 ACK 0)。 -
如果收到 未损坏且序列号为 0 的数据包 ,则提取数据、交付给上层,并发送 ACK 0 ,然后进入
Wait for 1 from below状态。 -
如果收到 未损坏但序列号为 1 的数据包 (即重复包),则忽略该包,但仍发送 ACK 1 以确认已收到正确的包。
-
3、关键特性
-
功能等价:在功能上与 rdt2.1 完全相同,都能处理比特错误和受损的控制报文。
-
简化控制消息:协议只使用一种控制消息(ACK),简化了协议的设计和实现。
-
ACK 的语义:ACK 不仅用于确认,还用于指示接收方期望的下一个数据包的序列号。重复的 ACK 和 NAK 在效果上是相同的,都会触发发送方重传当前的数据包。
(5)RDT3.0
存在错误和丢包信道上的可靠数据传输
rdt3.0 是 rdt2.2 的最终演进版本,它解决了数据包或确认报文(ACK)可能丢失这一最现实的网络问题。
1、核心假设与挑战
-
底层信道不可靠 :不仅可能发生比特错误,还可能出现数据包或 ACK 丢失。
-
关键问题:如何区分"包丢失"和"包延迟"?如果发送方等待 ACK 超时,是应该重传还是继续等待?
2、核心机制:定时器 (Timer)
为了解决丢包问题,rdt3.0 引入了定时器机制:
-
设定超时时间:发送方在发送一个数据包后,会启动一个倒计时定时器。
-
等待 ACK:发送方等待接收方的 ACK。
-
触发重传:
- 如果在定时器超时前收到正确的 ACK,则停止定时器,发送下一个数据包。
- 如果定时器超时仍未收到 ACK,则认为数据包或 ACK 已丢失,重传当前数据包并重新启动定时器。
3、协议工作流程 (FSM Specification)
- 发送方 (Sender)
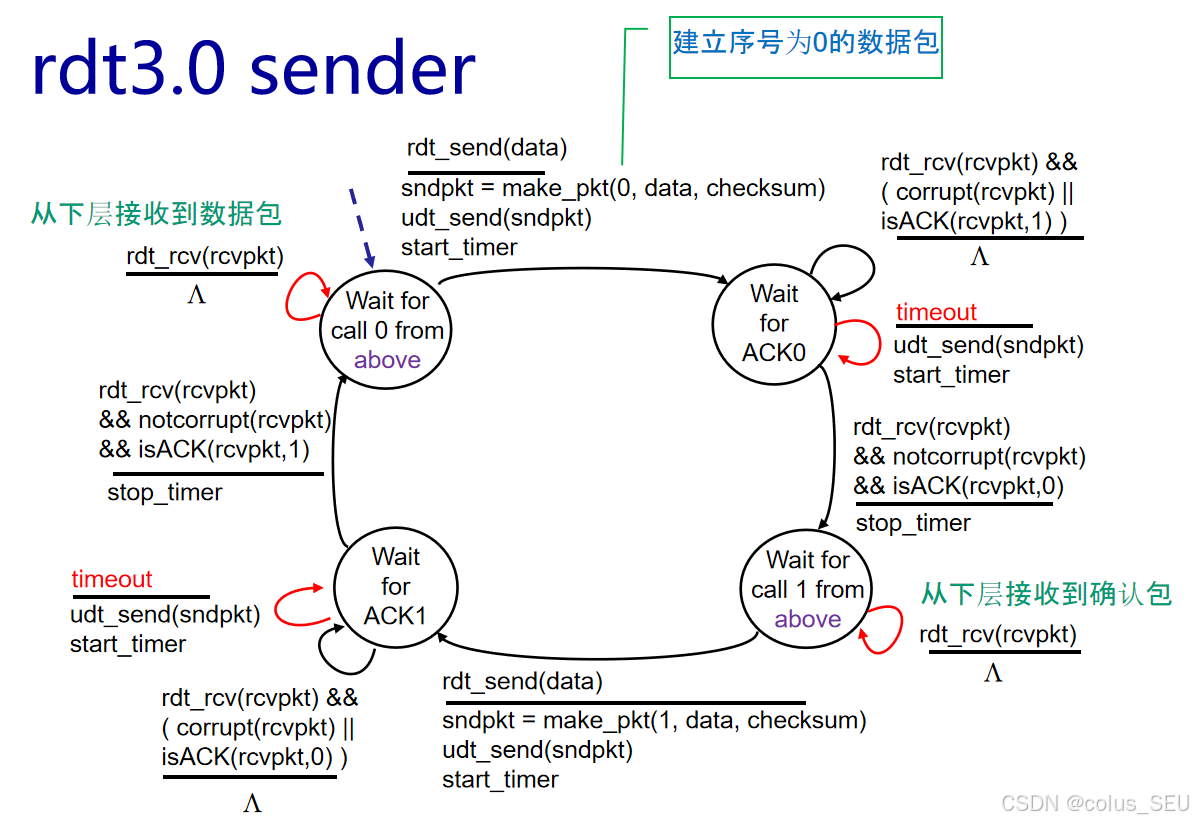
发送方的状态机与 rdt2.2 类似,但增加了 start_timer 和 stop_timer 操作。
-
初始状态 :
Wait for call 0 from above。 -
发送数据包 0 :创建并发送带序列号
0的数据包,并启动定时器。 -
等待 ACK 0 :进入
Wait for ACK 0状态。 -
处理反馈或超时:
-
如果收到 未损坏的 ACK 0 ,则停止定时器 ,进入
Wait for call 1 from above状态。 -
如果发生 timeout ,则重传数据包
0并重启定时器。 -
如果收到 损坏的 ACK 或 ACK 1 ,则重传数据包
0并重启定时器。
-
-
后续状态 :逻辑与上述类似,只是序列号变为
1。
- 接收方 (Receiver)
接收方的行为与 rdt2.2 完全相同,仅使用 ACK 并通过序列号处理重复包。
4、协议行为示例
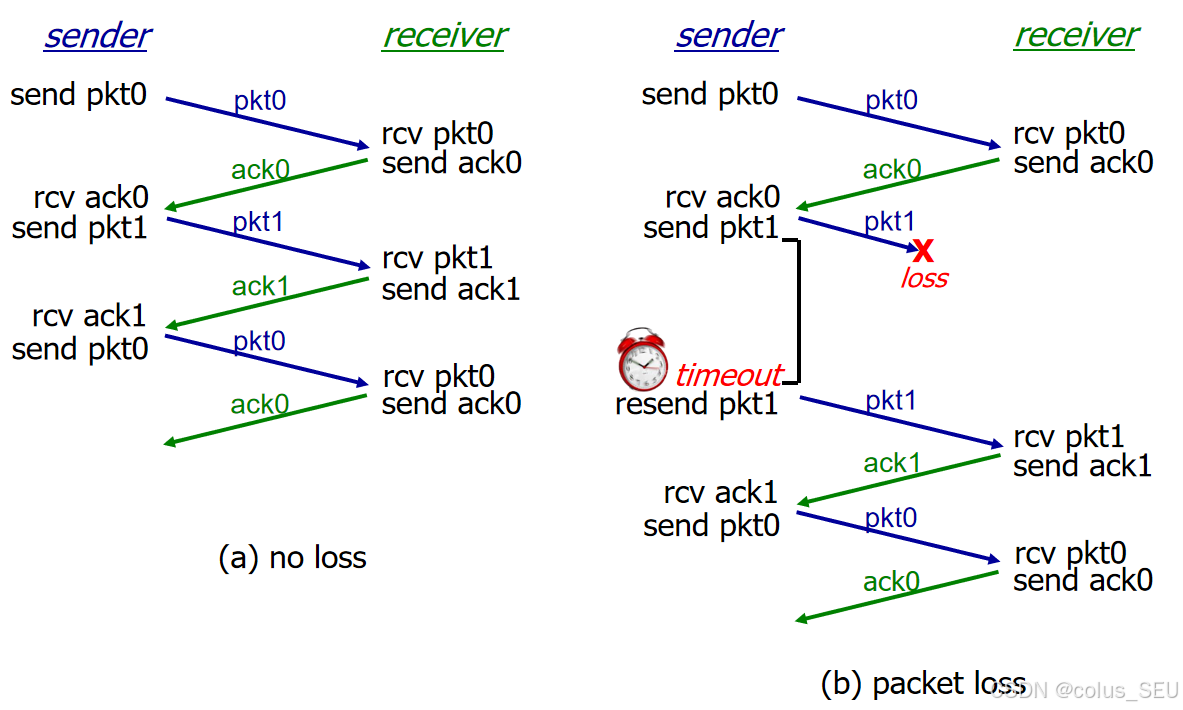
-
(a) 无丢失:正常的数据包和 ACK 交换过程。
-
(b) 数据包丢失 :当
pkt1丢失时,发送方因超时而重传pkt1。 -
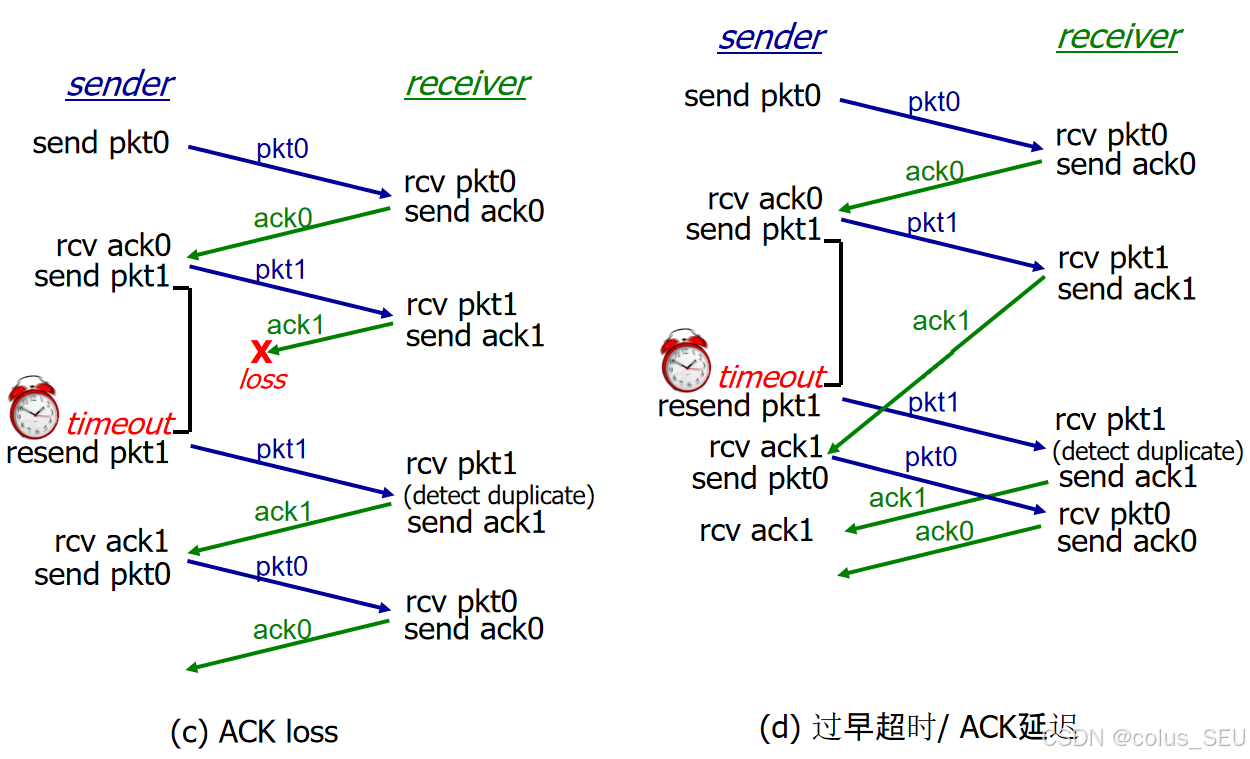
(c) ACK 丢失 :当
ack1丢失时,发送方因超时而重传pkt1。接收方收到重复的pkt1后,会再次发送ack1。 -
(d) 过早超时/ACK 延迟 :即使
ack1只是延迟而非丢失,发送方也会因超时而重传pkt1。接收方会检测到重复包并忽略,但仍会发送ack1。
5、性能分析
虽然 rdt3.0 在功能上是正确的,但其性能非常差。
-
利用率极低 (U_sender):
-
发送方在发送一个数据包后,必须等待整个往返时间(RTT)才能发送下一个包。
-
计算公式:
U_sender = (L/R) / (RTT + L/R),其中L是数据包大小,R是链路速率。 -
例如,在 RTT=30ms、链路速率为 1Gbps、数据包大小为 8000bit 的情况下,发送方利用率仅为
0.00027(0.027%)。
-
-
吞吐量低下:
- 在上述例子中,实际吞吐量仅为
33kB/sec,远低于物理链路的1Gbps能力。
- 在上述例子中,实际吞吐量仅为
-
根本原因:"停等"协议严重限制了物理资源的使用,导致网络带宽被大量浪费在等待上。
(6)流水线协议
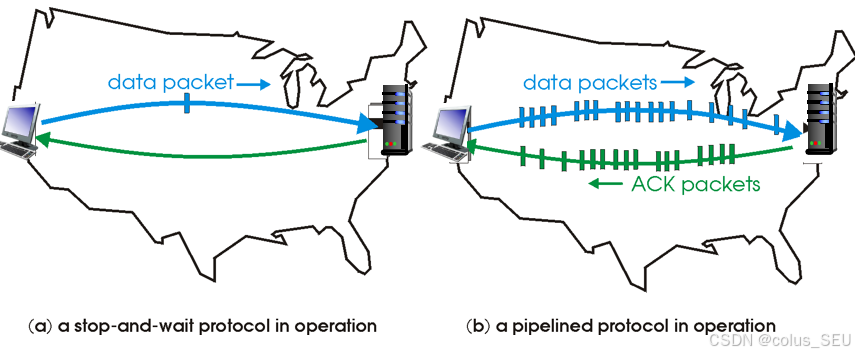
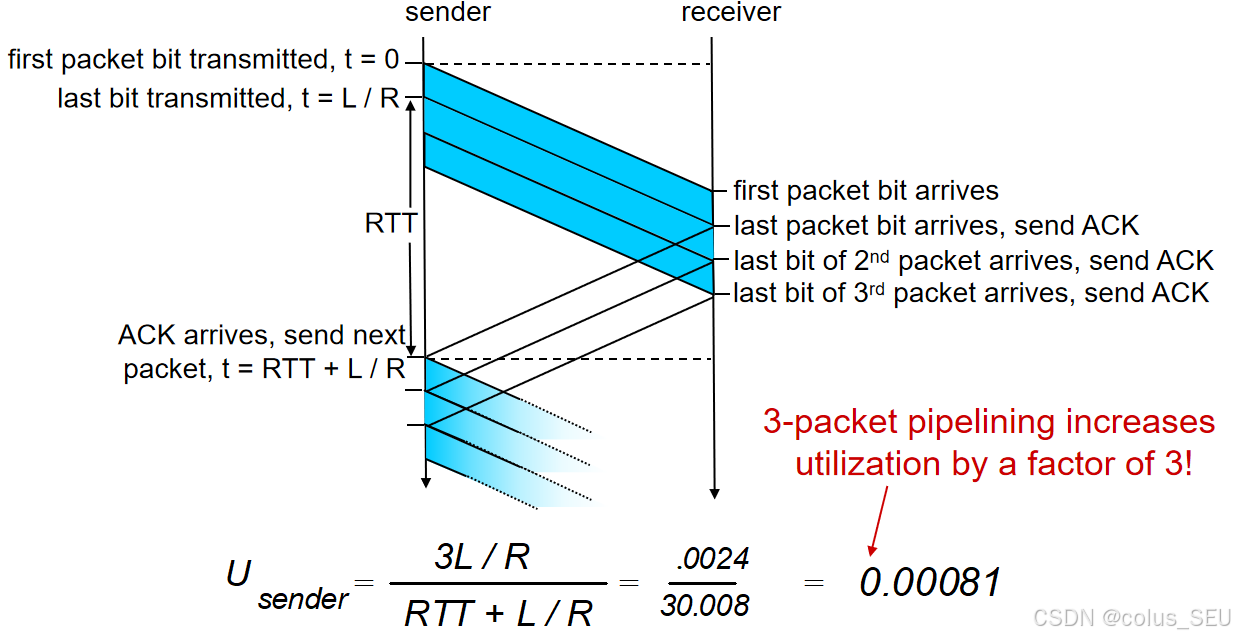
流水线 (Pipelining) 是一种提高网络传输效率的关键技术,它允许发送方在未收到前一个数据包的确认(ACK)之前,就连续发送多个数据包。流水线协议解决了RDT3.0的停等协议导致的发送方利用率低下的问题,还是上面的例子,换成3数据报流水线就能使发送方利用率增加3倍:
-
必要条件:
- 序列号范围必须扩大:因为需要同时追踪多个在途的数据包。
-
发送方和接收方都需要缓存:发送方需要缓存已发送但未被确认的数据包以便重传;接收方需要缓存乱序到达的数据包。
1、两种主要的流水线协议
-
Go-Back-N (回退N步)
-
发送方 :最多可以有
N个未被确认的数据包在"管道"中。 -
接收方 :只发送累积确认 (cumulative ACK)。它只会确认按序接收到的、最大的连续数据包。如果收到的数据包序号不连续,则不发送新的确认报文。
-
重传机制 :发送方只为最旧的未确认数据包 设置一个定时器。当该定时器超时时,发送方会重传所有从该最旧包开始的所有未确认数据包。
-
-
Selective Repeat (选择重传)
-
发送方 :最多可以有
N个未被确认的数据包在"管道"中。 -
接收方 :为每一个 成功接收的数据包发送单独的确认 (individual ACK)。
-
重传机制 :发送方为每一个 未确认的数据包都设置一个独立的定时器。当某个数据包的定时器超时时,发送方只重传那一个未被确认的数据包。
-
2、关键概念详解
-
滑动窗口协议 (Sliding Window Protocol)
-
这是实现流水线协议的一种通用框架。
-
发送窗口 (Send Window):在任意时刻,发送方维护一个连续的、允许发送的数据包序号范围。窗口内的序号代表那些已经发送但尚未被确认的数据包,以及那些可以立即发送的数据包。
-
接收窗口 (Receive Window):接收方也维护一个连续的、允许接收的数据包序号范围。
-
发送窗口和接收窗口的大小和边界可以不同。
-
-
累积确认 (Cumulative Acknowledge)
-
这是 Go-Back-N 协议的核心特征。
-
接收方即使收到了更高序号的数据包,也只会确认按序接收到的最大序号 。++例如,如果接收方收到了包 0, 1, 3,它只会发送对包 1 的确认,表示"我已经成功收到了包 0 和包 1",而不会提及包 3,因为中间缺少包2。++
-
(6.1)GBN
Go-Back-N (回退N步) 是一种流水线协议,通过允许发送方在未收到确认的情况下连续发送多个数据包来提高信道利用率。
1、核心概念与数据结构
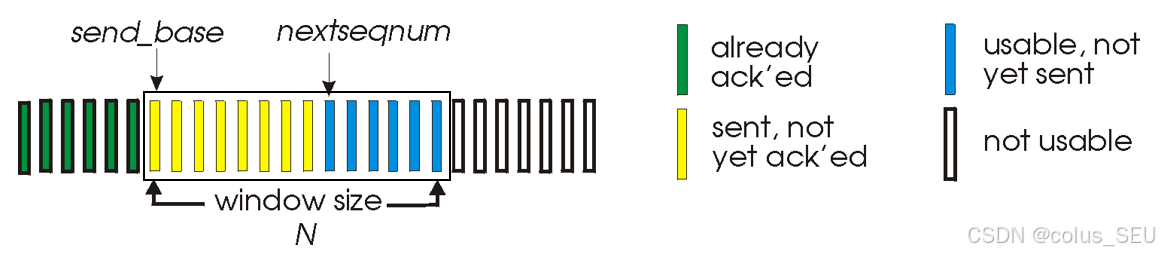
-
序列号:每个数据包的头部包含一个 K 位的序列号。
-
发送窗口 (Send Window):
-
大小为
N,表示发送方最多可以有N个未被确认的数据包在"管道"中。 -
窗口由两个指针定义:
-
send_base:窗口的起始序号,代表最早未被确认的数据包。 -
nextseqnum:下一个待发送数据包的序号。
-
-
窗口内状态:
[send_base, nextseqnum - 1]:已发送但未被确认的数据包。
-
[nextseqnum, send_base + N - 1]:可立即发送的数据包(如果上层有数据)。
-
-
累积确认 (Cumulative ACK) :接收方发送的 ACK
n表示它已经成功按序接收了所有序号小于等于n的数据包。
2、发送方 (Sender) 机制
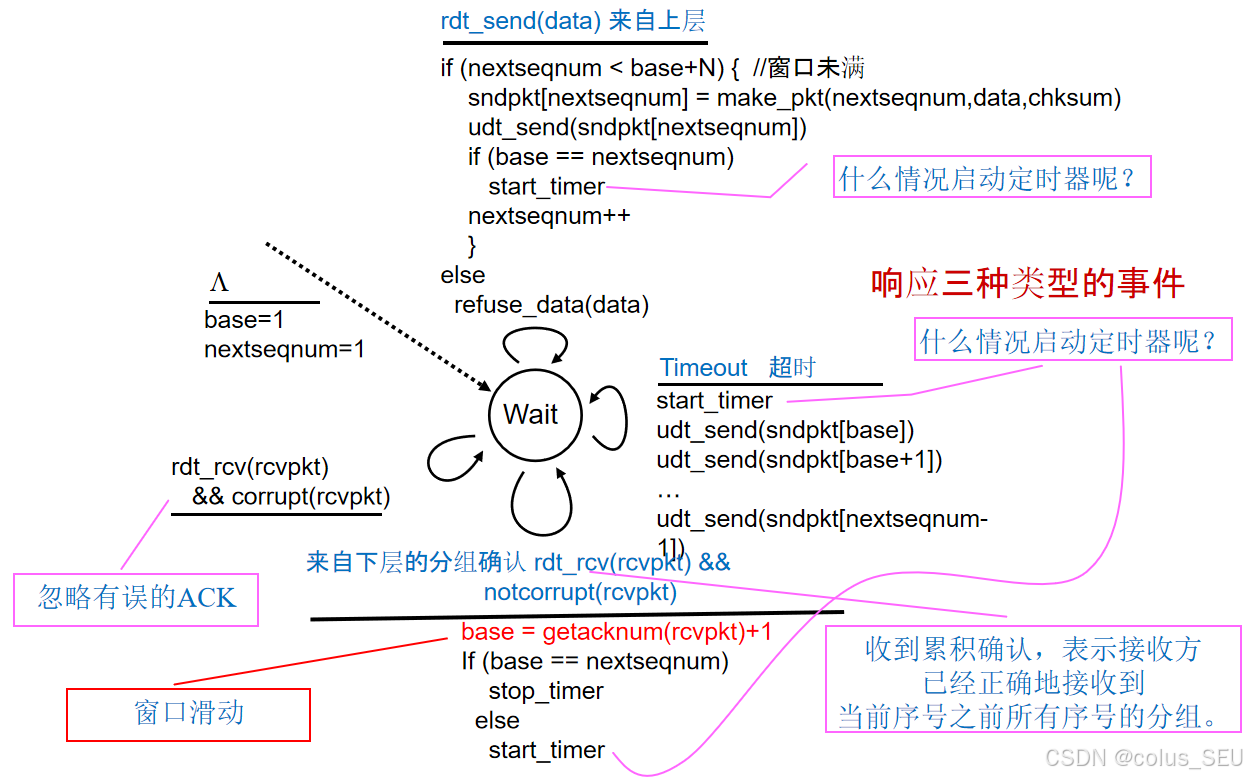
发送方的状态机需要响应三种事件:
-
来自上层的调用 (
rdt_send(data)):-
如果
nextseqnum < send_base + N(窗口未满),则创建并发送数据包,并将nextseqnum加 1。 -
如果
send_base == nextseqnum(这是窗口中第一个包),则启动定时器。 -
如果窗口已满,则拒绝上层数据。
-
-
超时事件 (Timeout):
-
当定时器超时时,重传从
send_base开始的所有未确认数据包(即窗口中的所有包)。 -
重传后重新启动定时器。
-
-
来自下层的确认 (
rdt_rcv(rcvpkt)):-
如果收到的 ACK 包含有效且未损坏的确认号
n,则更新send_base = n + 1。 -
如果
send_base == nextseqnum(所有已发送包均被确认),则停止定时器。 -
否则,重启定时器(因为仍有未确认的包)。
-
忽略损坏或重复的 ACK。
-
3、接收方 (Receiver) 机制
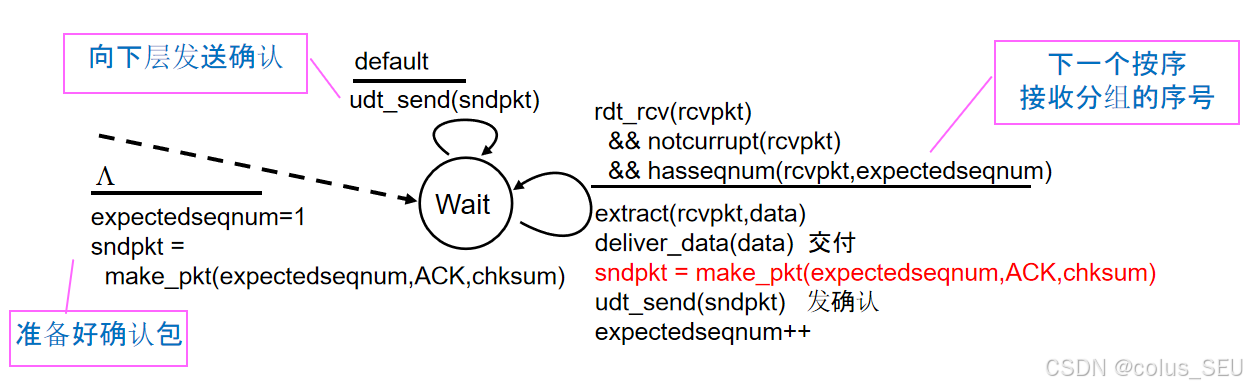
接收方的行为相对简单,其核心是"ACK-only"和"无缓冲"。
-
始终发送累积确认:
-
只为按序接收到的最高序号的数据包发送 ACK。
-
例如,如果期望接收序号
expectedseqnum,而收到了该序号的包,则交付给上层,并发送对该包的 ACK,然后将expectedseqnum加 1。 -
这可能导致产生重复的 ACK。
-
-
处理失序包 (Out-of-order pkt):
-
丢弃 (Don't buffer!):接收方不缓存任何失序到达的数据包。
-
重新确认:对于每一个失序包,接收方都会重新发送对上次成功按序接收到的最高序号包的 ACK。这可以提醒发送方可能有包丢失。
-
4、GBN 运行示例
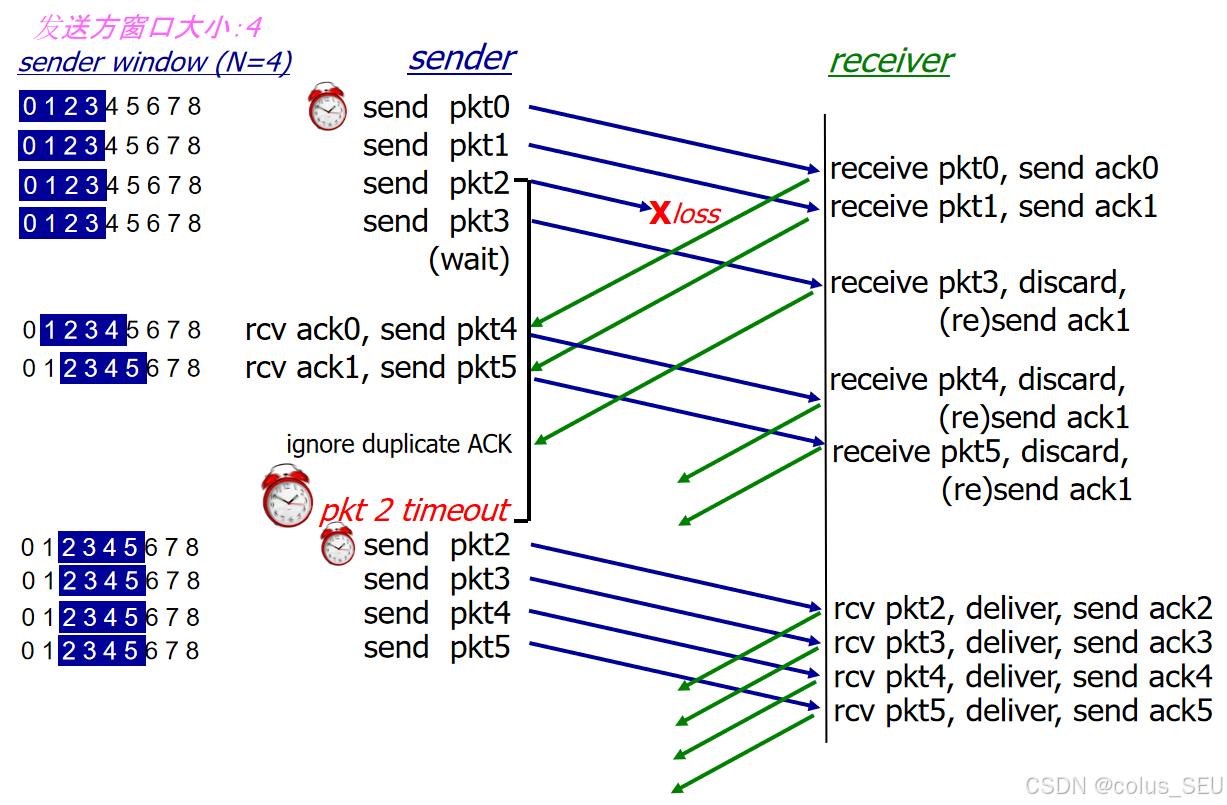
假设发送窗口大小 N=4:
-
发送方发送
pkt0,pkt1,pkt2,pkt3。 -
pkt2丢失。 -
接收方收到
pkt0和pkt1后,分别发送ack0和ack1。 -
接收方收到失序的
pkt3后,将其丢弃,并重新发送ack1。 -
发送方收到
ack0和ack1后,更新send_base。 -
当
pkt2的定时器超时后,发送方重传pkt2,pkt3,pkt4,pkt5。 -
接收方按序收到
pkt2,pkt3,pkt4,pkt5后,依次交付并发送对应的 ACK。
例题:
考虑两台网络主机A和B,它们使用 GBN 协议进行通信。A与B之间存在一条链路,其传输速率为64kb/s,单向传播延迟为250ms。假设A生成固定长度为1000字节的数据帧,B始终以相同长度的帧进行确认。为最大化信道利用率,A的发送窗口最小值应为多少?
答:
发送一帧所需要的时间:
\\frac{1000 \\times 8b}{64 \\times 1000b/s} = 125ms
从发送一帧到收到确认的总时间为(125+250)\times2=750ms 这段时间总共可以发送750/125=6帧 所以,为了最大化利用率,最小窗口为6。
(6.2)SR
选择重传 (Selective Repeat, SR) 是一种高效的流水线协议,它通过只重传丢失或出错的数据包来避免 Go-Back-N 中的"回退"开销。
1、核心机制
-
接收方单独确认 :接收方为每一个正确接收到 的数据包发送一个独立的 ACK。
-
接收方缓存:接收方会缓存所有失序到达的数据包,等待缺失的包到达后,再按序交付给上层应用。
-
发送方精准重传 :发送方只为那些未收到 ACK 的数据包进行重传。
-
每个包独立计时:发送方为每一个已发送但未被确认的数据包都设置一个独立的定时器。当某个包的定时器超时时,只重传该包。
2、窗口结构
与 GBN 类似,SR 也使用滑动窗口,但发送方和接收方各自维护一个窗口:
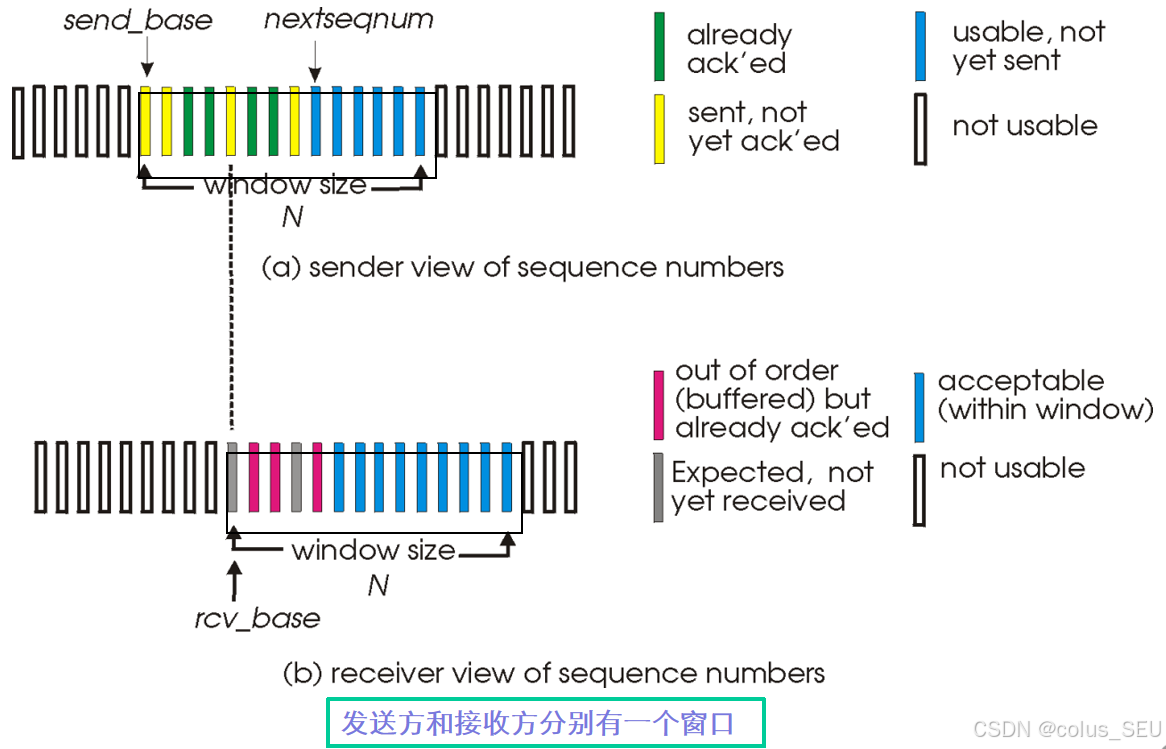
-
发送窗口 (Sender Window):
-
大小为
N,包含N个连续的序列号。 -
窗口内的序号代表已发送但未被确认的数据包,以及可以立即发送的数据包。
-
由
send_base和nextseqnum指针定义。
-
-
接收窗口 (Receiver Window):
-
大小也为
N,包含N个连续的序列号。 -
窗口内的序号代表接收方期望接收的数据包。
-
由
rcv_base指针定义。 -
接收窗口内可能包含:
-
预期但未收到的包。
-
已接收并确认的包(失序到达)。
-
可接受的包(在窗口范围内)。
-
-
3、发送方 (Sender)
-
来自上层的数据:
- 如果窗口中有可用的序列号,则发送数据包。
-
超时事件 (
timeout(n)):- 重新发送序号为
n的数据包,并重启其定时器。
- 重新发送序号为
-
收到 ACK (
ACK(n)):-
标记序号为
n的数据包为已接收。 -
如果
n是当前窗口中最小的未确认包,则将窗口的基值send_base向前移动到下一个未确认包的序号。
-
4、接收方 (Receiver)
-
收到序号在
[rcv_base, rcv_base + N - 1]范围内的包:-
发送对该包的 ACK。
-
如果是按序包 (即
n == rcv_base),则交付给上层,并检查是否有缓存的失序包可以一并交付,然后移动rcv_base。 -
如果是失序包,则将其缓存。
-
-
收到序号在
[rcv_base - N, rcv_base - 1]范围内的包:- 这些是重复的包,发送对应的 ACK 以确认。
-
其他情况:
- 忽略。
5、SR 运行示例
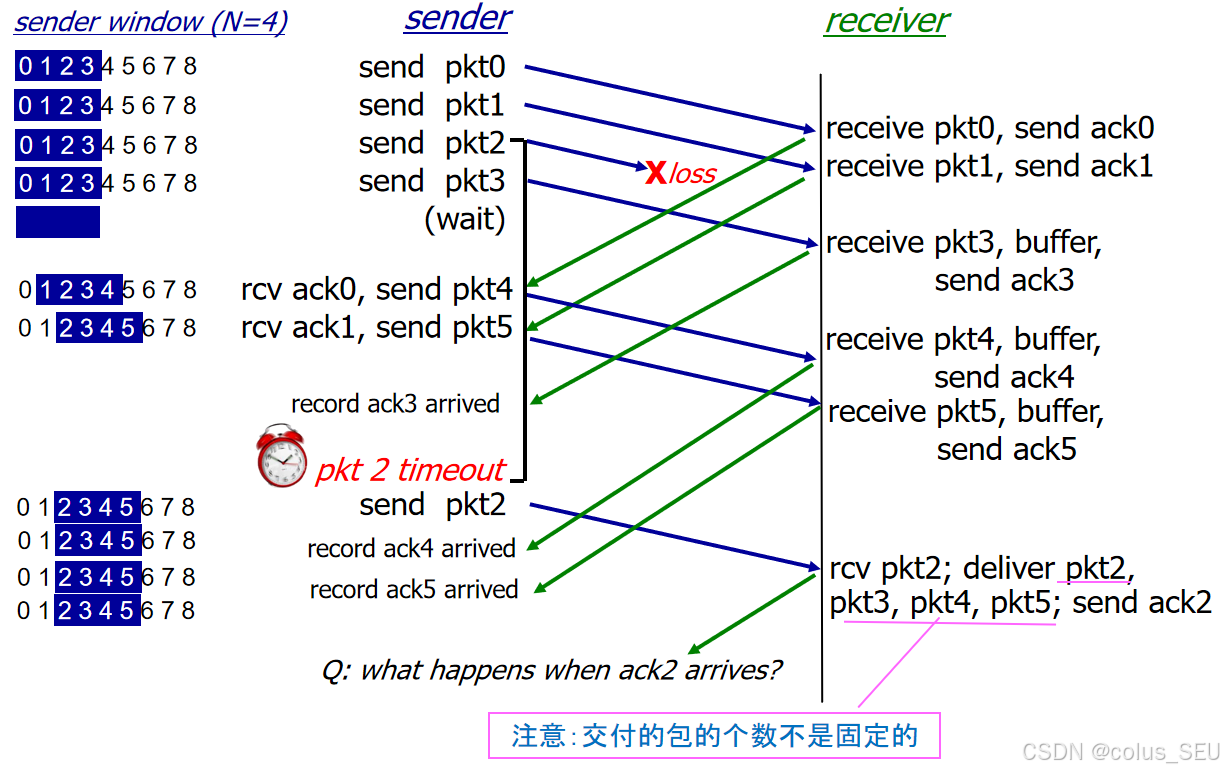
假设窗口大小 N=4:
-
发送方发送
pkt0,pkt1,pkt2,pkt3。 -
pkt2丢失。 -
接收方收到
pkt0,pkt1后,分别发送ack0,ack1,并交付给上层。 -
接收方收到失序的
pkt3,pkt4,pkt5后,将其缓存,并发送ack3,ack4,ack5。 -
当
pkt2的定时器超时后,发送方只重传pkt2。 -
接收方收到
pkt2后,由于pkt3,pkt4,pkt5已在缓存中,因此可以一次性将pkt2,pkt3,pkt4,pkt5按序交付给上层,并发送ack2。 -
发送方收到
ack2后,将窗口的基值send_base向前移动到下一个未确认包的序号,即6号。
6、存在的问题与解决方案
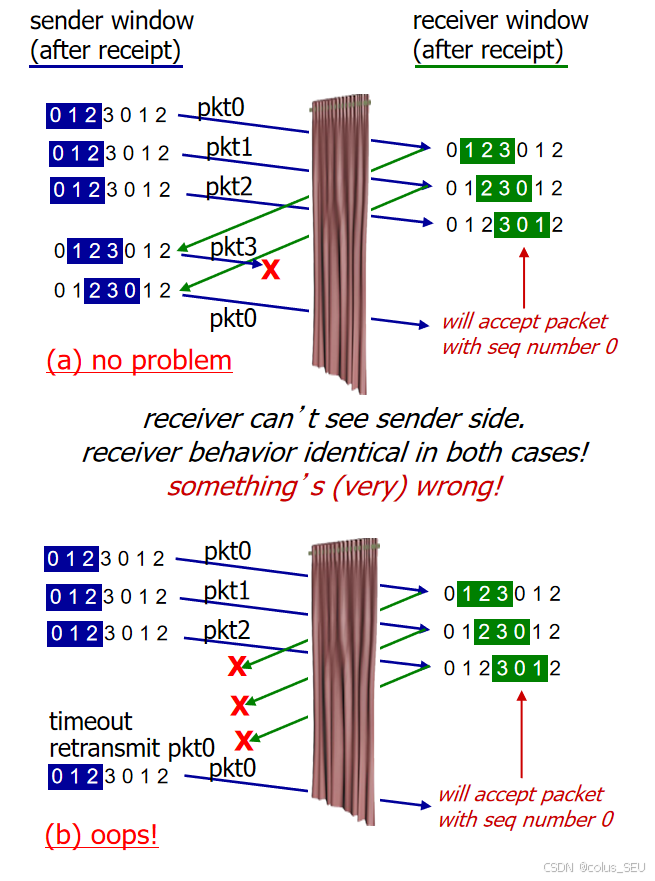
-
问题:如果序列号空间太小,而窗口太大,会导致接收方无法区分新旧数据包。
- 例如,序列号范围为
{0, 1, 2, 3},窗口大小为3。当发送方重传pkt0时,接收方无法判断这是新的pkt0还是上一轮的旧pkt0,可能导致重复数据被当作新数据处理。
- 例如,序列号范围为
-
解决方案:
- 窗口大小必须小于或等于序列号空间大小的一半 :
window_size <= max_seq_num / 2。
- 窗口大小必须小于或等于序列号空间大小的一半 :
-
这样可以确保在任何时刻,接收窗口内的序列号与发送方可能重传的旧序列号之间没有重叠,从而避免歧义。
五、面向连接的传输层协议:TCP
5.1. 分段结构
1、TCP报文段结构
TCP报文段由固定头部(20字节)和可选的选项字段及数据部分组成。
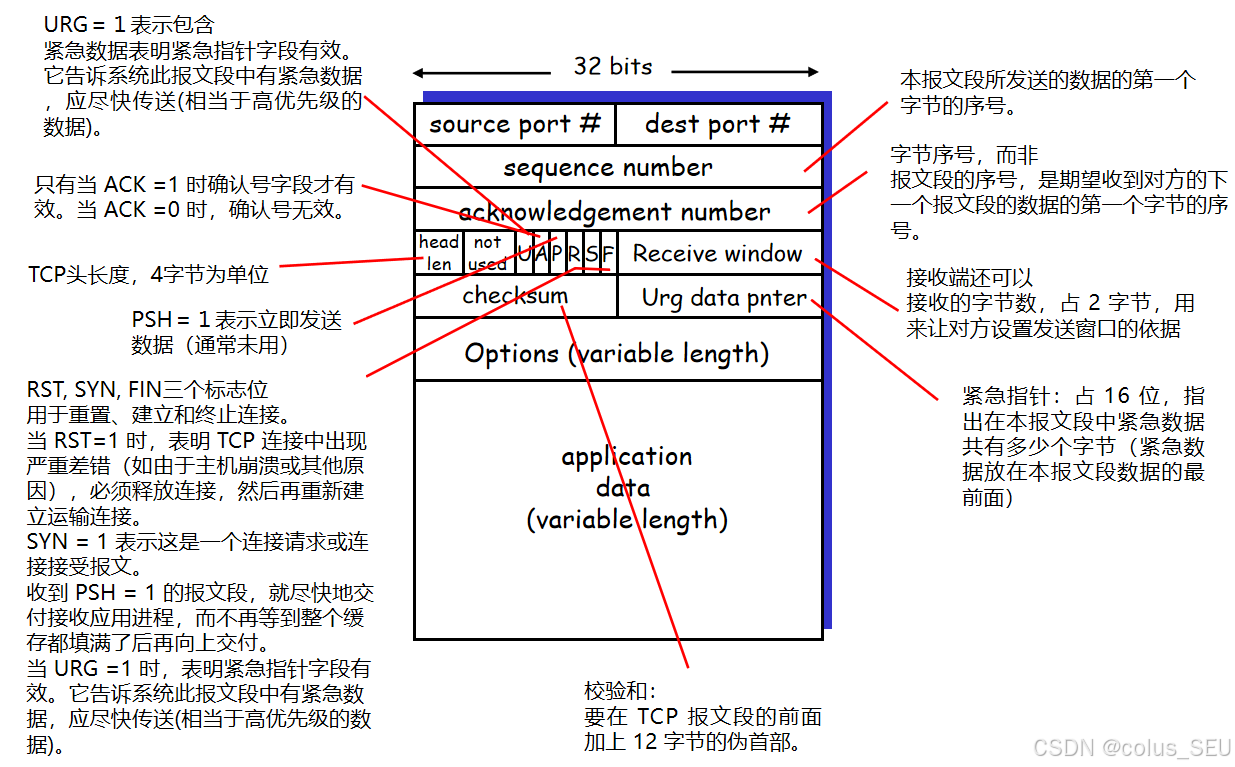
-
源端口 (source port #) & 目的端口 (dest port #): 各占16位,标识通信的两端应用。
-
序号 (sequence number): 占32位,表示本报文段所发送数据的第一个字节的序号。用于保证数据按序到达。
-
确认号 (acknowledgement number): 占32位,只有当ACK标志位为1时有效,表示期望收到对方的下一个报文段的第一个字节的序号。
-
数据偏移 (head len): 占4位,以4字节为单位,指示TCP头部长度。
-
控制位 (Flags):
-
URG: 紧急指针有效,表示报文段中有紧急数据,需优先处理。 -
ACK: 确认号字段有效。 -
PSH: 推送数据,要求接收方立即交付给应用层。 -
RST: 重置连接,用于异常情况下的连接释放。 -
SYN: 同步序列号,用于建立连接。 -
FIN: 终止连接。
-
-
窗口大小 (Receive window): 占16位,表示接收端当前还能接收的字节数,用于流量控制。
-
校验和 (checksum): 用于检测报文段在传输中是否出错,计算时需加上12字节的伪首部。
-
紧急指针 (Urg data pnter): 占16位,指向紧急数据的末尾,仅在URG=1时有效。
-
选项 (Options): 可变长度,用于协商MSS、窗口比例因子等参数。
-
数据 (application data): 可变长度,承载上层应用的数据。
2、MTU与MSS
-
MTU (Maximum Transmission Unit):
-
定义:IP数据报能经过一个物理网络的最大长度,包含IP首部。
-
典型值:以太网MTU通常设为1500字节。
-
计算:IP数据报最大长度 = MTU = 1500字节;整个以太网帧最大长度 = MTU + 14字节(以太帧首部) = 1514字节。
-
-
MSS (Maximum Segment Size):
-
定义:TCP报文段中数据部分的最大长度,不包括TCP首部。
-
协商:在TCP连接建立时(通过SYN报文中的选项),双方协商确定。
-
计算关系:
MSS = MTU - IP首部大小 - TCP首部大小。 -
作用:避免IP分片。若MSS + TCP首部 + IP首部 > MTU,则会发生分片。
-
3、重要的TCP选项
-
最大段长度 (MSS):
-
指定TCP段中可以携带的最大数据字节数。
-
建立连接时声明,缺省值为536字节。
-
-
窗口比例因子 (window scale):
-
用于扩展接收窗口大小,以支持高带宽延迟积的网络。
-
协商:在连接建立时双方协商一个比例因子。
-
计算:实际接收窗口大小 =
window size * 2^window scale。
-
-
选择确认 (SACK, Selective Acknowledgment):
-
改进机制:允许接收端精确指出哪些数据块已收到,哪些丢失。
-
优势:相比传统的累积确认,能更高效地进行重传,提升性能。
-
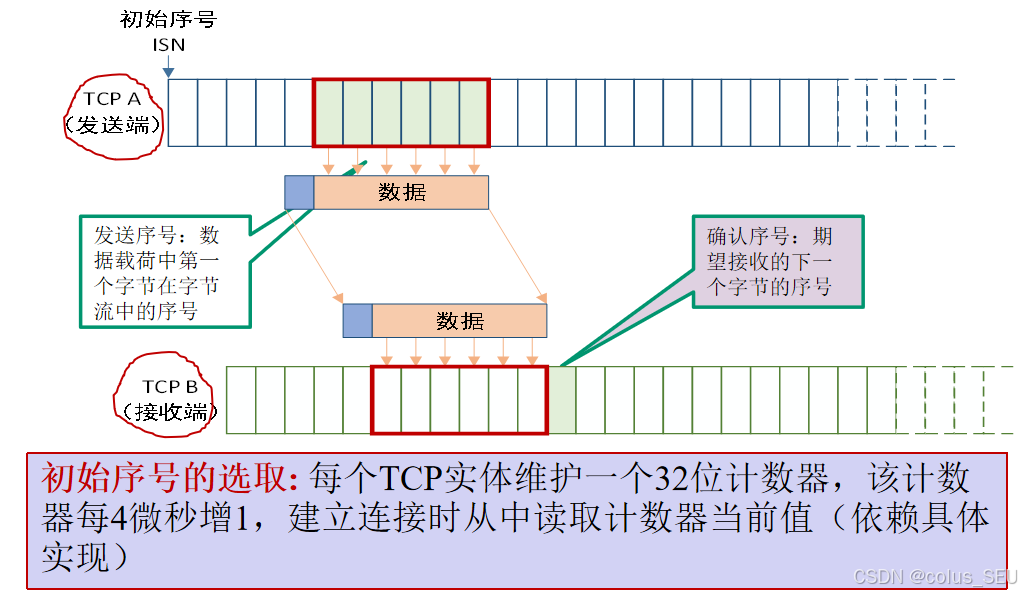
4、TCP序列号与确认号机制总结
-
发送序号 (Sequence Number, Seq#):
-
指当前TCP报文段中数据载荷部分第一个字节在字节流中的序号。
-
用于标识数据的顺序,确保接收方能按序重组数据。
-
-
确认序号 (Acknowledgement Number, ACK#):
-
指接收方期望收到的下一个字节的序号。
-
它不是对当前收到报文段的确认,而是对"下一个期望收到的字节"的声明。
-
该字段仅在ACK标志位为1时有效。
-
-
初始序号 (ISN) 的选取
-
每个TCP实体维护一个32位计数器,该计数器通常每4微秒递增1。
-
在建立连接时,双方从该计数器中读取当前值作为各自的初始序号(ISN),以保证序号的随机性和唯一性,防止旧连接的报文干扰新连接。
-
-
累积确认 (Cumulative ACK)
-
TCP默认采用累积确认机制。
-
接收方发送的ACK号表示其已成功接收到该序号之前的所有字节。
-
关键点: 如果接收方只收到了第1个和第3个报文段,它会ACK第1个报文段之后的下一个字节序号,即第2个报文段的起始序号。它不会因为收到了第3个报文段而ACK一个更高的序号,除非第2个报文段也已收到。
-
示例分析:
主机甲向主机乙发送了3个连续的TCP段,分别包含300、400和500字节的有效载荷,第3个段的序号为900。若主机乙仅正确收到第1个和第3个段,则主机乙发送给主机甲的确认序号是?答案: 500
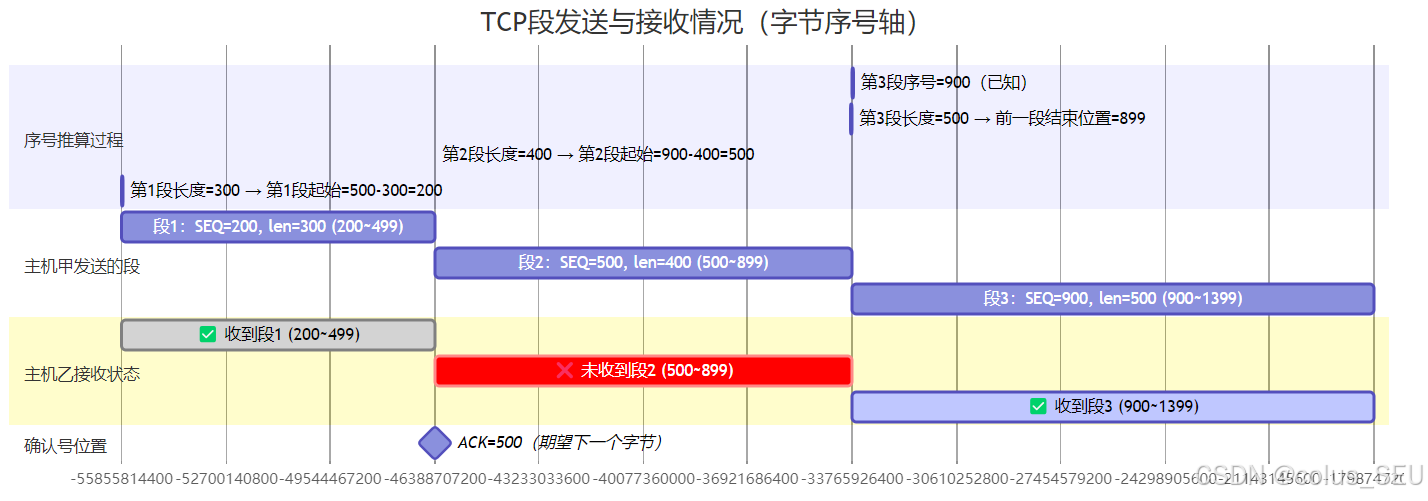
-
在Telnet交互场景中:
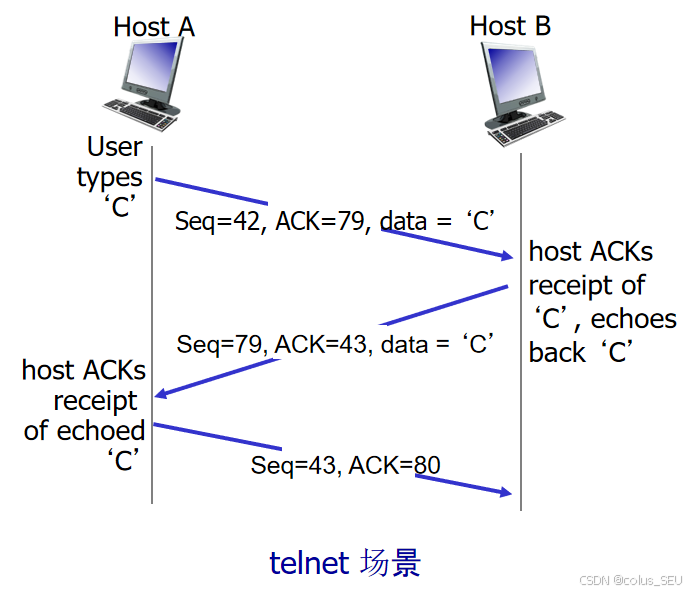
-
Host A 发送
Seq=42, ACK=79, data='C'给 Host B。 -
Host B 收到后,回复
Seq=79, ACK=43, data='C',表示它已收到序号42开始的数据,并期望收到序号43开始的下一个字节。 -
Host A 再次收到回显后,发送
Seq=43, ACK=80,继续推进序列。 -
这清晰地展示了序列号和确认号如何在双向通信中协同工作,实现可靠的数据传输。
-
5.2. 可靠数据传输
TCP协议在不可靠的IP服务基础上,通过一系列精巧且协同工作的机制,实现了面向字节流的、端到端的可靠数据传输。其核心在于重传机制 、确认机制 和超时控制的精密配合。
1、TCP可靠传输的核心机制
TCP旨在为上层应用提供一个可靠的、有序的、无差错的数据流服务,即使底层的IP网络是不可靠的(可能丢包、乱序、重复)。
TCP的核心机制包括:
-
流水线式发送 (Pipelined Segments): 发送方可以连续发送多个报文段,无需等待每个报文段的确认,从而提高了信道利用率。
-
累积确认 (Cumulative ACKs): 接收方只需发送一个ACK,确认其已按序收到的最高序号的字节。这个ACK隐含地确认了所有在此之前的数据。这是TCP高效性的基石。
-
单个重传定时器 (Single Retransmission Timer): 发送方只为最早发送但尚未被确认的报文段维护一个定时器。这种设计简化了状态管理,避免了为每个报文段都维护一个定时器的开销。
-
重传机制:当发生数据报丢失时,需要发送方进行重传,重传事件由以下两种情况触发:
-
超时事件 (Timeout Events): 当重传定时器到期时,表明该报文段及其后续未确认的报文段可能已经丢失。
-
重复确认 (Duplicate ACKs): 当接收方收到失序的报文段时,会重复发送对期望序号的ACK。当发送方连续收到3个或以上的重复ACK时,它会推断中间的某个报文段已经丢失,并立即触发快速重传。
-
2、发送方与接收方的详细协作流程
TCP的可靠性依赖于发送方和接收方之间精确的协作。
接收方 (Receiver) :
-
确认方式:
-
采用累积确认机制。只有当接收到正确且按序的报文段时,才更新确认序号。
-
对于失序到达的报文段,接收方会缓存它们,并重复发送前一次的确认序号。这与回退N步协议(GBN)中的"重复确认"行为类似。
-
关键点: 接收方的行为决定了ACK的生成模式,进而影响发送方的重传决策。
-
-
失序报文段处理:
-
接收方会缓存失序的报文段,等待缺失的报文段到达后,再将所有按序的数据交付给应用层。
-
这种行为与选择重传协议(SR)非常相似,因为它允许接收方接收并存储任何顺序到达的数据包,而不是像GBN那样丢弃所有失序包。
-
发送方 (Sender) :
-
发送策略:
- 采用流水线式发送。只要发送窗口允许,发送方就可以持续发送数据,无需等待每个报文段的确认。
-
定时器使用:
-
仅对最早未被确认的报文段启动一个重传定时器。这与GBN协议一致,因为GBN也是基于窗口的,且只对第一个未确认的包计时。
-
关键点: 定时器的启动和停止是动态的。当发送方发送第一个报文段时启动定时器;当收到新的ACK推进了窗口且仍有未确认数据时,重启定时器;当所有数据都被确认后,停止定时器。
-
-
重发策略:
-
仅在发生超时时,重发最早未被确认的报文段。这是因为接收方会缓存失序报文段,因此重发最早的报文段是最安全的选择。
-
关键点: 这种"只重发最早未确认包"的策略,结合接收方的缓存能力,使得TCP的行为在重传层面更接近于SR协议,而非GBN。
-
3、发送方事件处理的完整逻辑
TCP发送方是一个事件驱动的状态机,主要处理三种事件:收到应用数据、超时、收到ACK。
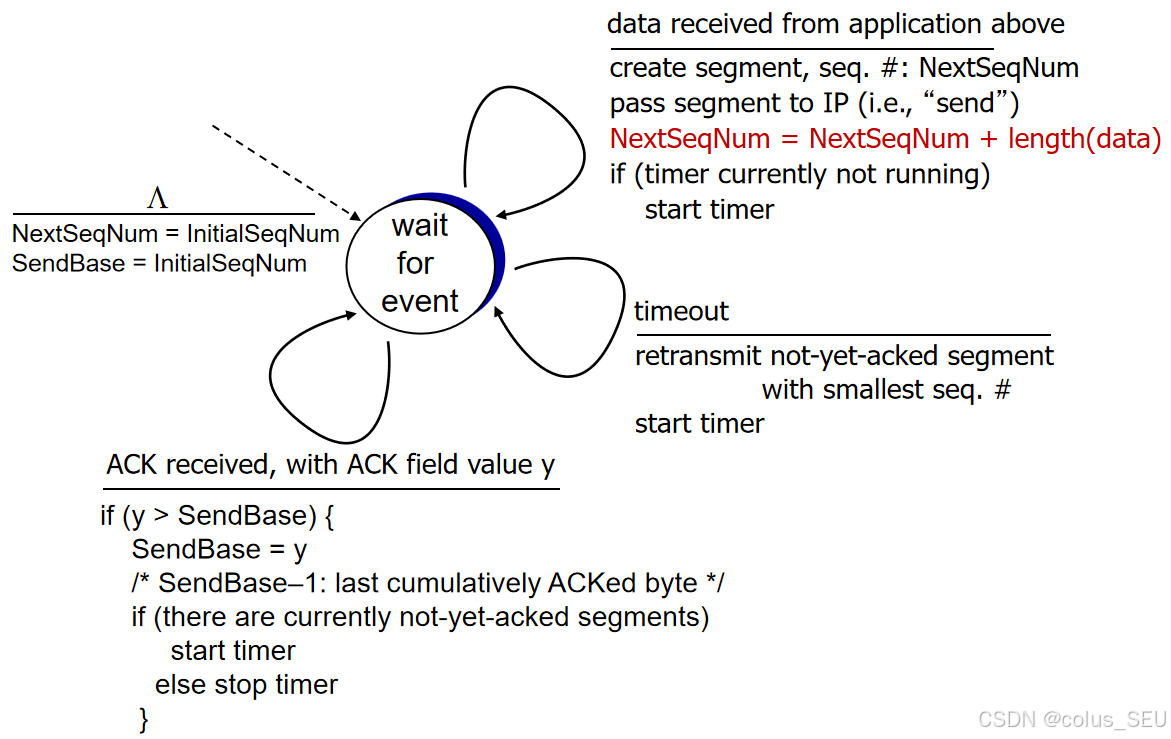
1. 收到应用数据 (Data Received from Application)
-
创建一个新的TCP报文段,为其分配序列号
NextSeqNum。 -
将报文段传递给IP层进行发送。
-
更新
NextSeqNum = NextSeqNum + length(data)。 -
定时器管理: 如果当前没有运行的重传定时器(即没有已发送但未确认的报文段),则启动定时器。
2. 超时事件 (Timeout Event)
-
重传包含最小序号的、尚未被确认的报文段。这个报文段就是当前窗口中第一个未被确认的报文段。
-
定时器管理: 重启重传定时器,为重传的报文段重新计时。
3. 收到ACK (ACK Received)
-
判断ACK是否有效 : 如果收到的确认序号
y大于当前的基序号SendBase(即y > SendBase),说明这是一个有效的、推进窗口的ACK。-
推进发送窗口 : 将
SendBase更新为y。 -
定时器管理: 如果发送窗口中仍有未确认的报文段,则启动定时器;否则,停止定时器。
-
-
判断ACK是否为重复ACK : 如果
y <= SendBase,说明这是一个重复ACK。-
计数 : 增加对该序号
y的重复ACK计数。 -
快速重传 : 如果重复ACK计数达到3,立即重传序号为
y的报文段(即丢失的那个报文段)。
-
4、ACK生成策略与重传场景
ACK生成策略 (TCP ACK Generation)
TCP接收方根据不同的接收事件,采取不同的ACK生成策略,以平衡效率和可靠性。
| 接收方事件 | TCP接收方动作 |
|---|---|
| 具有所期望序号的按序报文段到达,且所有期望序号之前的数据都已确认 | 延迟应答 (Delayed ACK): 等待最多500ms,看是否有下一个报文段到达。如果期间没有新报文段到达,则发送ACK。此机制为应用进程争取了从缓冲区取走数据的时间,从而增大了滑动窗口,提高了效率。 |
| 具有所期望序号的按序报文段到达,同时有另一个按序报文段在等待ACK传输 | 立即发送单个累积ACK: 立即发送一个ACK,确认当前和上一个按序报文段。这确保了数据能及时得到确认,避免因延迟而引发不必要的重传。 |
| 比期望序号大的失序报文段到达,检测出时间间隔 | 立即发送冗余ACK: 立即发送一个ACK,指明下一个期望报文段的序号。这相当于一个否定应答(NAK),通知发送方有数据包丢失。 |
| 能部分或完全填充接收数据间隔的报文到达 | 立即发送ACK: 立即发送ACK,更新窗口信息,以便发送方能尽快发送后续数据。 |
延迟应答与捎带应答 (Delayed ACK & Piggybacking)
-
延迟应答 (Delayed ACK):
-
目的: 为应用进程争取时间从缓冲区取走数据,从而增大滑动窗口,提高传输效率。
-
机制: 接收方收到数据后不立即回复ACK,而是等待一段时间(最长500ms),如果期间有新数据要发送,则将ACK"捎带"在数据包中一起发出;否则,在超时后单独发送ACK。
-
-
捎带应答 (Piggybacking):
-
目的: 将ACK与需要发送的数据合并,减少网络上的独立ACK包数量,提升整体效率。
-
机制: 当接收方有数据要发回给发送方时,可以将ACK信息附在数据包的头部一同发送。
-
快速重传 (Fast Retransmit)
-
动机: 超时阶段通常较长,为了更快地恢复,TCP引入了快速重传机制。
-
机制 : 当发送方收到3个重复的ACK时,意味着接收方已经收到了后续的报文段,只是中间某个报文段丢失了。此时,发送方应在超时触发前,立即重传该丢失的报文段。
-
优势: 显著缩短了重传等待时间,提高了网络吞吐量和响应速度。这是现代TCP实现中不可或缺的一部分。
重传场景详解
| 场景1 | 场景2 | 场景3 | 场景4 |
|---|---|---|---|
 |
 |
 |
 |
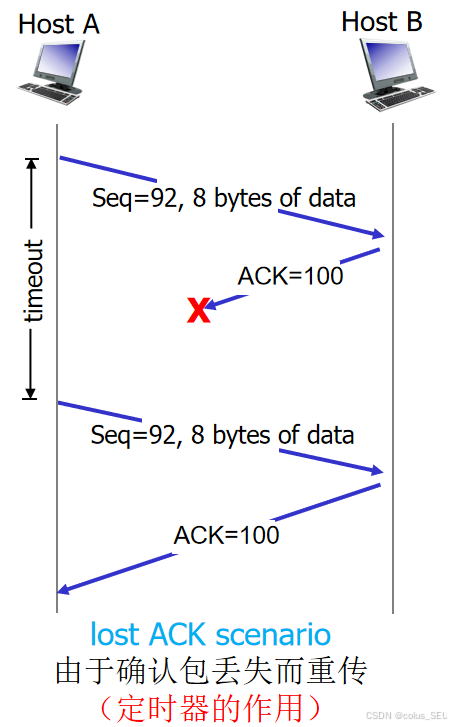
场景1: 丢失ACK导致的重传 (Lost ACK Scenario)
-
过程 : Host A 发送
Seq=92的报文段,Host B 正常接收并发送ACK=100。 -
问题: 该ACK在传输中丢失。
-
结果 : Host A 的定时器到期,误以为数据包丢失,于是重传
Seq=92的报文段。 -
关键点 : 这体现了定时器的作用------即使数据已成功送达,只要确认未返回,就会触发重传。这是一种保守但必要的机制。
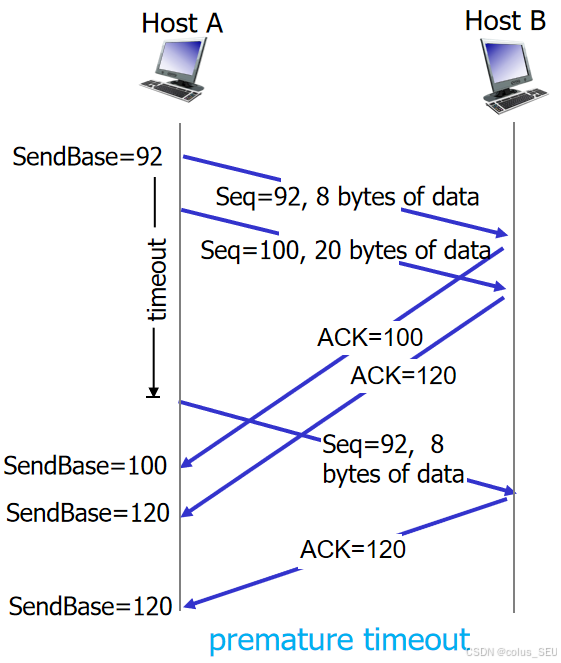
场景2: 提前超时 (Premature Timeout)
-
过程 : Host A 连续发送
Seq=92和Seq=100两个报文段。但是在超时之前都未收到ACK=100和ACK=120 -
结果 : HostA会在超时后直接重传
Seq=92,然后HostA收到ACK=100和ACK=120,将SendBase=120,则HostB只需传回ACK=120
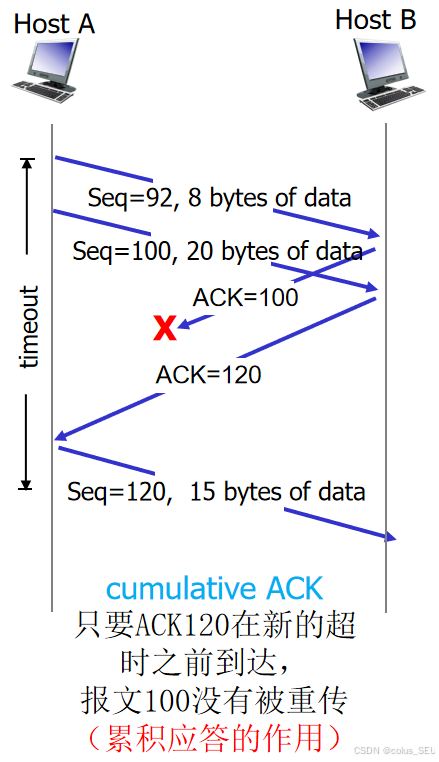
场景3:累积确认 (Cumulative ACK)
-
过程 : Host A 连续发送
Seq=92和Seq=100两个报文段。ACK=100丢失。 -
行为 : 如果
ACK=120在新的超时之前到达,那么Seq=100的报文段就不会被重传,因为ACK=120已经隐含确认了它。 -
关键点 : 累积确认能有效避免不必要的重传。
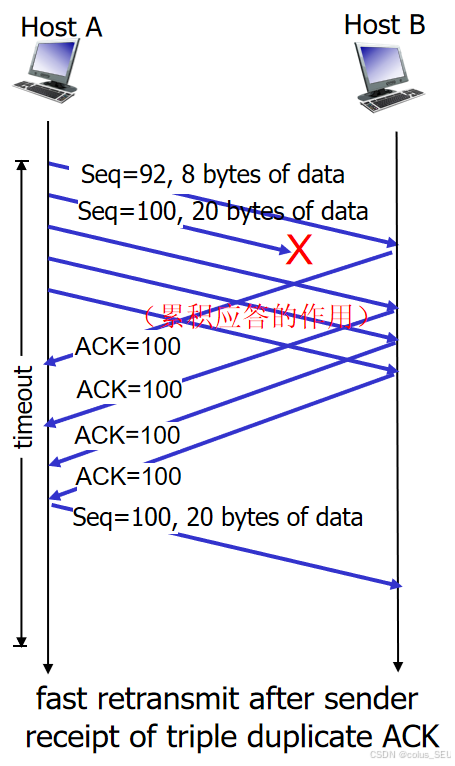
场景4: 快速重传 (Fast Retransmit)
-
过程 : Host A 发送
Seq=92和Seq=100。Seq=92到达,Seq=100丢失 。 -
行为 : Host B 缓存
Seq=100,并发送ACK=100。由于Seq=100未到,Host B 会继续发送ACK=100。当Host A连续收到3个ACK=100时,它会立即重传Seq=100。 -
关键点: 若发送者收到重复的3个ACK报文段, 意味着该报文段所指下一个段丢失,然后发送者能够在超时触发前快速重传该报文段。
超时长度的设置
超时时间(RTO, Retransmission Timeout)的设置是TCP可靠性的关键。
-
原则: RTO 应该大于 RTT(往返时间),但RTT是动态变化的。
-
问题:
-
太短: 会导致过早超时和不必要的重传,浪费网络资源。
-
太长: 对报文段的丢失反应不灵敏,降低性能,尤其是在高丢包率的网络中。
-
-
结论: TCP必须动态地估计RTT,并据此计算RTO,以适应不断变化的网络状况。
5、TCP:是GBN还是SR?------ 混合型协议的本质
TCP的机制融合了回退N步(GBN)和选择重传(SR)的特点,是一种混合型协议。
类似GBN的方面:
-
单个重传定时器: 只对最早未确认的报文段计时,简化了状态管理。
-
发送窗口滑动: 基于累积确认进行滑动,这与GBN协议一致。
类似SR的方面:
-
接收方缓存失序报文段: 接收方会存储任何顺序到达的数据包,而不是像GBN那样丢弃所有失序包。
-
精准重传 : 重发策略是只重发丢失的报文段,而不是像GBN那样重发所有未确认的报文段。这得益于接收方的缓存能力和重复ACK机制。
以下是TCP发送方处理ACK事件的核心伪代码:
 event: ACK received, with ACK field value of y
 if (y > SendBase) { // y是新ACK,推进窗口
     SendBase = y;
     /* SendBase-1: last cumulatively ACKed byte */
     if (there are currently not-yet-acknowledged segments) {
         start timer; // 如果还有未确认数据,重启定时器
     } else {
         stop timer; // 如果所有数据都已确认,停止定时器
     }
 } else { // y是重复ACK
     increment count of dup ACKs received for y;
     if (count of dup ACKs received for y == 3) { // 快速重传
         resend segment with sequence number y; // 只重传丢失的那个报文段
     }
 }
判断题:
TCP连接是一条物理连接。(❌)
每一条 TCP 连接只能有两个端点 (endpoint),每一条 TCP 连接只能是点对点的(一对一)。(✅)
UDP 支持一对一、一对多、多对一和多对多的交互通信。(✅)
使用GBN协议的接收端只需要保存一个报文的序号。(✅)
在GBN机制下,在接收端的传输层一次只交付给上层一个分组,并且保证是按序交付的。(✅)
GBN中的发送端窗口和SR中的发送端和接收端窗口都是用于缓存分组的。(✅)
GBN的接收端没有窗口。(✅)
GBN只有一个定时器,SR为每个报文段设置单独的计时器。(✅)
TCP中ACK是指接收端希望从发送端收到的下一个字节的序号。(✅)
5.3. 流量控制
1、核心概念
TCP流量控制(Flow Control)是一种接收端主导 的机制,其核心目标是:防止发送方发送数据过快,导致接收方的缓冲区溢出。
该机制通过动态调整发送窗口大小来实现。
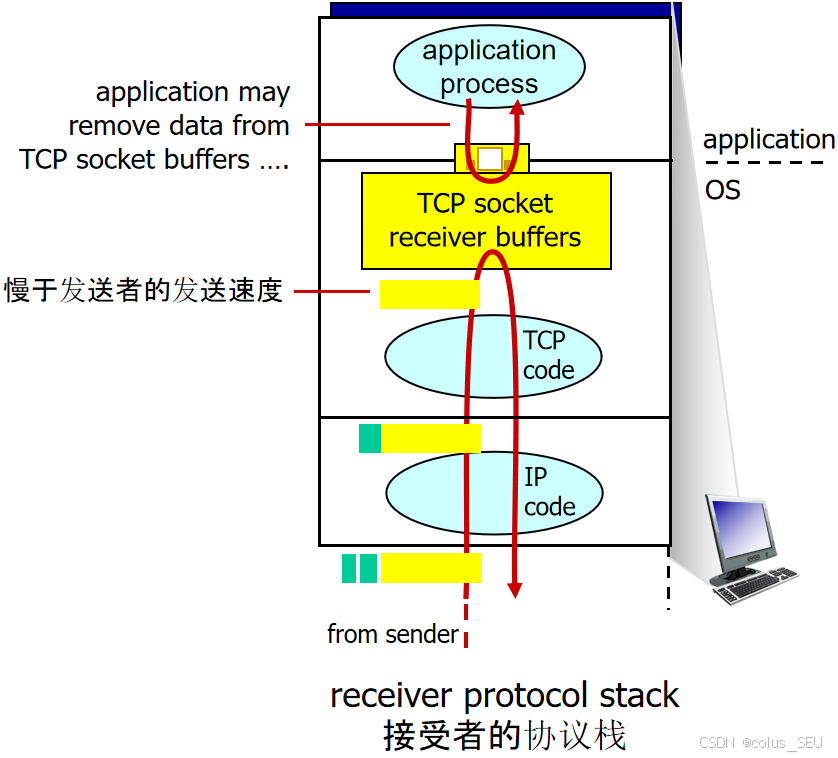
2、关键组件与原理
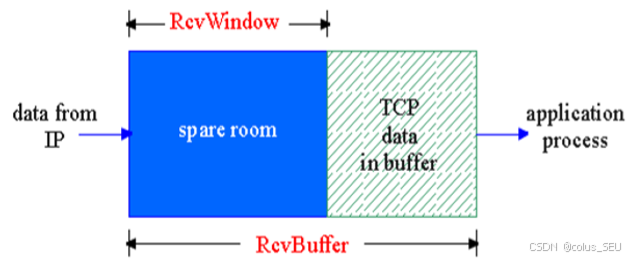
-
接收窗口 (Receive Window, RcvWindow)
-
定义 : 接收方在TCP报文段中通告的一个值,表示当前接收缓冲区中可用的空闲空间大小。
-
作用 : 发送方必须将自己未被确认的数据量(unACKed data)限制在
RcvWindow的大小之内,以确保接收方缓冲区不会溢出。
-
-
接收缓冲区 (RcvBuffer)
-
定义: 接收主机为TCP连接分配的固定大小的内存区域。
-
构成:
-
buffered data: 已接收但尚未被应用进程读取的数据。 -
free buffer space: 可用于接收新数据的空闲空间。
-
-
关系 :
RcvWindow = free buffer space = RcvBuffer - [LastByteRcvd - LastByteRead]-
LastByteRcvd: 最后一个已收到的字节序号。 -
LastByteRead: 应用进程最后一个已读取的字节序号。
-
-
-
流量控制流程
-
接收端通告 : 接收方在每次发送的ACK报文段中,都会包含其当前的
RcvWindow值。 -
发送端限制 : 发送方根据接收到的
RcvWindow值,动态调整自己的发送窗口,确保unACKed data <= RcvWindow。 -
应用层影响 : 当应用进程从TCP套接字缓冲区读取数据时,会释放缓冲区空间,从而增大
RcvWindow,允许发送方继续发送更多数据。
-
3、总结要点
-
控制方向: 由接收方控制发送方的发送速率。
-
核心手段 : 通过
RcvWindow字段进行"广告"和"限速"。 -
最终目的: 保证接收方的缓冲区不因发送方发送过快而溢出,从而保障数据传输的可靠性。
-
系统支持 : 操作系统通常能自动调整
RcvBuffer的大小,以适应不同的网络环境和应用需求。
5.4. 连接管理
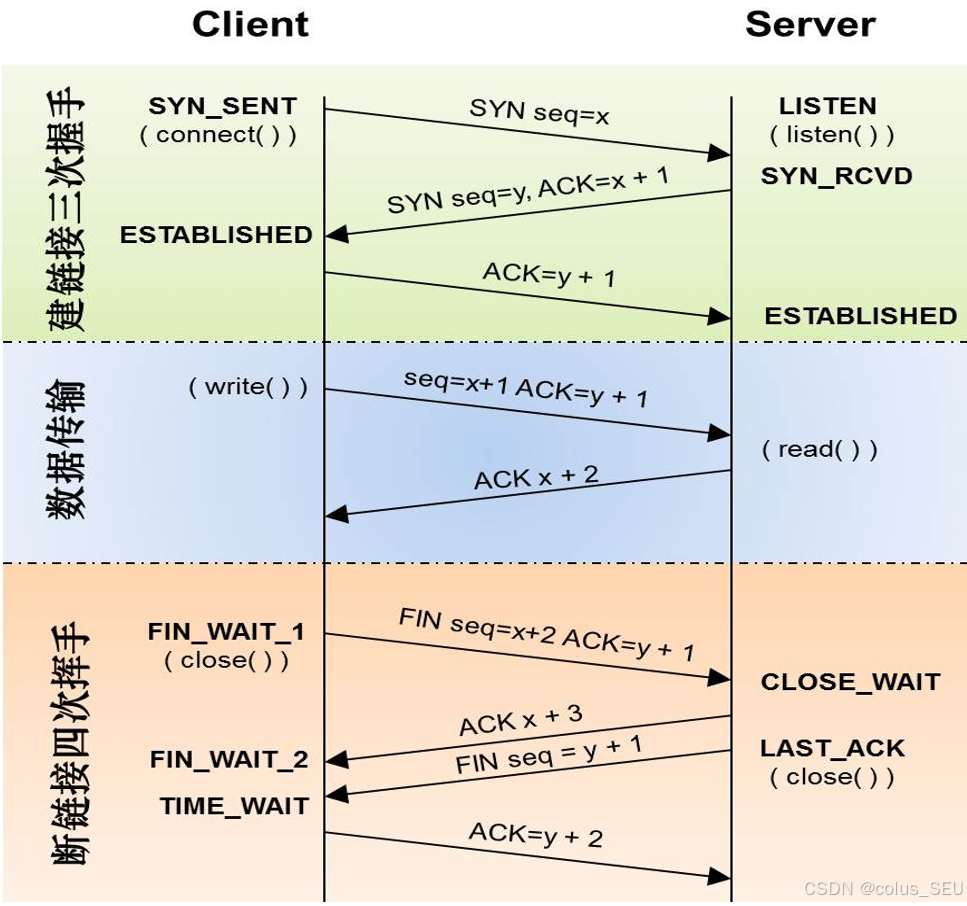
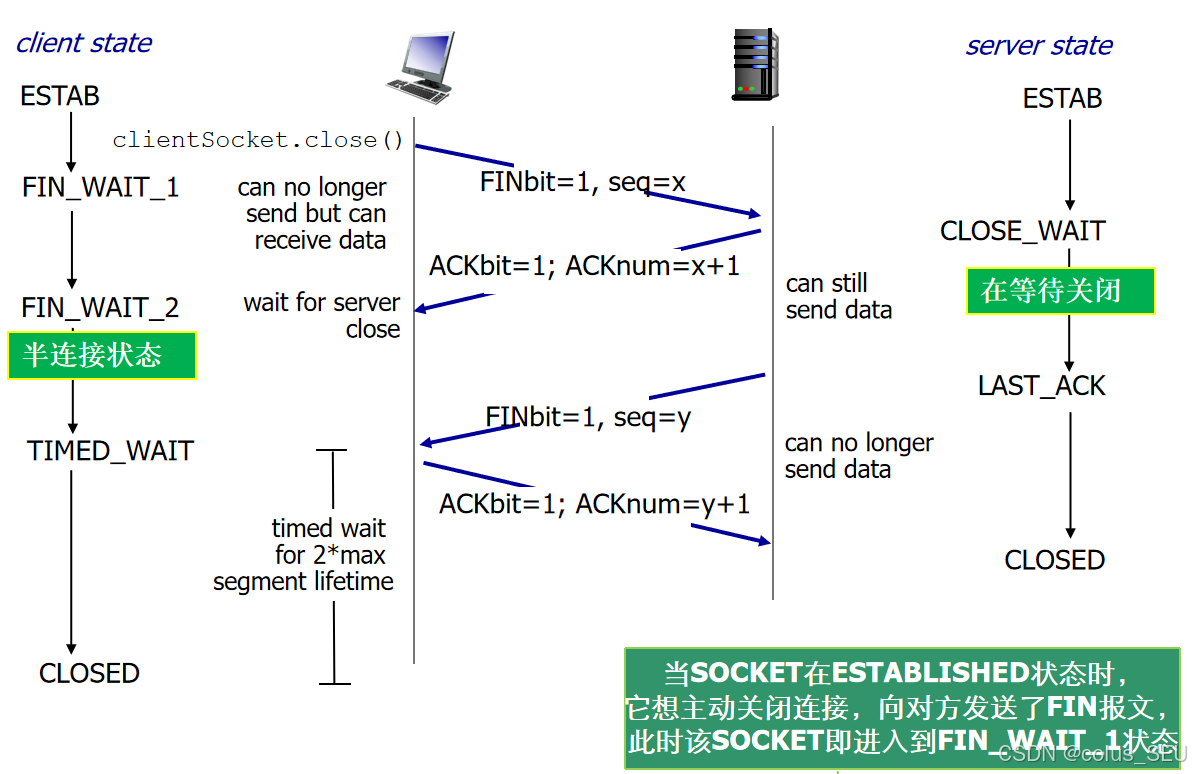
TCP连接管理是其提供可靠数据传输服务的核心。它通过一个精密的状态机,确保通信双方在建立、维护和关闭连接的全过程中,都能保持同步并记录关键状态。TCP连接的整个周期流程如下图:核心是三次握手 建立连接和四次挥手断开连接。
1、为什么需要建立TCP连接?
TCP协议的根本目标是提供可靠性数据传输 (RDT) 。要实现这一目标,必须在通信双方之间建立一个端到端的、有状态的连接。
-
记录通信状态: 连接的主要功能在于记录两个端口之间的通信状态(如序列号、窗口大小、确认号等)。没有这个状态,TCP就无法知道哪个数据包丢失了、哪个数据包重复了,也无法保证数据包的到达顺序。
-
保障可靠性的前提: 只有建立了连接,TCP才能应用重传、流量控制、拥塞控制等一系列机制来保证数据的可靠、有序传输。
2、连接建立:三次握手 (3-way Handshake)
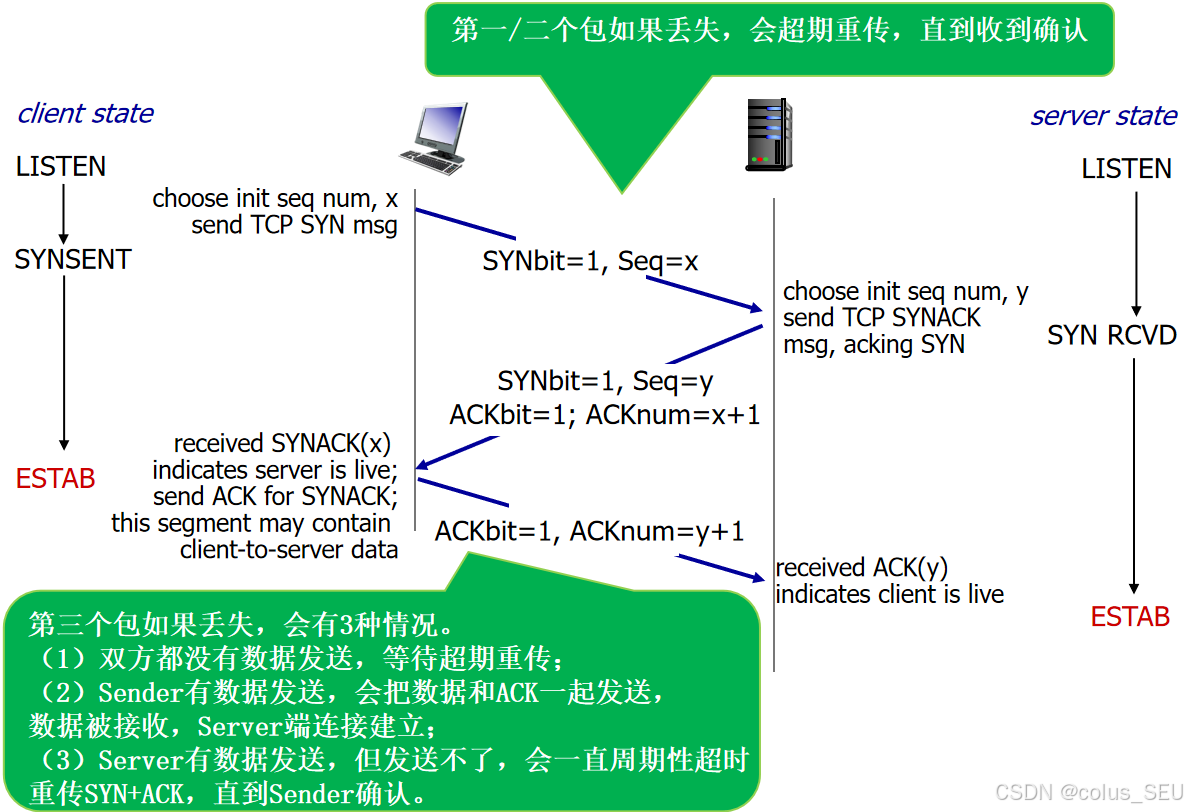
为了解决网络中固有的延迟、丢包和乱序问题,TCP采用了三次握手机制来建立一个可靠的、全双工的连接。
1. 建立连接要解决的三个核心问题
-
同步 (Synchronization): 确保双方都知晓对方的存在并已准备好通信。
-
参数协商 (Parameter Negotiation): 协商初始序列号、最大窗口值、是否使用高级选项等关键参数。
-
缓冲区分配 (Buffer Allocation): 双方分配专用缓冲区以暂存数据,需平衡效率与资源占用。
2. 三次握手的详细流程
-
第一次握手:客户端发起请求
-
客户端选择初始序列号
x,发送 SYN报文段 (SYN=1, Seq=x)。(Synchronize Sequence Numbers,同步序列编号) -
客户端进入
SYN_SENT状态。
-
-
第二次握手:服务器响应并确认
-
服务器收到SYN后,选择自己的初始序列号
y,发送 SYN+ACK报文段 (SYN=1, Seq=y, ACK=1, ACKnum=x+1)。-
ACKnum=x+1: 确认收到了客户端的SYN。 -
Seq=y: 服务器自身的初始序列号。
-
-
服务器进入
SYN_RCVD状态。
-
-
第三次握手:客户端最终确认
-
客户端收到SYN+ACK后,发送 ACK报文段 (
ACK=1, ACKnum=y+1)。 -
此时,客户端和服务器都进入
ESTABLISHED状态,连接正式建立。
-
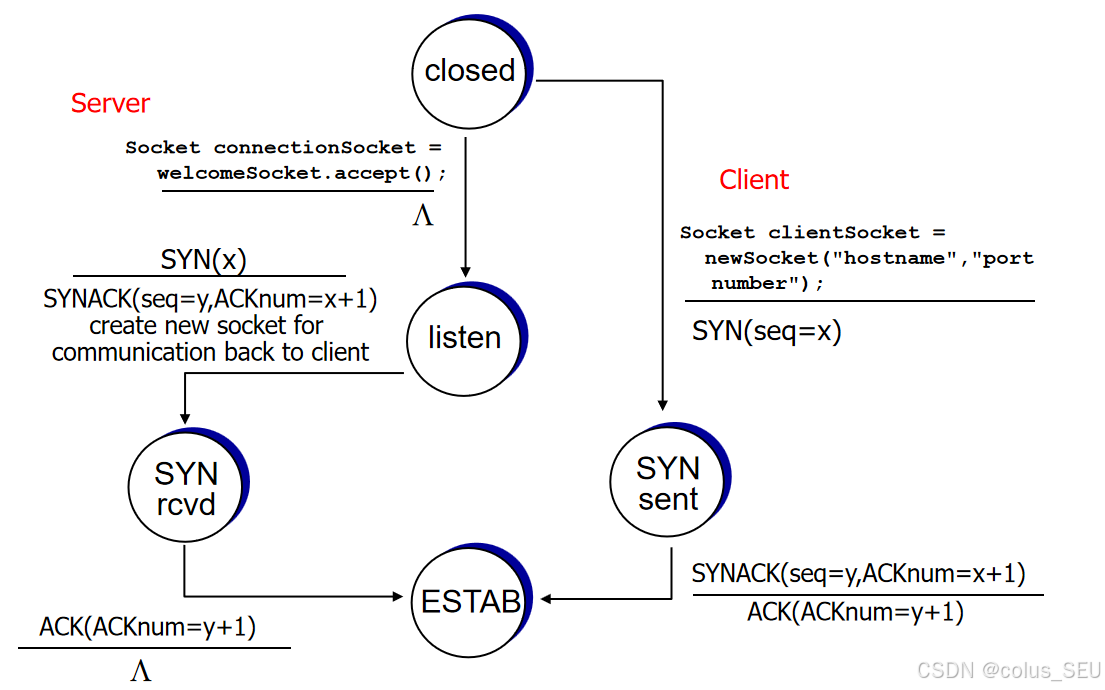
三次握手对应的状态机如下:
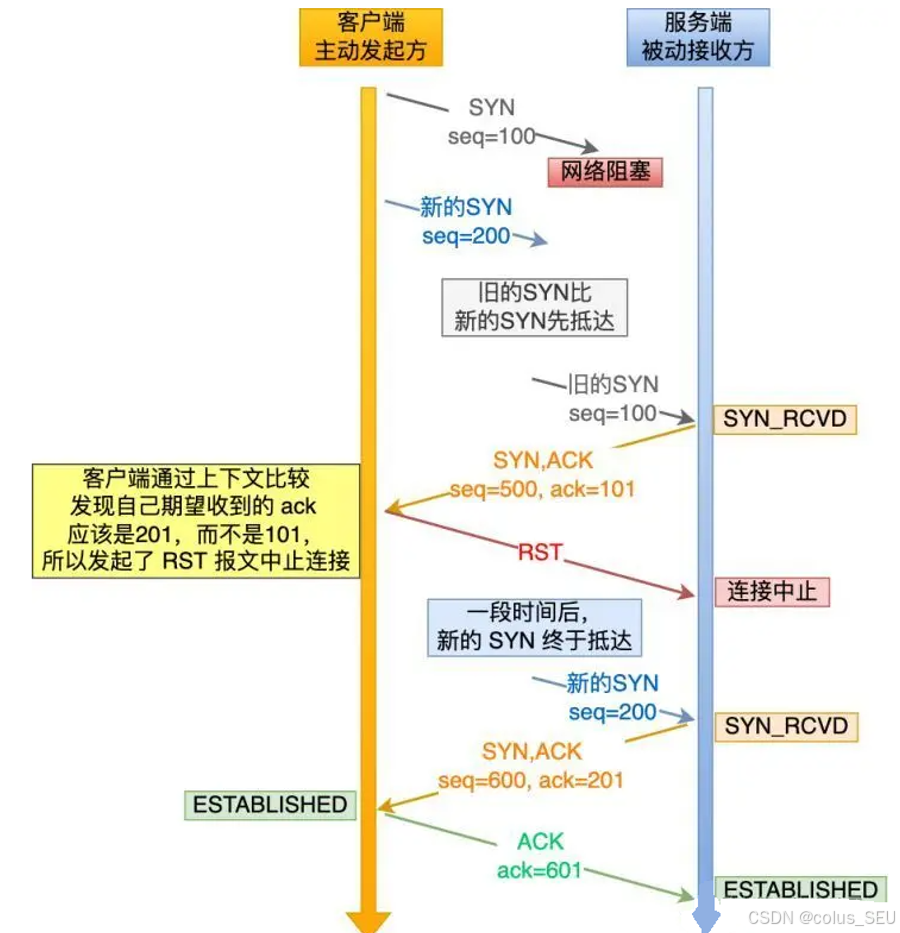
三次握手应对历史连接:
3、连接关闭:四次挥手 (4-way Handshake)
由于TCP连接是全双工 的,数据可以在两个方向上独立流动,因此关闭连接时,每个方向都必须单独关闭,这就需要四次挥手。
1. 关闭连接的基本原则
-
全双工特性: 一方可以停止发送数据,但仍能接收数据;另一方同理。
-
主动关闭 vs 被动关闭:
-
主动关闭: 首先发送FIN报文段的一方。
-
被动关闭: 接收到FIN报文段后进行响应的一方。
-
2. 四次挥手的详细步骤
-
第一次挥手:主动关闭方发送FIN(表示主机1没有数据要发送给主机2了;)
-
主机1(客户端或服务器)决定关闭连接,发送 FIN报文段 (
FIN=1, Seq=u)。(Finish) -
主机1进入
FIN_WAIT_1状态,表示它已无数据可发。
-
-
第二次挥手:被动关闭方确认FIN
-
主机2收到FIN后,发送 ACK报文段 (
ACK=1, ACKnum=u+1)。 -
主机1收到ACK后,进入
FIN_WAIT_2状态。 -
主机2进入
CLOSE_WAIT状态,表示它已收到关闭请求,但可能还有数据要发送。
-
-
第三次挥手:被动关闭方发送FIN(表示主机2也没有数据要发送给主机1了;)
-
当主机2完成所有数据发送后,发送自己的 FIN报文段 (
FIN=1, Seq=v)。 -
主机2进入
LAST_ACK状态。
-
-
第四次挥手:主动关闭方确认FIN
-
主机1收到主机2的FIN后,发送 ACK报文段 (
ACK=1, ACKnum=v+1)。 -
主机1进入
TIME_WAIT状态,等待2MSL的时间。 -
主机2收到ACK后,立即关闭连接。
-
在等待
2MSL后,主机1也关闭连接,整个连接彻底终止。
-
关键点 :
TIME_WAIT状态的存在是为了确保最后一个ACK报文段能够被对方收到。如果ACK丢失,对方会重传FIN,而处于TIME_WAIT状态的主机可以再次发送ACK,保证连接的可靠关闭。
4、优化与特殊情况
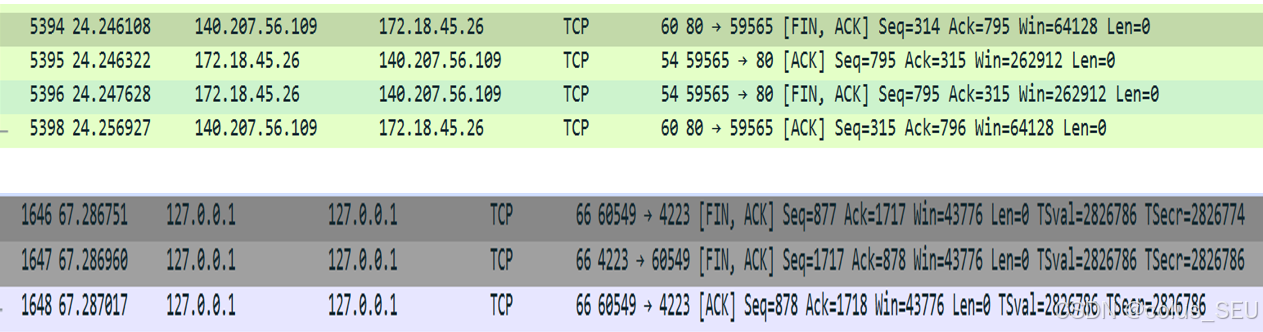
1. "三次挥手"?------ 捎带应答 (Piggybacking)
在实际应用中,四次挥手有时可以优化为"三次挥手"。
-
场景: 如果服务器在收到客户端的FIN后,也恰好没有数据要发送了,那么它可以将对客户端FIN的ACK和自己的FIN合并成一个报文段发送出去。
-
结果: 这样就节省了一个报文段,从四次挥手变成了三次挥手。
-
抓包示例 : 在Wireshark抓包中,可以看到
[FIN, ACK]报文段,这正是ACK和FIN合并的结果。
2. 为什么两次握手不行?
两次握手无法解决网络中的延迟、重传和失序问题,会导致以下严重后果:
-
半开连接: 服务器可能为不存在的客户端创建连接。
-
旧连接干扰: 延迟到达的旧连接请求会被误认为是新连接,导致数据错误交付。
结论: 三次握手是TCP协议在不可靠网络中建立可靠连接的必要且充分条件。
六、拥塞控制
6.1 拥塞的定义与成因
-
定义:
-
非正式定义:当"太多源主机以过快的速度向网络发送过多数据,导致网络无法处理"时,即发生拥塞。
-
正式定义:在某段时间内,若对网络中某资源的需求超过了该资源所能提供的可用部分,网络性能就会变坏,这种现象称为拥塞。
-
-
根本原因:
-
资源需求总和 > 可用资源。
-
具体诱因包括:路由器缓存容量不足;网络链路带宽不足;路由器或主机处理能力(速率)太慢;拥塞本身会形成恶性循环,进一步加剧问题。
-
-
上层表现:
-
数据包丢失 (lost packets):路由器缓冲区溢出导致丢包。
-
传输延迟增加 (long delays):数据包在路由器缓冲区排队等待。
-
-
解决方案误区 :单纯增加资源(如增大缓存、提高处理速度)不能解决拥塞问题,有时甚至会使情况更糟。
-
原因分析:
-
增大缓存: 若链路容量和处理速度未同步提升,只会导致数据包在队列中等待时间更长,引发大量超时重传,反而加剧拥塞。
-
提高处理速度: 可能将瓶颈转移到网络的其他环节,无法根治全局性拥塞
-
-
6.2 拥塞控制方法
1、++端到端拥塞控制++ (End-to-End Congestion Control)
-
特点: 网络本身不提供任何反馈信息。
-
推断方式: 发送端通过观察网络行为(如数据包丢失、往返时间RTT增加)来推断是否发生拥塞。
-
应用: TCP协议采用此策略,这是其核心的拥塞控制机制。
2、网络辅助的拥塞控制 (Network-Assisted Congestion Control)
-
特点: 网络中的路由器或交换机主动向端系统发送拥塞信号。
-
实现方式: 在分组的某个比特位上设置标志,明确指示拥塞状态。
-
技术示例: SNA, DECbit, TCP/IP的ECN (Explicit Congestion Notification), ATM等。
-
优势: 能更及时、准确地通知发送方调整速率。
TCP采用端到端拥塞控制机制,其核心是发送方根据自身对网络状况的感知,动态调整发送速率,以避免网络过载。
要实现这一目标,需要解决三个关键问题:
-
发送方如何感知拥塞:
-
发送方通过丢包事件来推断网络拥塞。
-
丢包事件的判定标准:
-
定时器超时 (Timeout): 最直接的拥塞信号。
-
收到3个重复的ACK (3 duplicate ACKs): 表明有数据包丢失,但后续包已到达,是更早发现拥塞的信号。
-
-
核心观点: 无论是超时还是收到重复ACK,对于发送端而言,都等同于"丢包",并触发拥塞处理流程。
-
-
采用什么机制来限制发送速率?
-
感知到拥塞后,采取何种策略调节速率?
6.3 端到端拥塞控制机制详解
关键参数
-
CongWin (cwnd): 拥塞窗口,是一个动态函数,用于量化和响应网络拥塞。
-
Ssthresh (Slow Start Threshold): 一个阈值,用于划分TCP的"慢启动"状态和"拥塞避免"状态。它本身也是一个动态参数。
-
MSS (Maximum Segment Size): 最大报文段大小,是TCP传输的基本单位,也是拥塞控制中增加窗口大小的最小步长。
1、速率限制机制 (How to Limit Transmission Rate?)
-
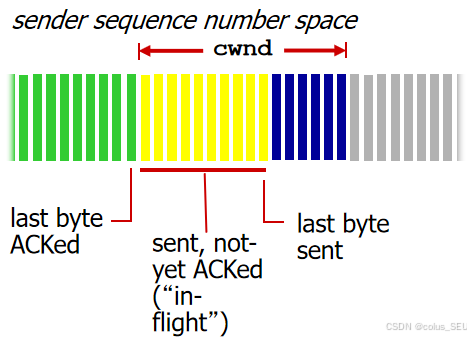
发送方使用一个名为拥塞窗口 (Congestion Window, cwnd) 的变量来限制未被确认的数据量。
-
基本约束 :
LastByteSent - LastByteAcked ≤ cwnd -
理论发送速率:
rate = \\frac{cwnd}{RTT}(Bytes/sec)
- 这表示在每个RTT(往返时间)内,发送方最多可以发送
cwnd大小的数据。
- 这表示在每个RTT(往返时间)内,发送方最多可以发送
-
动态性 :
cwnd是一个动态变化的值,其大小完全取决于发送方对网络拥塞程度的感知。
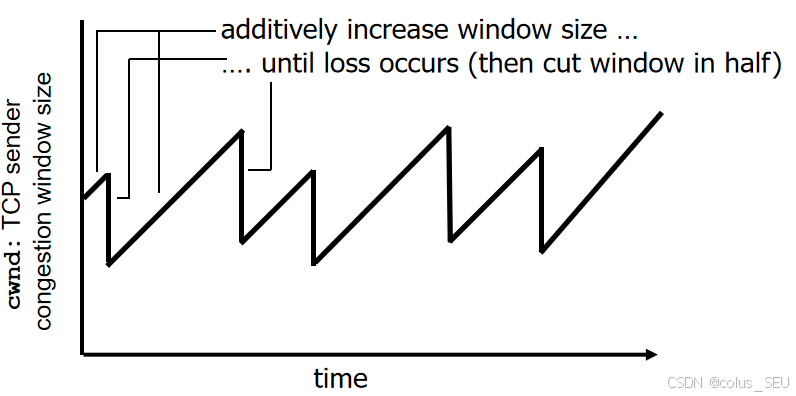
2、核心算法:AIMD (Additive Increase, Multiplicative Decrease)
这是TCP拥塞控制的核心算法,其行为模式呈"锯齿状"。
-
加性增 (Additive Increase):
-
在没有检测到丢包的情况下,每个RTT周期,
cwnd增加1 MSS(最大报文段大小)。 -
目的是缓慢、线性地探测可用带宽。
-
-
乘性减 (Multiplicative Decrease):
-
一旦检测到丢包(无论是超时还是收到3个重复ACK),
cwnd立即减半 (cwnd = cwnd / 2)。 -
目的是快速降低发送速率,缓解网络压力。
-
-
整体行为 : 该算法使
cwnd呈现"缓慢上升,急剧下降"的锯齿状波形,从而在保证高吞吐量的同时,有效避免网络拥塞。
3、TCP 慢启动(Slow Start)和拥塞避免(Congestion Avoidance)
1. 慢启动
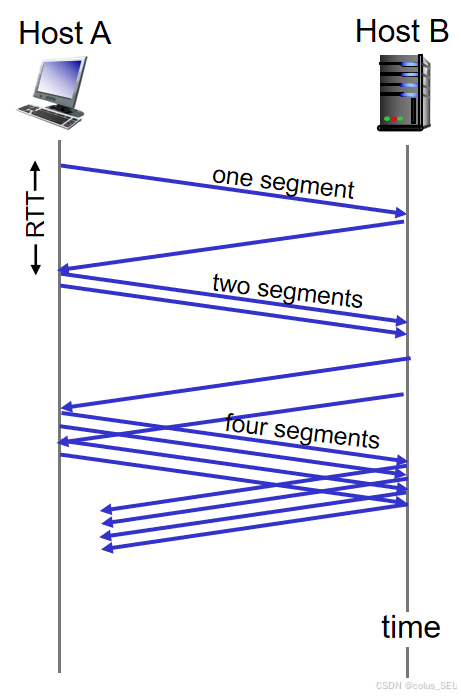
-
目标:在连接建立或经历重传后,快速探测可用带宽,同时避免突然向网络注入大量数据。
-
机制:
-
初始时,
cwnd = 1 MSS。 -
每收到一个ACK,
cwnd增加1 MSS。由于在一个RTT内会收到多个ACK,因此cwnd在每个RTT结束后会翻倍。 -
发送速率呈指数级增长(斜坡式上升)。
-
-
结束条件 : 当
cwnd达到慢启动阈值ssthresh或发生丢包事件时,慢启动阶段结束,进入拥塞避免阶段。
2. 检测与响应丢包事件(拥塞避免)
TCP根据不同的丢包信号采取不同的响应策略:
1. 超时 (Timeout)
-
含义: 最严重的拥塞信号,表明网络可能极度拥堵或路径中断。
-
响应 (TCP Tahoe算法):
-
将
cwnd重置为1 MSS。 -
重新进入慢启动阶段。
-
-
响应 (TCP Reno算法):
-
将
cwnd重置为1 MSS。 -
同时将
ssthresh设置为当前cwnd的一半。 -
进入慢启动阶段。
-
2. 收到3个重复ACK (3 Duplicate ACKs)
-
含义: 表明网络并非完全瘫痪,部分数据包仍能到达接收端,是较轻度的拥塞信号。
-
响应 (TCP Reno算法 - 快速重传/快速恢复):
-
将
ssthresh设置为当前cwnd的一半。 -
将
cwnd设置为ssthresh + 3 MSS(或直接设为ssthresh,具体实现略有不同),然后进入拥塞避免阶段。 -
优势 : 避免了从
cwnd=1重新开始,效率更高。
-
3. 从慢启动到拥塞避免状态的切换
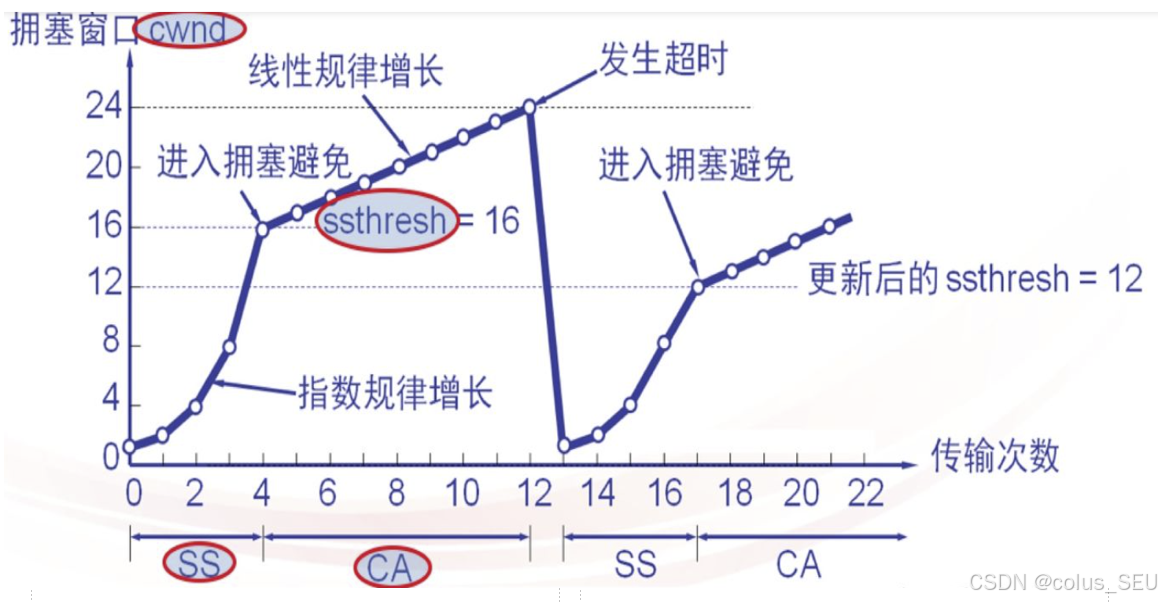
-
关键问题: 指数增长何时应切换为线性增长?
-
答案 : 当
cwnd达到ssthresh(慢启动阈值) 时。 -
实现:
-
ssthresh是一个动态变量。 -
当发生丢包时 ,
ssthresh会被设置为当前cwnd值的一半 (ssthresh = cwnd / 2)。 -
在慢启动阶段,
cwnd指数增长;一旦cwnd >= ssthresh,则进入拥塞避免阶段,cwnd开始线性增长(每个RTT增加1 MSS)。
-
4、TCP拥塞控制状态机详解
TCP拥塞控制通过一个状态机在三个核心状态间切换:慢启动 (Slow Start) 、拥塞避免 (Congestion Avoidance) 和 快速恢复 (Fast Recovery)。
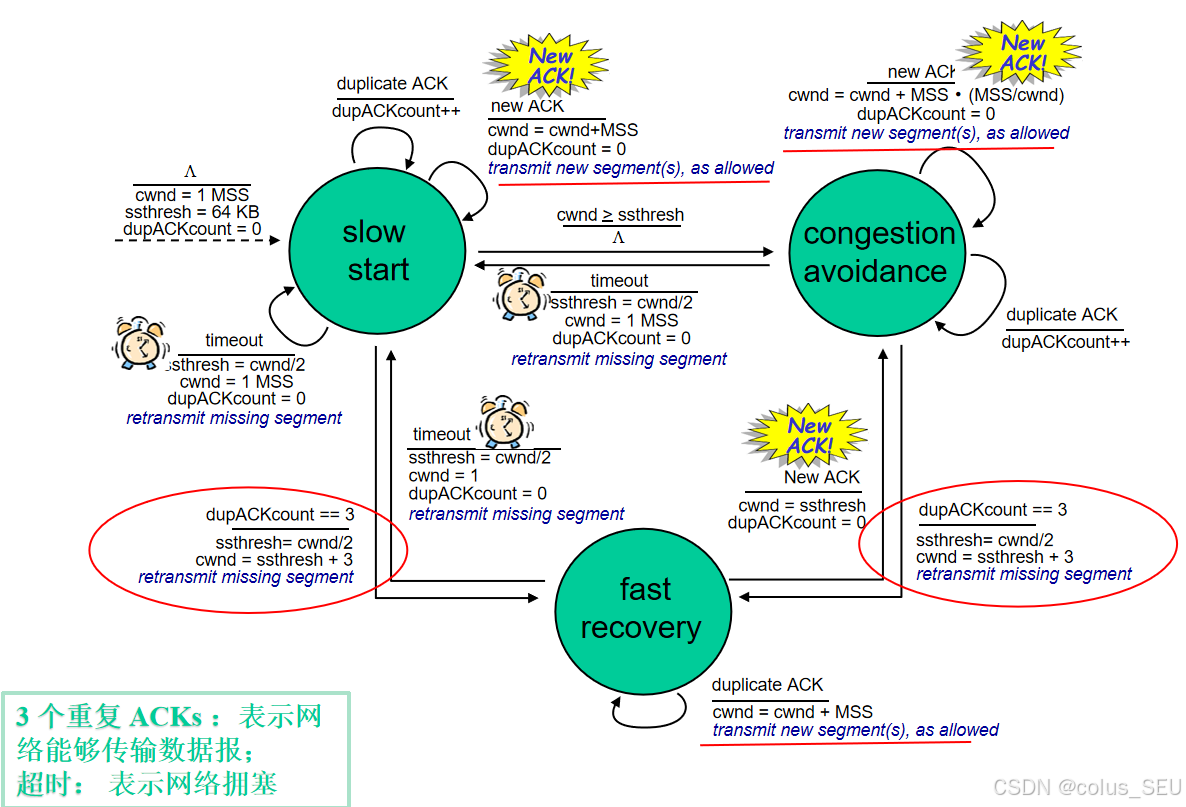
-
初始状态 : 连接建立时,
cwnd = 1 MSS,ssthresh = 64 KB,dupACKcount = 0,进入慢启动。 -
慢启动 -> 拥塞避免
-
条件:
cwnd >= ssthresh。 -
动作: 进入拥塞避免 状态,
cwnd开始线性增长。
-
-
慢启动/拥塞避免 -> 快速恢复
-
条件: 收到第3个重复ACK (
dupACKcount == 3)。 -
动作:
-
设置
ssthresh = cwnd / 2。 -
设置
cwnd = ssthresh + 3 MSS(或cwnd = ssthresh)。 -
进入快速恢复状态。
-
-
-
慢启动/拥塞避免 -> 慢启动 (超时)
-
条件: 发生定时器超时。
-
动作:
-
设置
ssthresh = cwnd / 2。 -
设置
cwnd = 1 MSS。 -
重传丢失的报文段,并重新进入慢启动状态。
-
-
-
快速恢复 -> 拥塞避免
-
条件: 收到一个新的ACK(非重复ACK)。
-
动作:
cwnd = ssthresh,进入拥塞避免状态。
-
-
快速恢复 -> 慢启动 (超时)
- 条件: 在快速恢复阶段发生超时。
- 动作: 重置
cwnd = 1 MSS,进入慢启动状态。
核心事件处理:
-
收到新ACK :
cwnd增加MSS,并发送新数据。 -
收到重复ACK :
dupACKcount递增。当计数达到3时,触发快速恢复。 -
超时 : 触发最保守的恢复机制,重置
cwnd并重传。
慢启动与快速恢复的速率对比
-
慢启动阶段:
-
在每个RTT内,由于会收到多个ACK,
cwnd会翻倍增长。 -
例如:
-
初始:
cwnd = 1 -
1 RTT后:
cwnd = 2 -
2 RTT后:
cwnd = 4 -
3 RTT后:
cwnd = 8
-
-
特点:指数级增长,旨在快速探测带宽。
-
-
快速恢复阶段:
-
重复ACK的到来表明网络仍能传输数据,因此不需要像超时那样激进地重置窗口。
-
关键区别:在快速恢复中,每个RTT只将
cwnd增加1 MSS。 -
原因:重复ACK消耗了一个RTT的时间来确认单个丢失的分段,相当于在一个RTT内只"处理"了一个分段,因此
cwnd仅增加1。 -
特点:线性增长,效率高于从头开始的慢启动。
-
6.4 拥塞控制与流量控制的区别
-
拥塞控制 (Congestion Control) : 关注整个网络的健康状况,防止网络过载。其目标是避免网络性能崩溃。
-
流量控制 (Flow Control) : 关注单个接收方的接收能力,防止接收方缓冲区溢出。其目标是保护接收端。
| 特性 | 拥塞控制 (Congestion Control) | 流量控制 (Flow Control) |
|---|---|---|
| 目标 | 防止过多的数据注入网络,避免路由器或链路过载。 | 抑制发送端发送数据的速率,使接收端能够及时处理。 |
| 范围 | 全局性过程,关注整个网络的性能和稳定性。 | 点对点通信量的控制,是端到端的问题。 |
| 控制方 | 发送方根据网络反馈(丢包、延迟)调整速率。 | 接收方通过通告 RcvWindow 来控制发送方。 |
| 核心参数 | cwnd (拥塞窗口) |
RcvWindow (接收窗口) |
| 最终限制 | 实际发送窗口 = min(cwnd, RcvWindow) |
关键公式 : TCP的发送方速率受双重限制:
LastByteSent - LastByteAcked < min(cwnd, RcvWindow)。发送速率约为min(cwnd, RcvWindow) / RTT。