前言
(1)开放域问答的生成模型已被证明具有相当竞争力的性能,可以无需借助外部知识完成任务。本工作研究了这些生成模型从检索到的可能包含证据的文本段落中能受益多少;
(2)作者观察到,当增加检索到的段落数量时,这种方法的性能会显著提高。这证明了Seq2seq模型能提供一个灵活的框架,可以有效地聚合和组合来自多个段落的证据。
一、解码中的融合(Fusion-in-Decoder)模型
1.1 检索
本工作探索了两种段落检索的方式:
(1)BM25,段落表示为单词袋,排名函数基于词频(TF)和逆文档频率(IDF),使用SpaCy库对问题和段落进行token化;
(2)DPR,段落和问题表示为密集向量表示,使用两个BERT网络分别得到嵌入向量。排名函数是查询和段落表示之间的点积,使用FAISS库的近似最近邻进行检索。
1.2 生成
生成模型选择基于Seq2seq的网络(如T5或BART),因为这些模型对无监督数据进行了预训练。模型结构如下图所示:
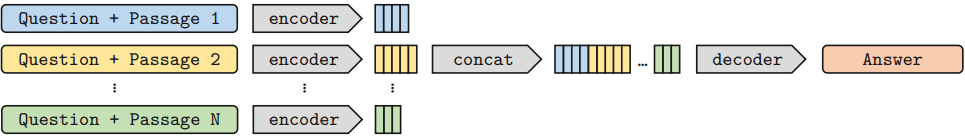
(1)模型将问题以及检索到的段落一起作为输入,并生成答案。更确切地说,每个检索到的段落及其标题都与问题concat在一起,并由编码器独立于其他段落进行处理。
(2)在问题、每个段落的标题和文本之前添加特殊的token------question: 、title: 和context:;
(3)decoder对所有问题-段落对的向量表示进行concat操作,并对该连接后的表示进行注意力计算。该模型仅在解码器中执行文本融合,因此称之为解码器中的融合。
在编码器中独立处理段落,但在解码器中联合处理。好处有:
(1)在编码器中独立处理段落允许扩展到大量上下文,因为它一次只对一个上下文进行自我关注,这意味着模型的计算时间随通道数量呈线性增长,而不是二次增长;
(2)另一方面,在解码器中联合处理段落可以更好地聚合来自多个段落的证据。
二、训练和推理
通过独立编码多个段落、在解码器中进行融合的方式,实现了对多源信息的灵活整合。
2.1 训练
(1)输入
由多个独立的文本序列组成,每个序列的结构如下:
python
question: [问题文本]
title: [段落标题,如 Wikipedia 页面标题]
context: [段落正文]
注意:每个 "问题 + 一个段落" 是一个独立输入序列,彼此之间在编码器中是分开的。
(2)输出
一个短文本序列 ,即标准答案。
(3)训练目标
最小化生成答案与真实答案之间的交叉熵损失。
2.2 推理
(1)输入
同样是将"问题 + 每个段落"分别送入编码器。
(2)输出:
同样是一个短文本序列(如 "亚历山大·贝尔")。
三、总结
本工作所提的方法与先前作品的不同之处在于生成模型 如何处理检索到的段落,即编码阶段独立,解码阶段融合。这允许扩展到大量文档,并从大量证据中受益。