开卷考试,只能带纸质资料,不允许带计算器,但是可以带前面学长准备好的速查表。
个人认为,不追求非常高分的话。把本资料的内容看一遍,例题跟着做一遍,考试打印一份带着就稳稳拿下了。
2025考试情况:题目很简单,但是计算量大,很多人没做完最后一题
考试范围
第一大题:数据仓库相关(数据多维、OLAP操作、数据仓库优化方式等等)
2025考题:①数据立方体的多层和多维度(需要结合题目背景分析 );②为什么数据仓库的OLAP不适合实时推荐算法?③概念解释2选1:一个是Bitmap和Join index,另一个不记得了
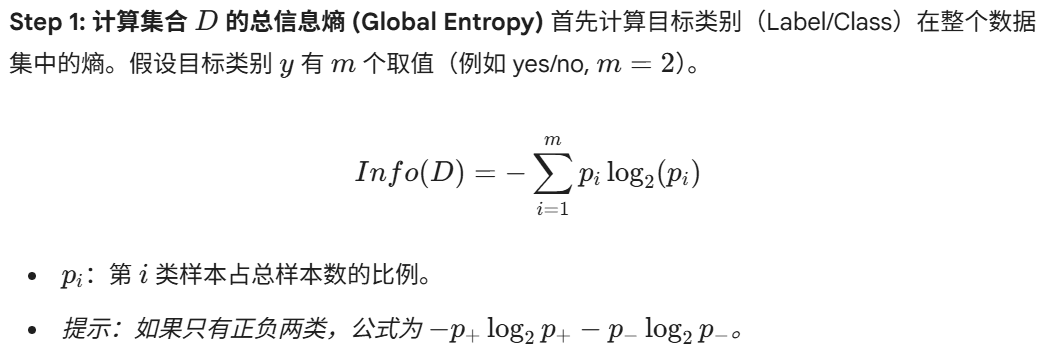
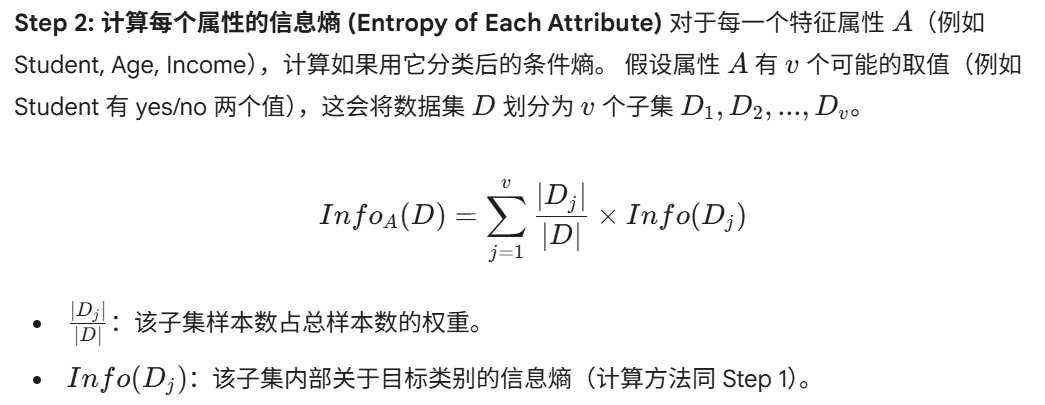
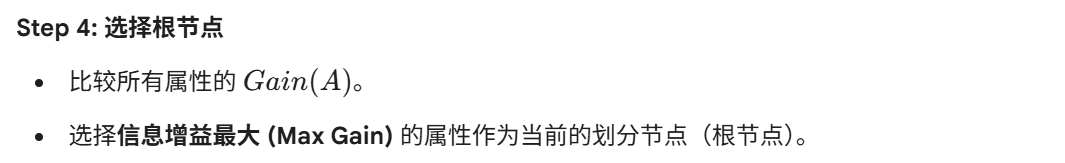
第二大题:信息熵与信息增益
2025考题:换了数据,但是新增要求:量化筛选出来的属性(特征和区分),我也不知道什么意思。
第三大题:关联(fp算法和apriori算法二选一)
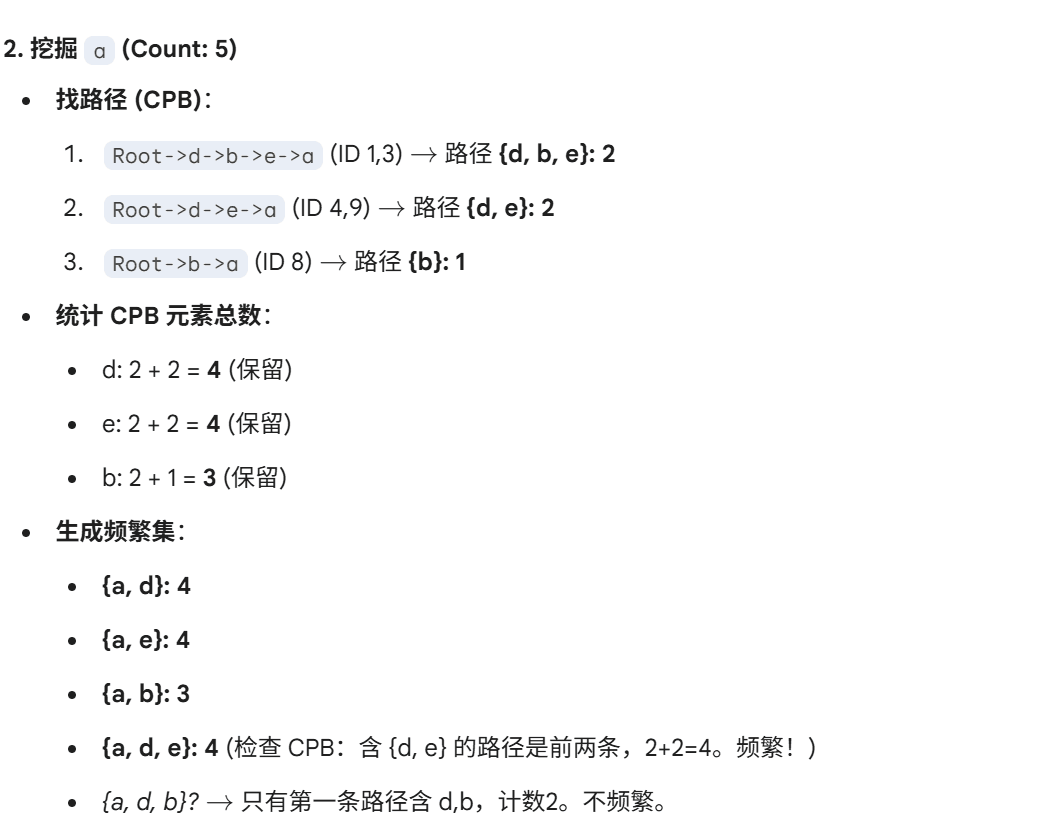
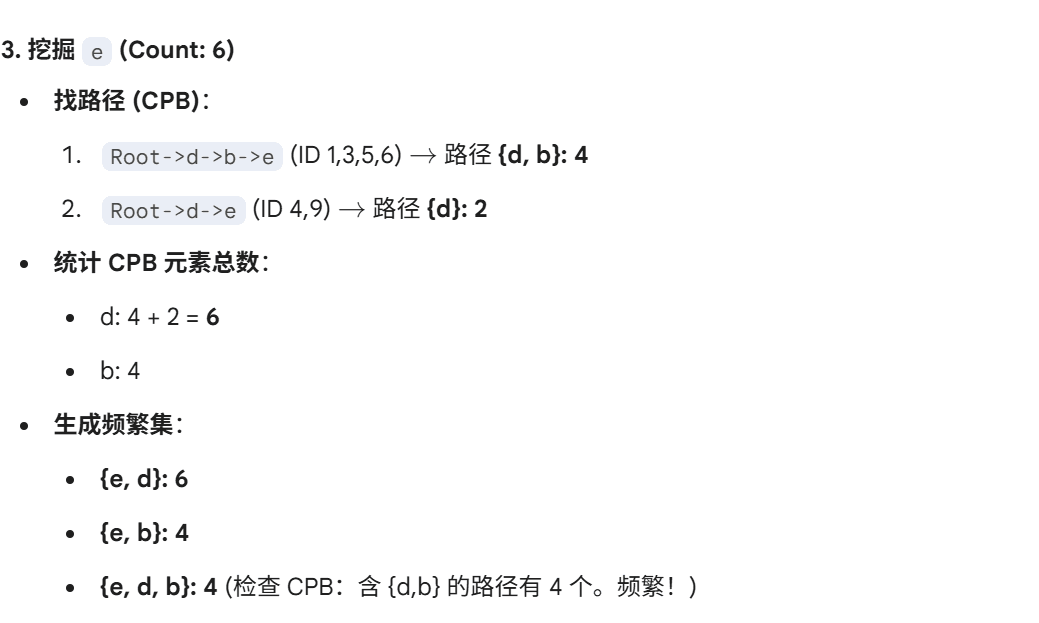
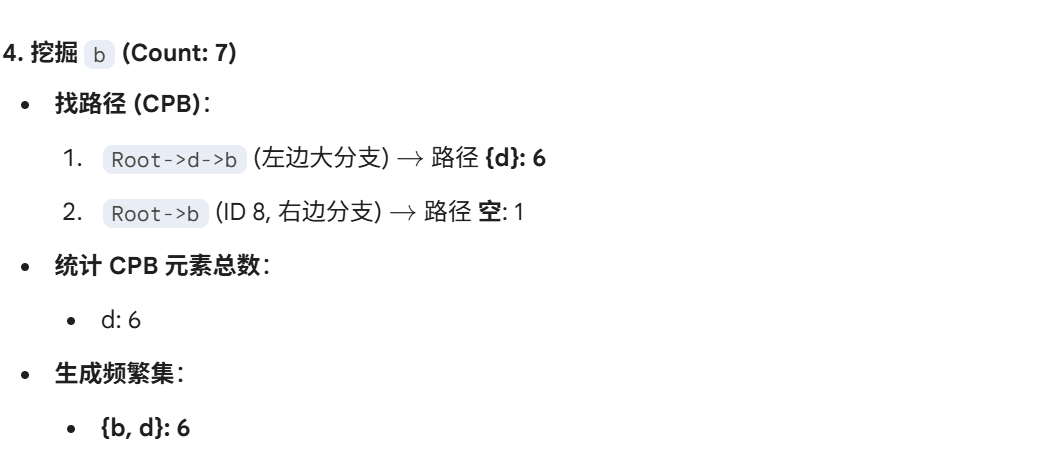
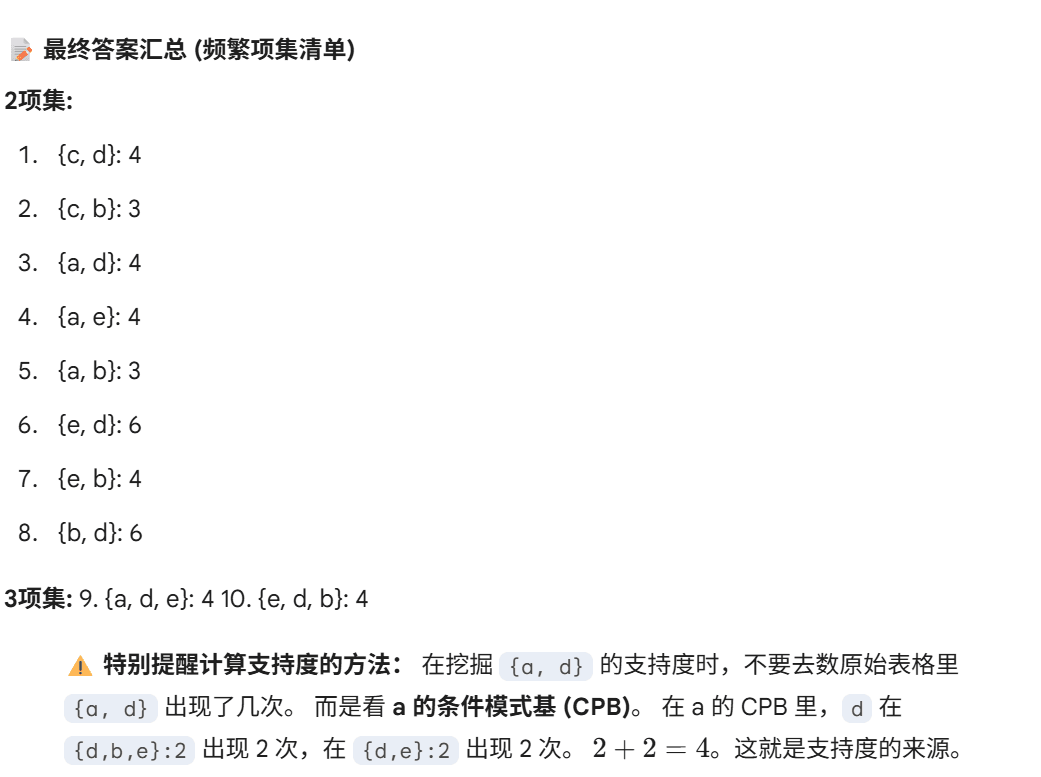
2025考题:FP增长算法,很常规。频繁项集的计算量较大,但是可以根据规律简化。
第四大题:分类(决策树和贝叶斯二选一)
2025考题:考了**3-4-5自然划分。**很抽象,理论上可以随意划分,但是这样就没有标准答案了。我自己是把数据平均分成了12份,然后把区间划分成了3-4-5。
第五大题:聚类(k平均(中心)聚类、层次聚类、密度聚类三选一)
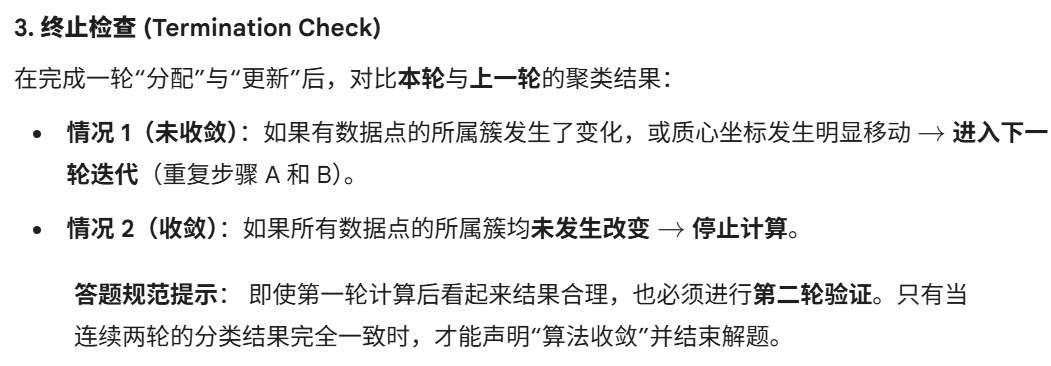
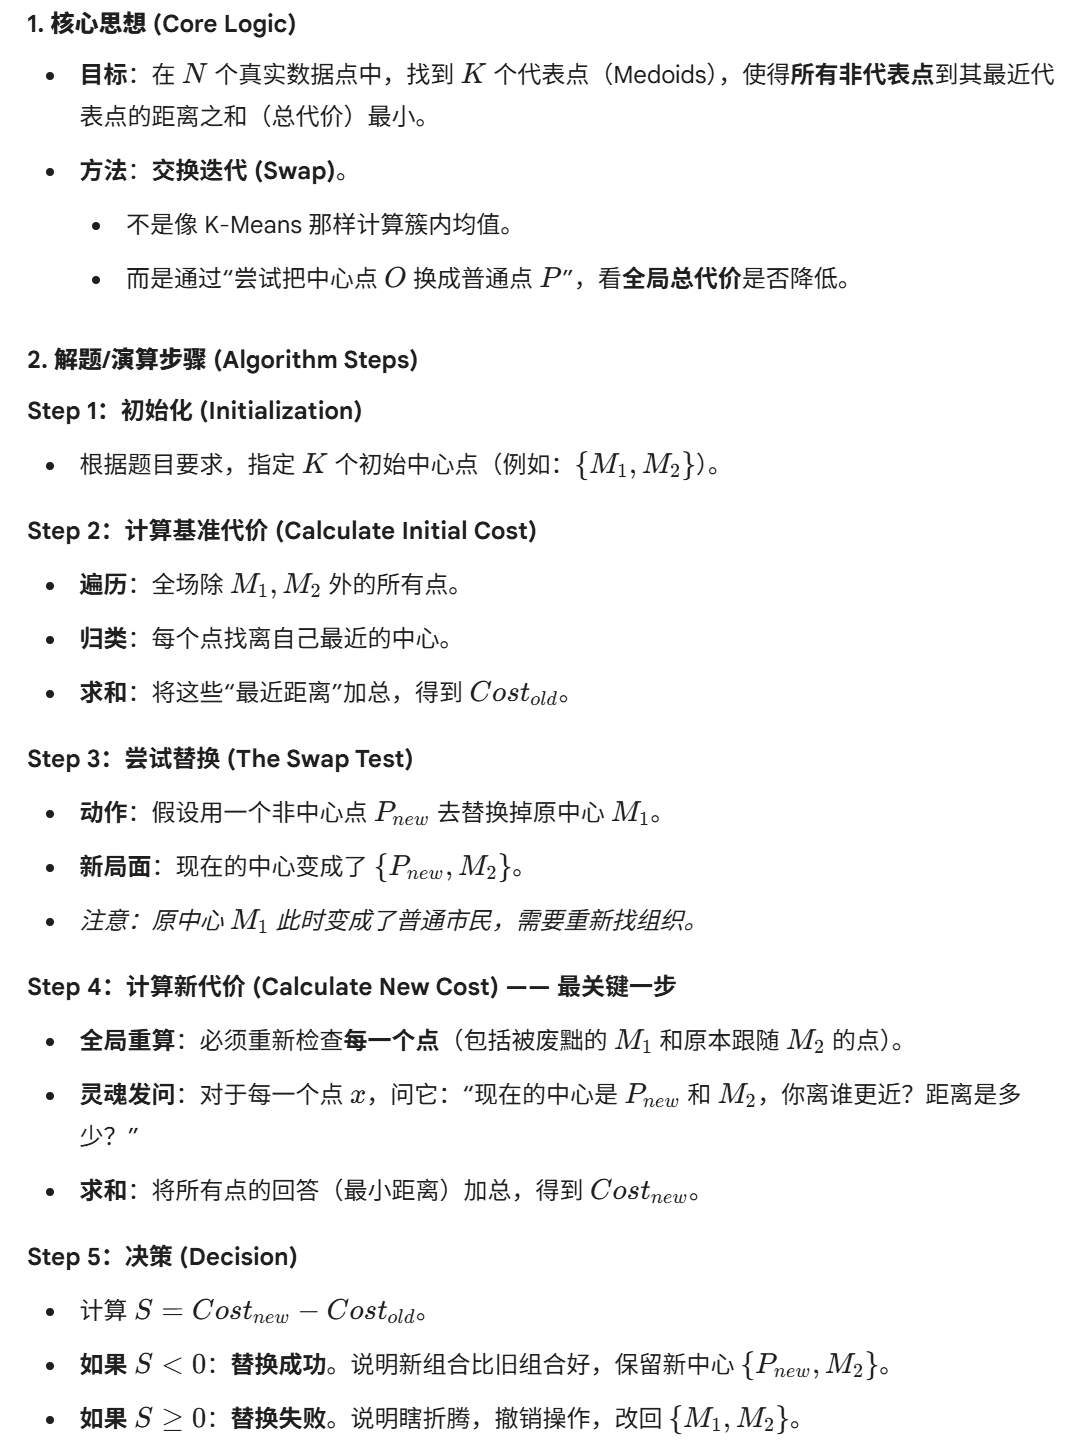
2025考题:考了中心点聚类。题目要求每次迭代在簇内进行,选出与簇内其他点的距离之和最小的作为簇的新中心点,跟教材上的定义不同。迭代一轮,第二轮就稳定了。
第一题 数据仓库
1 基础概念
建议直接带着《数据挖掘 概念与技术》进考场,考什么翻书就可以了。
2 BITMAP索引
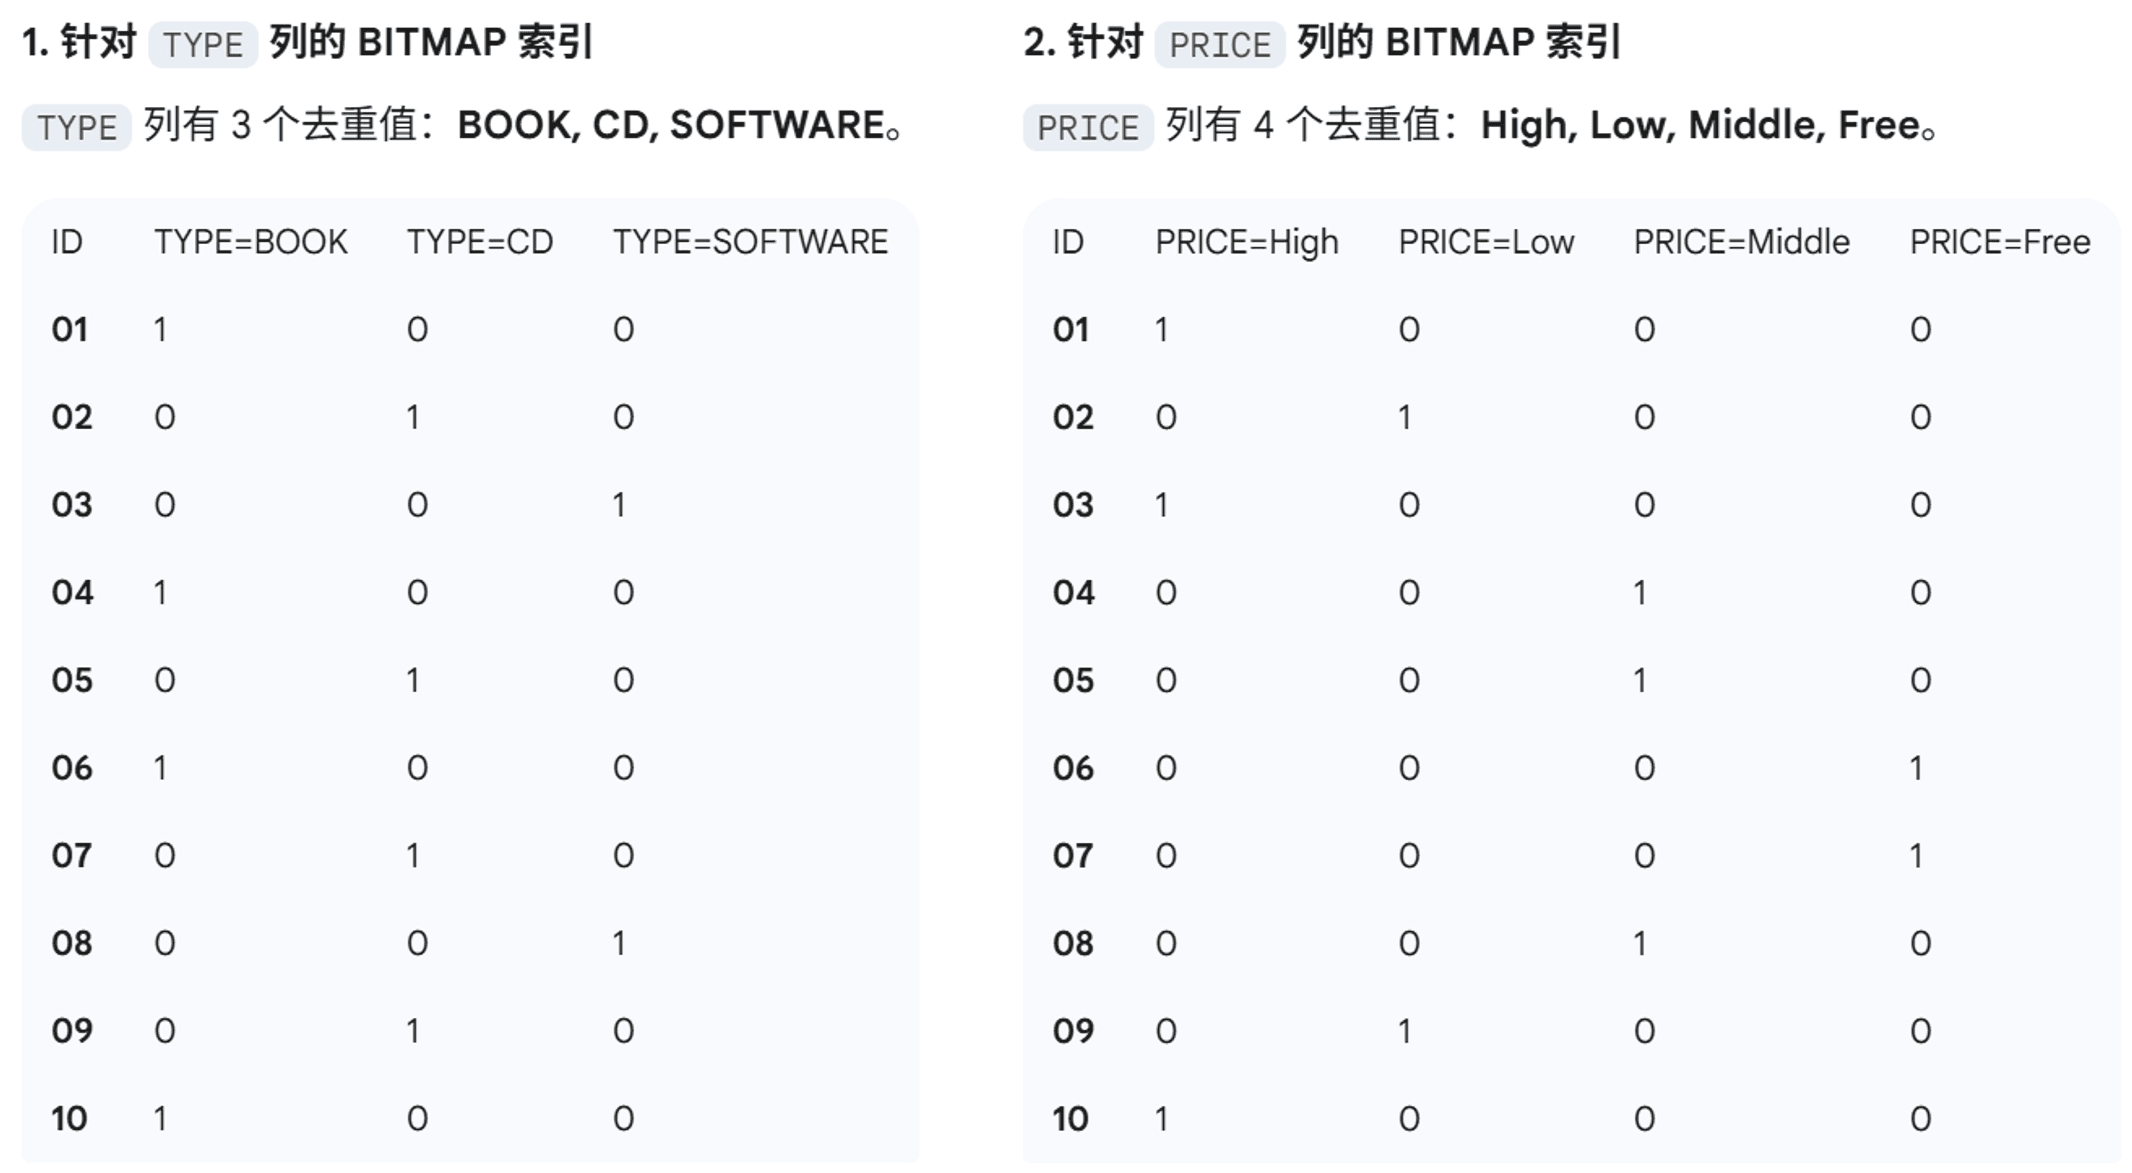
位图索引分为两种,简单位图索引和编码位图索引,考试时候会让你画简单位图索引。
与B树索引的对比
-
位图索引适合只有少量枚举值的属性,如性别、婚姻状况、行政区等等。对于性别,枚举值只有'男','女',并且男和女可能各占该表的50%的数据,这时添加B树索引还是需要取出一半的数据, 因此完全没有必要。
-
如果某个字段的取值范围很广,几乎没有重复,比如身份证号,就不适合用位图索引,适合B树索引。
简单位图索引
对于每个属性,根据属性中的不同取值生成不同的位向量,有几个不同的取值就有几个不同的位向量。例如:
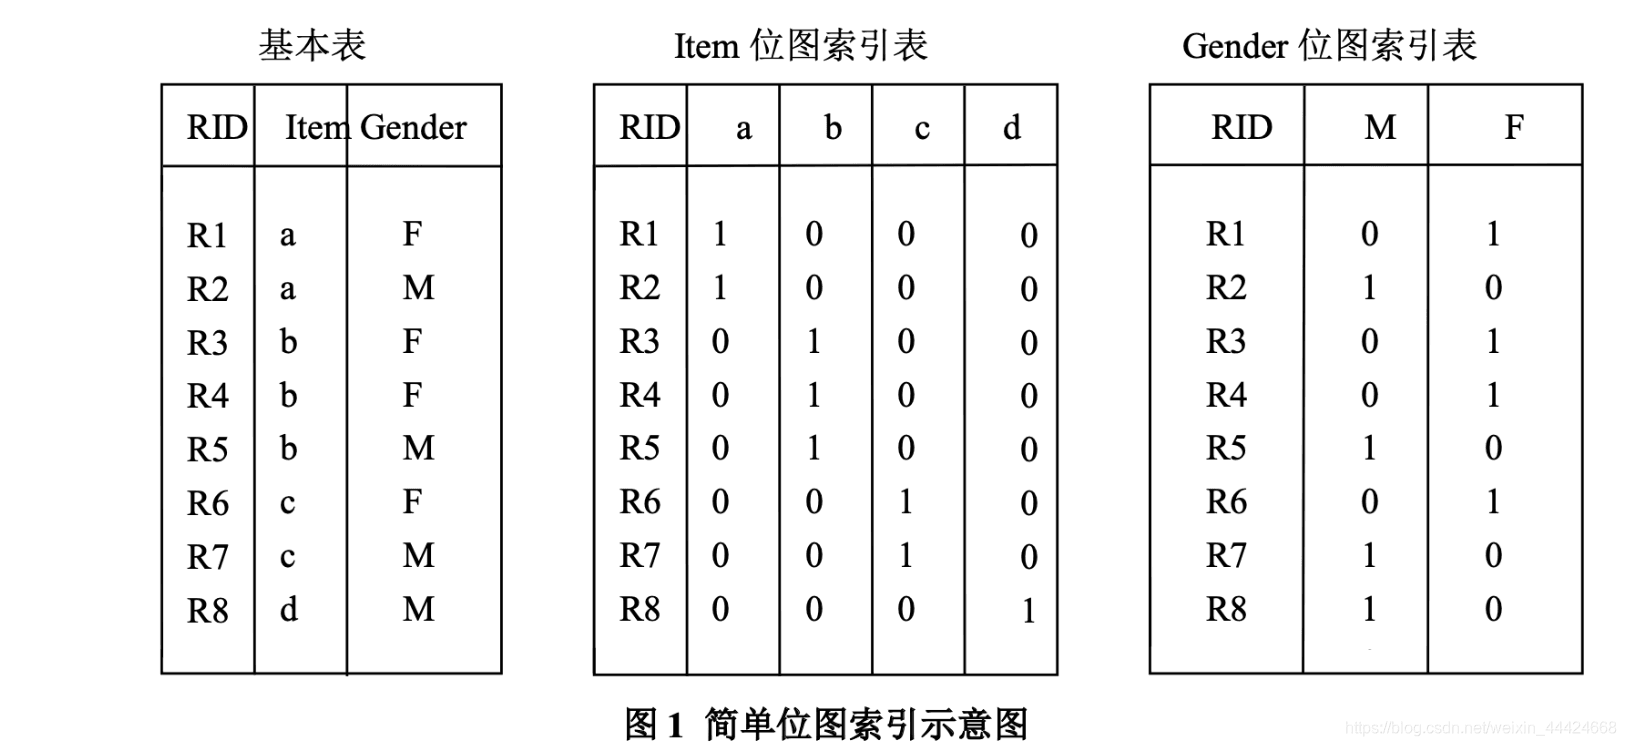
如果我们要找买了b产品的女性,计算时候首先取出b产品和女性F向量做 & 操作
b:0 0 1 1 1 0 0 0
F:1 0 1 1 0 1 0 0
&:0 0 1 1 0 0 0 0
发现第3位和第4位为1,表示第三行、第四行数据是我们要的结果
3 连接索引 Join Index
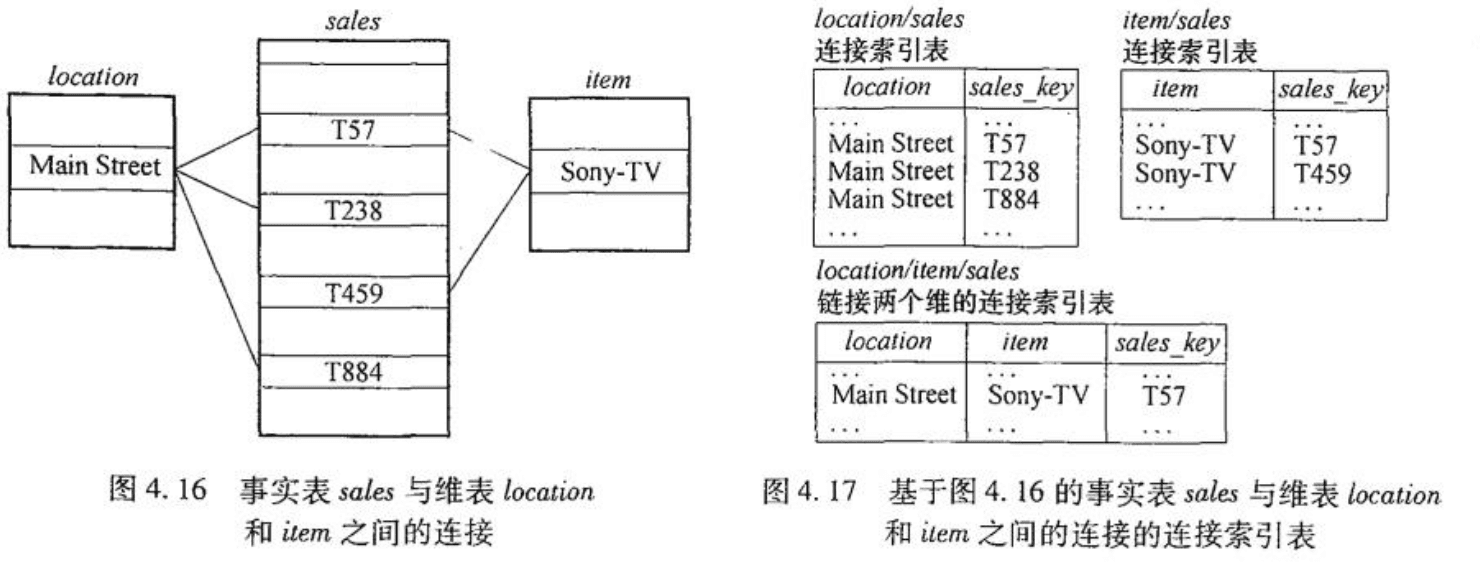
事实表与对应的维表的连接属性是事实表的外码和维表的主码
事实表
记录客观事实的内容。比如销售数据,每条数据记录商品类型、客户性别、交易时间等。
维度表
观察客观事实的维度。比如从客户性别维度来观察销售数据,客户性别维度通常包含男、女、其他。
示例
例题
例题1
a)
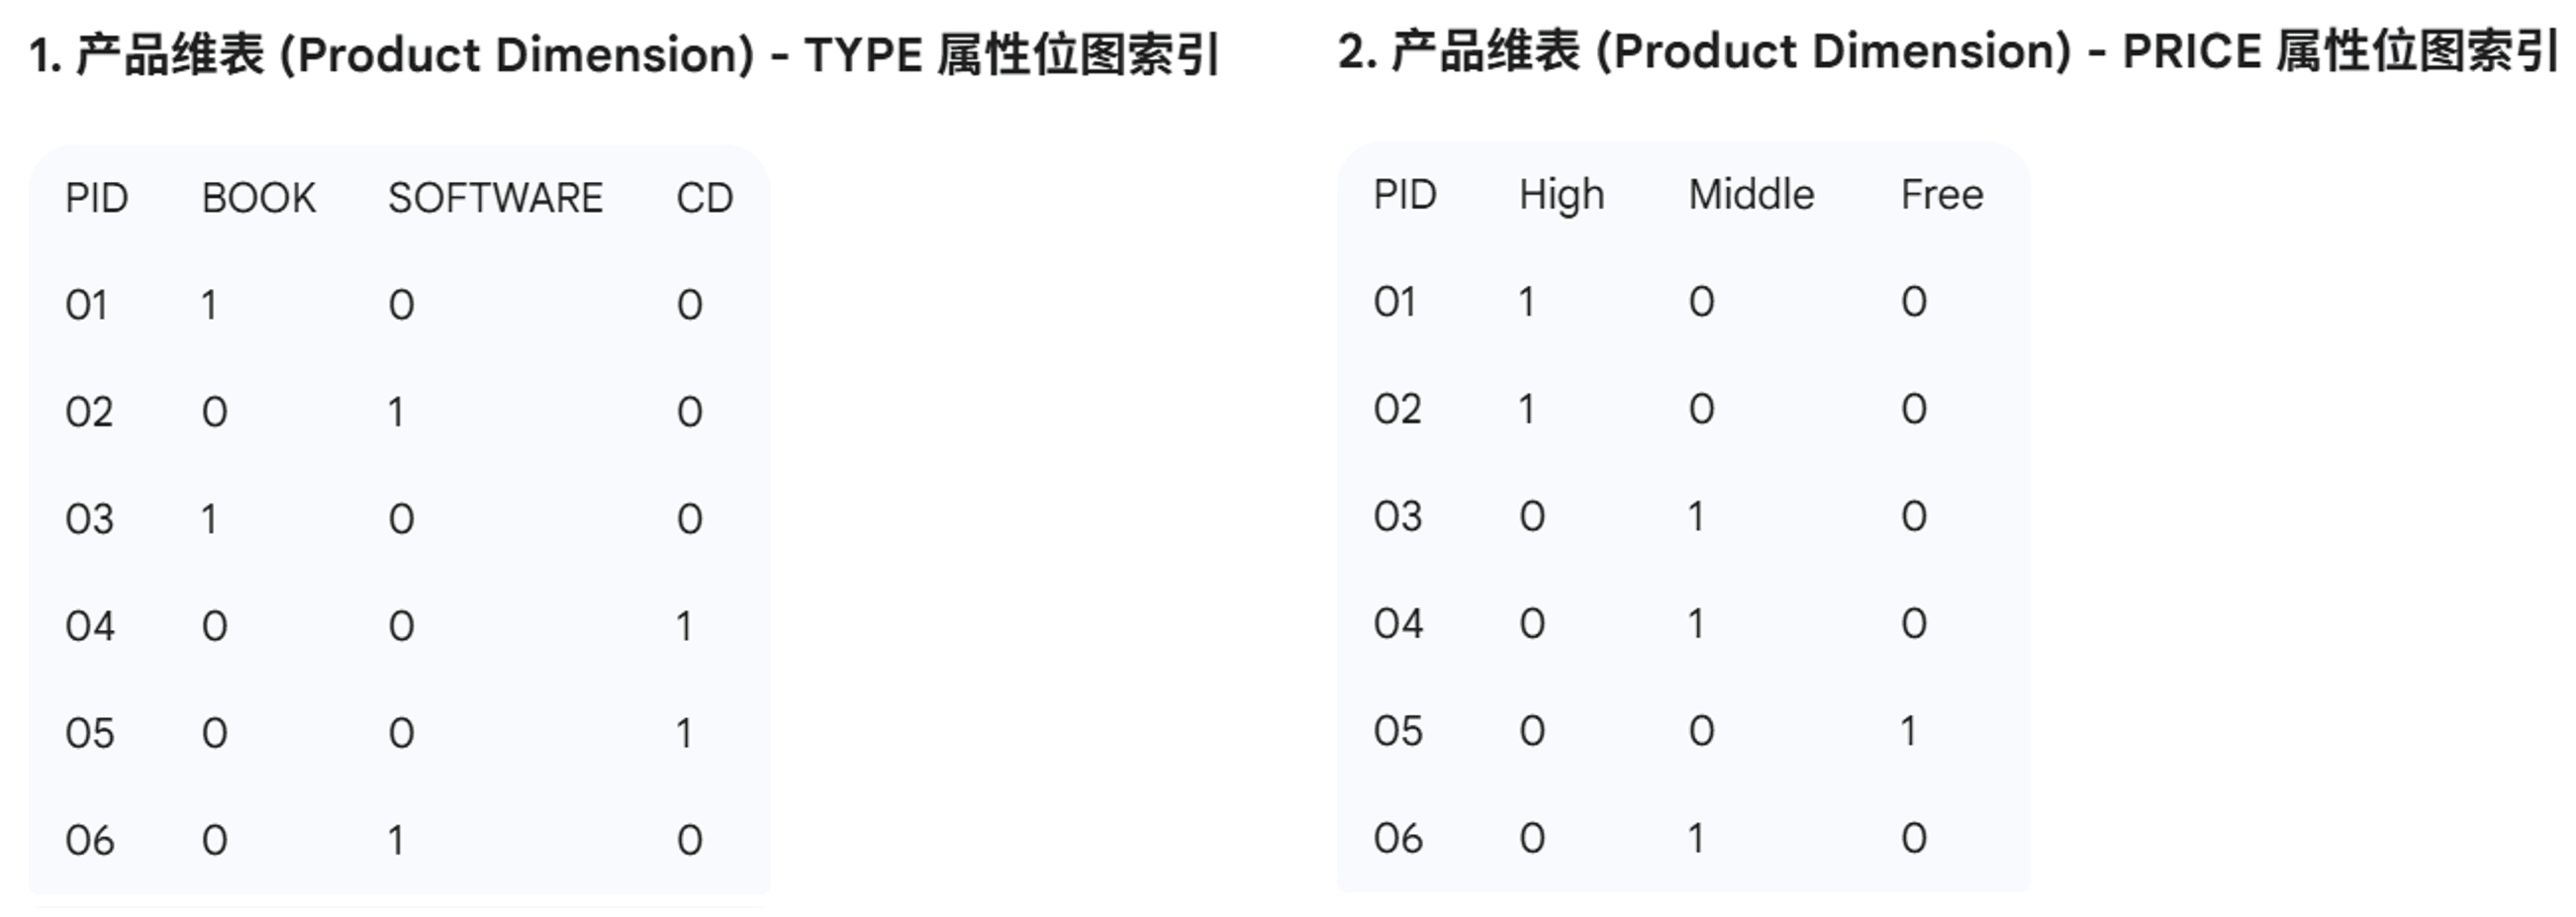
b)
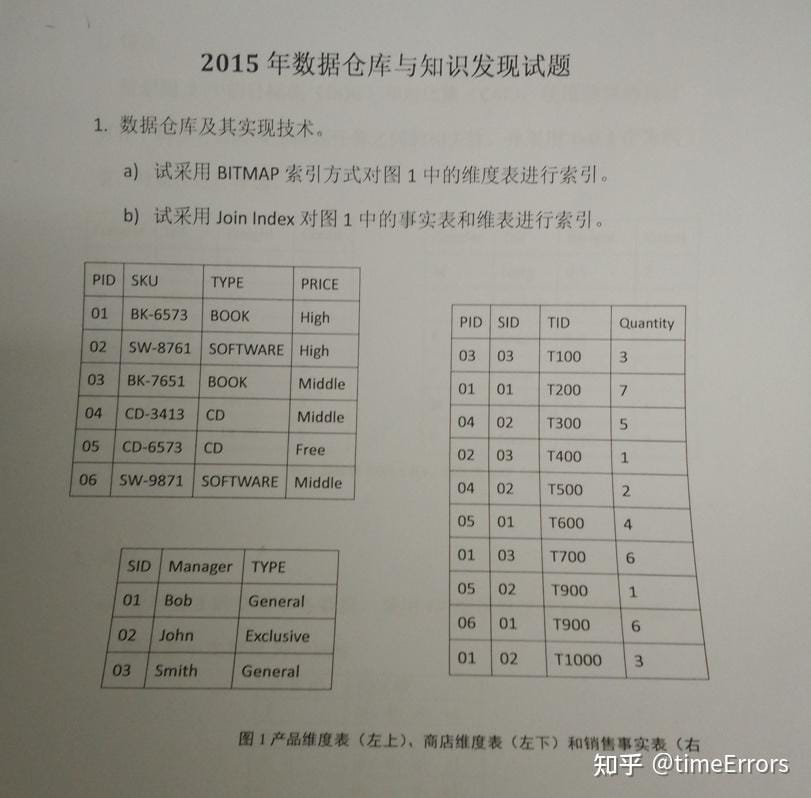
单个维度的连接索引表
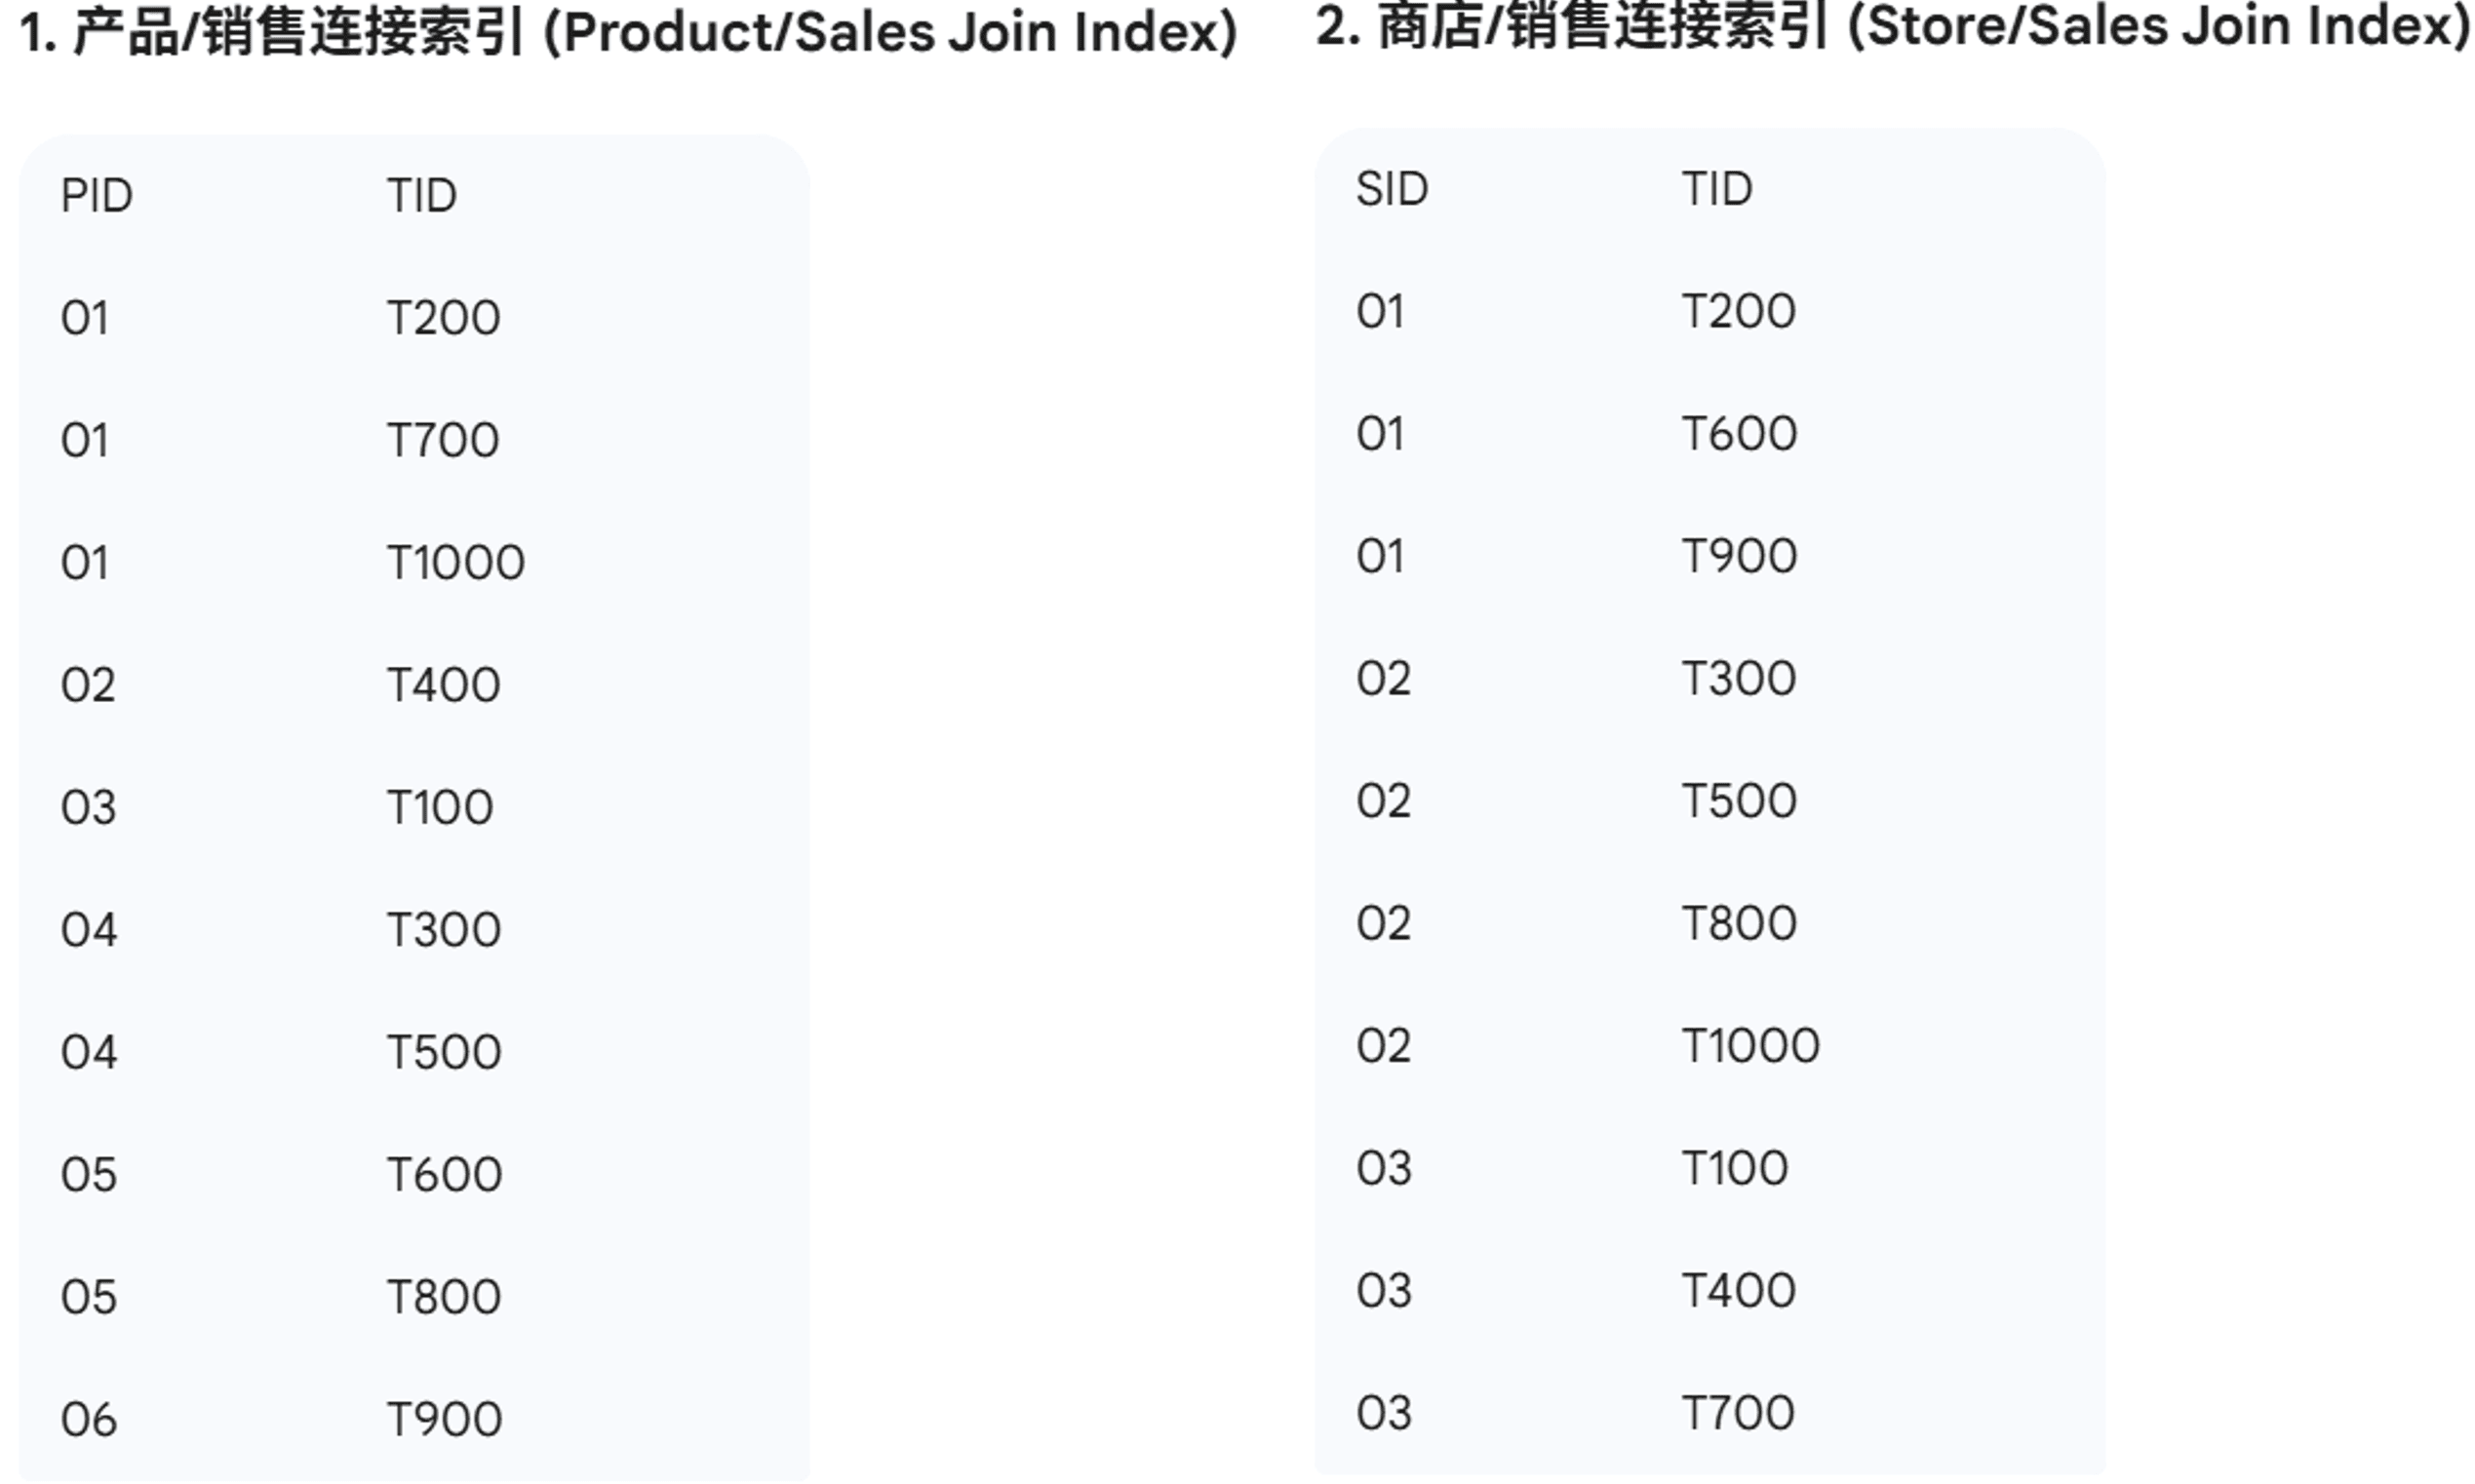
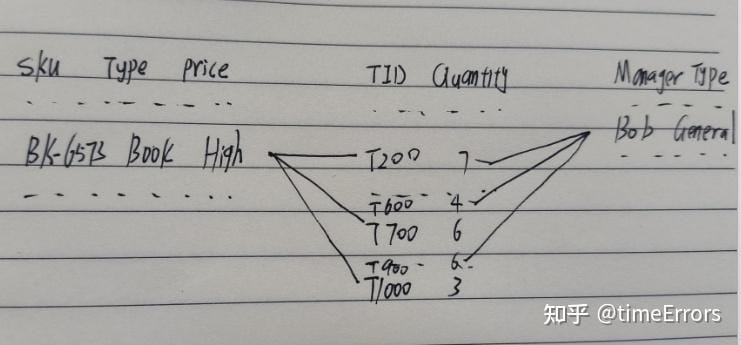
两个维度的连接索引,直接连线表示。例如:
例题2
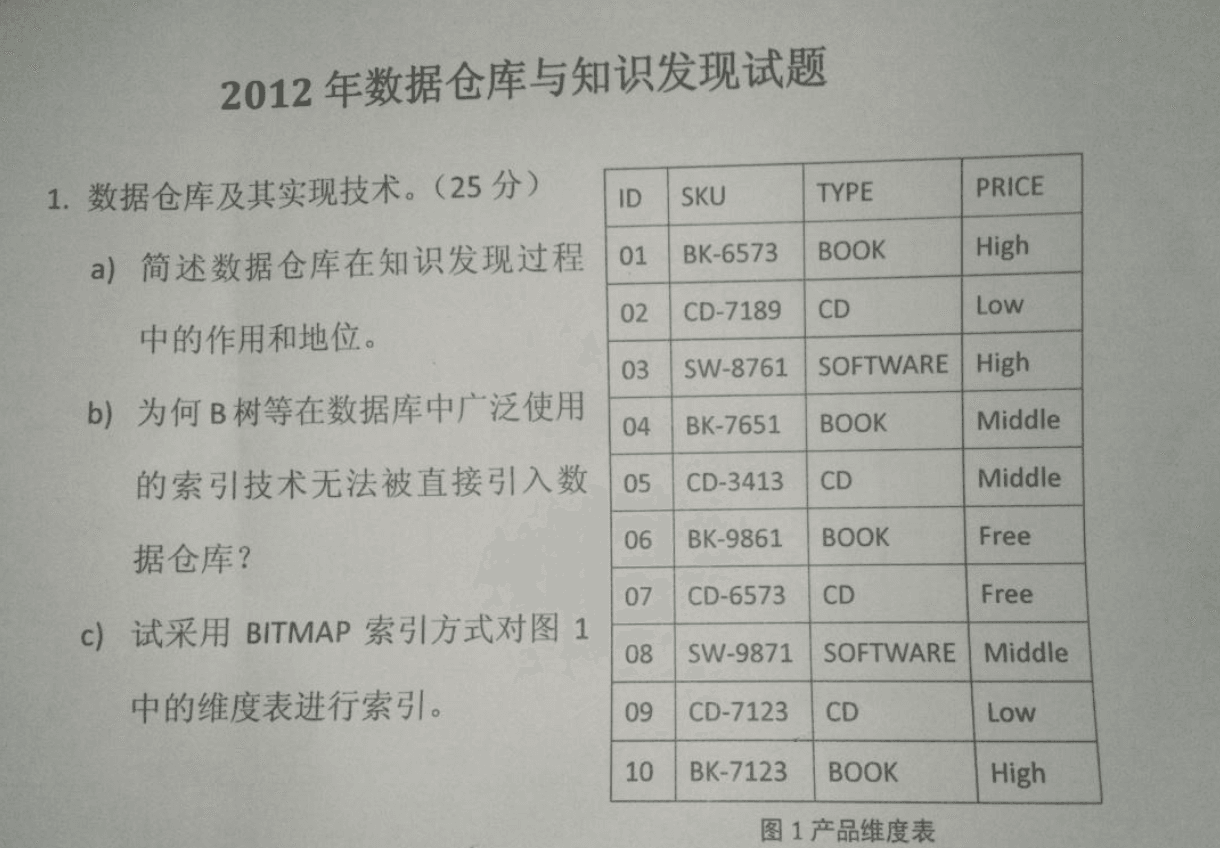
a)
-
数据集成和存储: 数据仓库作为一个集中式的数据存储系统,能够整合来自不同数据源的数据,例如企业内部的事务处理系统、外部数据源、互联网数据等。这种集成确保了数据的一致性和完整性,为知识发现提供了一个可靠和全面的数据基础。
-
数据清洗和预处理: 在数据被存储到数据仓库之前,通常会经过清洗和预处理的步骤,以去除不一致性和错误,提升数据质量。高质量的数据是知识发现的关键,因为知识发现的结果很大程度上依赖于数据的准确性和完整性。
-
数据历史性和时序性: 数据仓库中存储的数据通常包括了时间维度,这使得用户能够进行历史数据分析和趋势预测。在知识发现过程中,时间维度的数据能够提供洞察历史趋势和模式的能力。
-
支持复杂的查询和分析: 数据仓库设计用来支持复杂的查询操作和分析工具,如数据挖掘和在线分析处理(OLAP)。这些工具使得从大量数据中提取有价值的信息变得可能。
-
决策支持: 数据仓库提供的历史、整合、质量高的数据,加上强大的查询和分析工具,为企业提供了有力的决策支持。通过分析这些数据,企业能够发现重要的业务趋势和模式,从而制定更有效的策略和决策。
综上所述,数据仓库在知识发现过程中扮演着至关重要的角色,它不仅是数据存储和管理的中心,也是支持数据分析和知识提取的关键基础设施。
b)
B 树及其变体(如 B+树)是数据库中广泛使用的索引技术,它们提供高效的数据检索和插入性能。然而,在数据仓库环境中,这些技术无法被直接引入,主要基于以下几个原因:
-
查询模式的不同: 传统数据库系统(如在线事务处理系统,OLTP)和数据仓库在查询模式上有显著的不同。OLTP 系统通常处理大量的短小事务,如插入、更新和删除,这些操作涉及到少量记录。B 树等索引非常适合这种类型的快速查找和修改。然而,数据仓库主要用于在线分析处理(OLAP),其特点是少量的查询,但每次查询涉及大量数据,并且查询通常是复杂的,涉及到多表连接和聚合操作,这种情况下 B 树的效率并不高。
-
数据更新频率: 数据仓库中的数据通常是预处理和加载的,而不是实时更新的。这意味着数据仓库中的数据变化频率远低于 OLTP 系统。因此,数据仓库中不太需要针对频繁更新优化的索引结构。
-
大规模扫描的需要: 数据仓库的查询通常涉及对大量数据的扫描。在这种情况下,传统的 B 树索引可能不如其他针对批量读取优化的技术,如位图索引或列式存储。
-
存储空间的考量: B 树索引占用相对较多的存储空间。在数据仓库中,由于数据量本身就很大,因此额外的索引可能会导致存储空间的显著增加。 列式存储的兴起: 数据仓库领域的一个重要趋势是列式存储的使用,这对于执行大规模分析查询更为有效。列式存储与 B 树这种基于行的索引方法在概念上有所不同,更适合数据仓库的使用场景。
综上所述,尽管 B 树等索引技术在传统数据库中非常有效,但由于数据仓库与传统数据库在数据处理和查询需求上有本质的区别,使得这些技术并不适合直接应用于数据仓库环境。相反,数据仓库倾向于使用其他类型的索引和存储结构,以满足其特定的性能和存储需求。
c)
例题3
a)
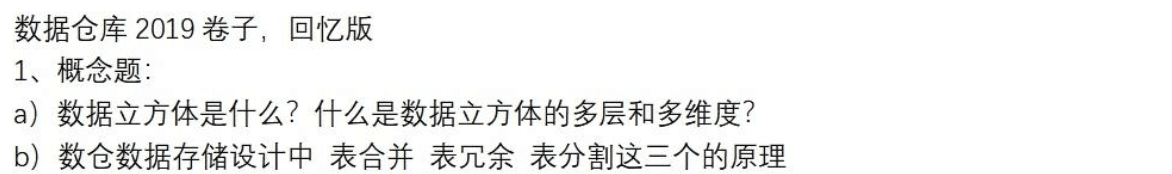
数据立方体(Data Cube)是一种用于表示和处理多维数据的数据结构。在数据库和数据仓库系统中,它是一个常用的概念,特别是在在线分析处理(OLAP)和多维数据分析中。数据立方体使得用户可以从多个维度(如时间、地区、产品类型等)分析数据,支持复杂的数据查询和汇总操作。
数据立方体是一种多维数据模型,主要有星形模式、雪花模式和事实星座模式;在数据仓库中多用事实星座模式,因为它能对多个相关的主题建模;而在数据集市流行用星形或雪花模式。
多维度(Multidimensionality)
定义:在数据立方体中,多维度是指数据可以沿着多个不同的维度进行组织和分析。每个维度代表数据的一个特定方面或分类。 例子:常见的维度包括时间(例如年、月、日)、地理位置(如国家、城市)、产品类别等。例如,一个零售业务的数据立方体可能包含时间、产品类别和地区三个维度。作用:多维度使得用户能够从不同角度查看和分析数据,以便更全面地理解业务情况和趋势。
多层(Multilevel)
定义:在数据立方体中,多层指的是每个维度内部的层次结构。一个维度可以被分解成不同的层次,每个层次提供不同粒度的数据视图。 例子:以时间维度为例,时间可以被分解为年、季、月、日等层次。用户可以选择查看年度总结数据,也可以深入到月度或日度数据进行更详细的分析。 作用:多层结构允许用户在不同的粒度级别上进行数据分析,从而进行更深入的数据挖掘和洞察。
b)
在数据仓库存储设计中,表合并、表冗余和表分割是三个关键的概念,它们各自基于不同的原理,旨在优化数据存储、查询性能和数据整合。下面我将详细解释每一个概念:
表合并(Table Merging)
-
原理:表合并是将多个相关的表合并为一个更大的表的过程。这通常发生在维度表与事实表之间,或者是当多个维度表具有高度相关性时。例如,在一个销售数据仓库中,可以将产品信息、供应商信息和价格信息合并为一个大表。
-
目的:主要目的是为了简化查询,通过减少需要进行连接操作的表的数量来提高查询效率。这对于需要频繁访问多个表的数据分析尤为重要。
-
优点:减少了查询时的表连接操作,简化了查询逻辑,提高了查询效率。
-
缺点:可能导致数据冗余和存储空间的增加。
表冗余(Table Redundancy)
-
原理:表冗余是指在一个或多个表中故意存储重复数据的做法。在数据仓库中,这通常意味着某些数据在多个地方被复制和存储。
-
目的:主要是为了优化查询性能,尤其是在分布式系统中,通过本地化数据来减少查询时的网络延迟。
-
优点:提高了数据检索的速度,减少了复杂的表连接和数据聚合操作。
-
缺点:增加了存储需求,可能导致数据一致性维护的复杂性增加。
表分割(Table Partitioning)
-
原理:表分割是将一个大表分割成多个更小的、管理起来更容易的部分。这可以是水平分割(根据行),也可以是垂直分割(根据列)。
-
目的:旨在提高大数据集的管理效率和查询性能。分割后,查询可以仅针对相关的数据分区进行,而不是整个表。
-
优点:提高了大型表的管理效率,优化了查询性能,降低了维护成本。
-
缺点:如果分割策略设计不当,可能会导致数据分布不均匀,影响查询性能。
第二题 特征(信息增益)
1 信息熵
2 信息增益
3 计算简化
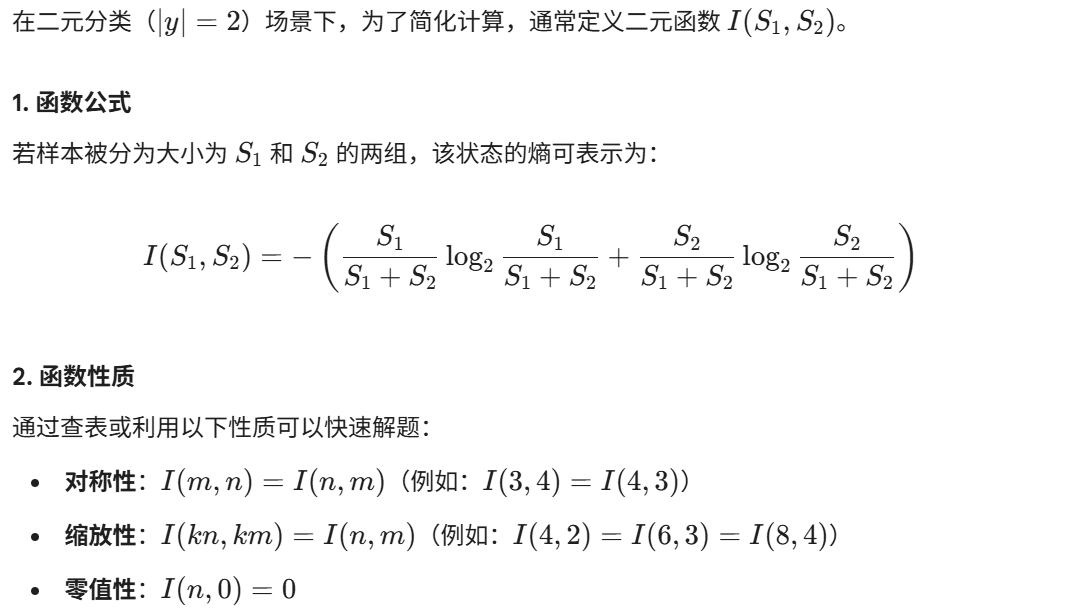
例题
例题1
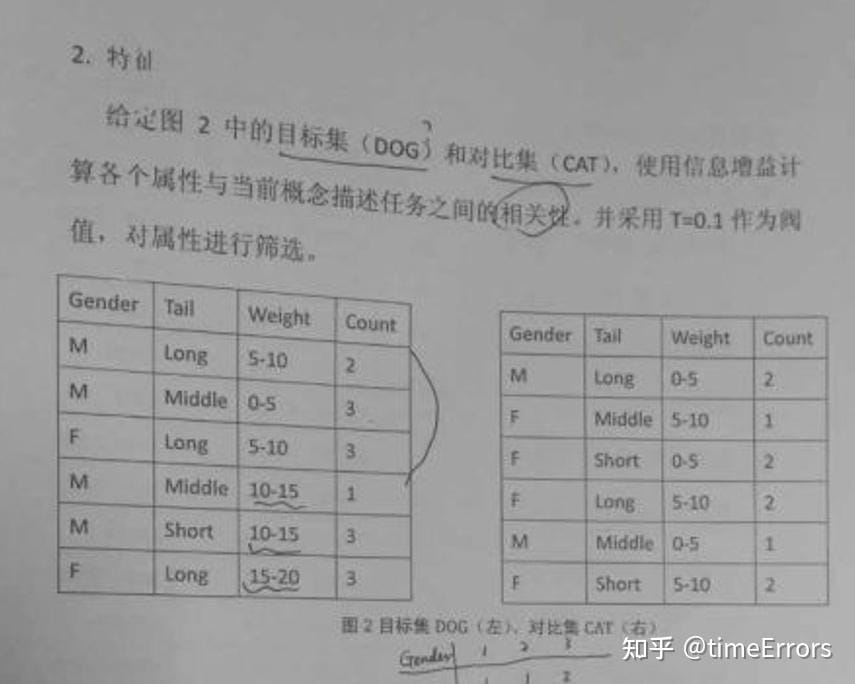
1. 数据预统计
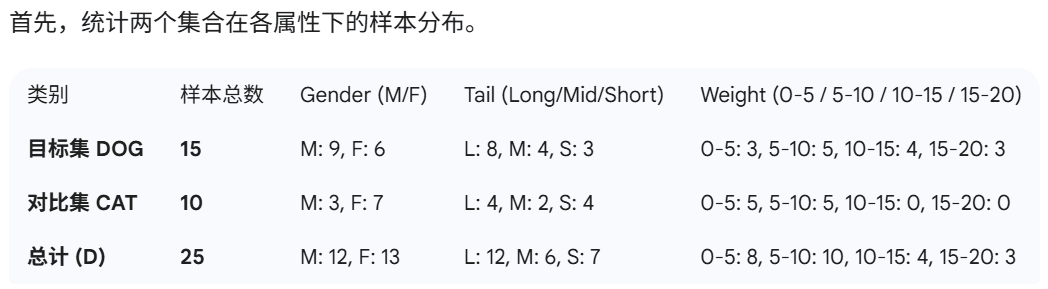
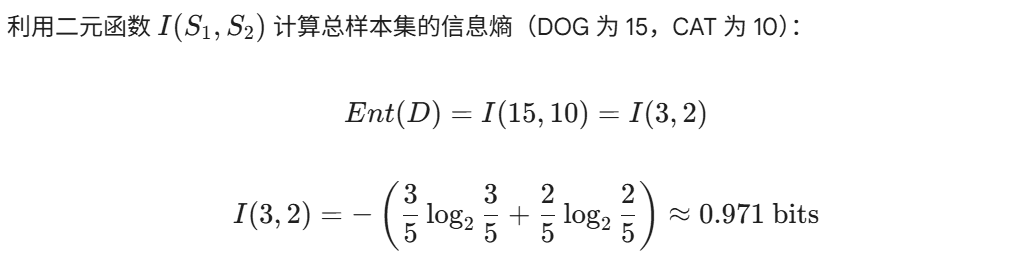
2. 计算初始信息熵
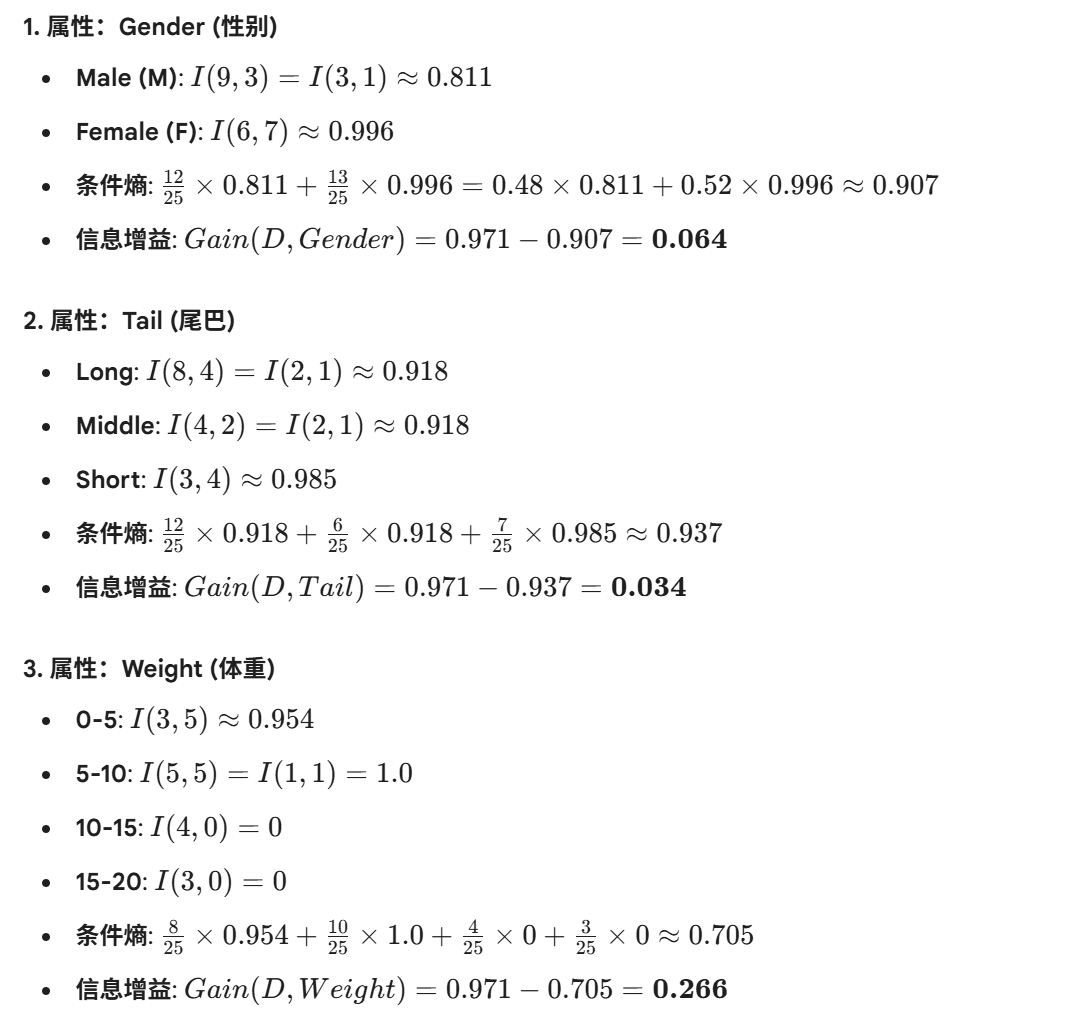
3. 计算各属性的信息增益
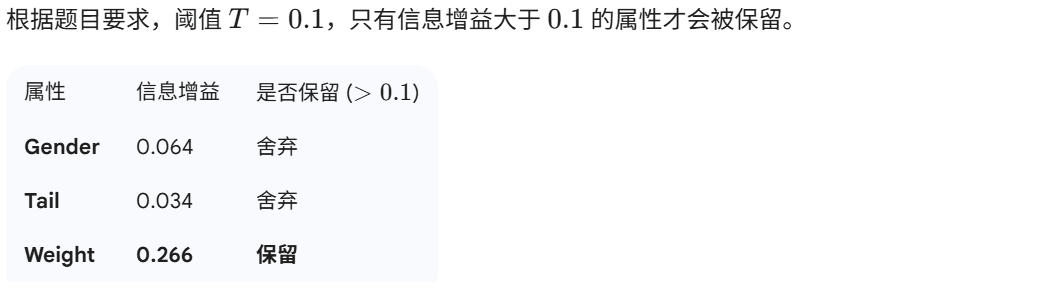
4. 属性筛选
例题2

第三题 关联
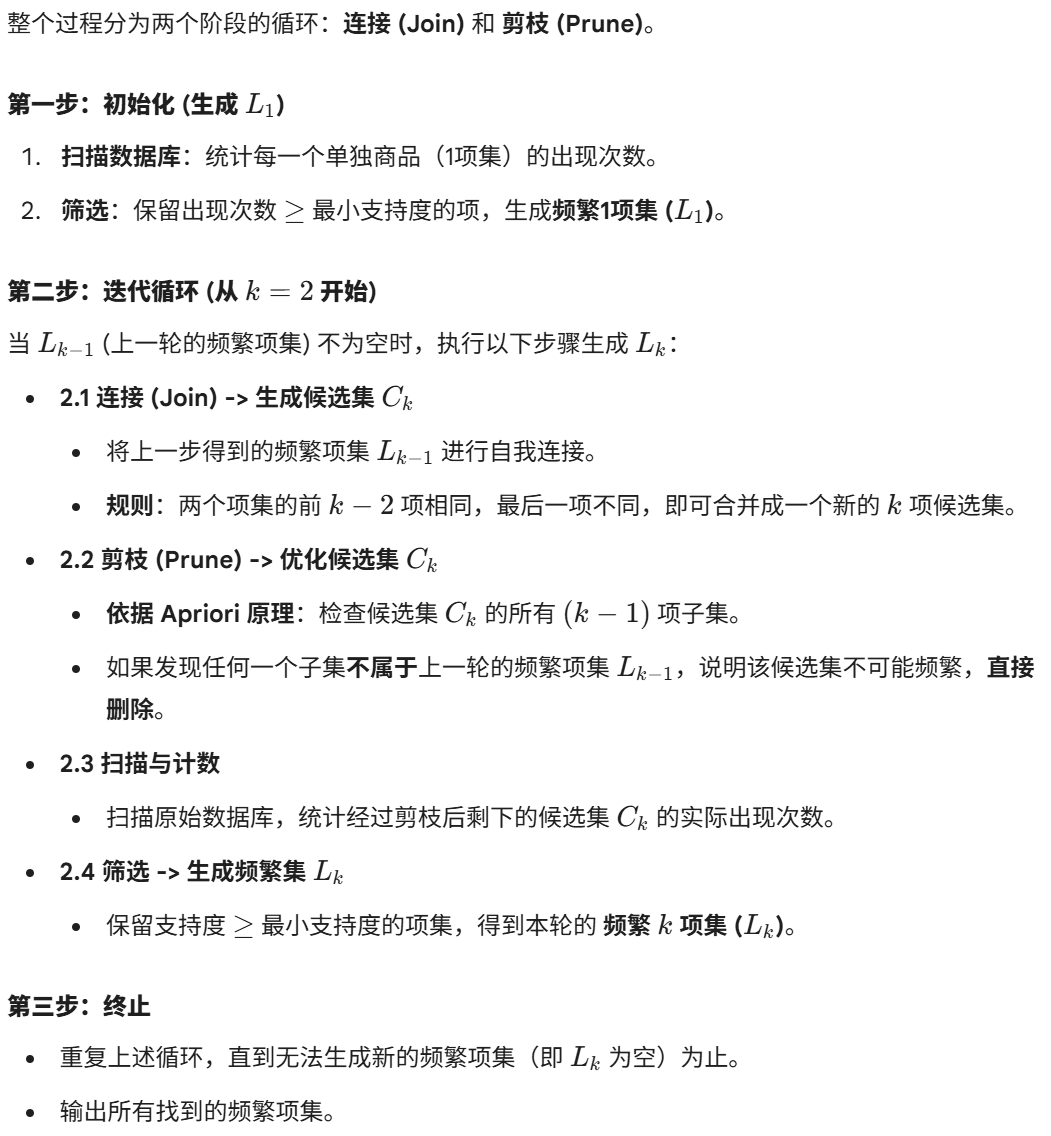
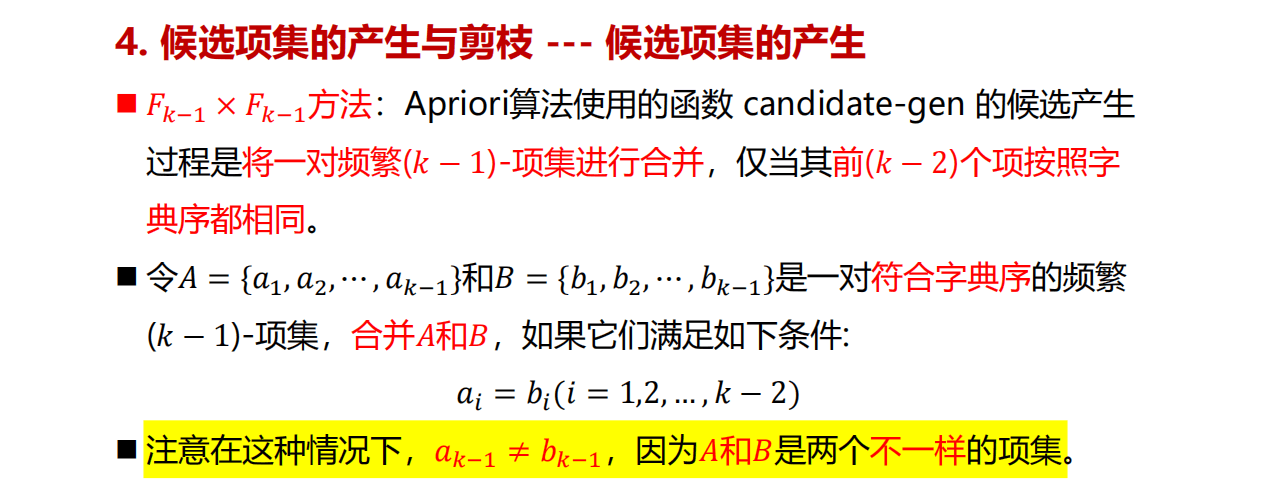
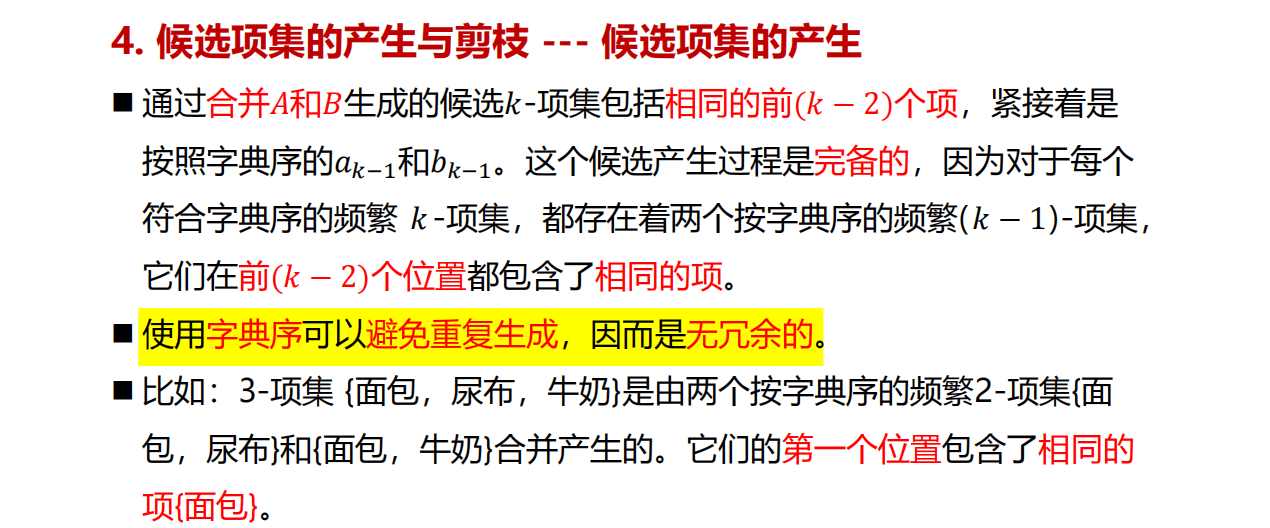
1 Apriori算法
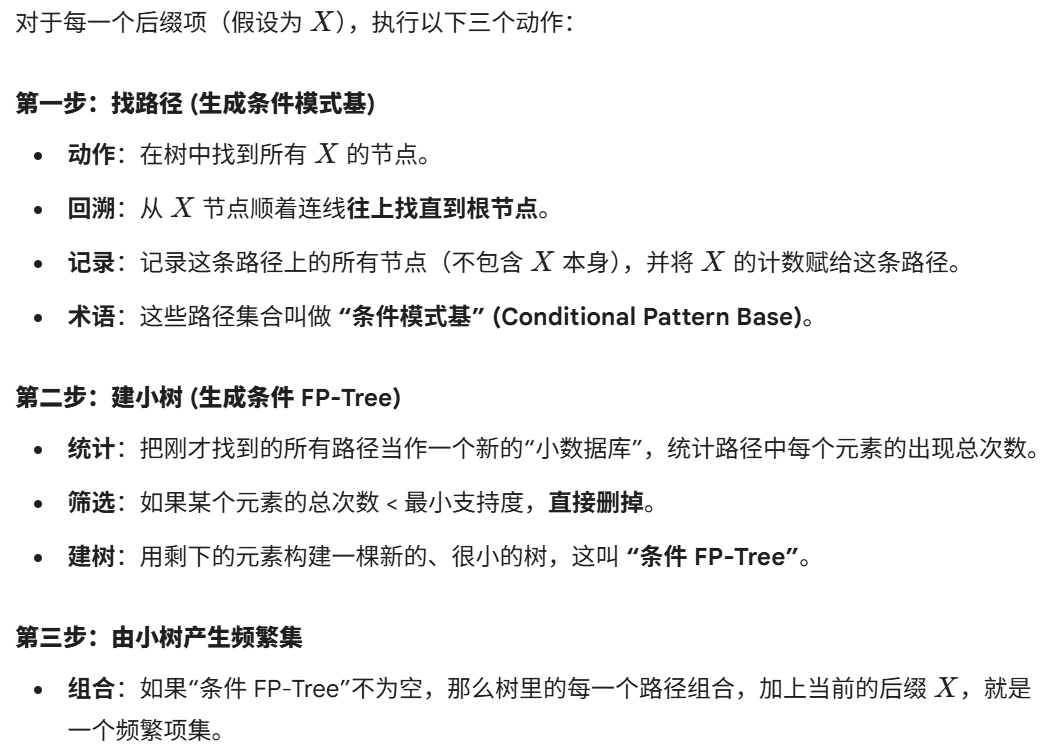
2 FP增长算法
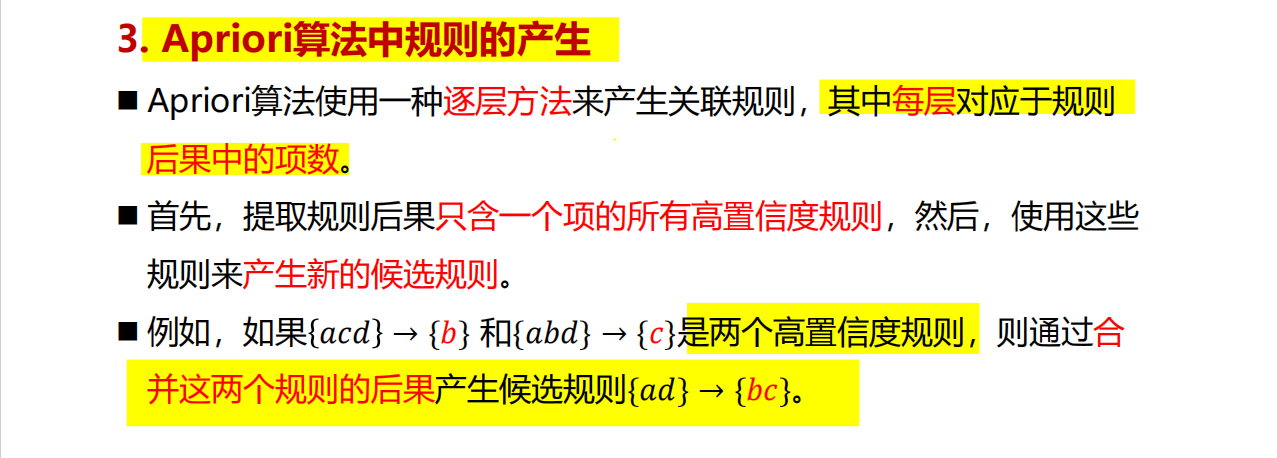
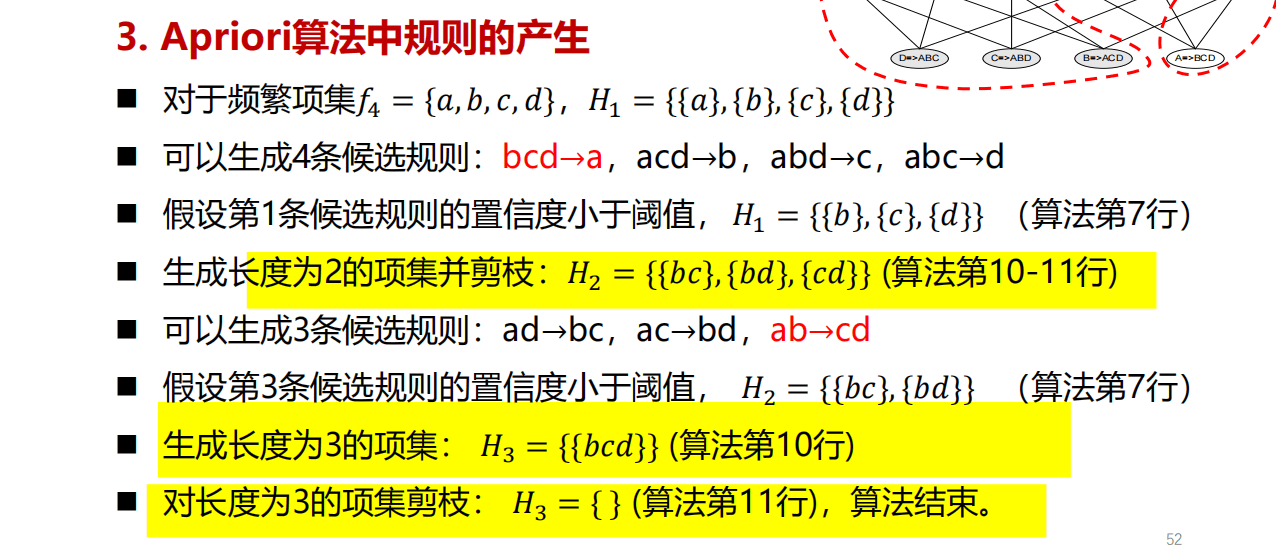
3 规则的产生
例题
例题1
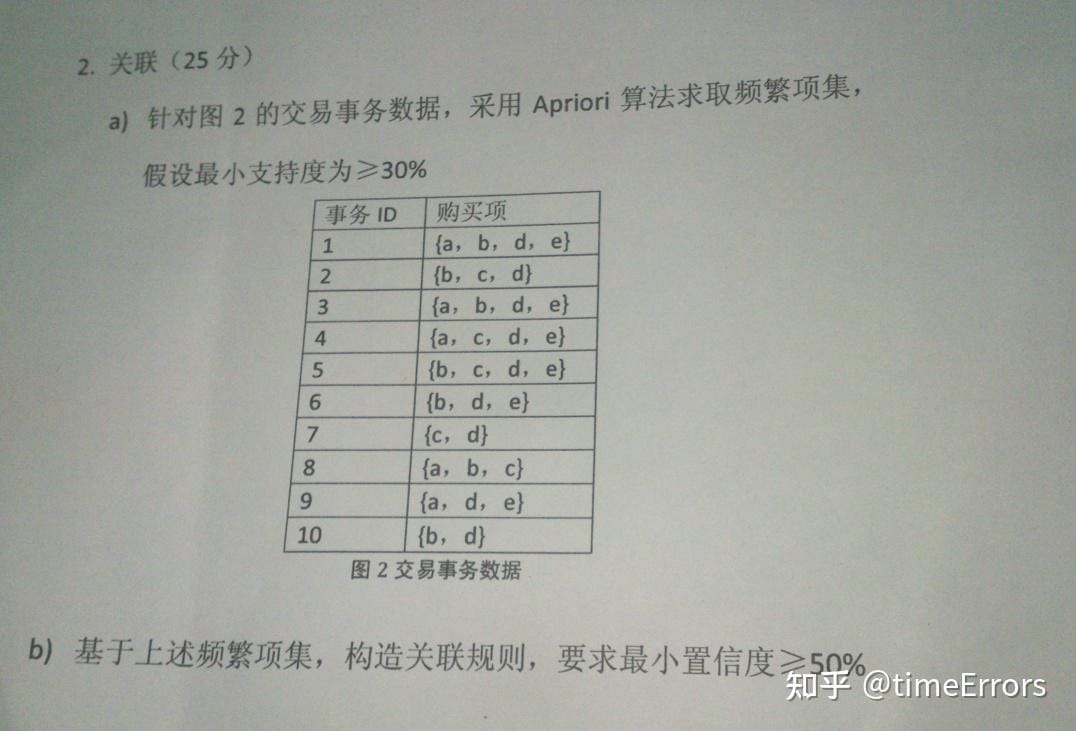
a)
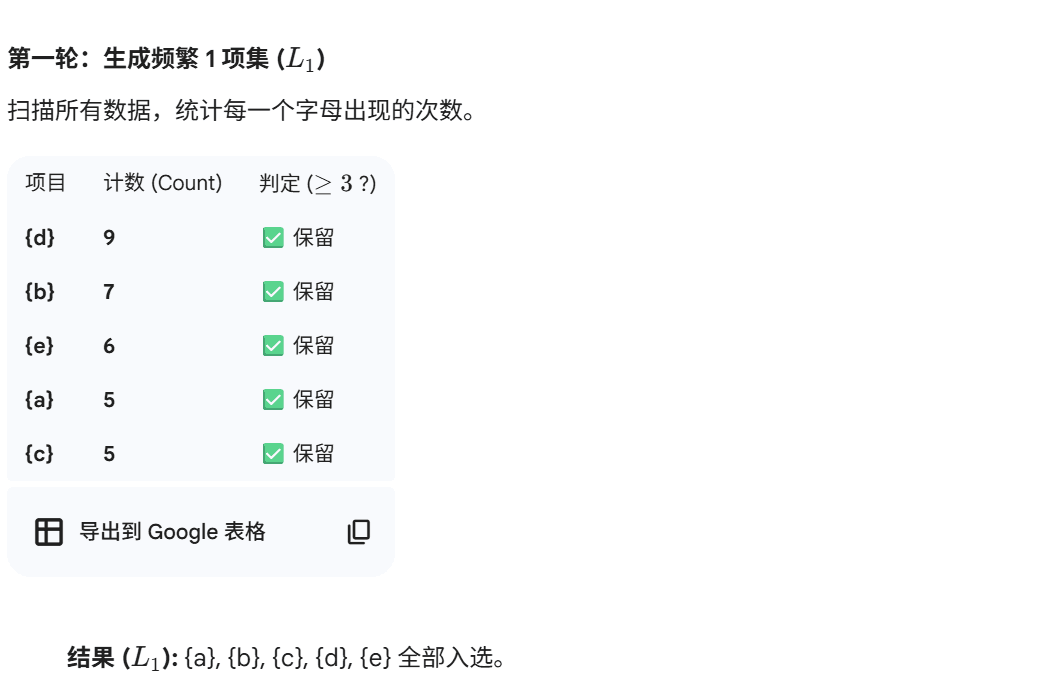
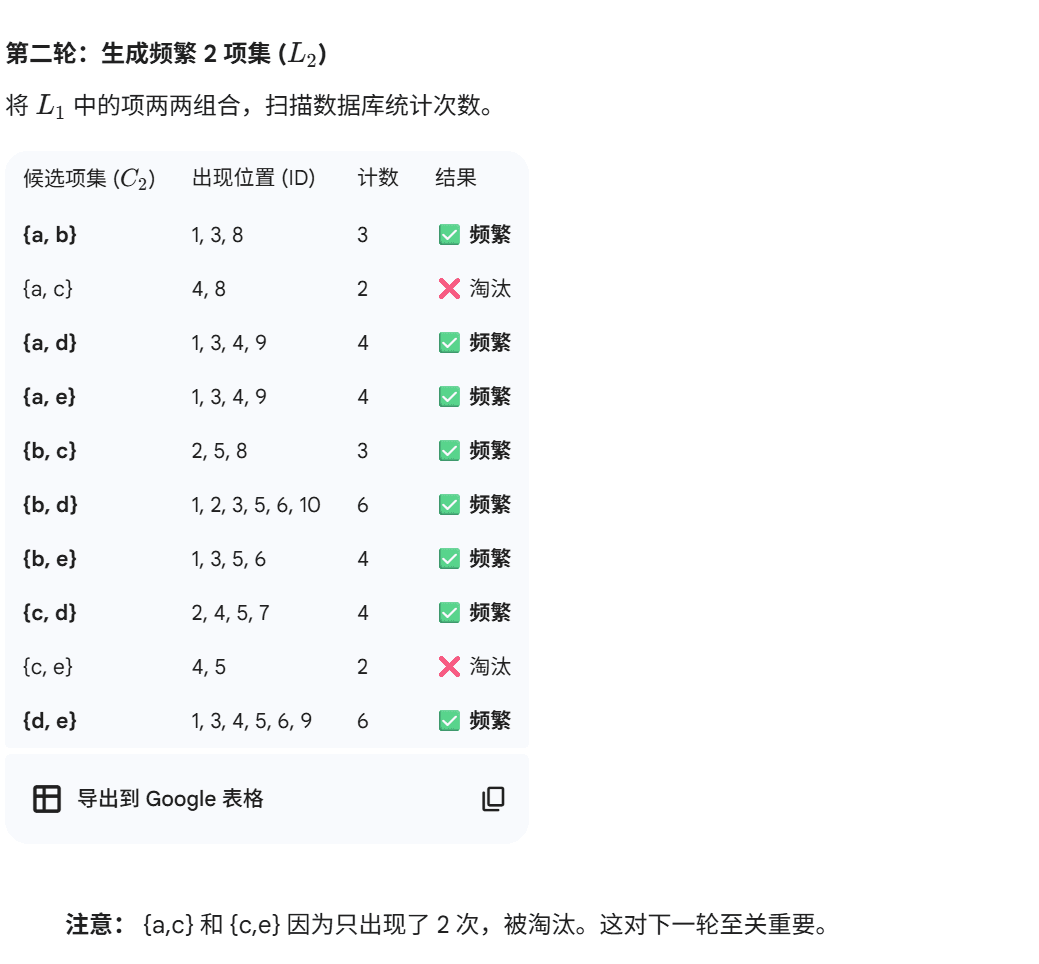
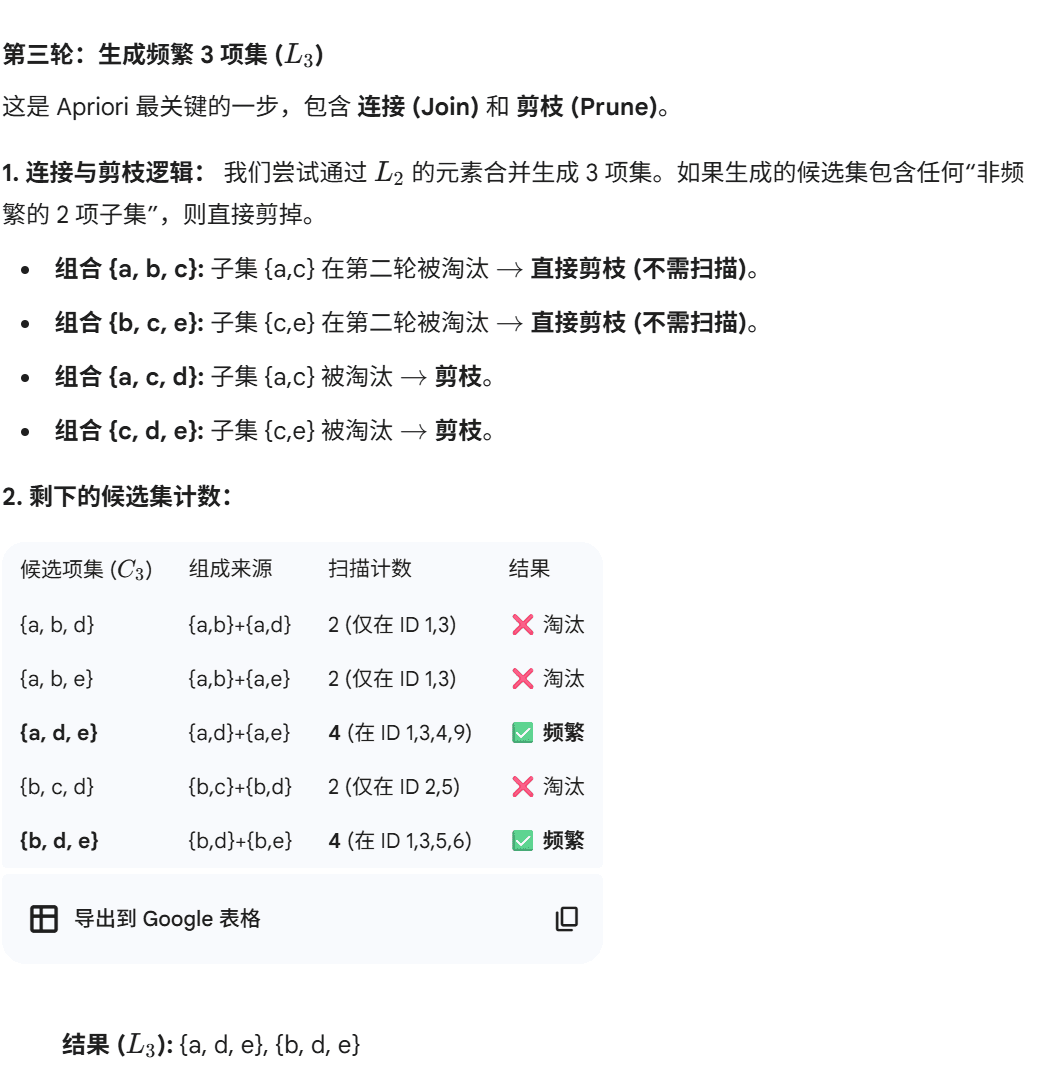
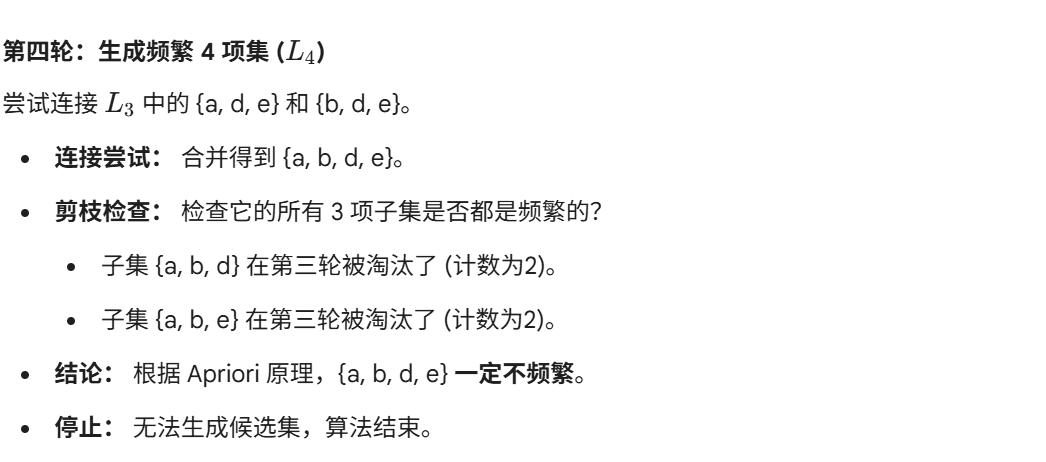
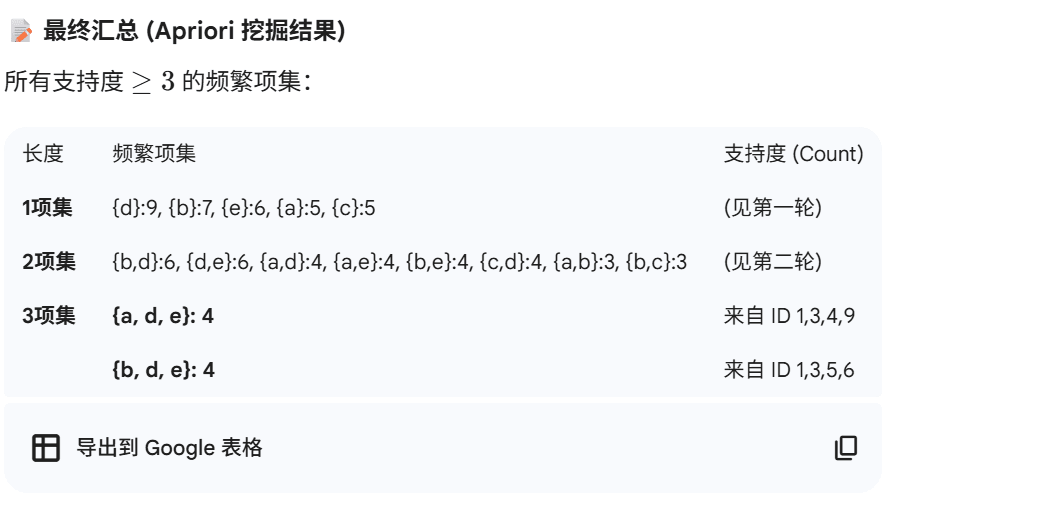
b)
以"2推1"为例
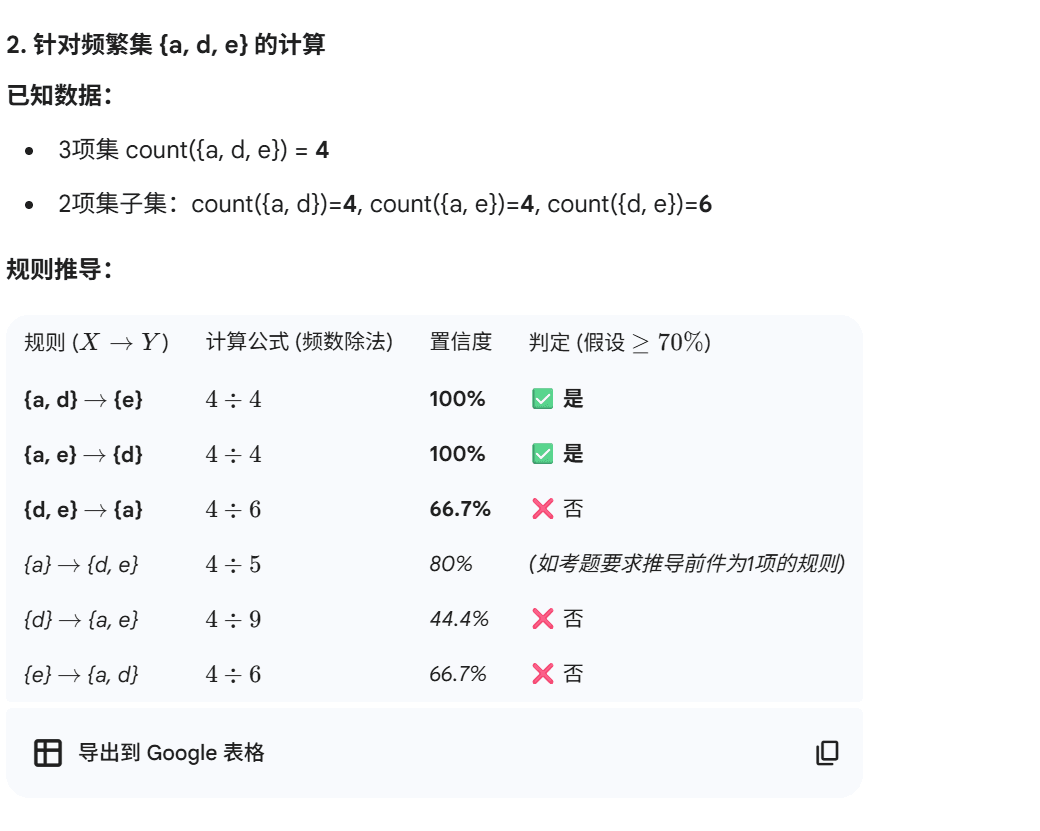
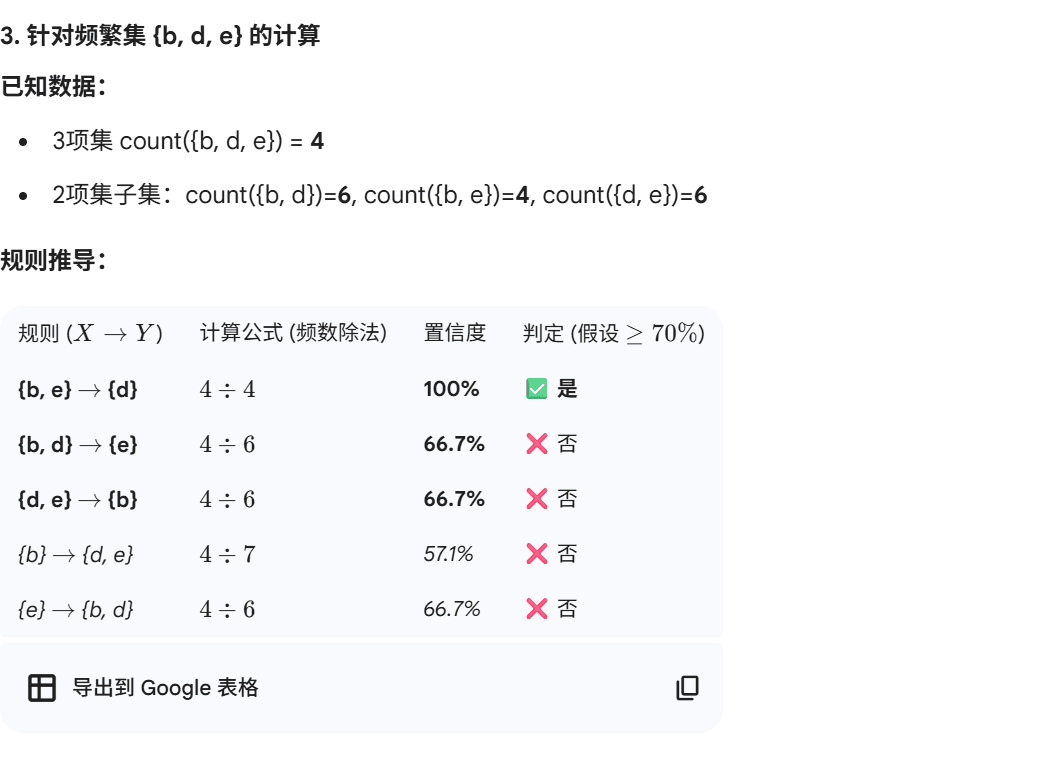
例题2
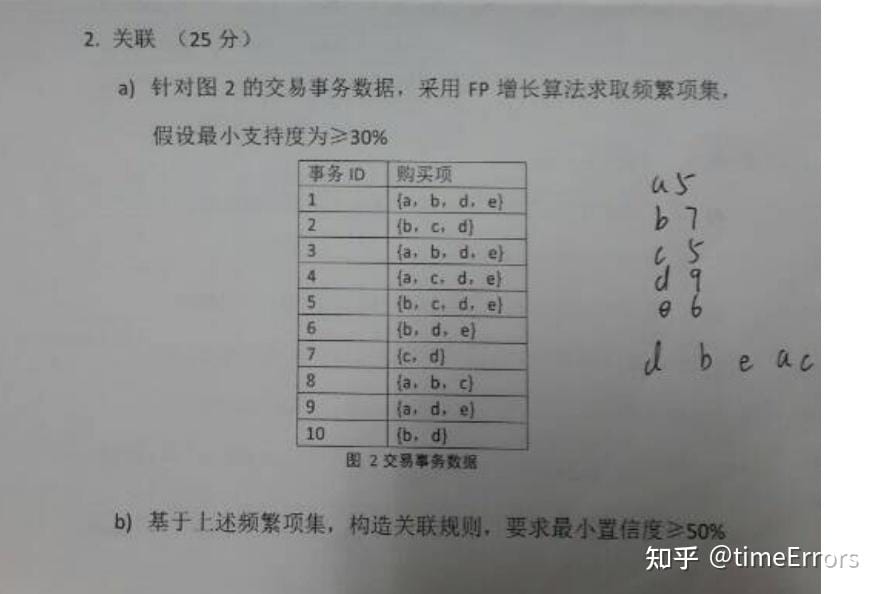
a)
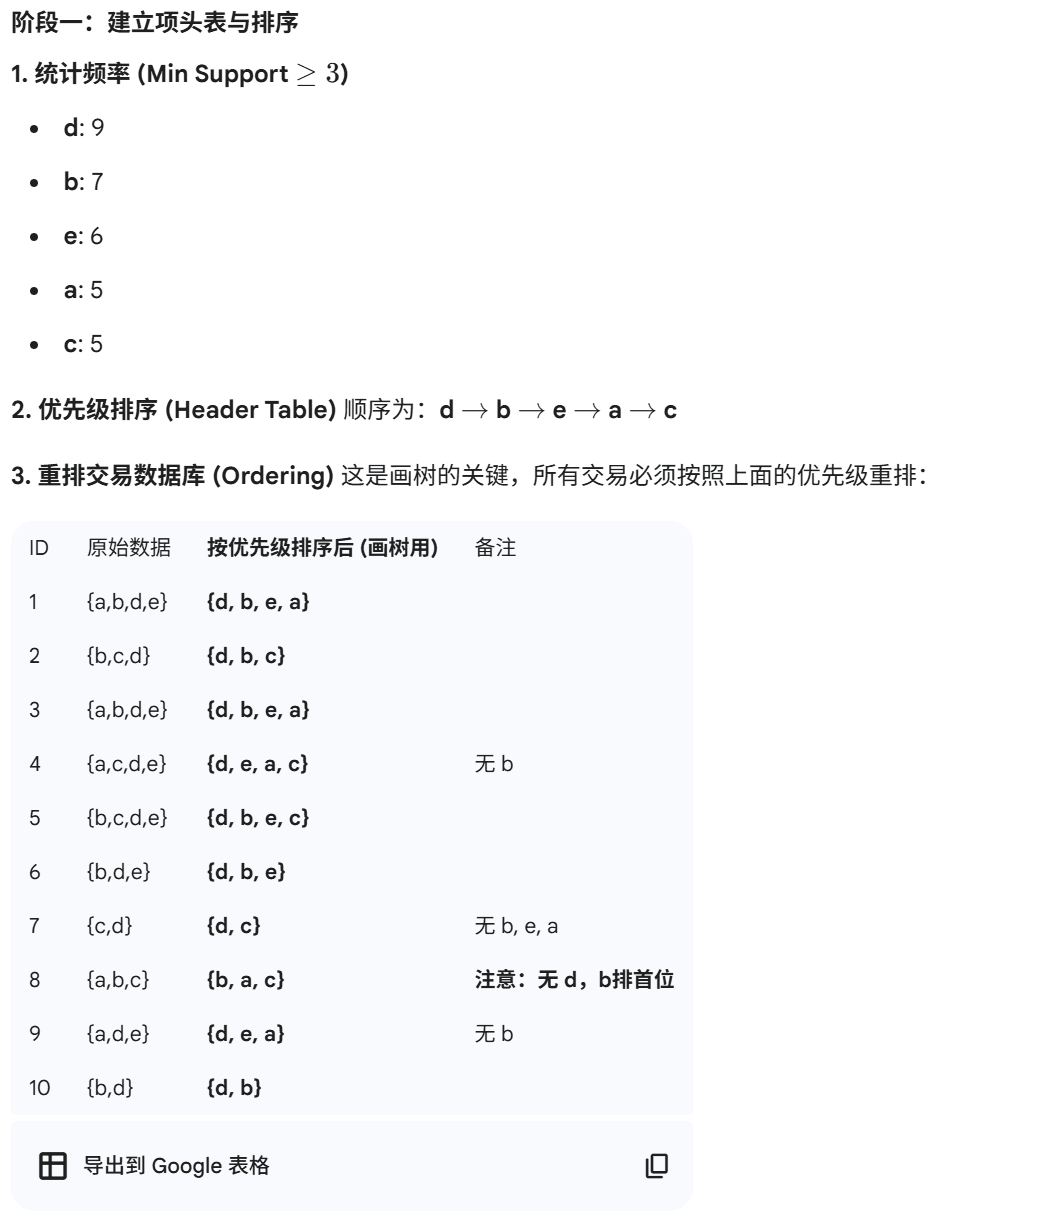
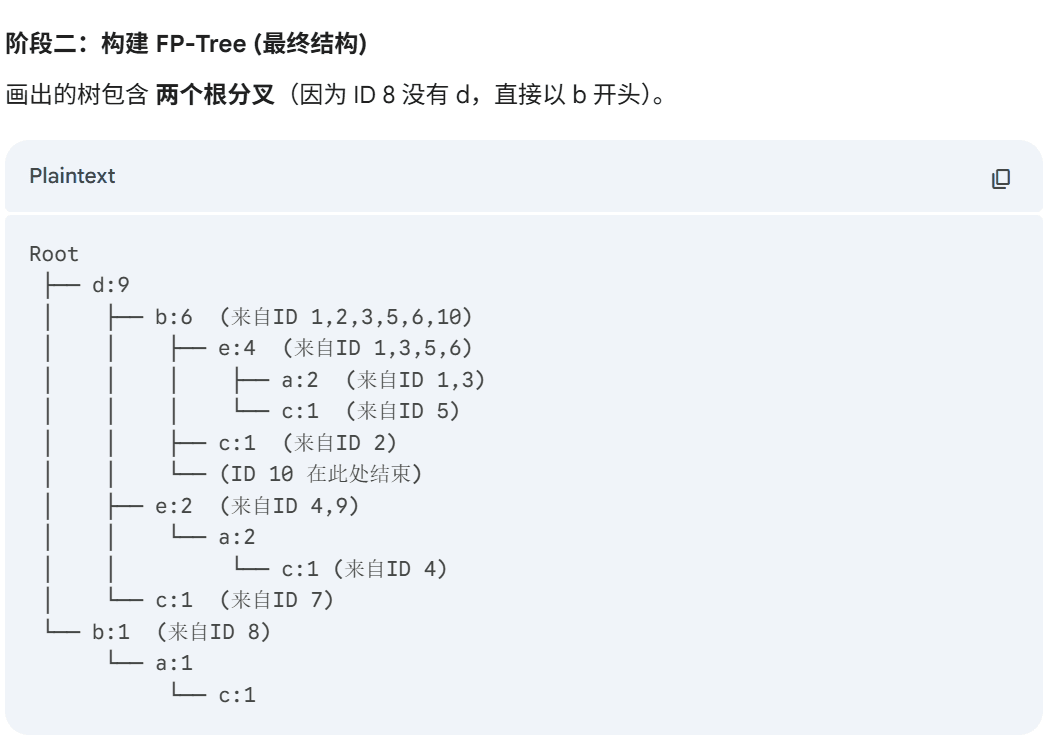
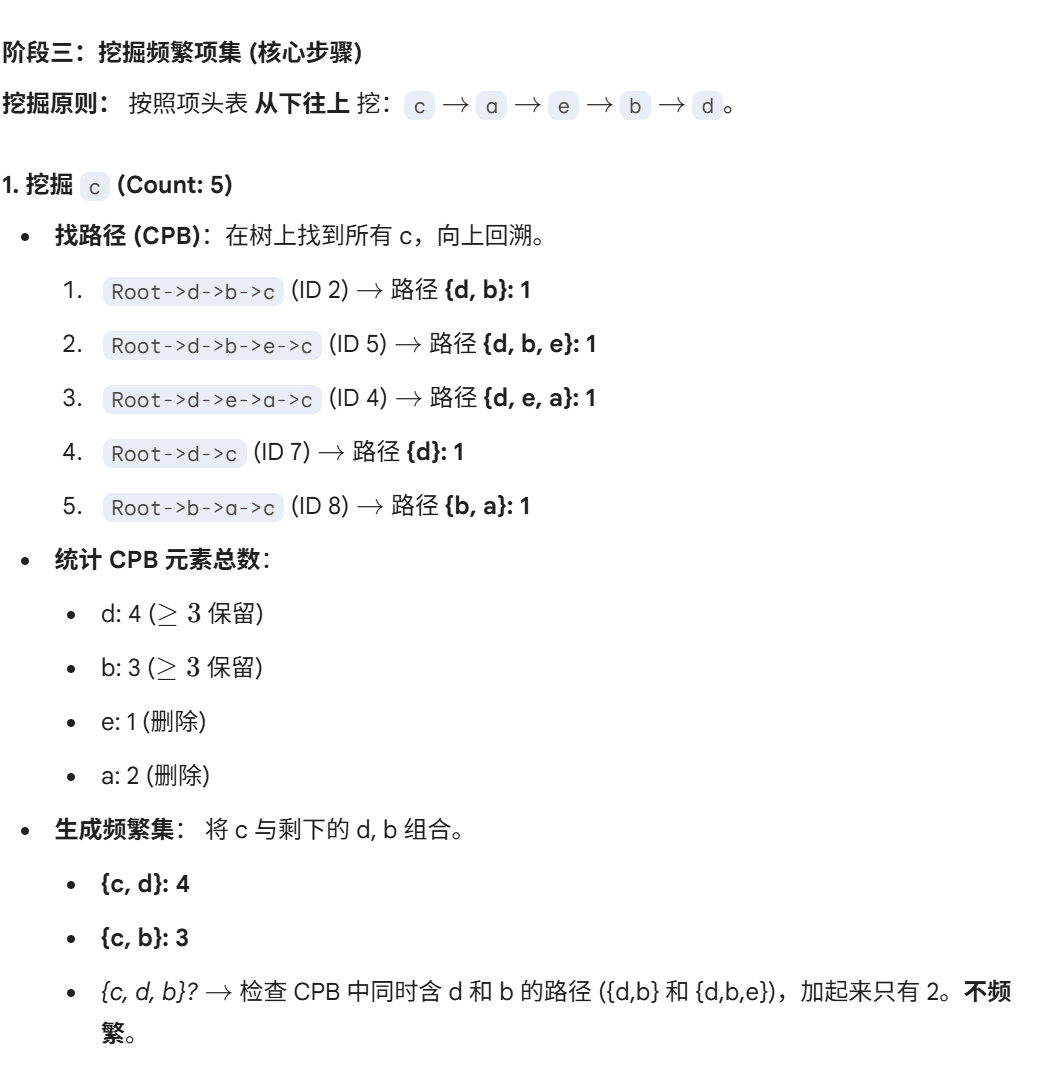
b)
与例题1结果相同。
例题3

第四题 分类
1 分桶
-
等宽分桶:
数据的范围被分割成宽度相等的区间,每个区间的宽度由数据的最大值和最小值决定。
-
等深分桶
等深分桶将数据分割成包含大致相同数量数据点的区间。这意味着每个桶的宽度可能会不同,但每个桶中的数据点数量相似。
-
3-4-5 原则分桶
这是一种更加定性的分桶方法,通常用于商业和市场分析。它基于这样一个观察:人类倾向于更好地记住和理解 3 到 5 个类别。在应用这个原则时,数据被分割成 3 到 5 个区间,以使结果更容易被人理解和记忆。这种方法更多地依赖于业务理解和目标,而不是严格的数学规则。
2 决策树分类器
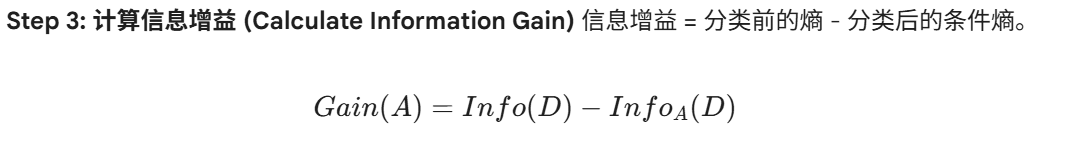
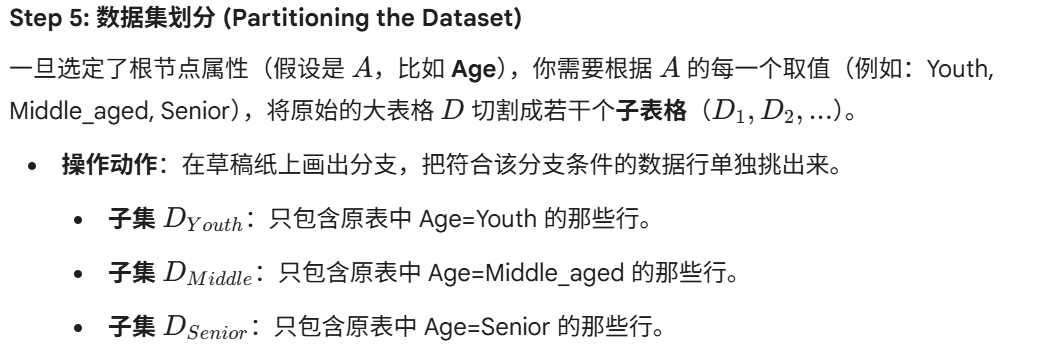
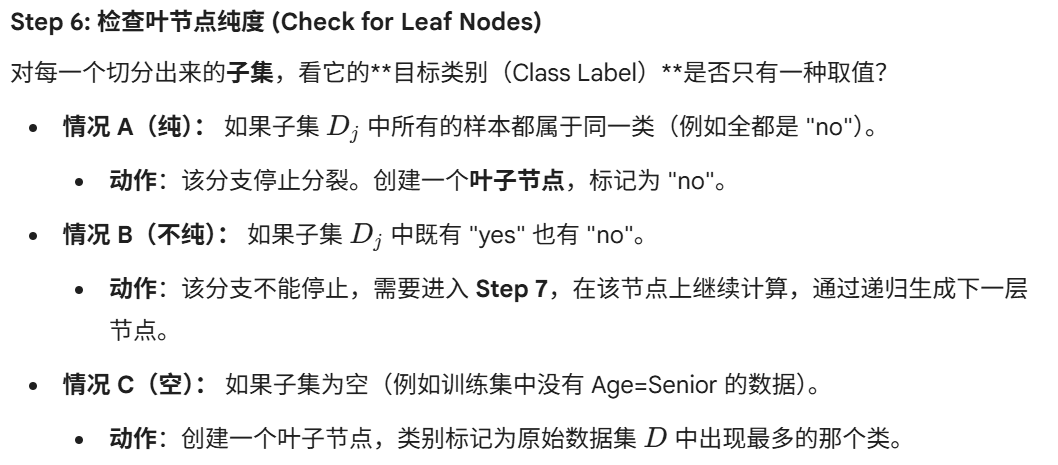
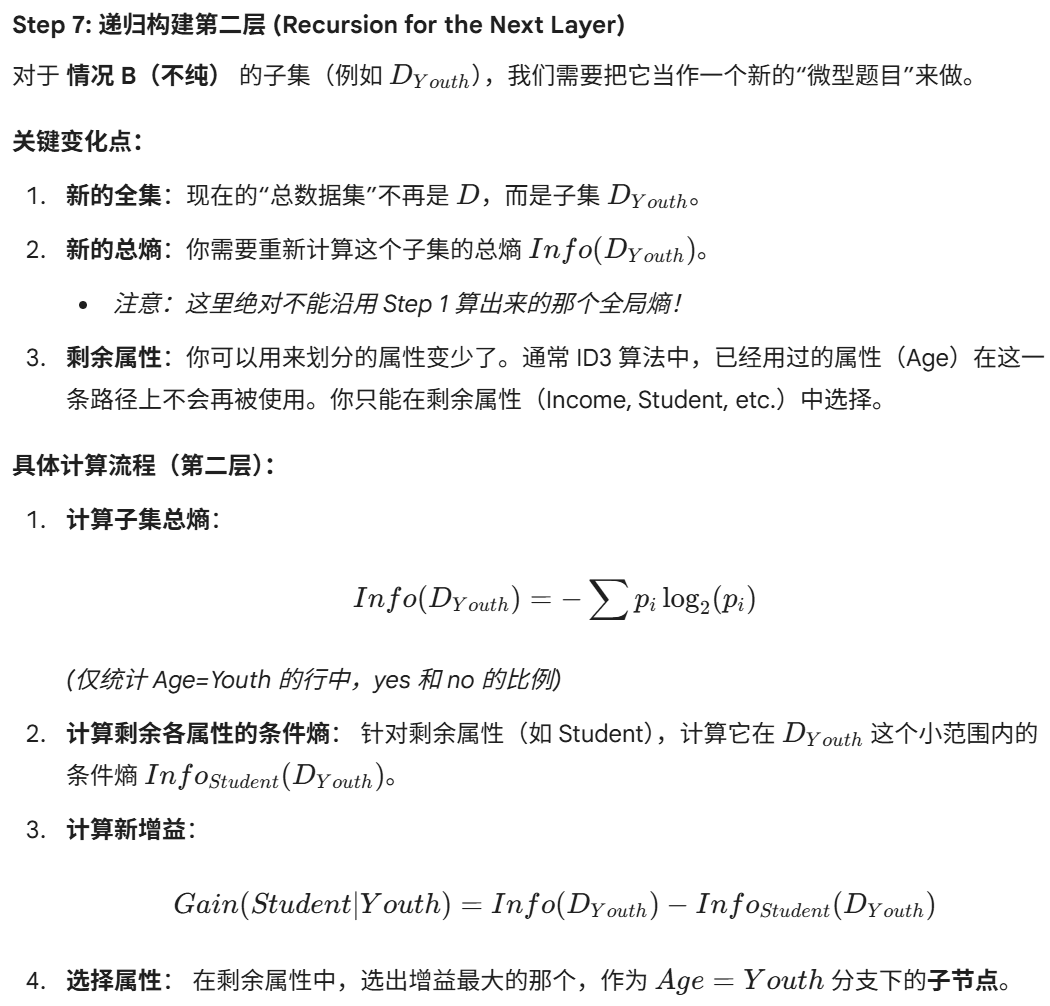
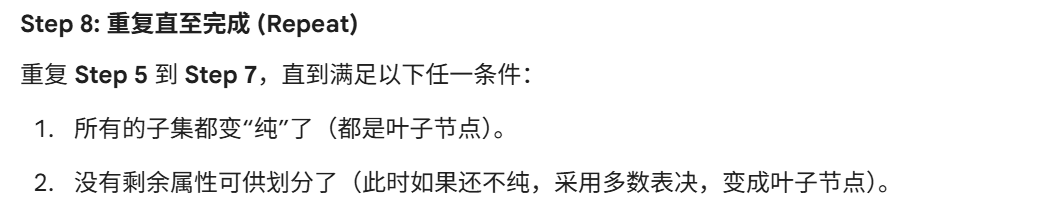
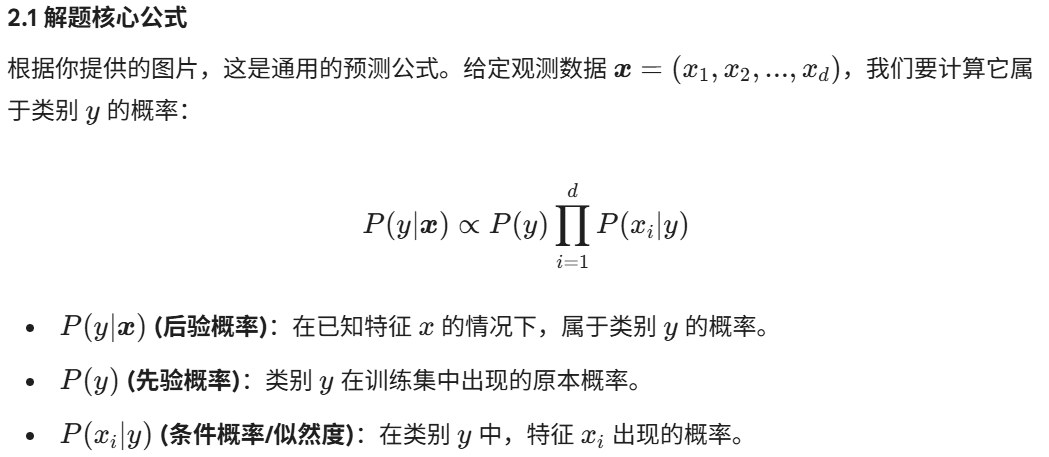
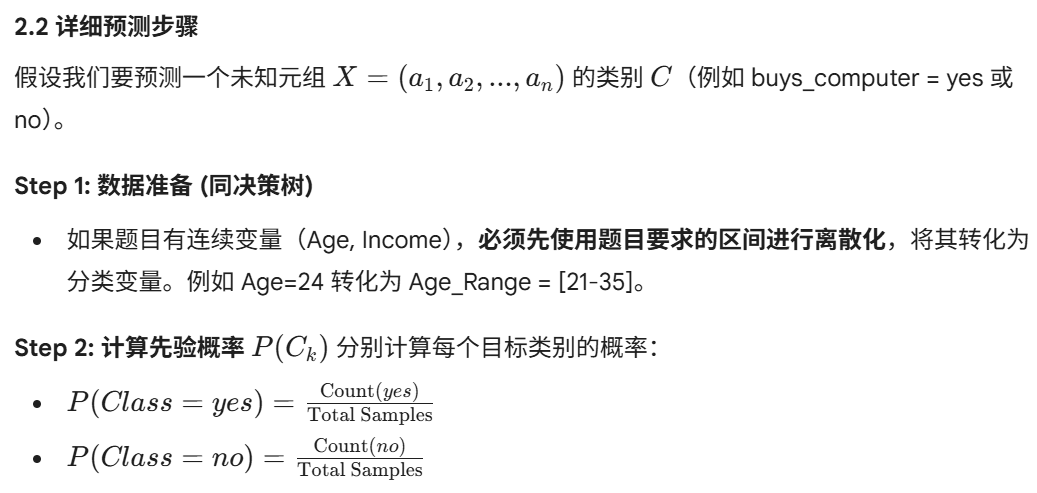
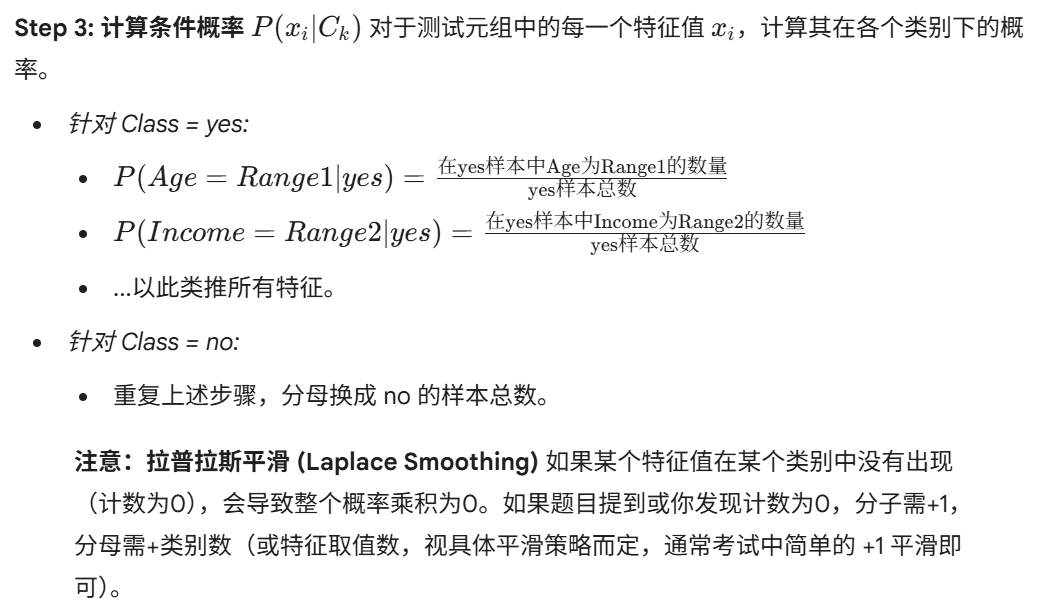
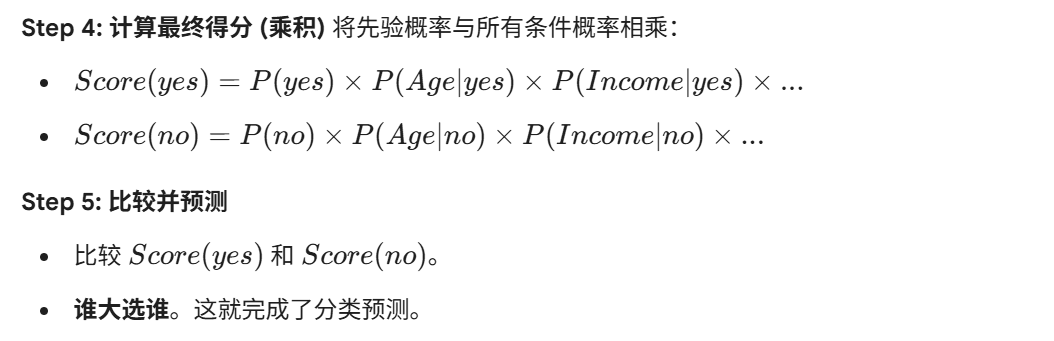
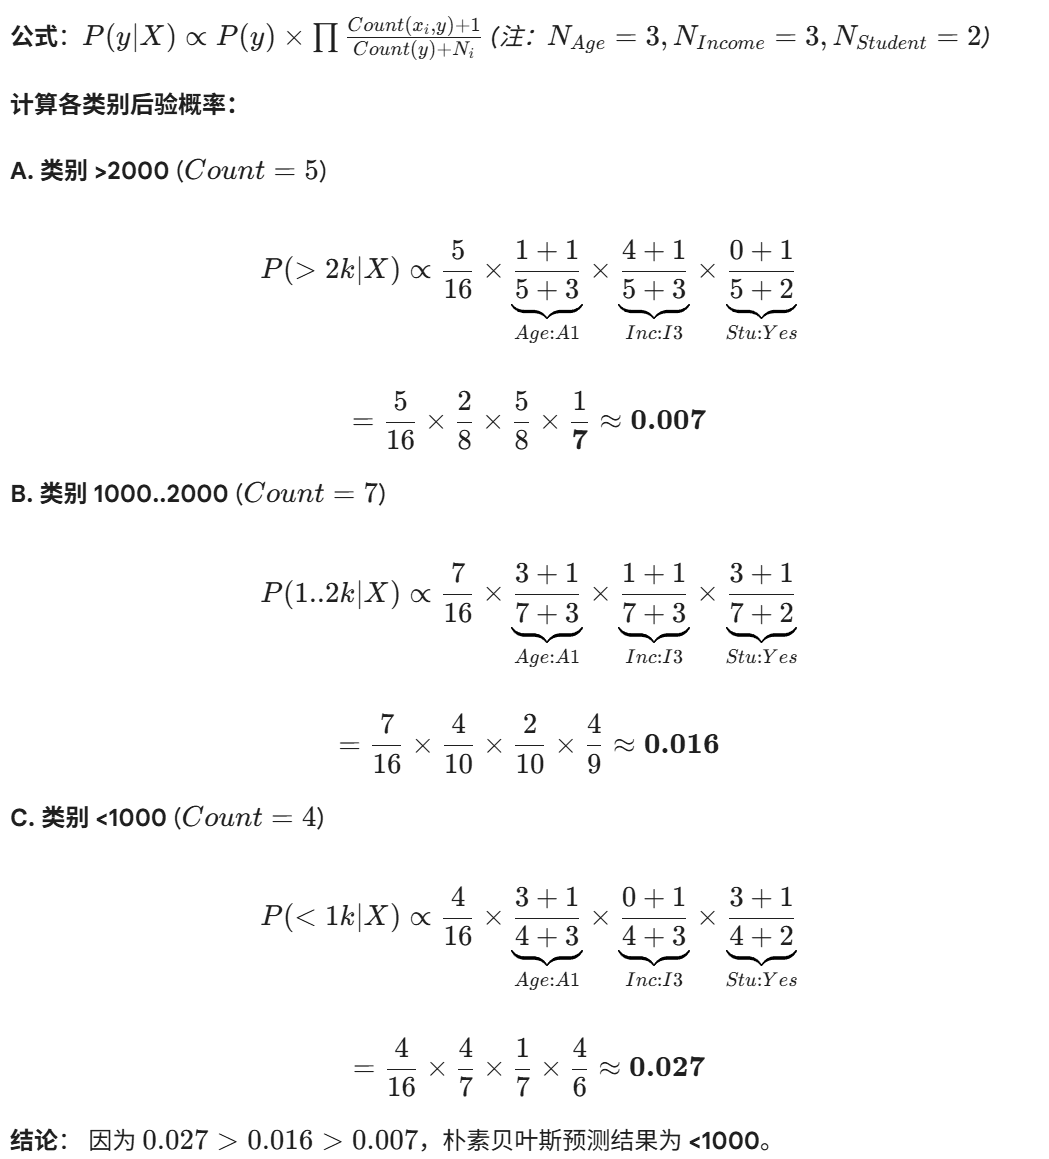
3 贝叶斯分类器
要求采用拉普拉斯修正
例题
例题1
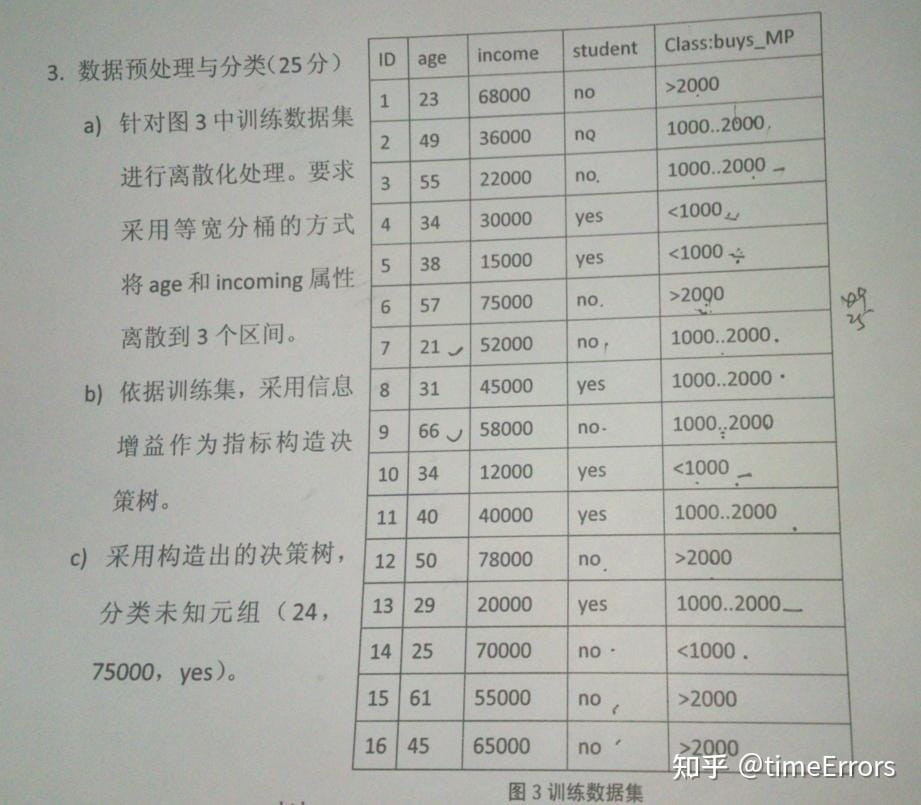
a)
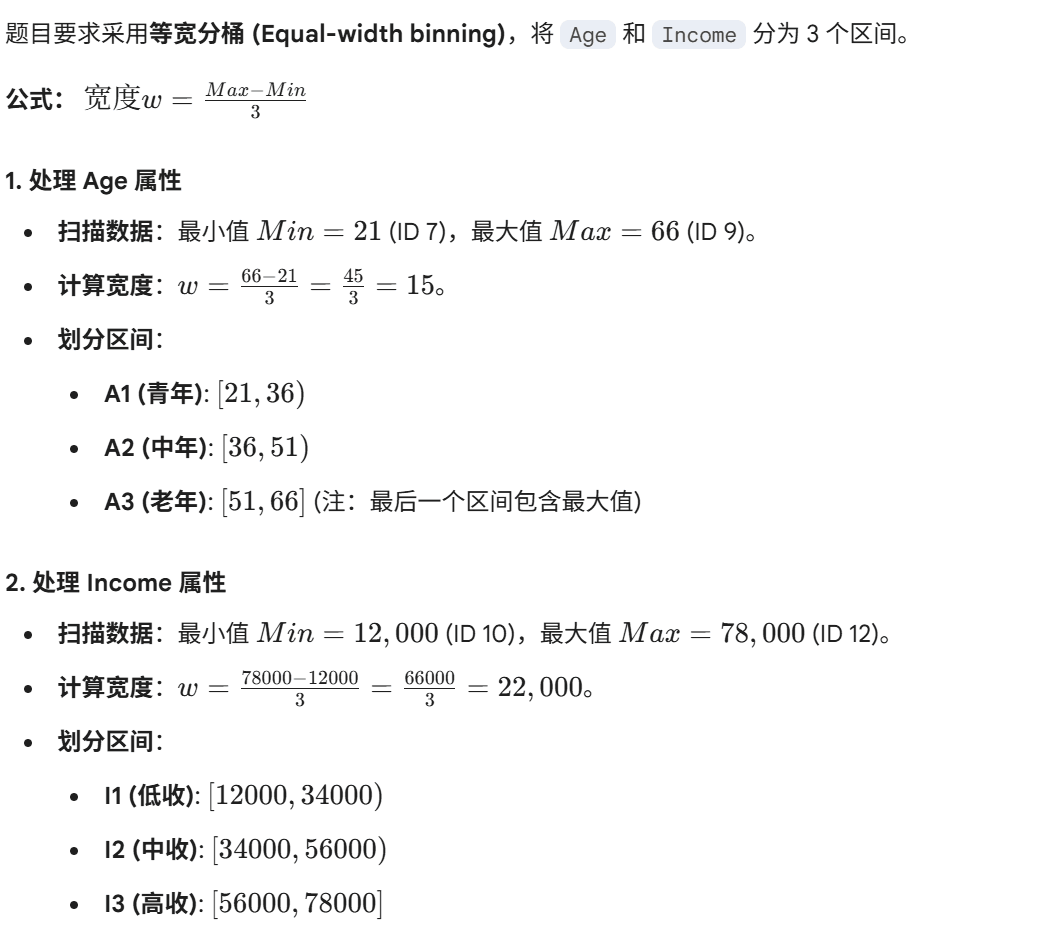
b)
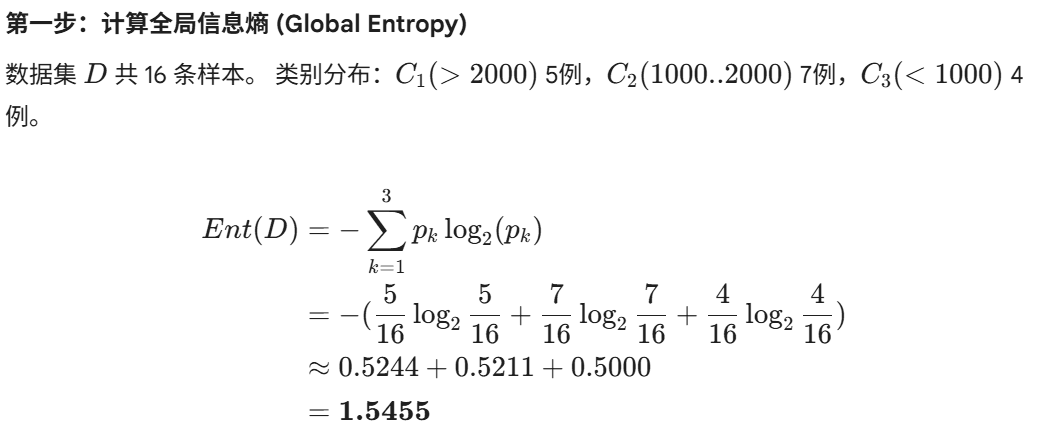
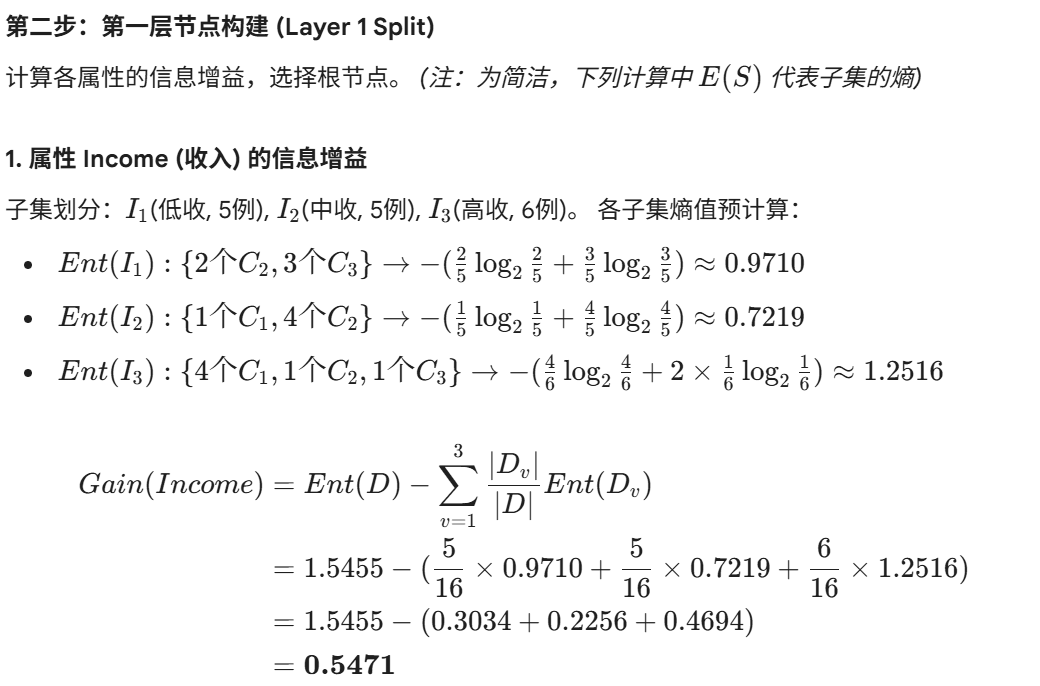
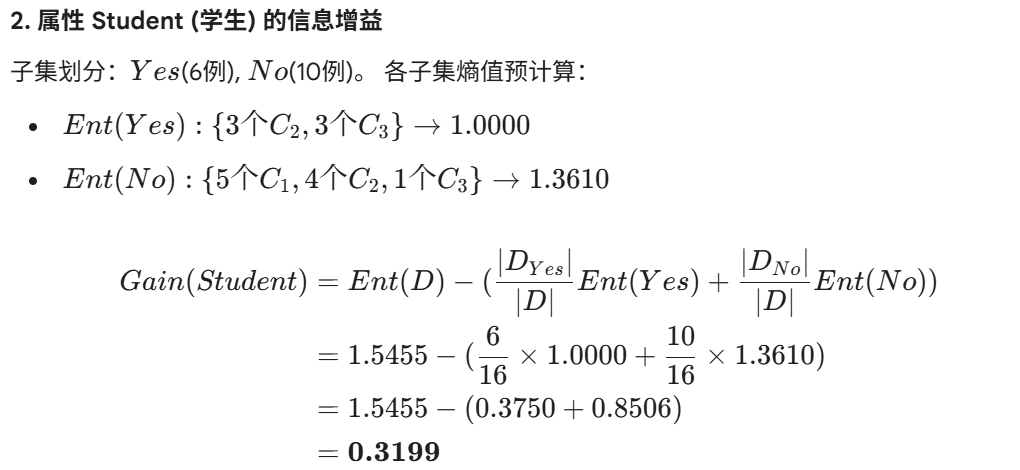
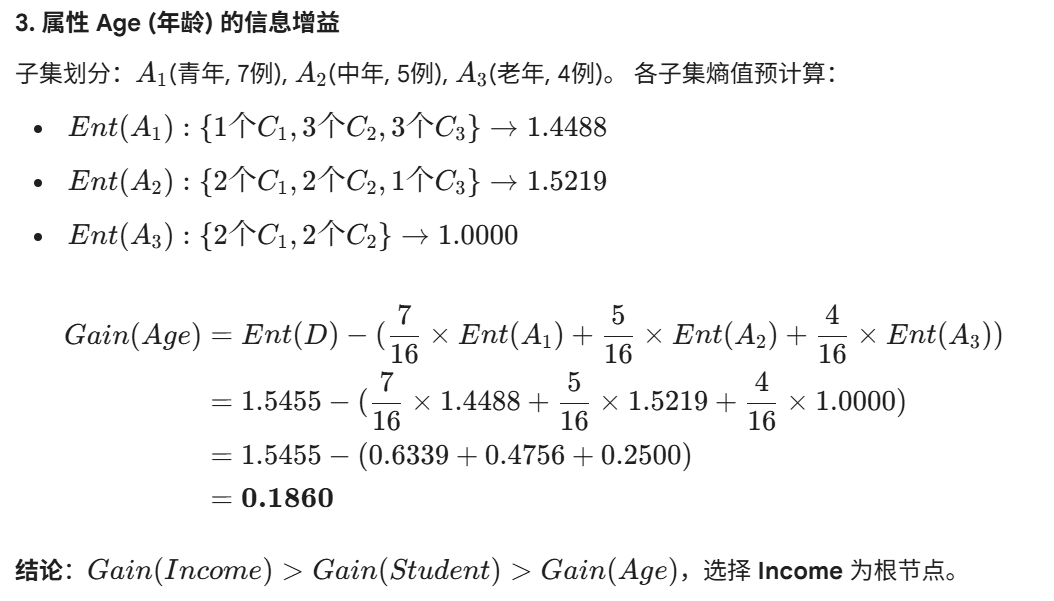
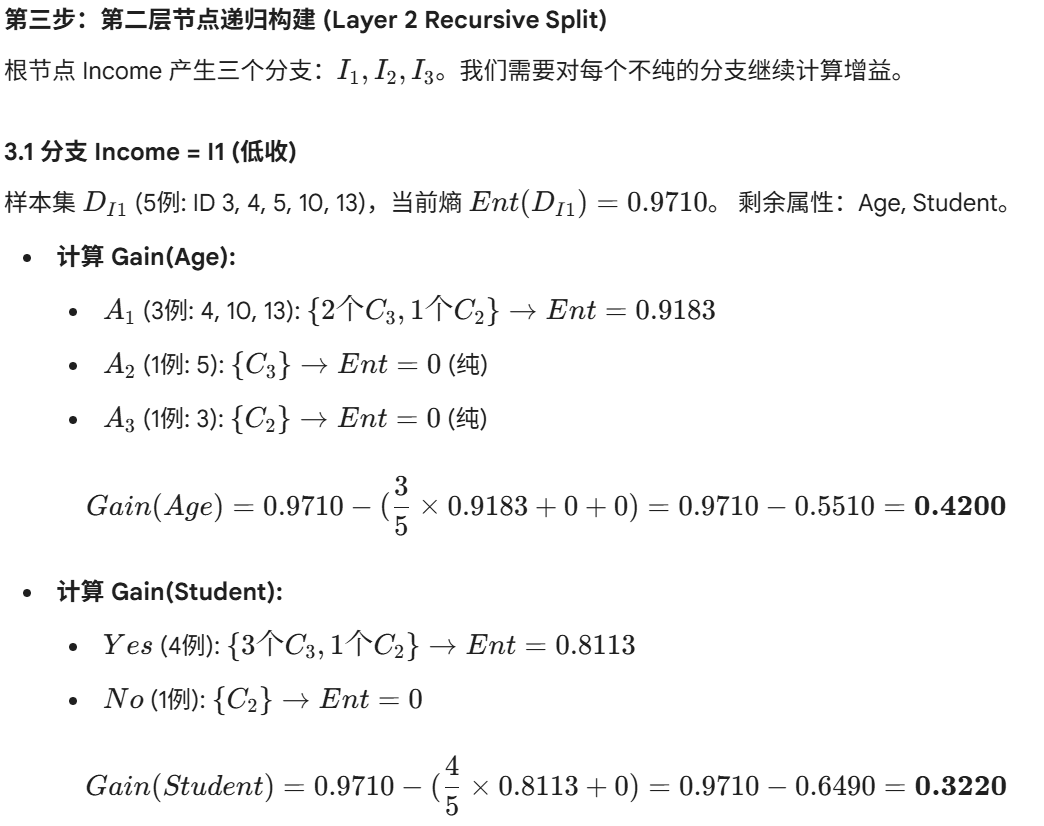
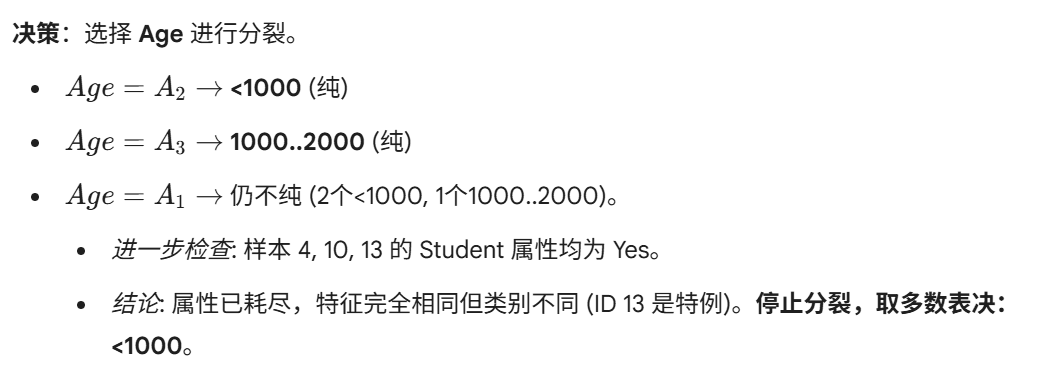
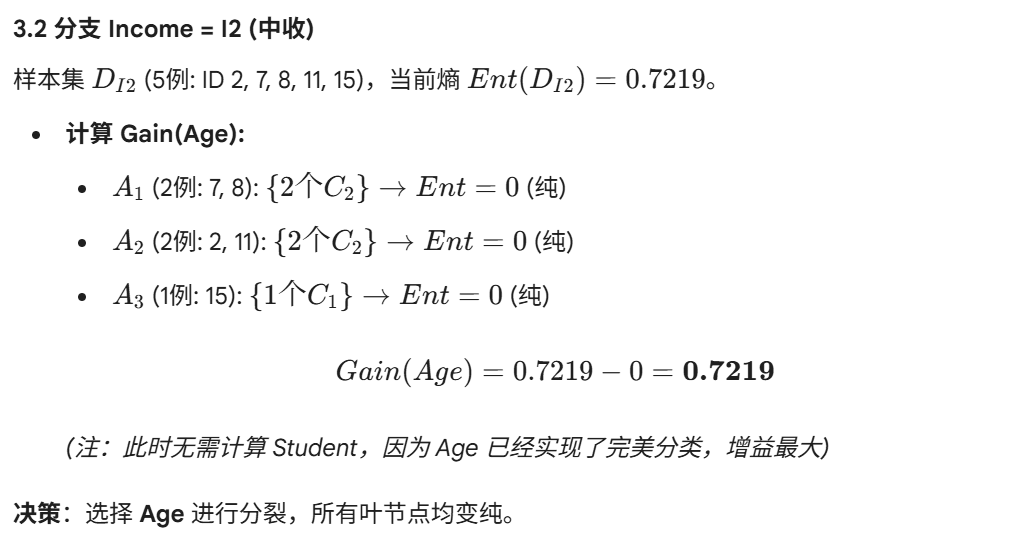
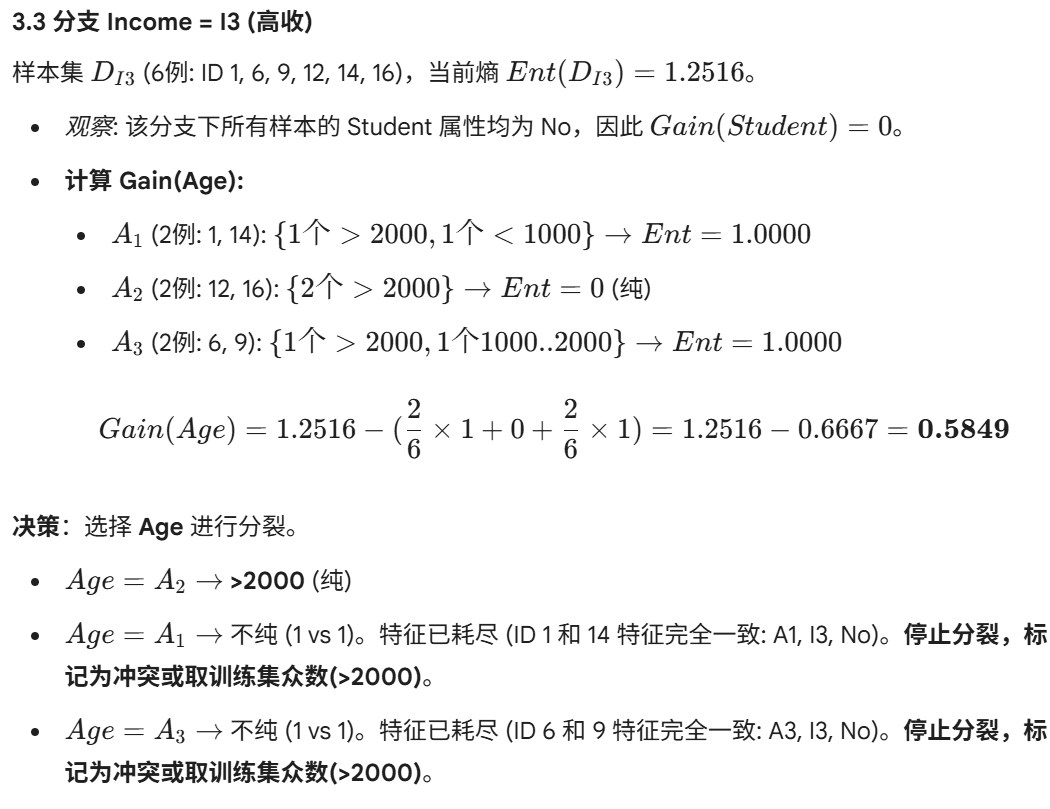
c)
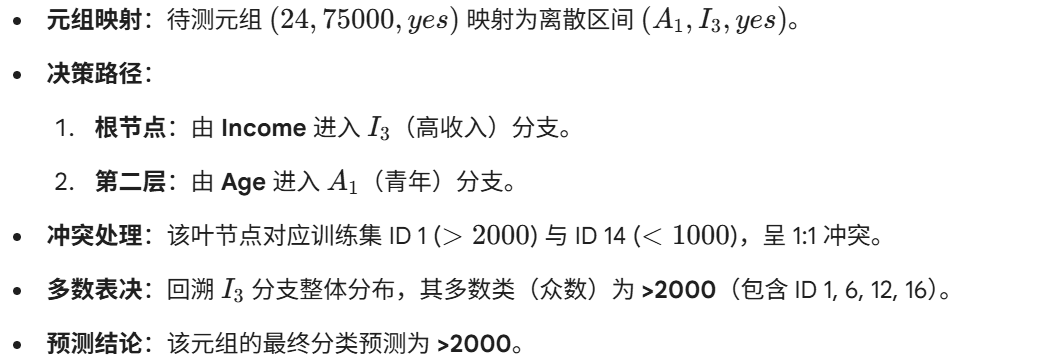
例题2
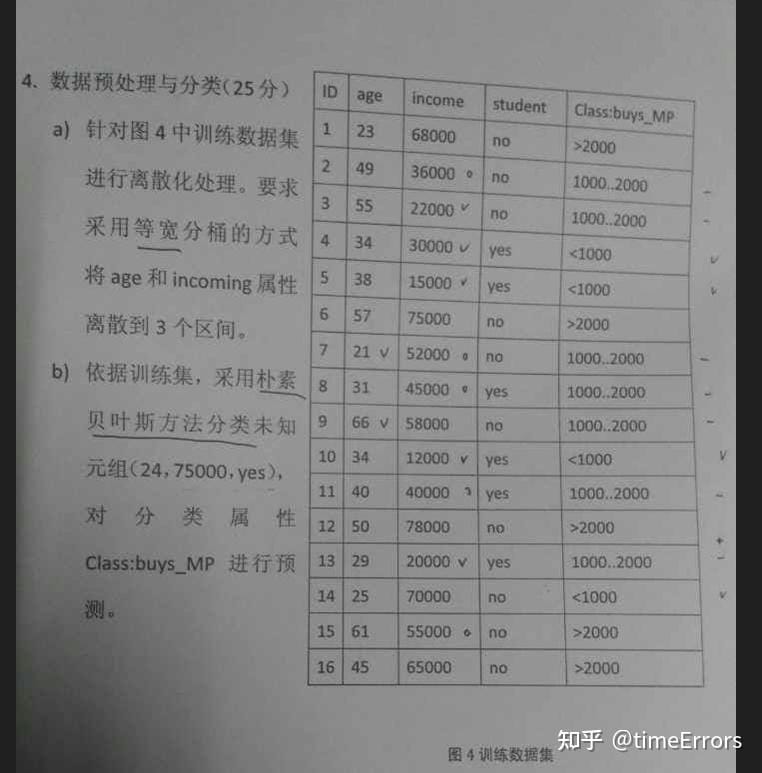
a)
与例题1相同
b)
使用拉普拉斯修正
例题3

第五题 聚类
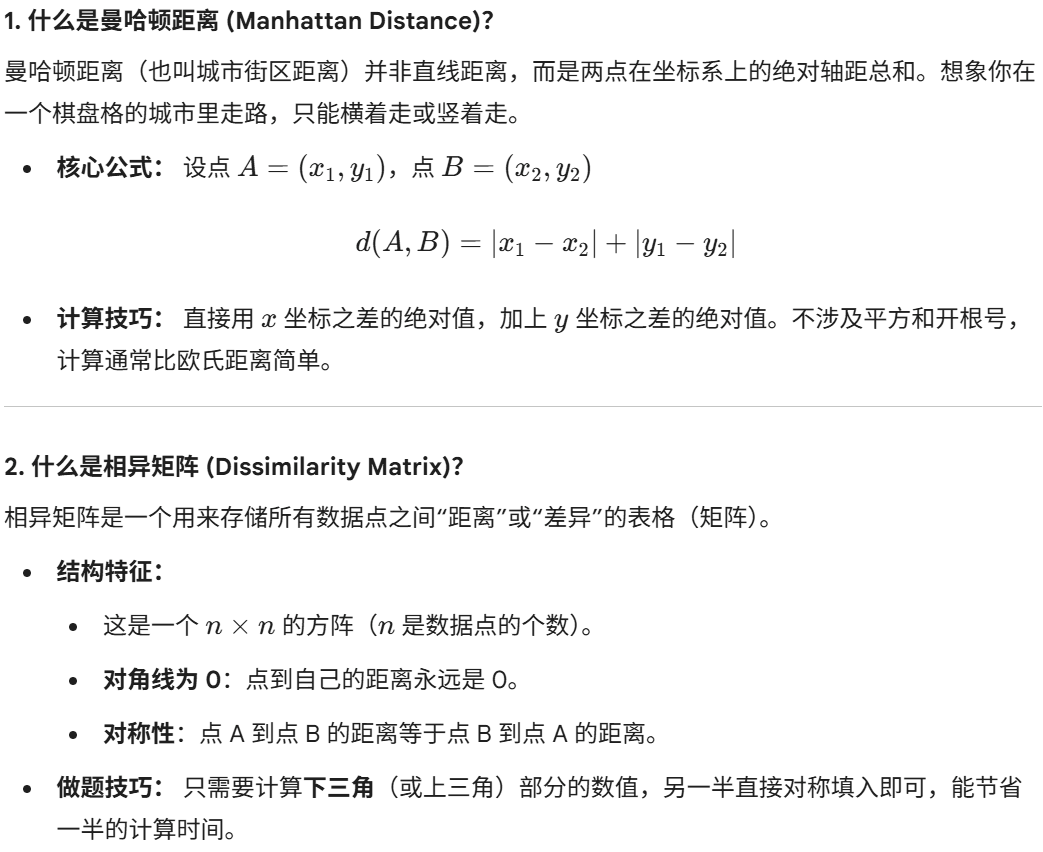
1 相异矩阵
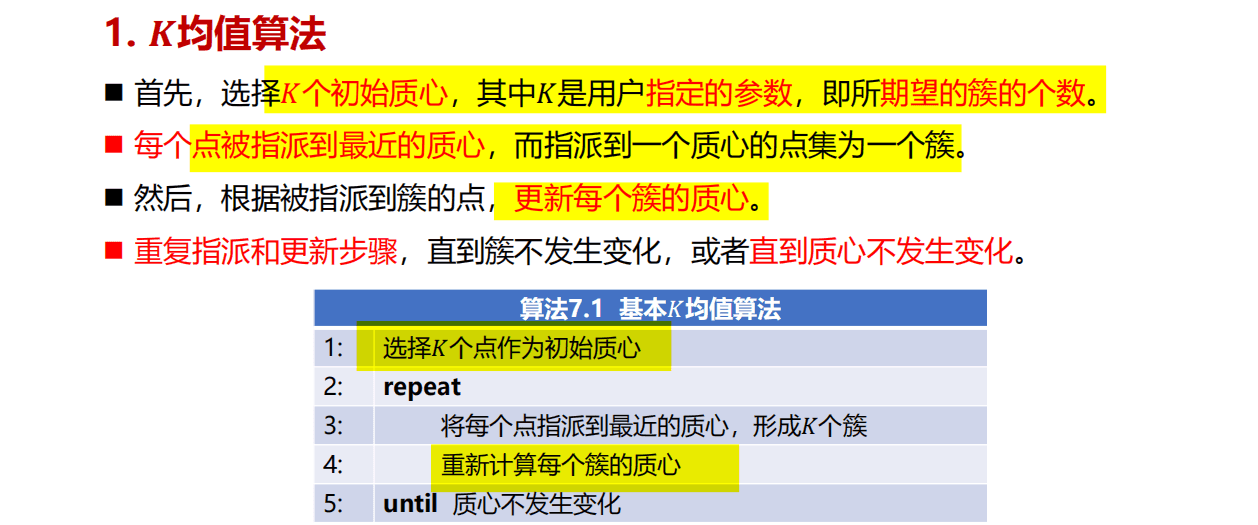
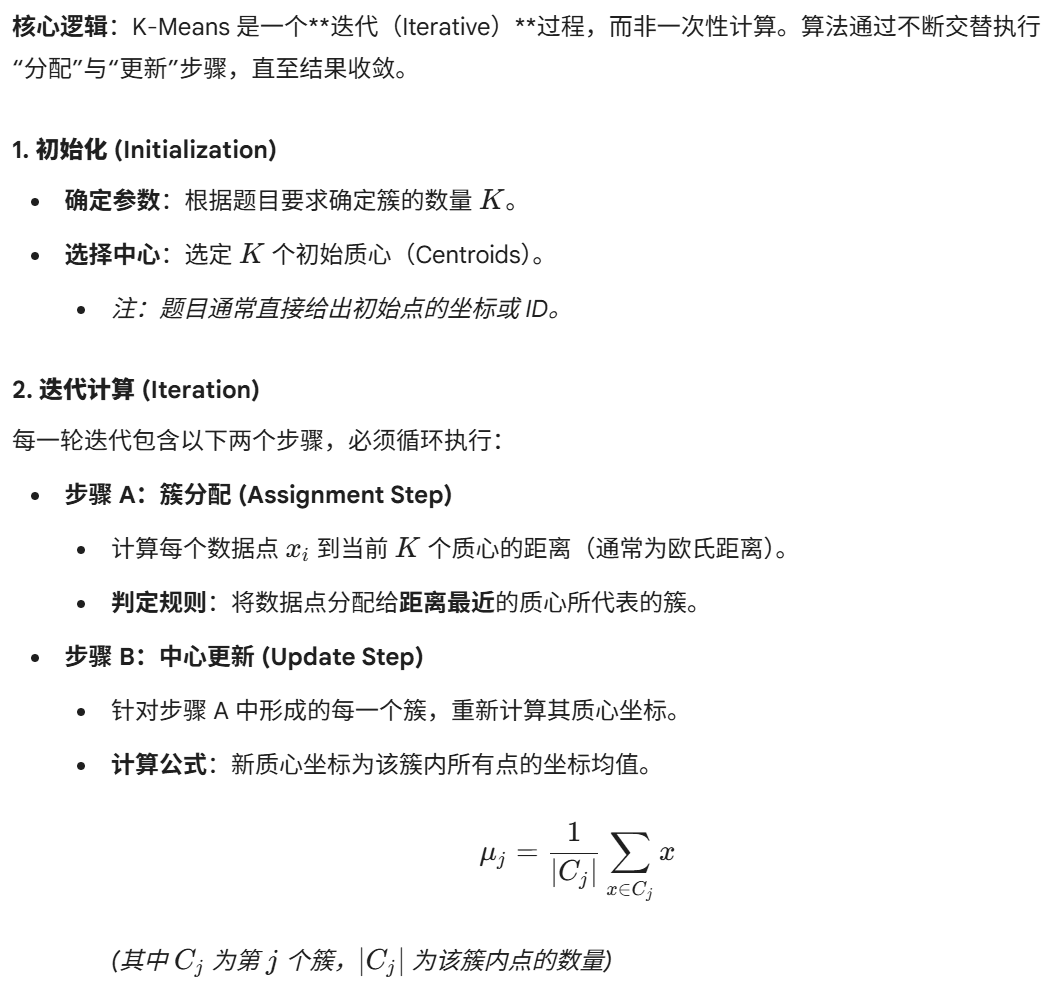
2 K-平均点方法
3 K-中心点算法
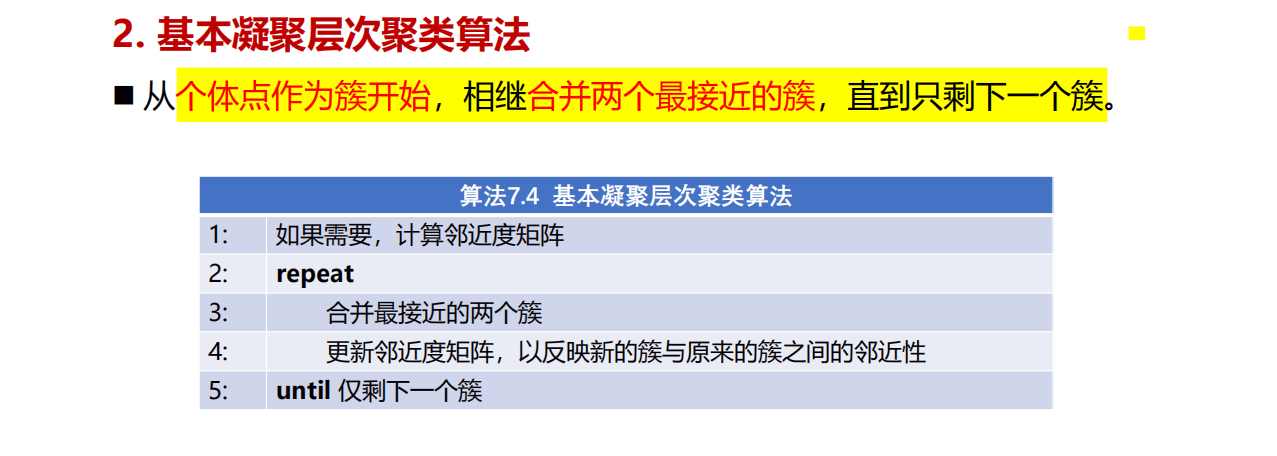
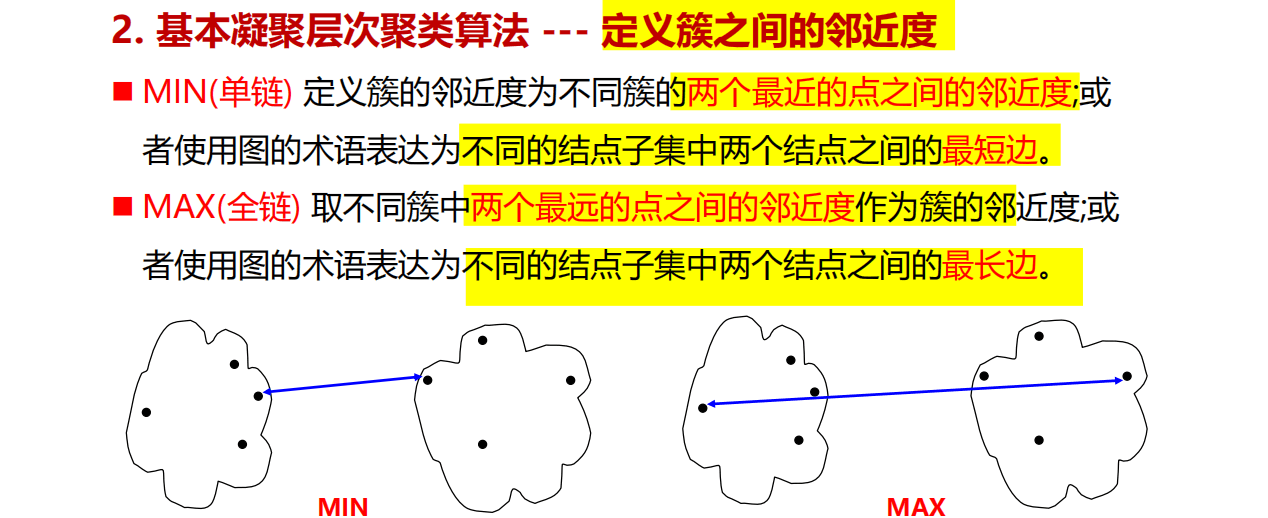
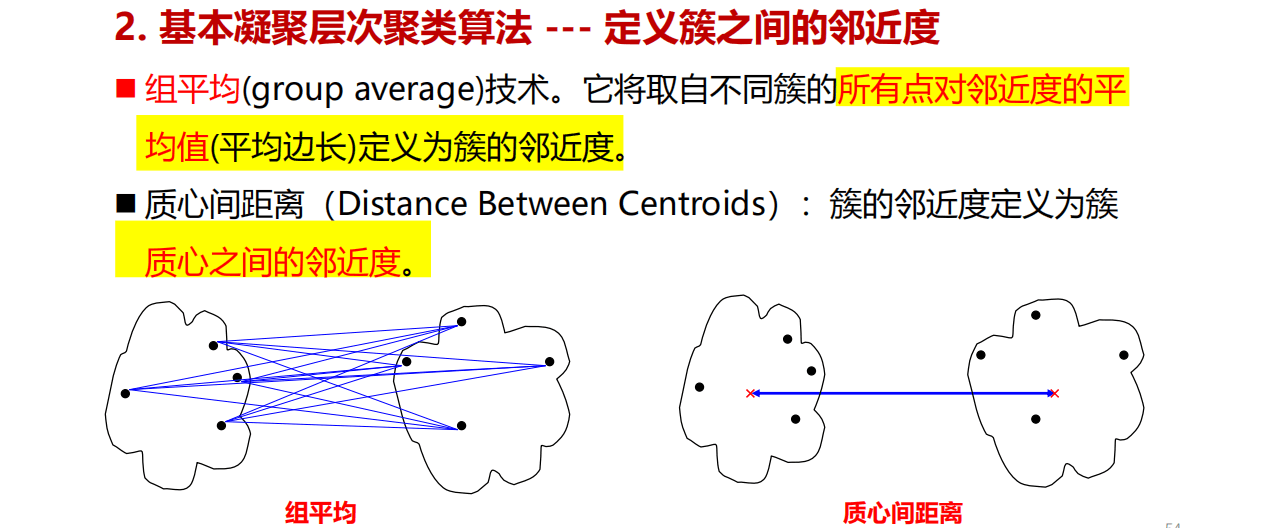
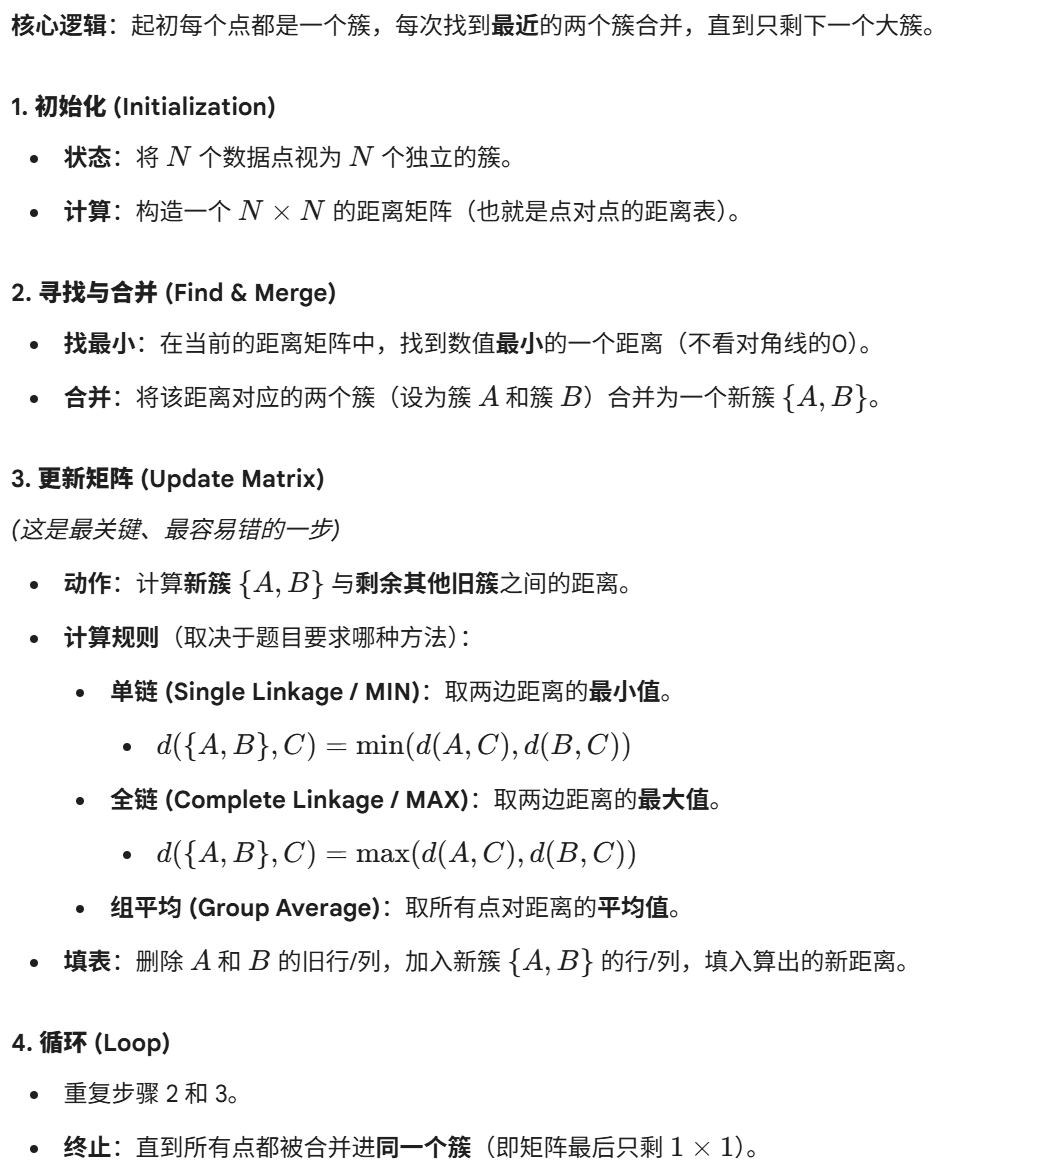
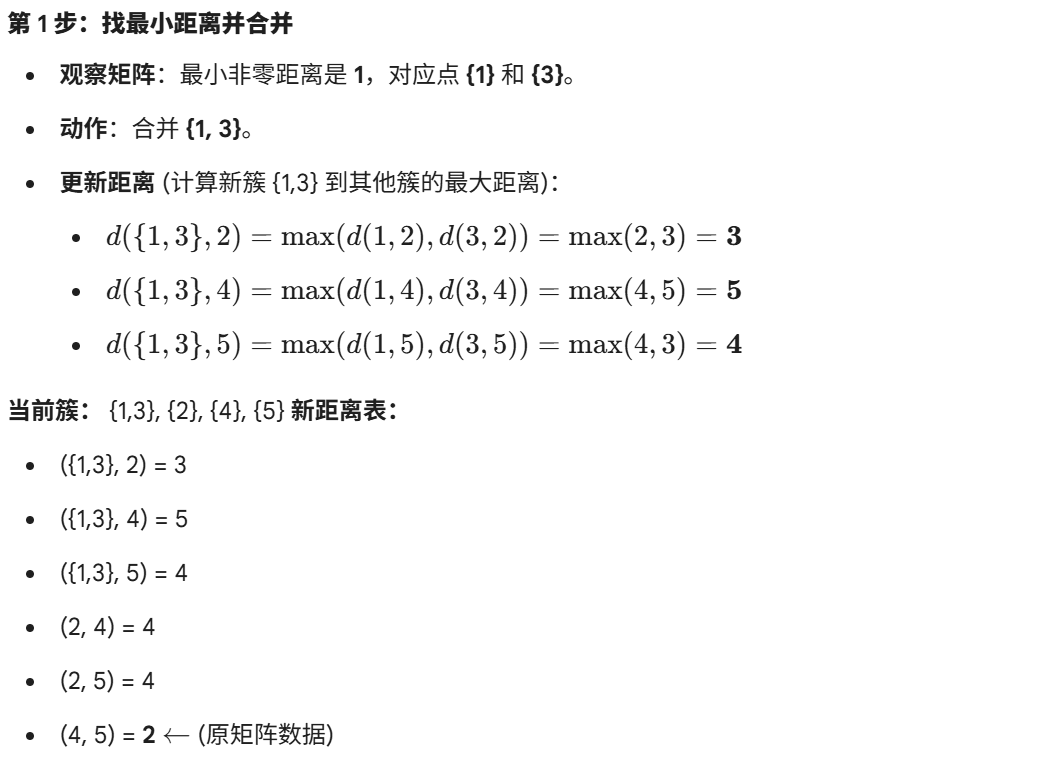
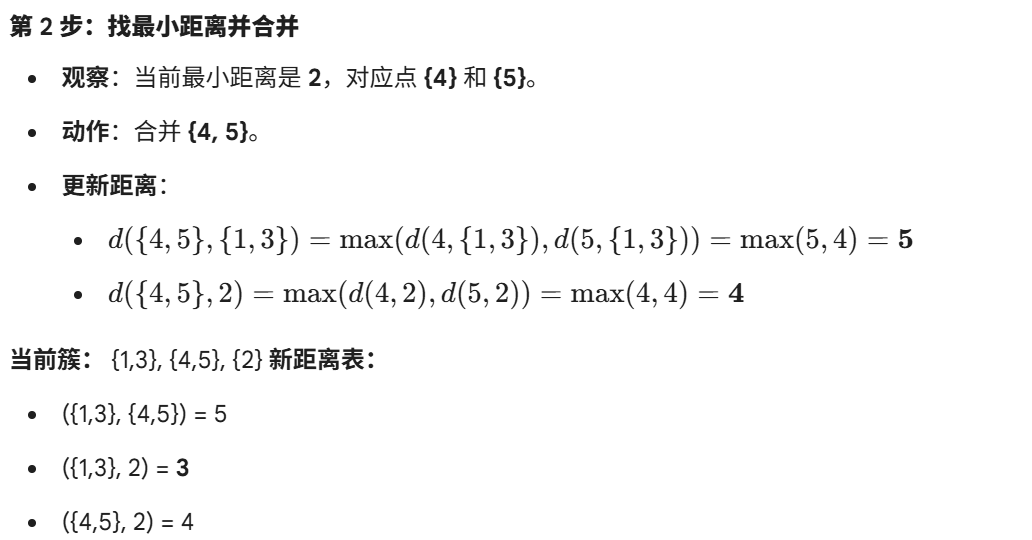
4 凝聚式层次式方法
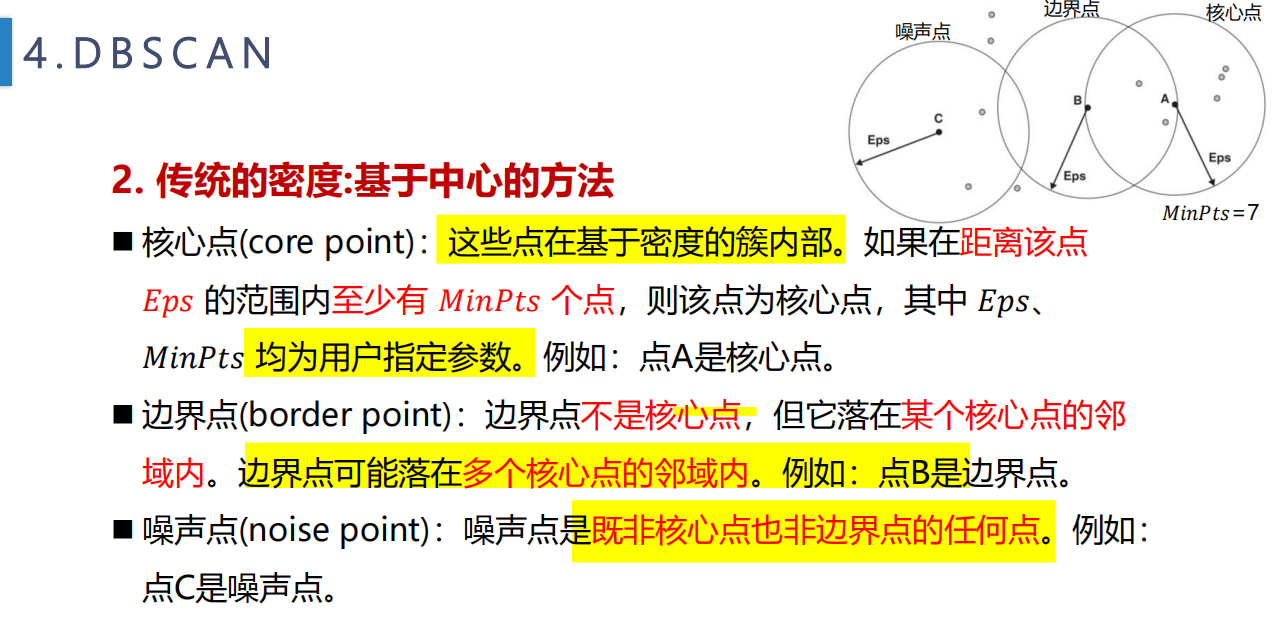
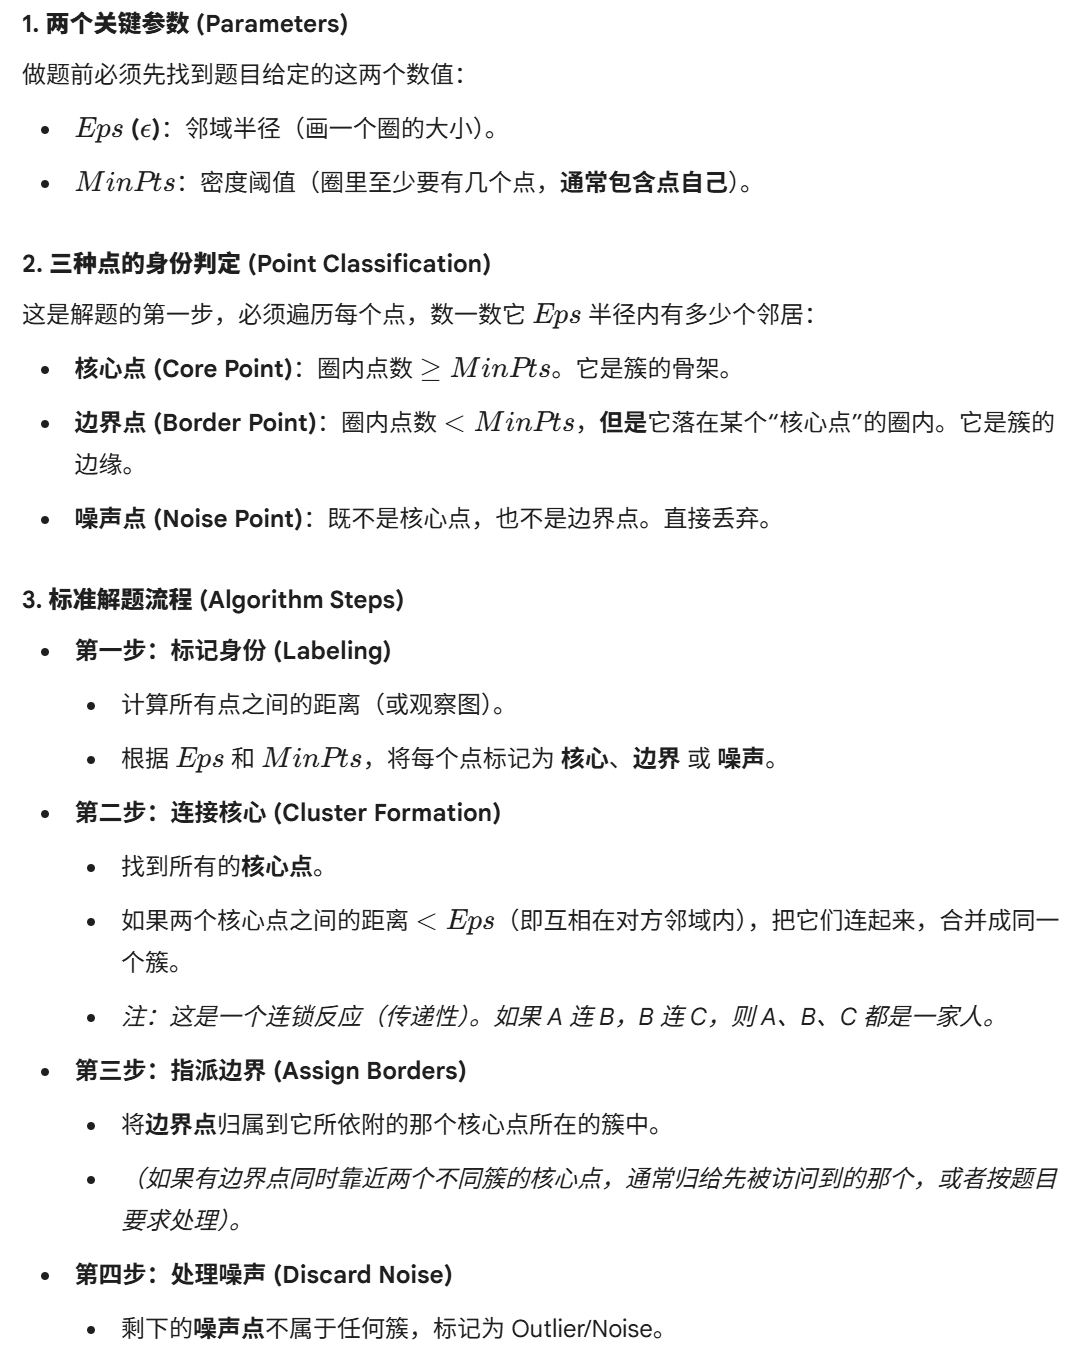
5 基于密度的方法(DBSCAN)

例题
例题1
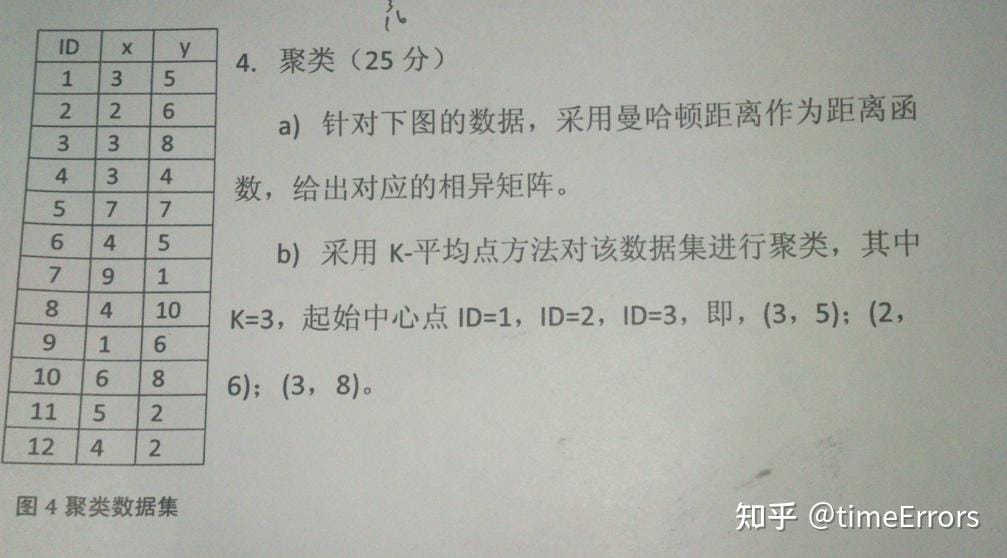
a)
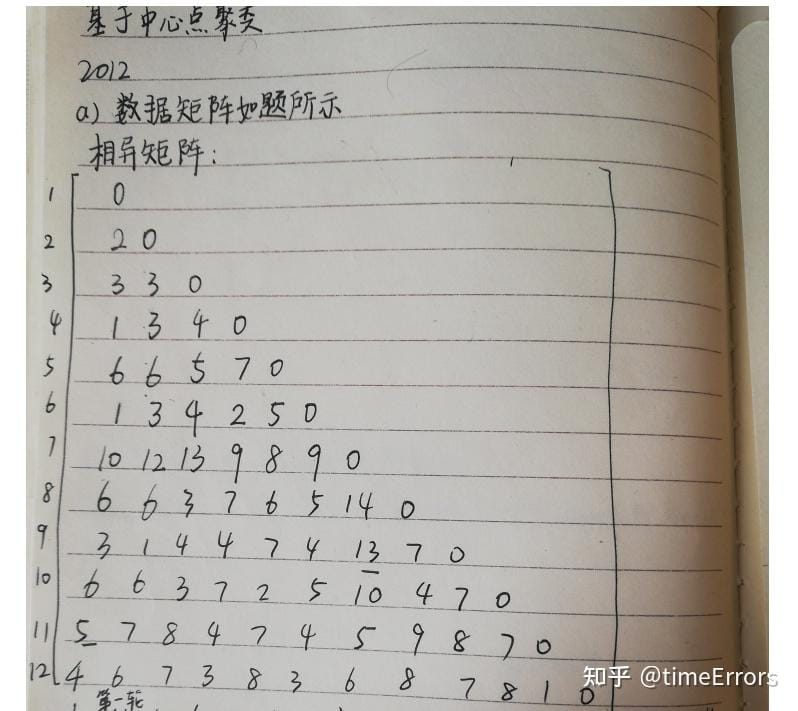
b)
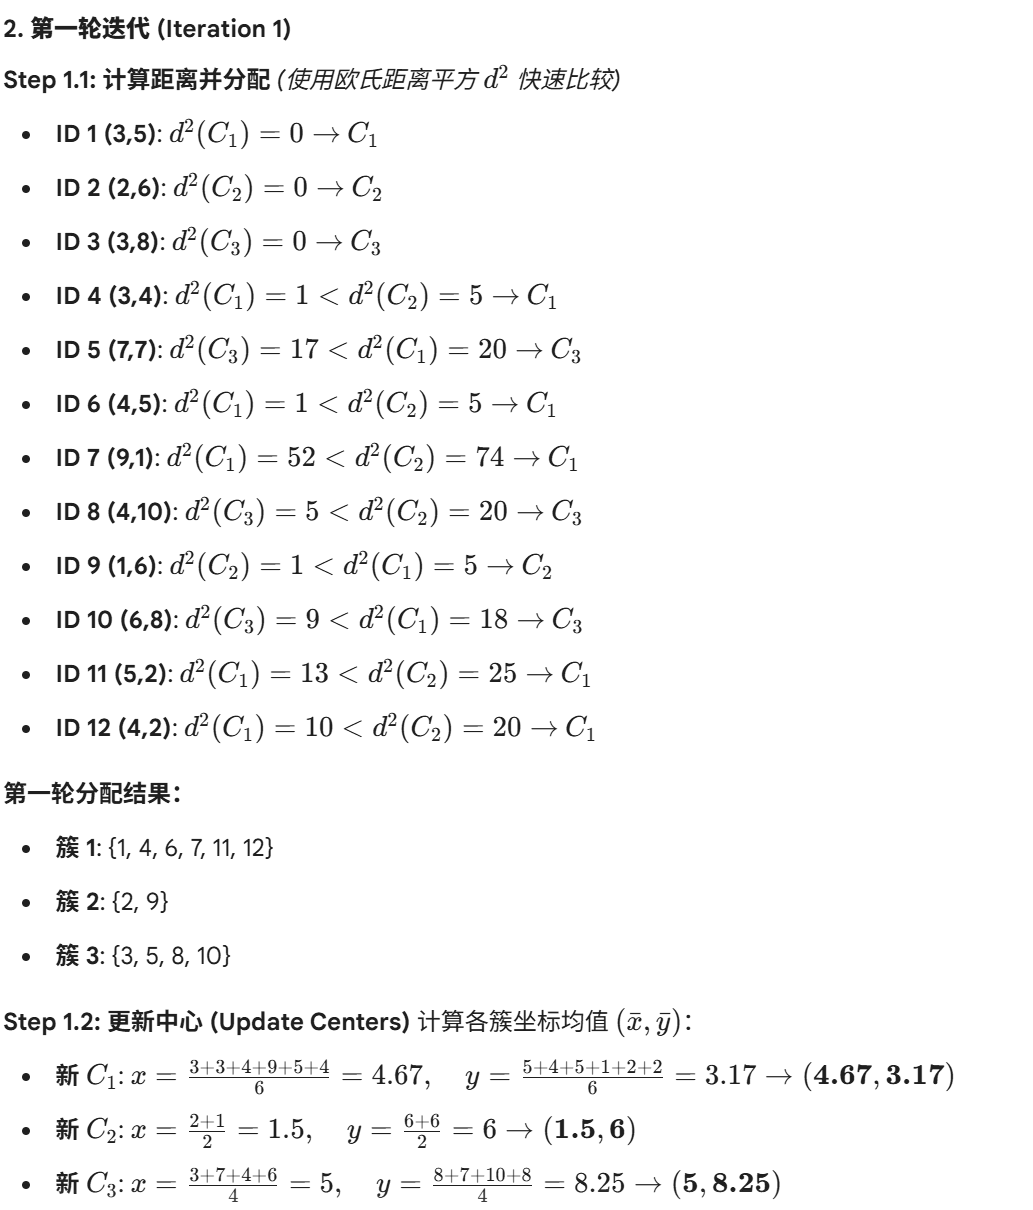
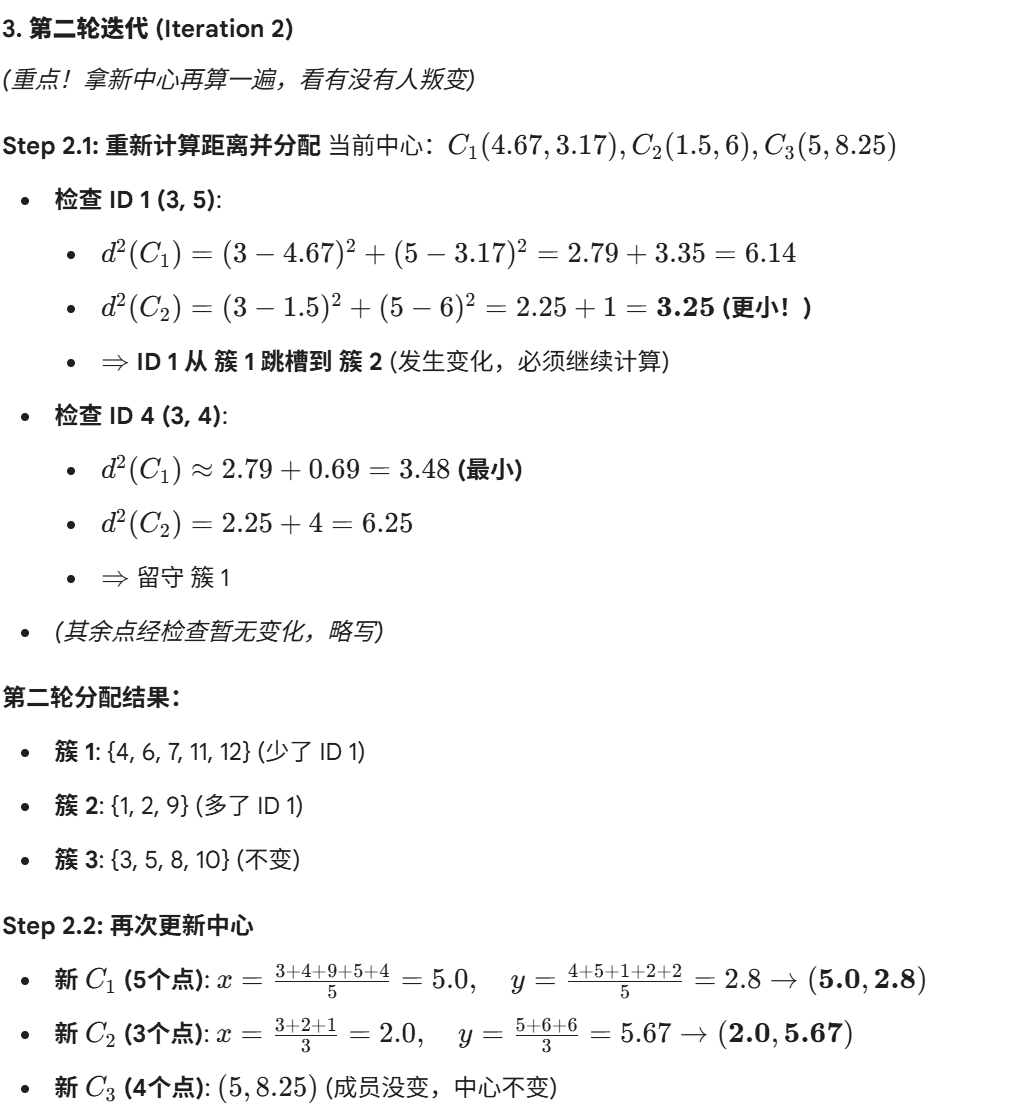
例题2
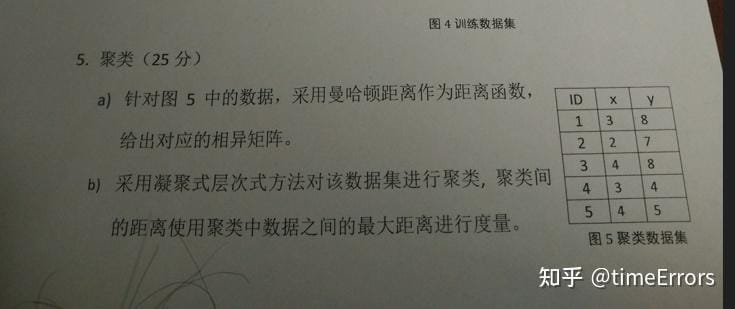
a)
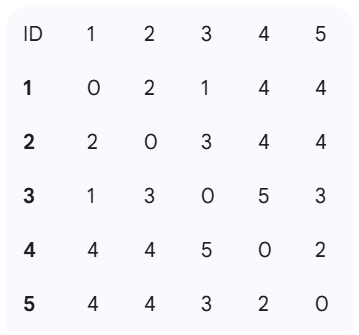
b)
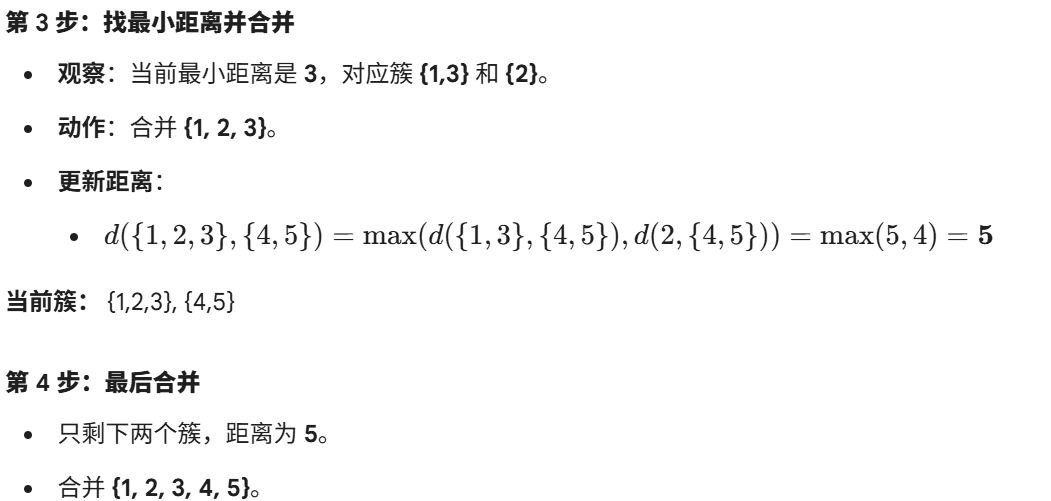
例题3
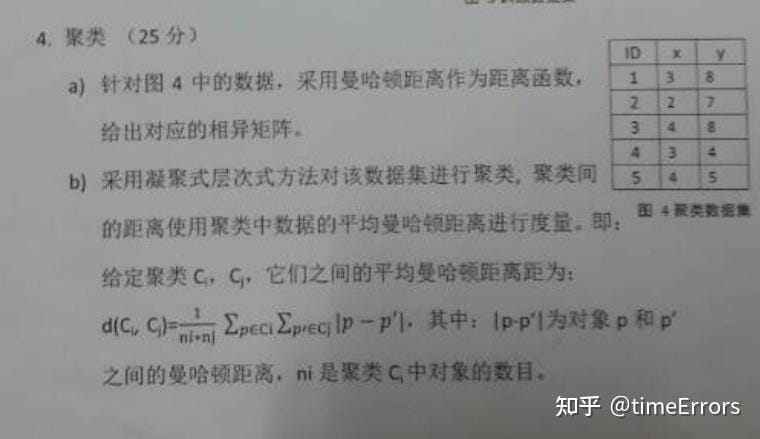
a)
与例题3相同
b)

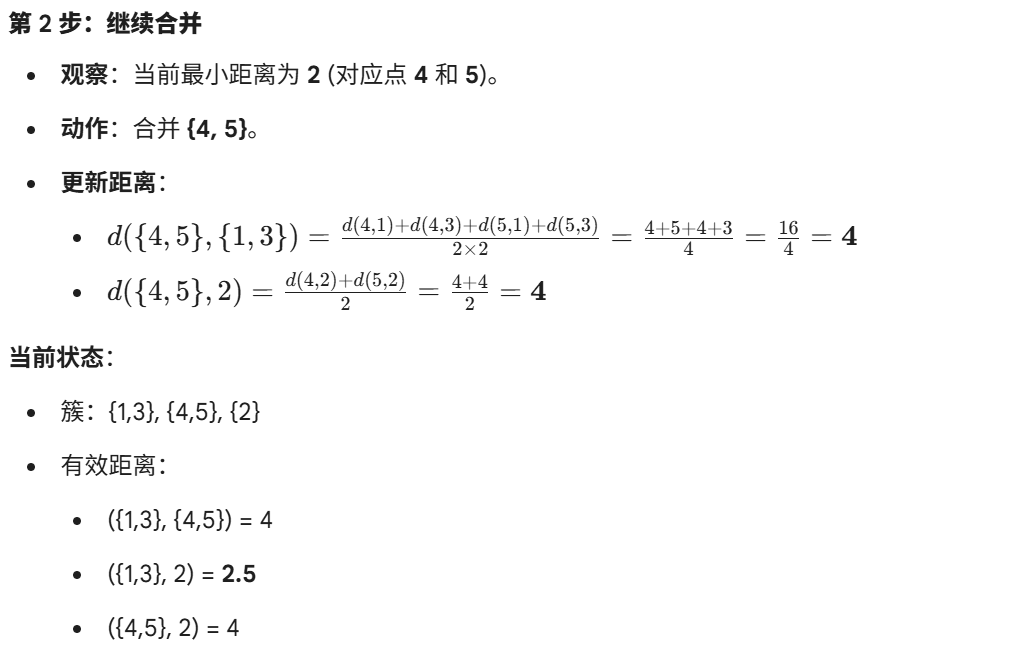
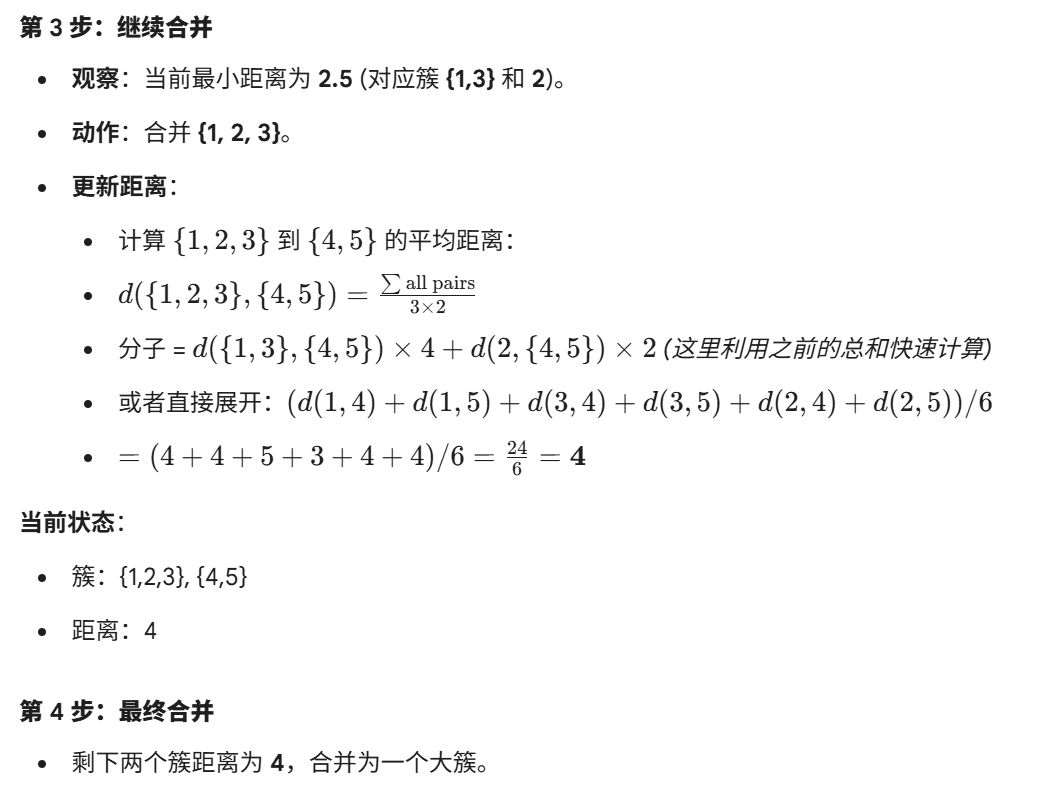
例题4
