ARC-AGI benchmark 提供了基于视觉网格的谜题,这些谜题是"对于人类简单、对于大模型困难"的问题。ARC-AGI 通过评测大模型解决这类问题的能力,来衡量大模型距通用智能的距离。
每个谜题仅提供少量示例,大模型需要基于这些示例,通过抽象推理,理解谜题的含义。(另一方面,示例较少也意味着训练数据集较少,即,ARC-AGI benchmark 不容易通过专门训练来刷点。)该 benchmark 测试模型识别 pattern 并将其快速应用于新情况的能力。
ARC-AGI 的主要评估指标是 Pass@2,它衡量模型在两次尝试内生成正确输出的能力。
示例:
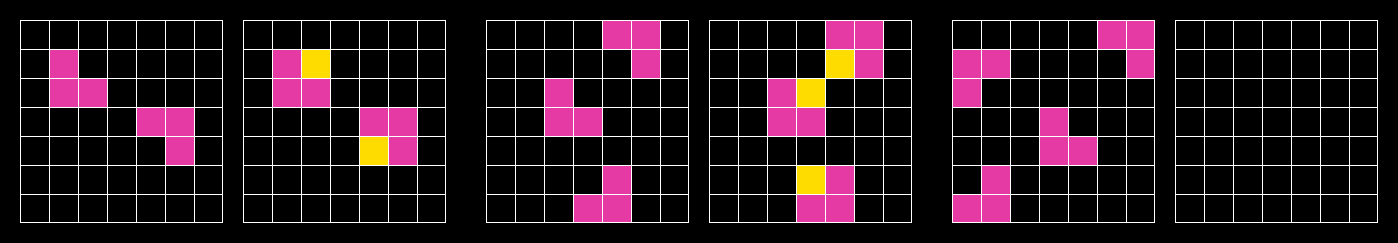
(ARC-AGI-1)
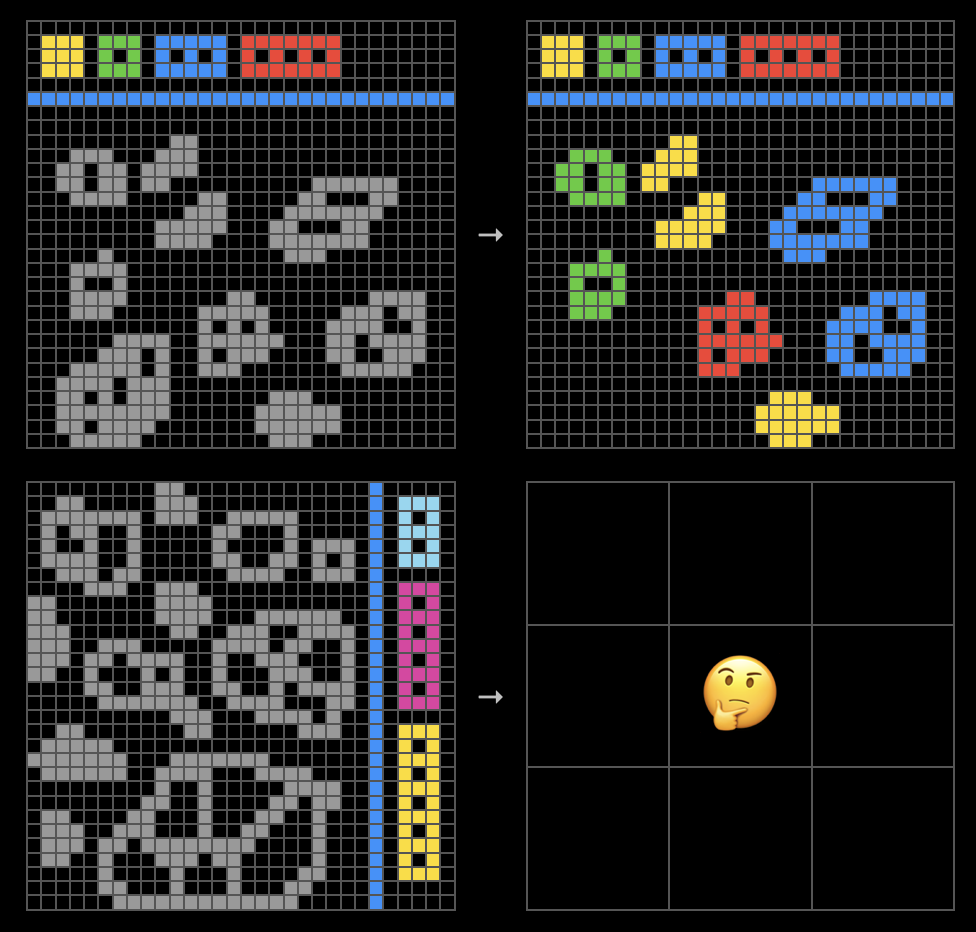
(ARC-AGI-2)
如何解决 ARC-AGI 问题?ARC-AGI 团队在 Kaggle 上发布了相关竞赛,然而,由于训练数据过少,无法训出一个用于解决 ARC-AGI 问题的模型(这个思想也与考察模型通用推理能力的初衷相悖),因此在 2024 年 GPT 等模型兴起之前,基于深度学习的方法并未取得好的结果。
根据 ARC Prize 2024: Technical Report,在 2024 年度,ARC-AGI 的求解取得突破,主要使用了以下三种方法:
- 深度学习引导的程序合成:利用深度学习模型,特别是专门的代码 LLMs,来生成解决任务的程序,或对搜索程序的过程进行指导。
- 直推模型(transductive models)在测试时训练(test-time training,TTT):在给定的 ARC-AGI 任务规范上对 LLM 进行微调,以便将 LLM 的先验知识重新组合成一个新的模型,适应当前的任务。直推模型指的是,接收输入后直接输出结果,而非输出一个程序。
- 将程序合成与直推模型相结合:将上述两种方法合并为一个超级方法,因为据观察,这两种方法擅长解决不同类型的任务。
ARC-AGI 任务的官网:https://arcprize.org/
ARC-AGI-1/2/3 :
ARC-AGI-1/2 的榜单:https://arcprize.org/leaderboard
ARC Prize 2024: Technical Report:https://arxiv.org/html/2412.04604v1
相关博客:
- 像 AI 写的神秘博客:https://labs.adaline.ai/p/what-is-the-arc-agi-benchmark-and
- 知乎 · 机器之心 |「压缩即智能」得到实验验证,无需预训练和大量数据就能解决 ARC-AGI 问题:https://zhuanlan.zhihu.com/p/30426666081
- 知乎 | ARC-AGI 测试集对人工智能来说难在哪里?https://www.zhihu.com/question/7955529556/answer/65269819236