小白的RAG缓存

RAG流程:

  1. 用户提问(q)

  2. 对q做处理(重写 \ 查询扩展 \ 向量化)

  3. 向量库检索(向量相似度匹配)

  4. 将q+选出的文档片段组合成prompt

  5. 调用大模型回答a

1.完整问答缓存(q → a cache)

将每个q标准化以后,与对应的a做匹配后存入缓存,当用户再问同样的问题后直接返回与其对应的a

key : q问题(标准化后的问题)

value :模型返回的答案

2. 近似问题缓存
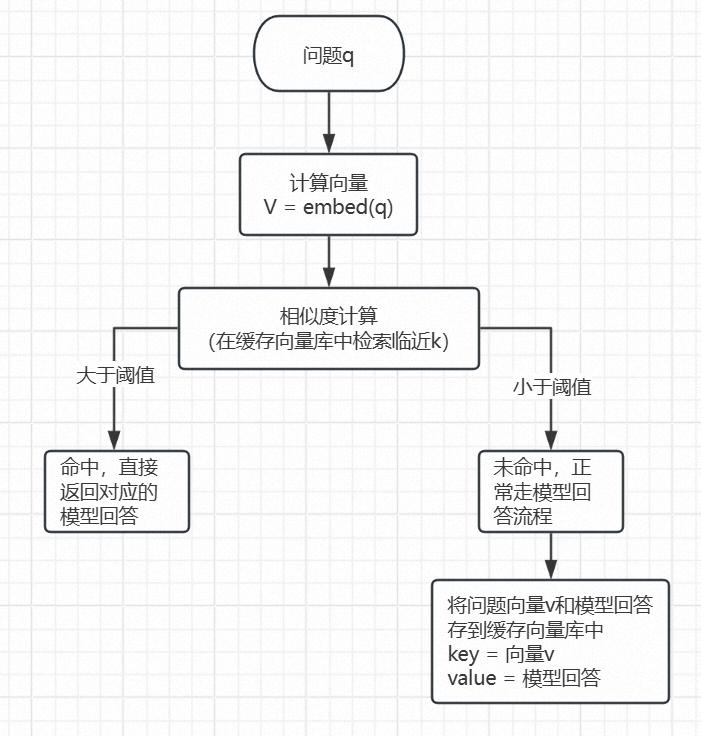
3. 检索结果缓存
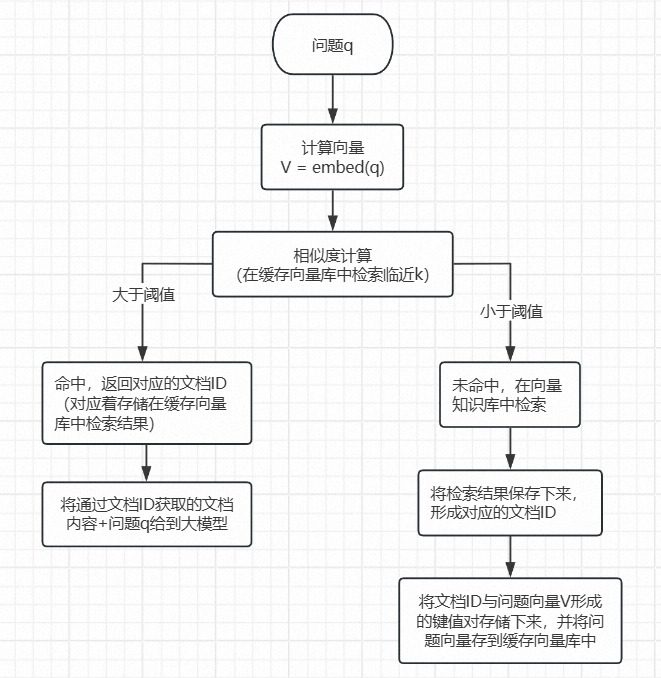
相关推荐
七夜zippoe6 分钟前
Agent 错误处理体系:分类、重试、降级与熔断设计
ai·agent·降级·错误处理·熔断设计
VIP_CQCRE19 分钟前
内容自动化越跑越乱?先补上状态、去重和失败恢复
python·ai·工作流·幂等设计·内容自动化
真上帝的左手1 小时前
30. 技术专题-‌应用框架组件-缓存-Redis
数据库·redis·分布式·缓存·中间件
GJGCY1 小时前
券商舆情智能体如何设计?事件聚类去重、主体消歧与风险事件抽取技术解析
经验分享·ai·金融·自动化·证券·智能体
whyutianict_vv1 小时前
零基础转 AI 运维:投入清单、技术路线与核对表
linux·运维·人工智能·ai
西安小哥2 小时前
大模型 Agent 做日常任务,卡住的从来不是模型能力
aigc
bksczm2 小时前
C++Redis开发(Ubuntu 22.04)
数据库·redis·缓存
goehou2 小时前
缓存该删还是该改,LLM 服务里的双写问题
redis·缓存·llm·一致性·系统设计
HKT_China2 小时前
香港电讯河套区创新科技中心暨AI机楼揭幕,以网络基建助力北部都会区发展
网络·ai
全栈练习生3 小时前
大模型原理之自适应推理
python·ai