强化学习与思维链

一. 强化学习

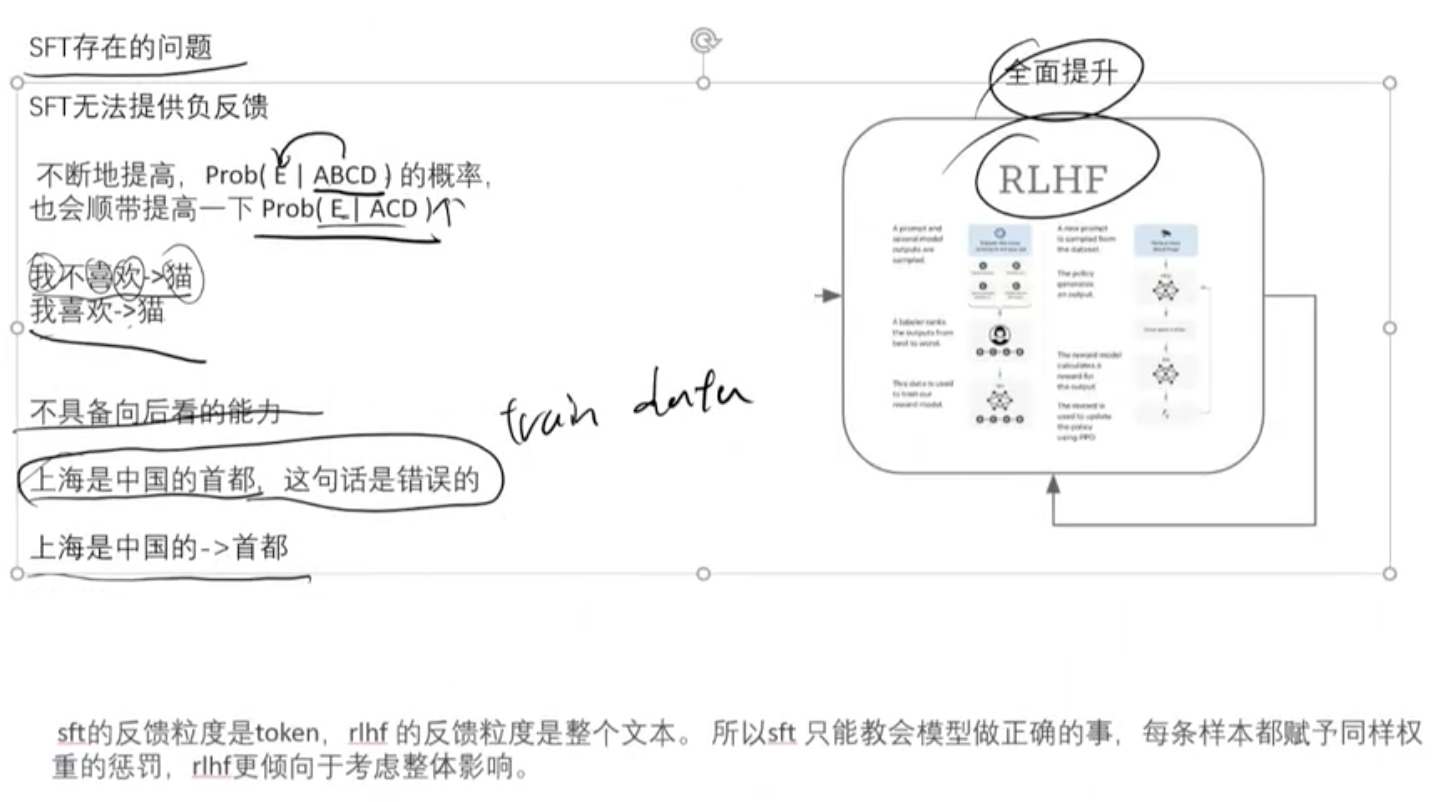
1.SFT与强化学习

2.RM(奖励模型)

ORM(结果奖励):标注困难,成本高

PRM(过程奖励): 简单, 但存在结果对, 过程错的情况。

  1. 奖励方法:

基于规则 (Rule-based Rewards)的奖励, deepseek

基于模型(Reward Model)的奖励, openai

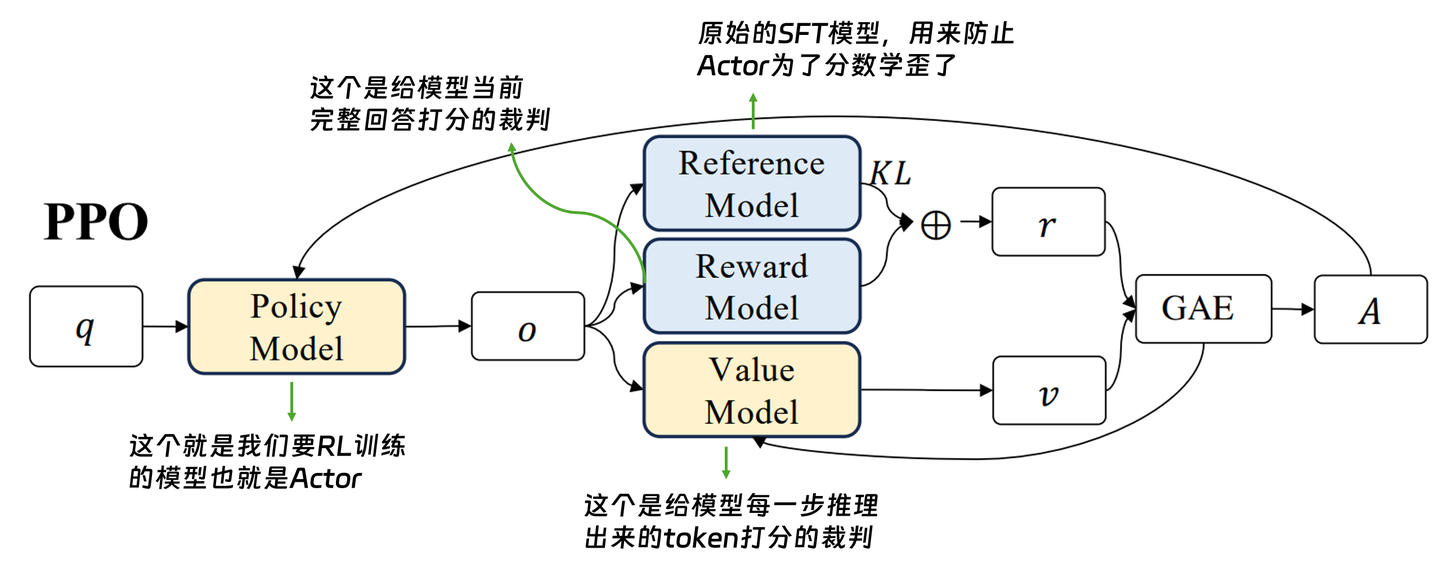
  1. PPO:有value Model
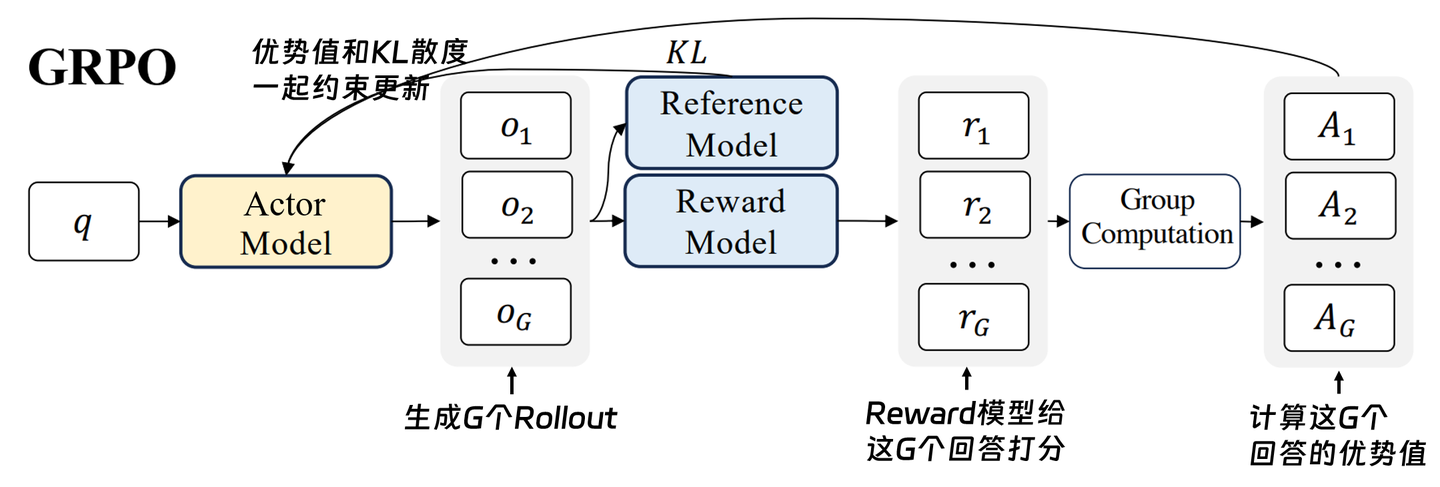
  1. GPO: 没有Value Model, 让结果内卷

二. 思维链技术

  1. 增强模型推理技术的手段

1)提高token数,2)生成更多个的输出

  1. 思维链方法

(1)

iput: prompt

output: W1,W2, W3, R1

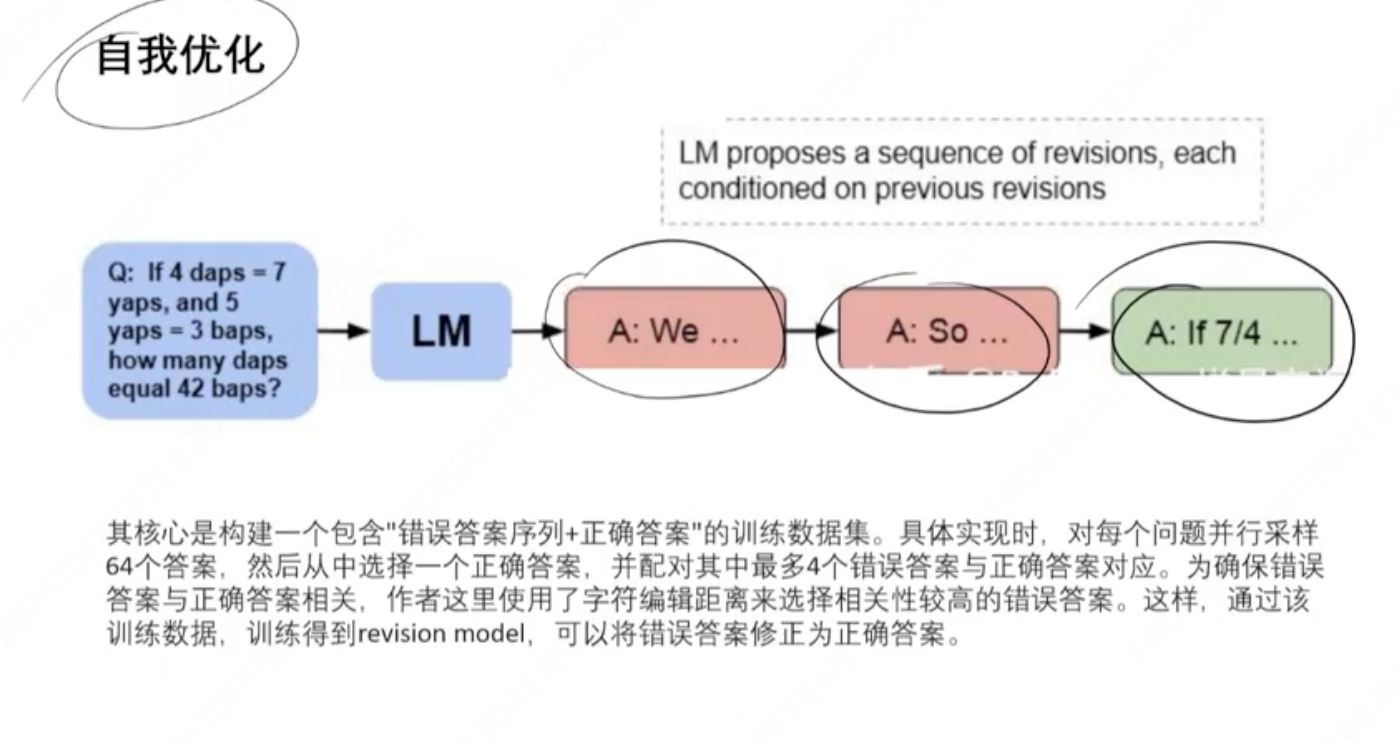
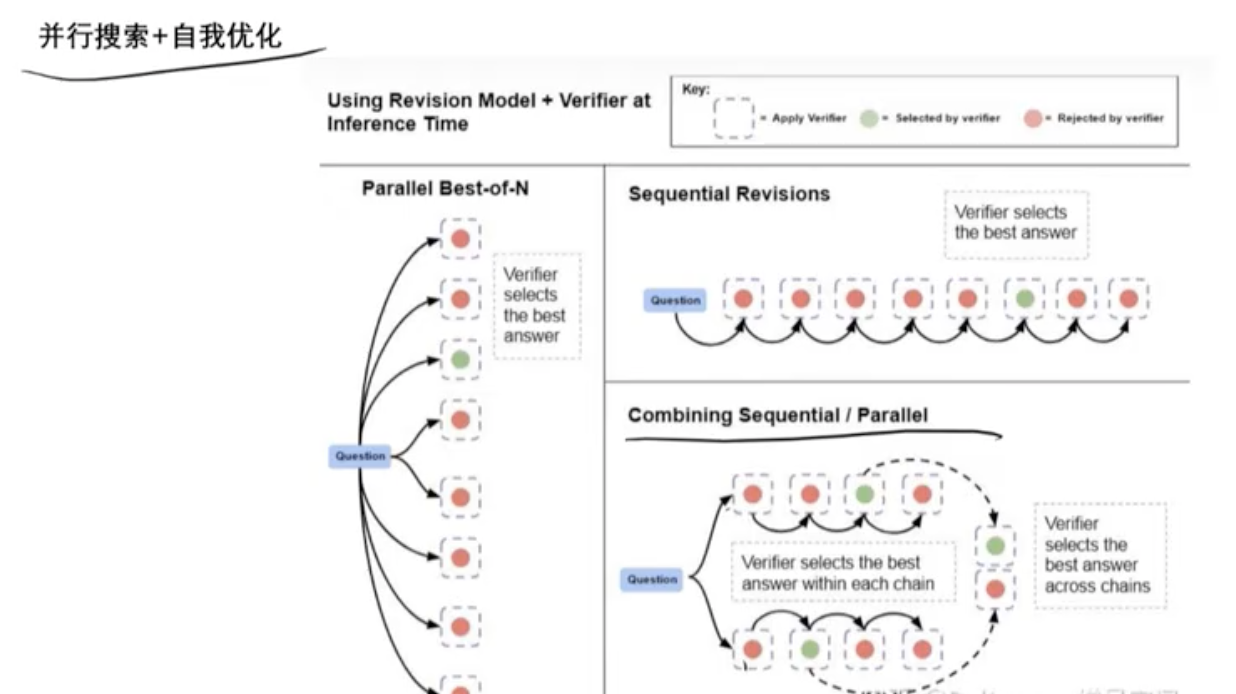
(2)并行搜索+自我优化
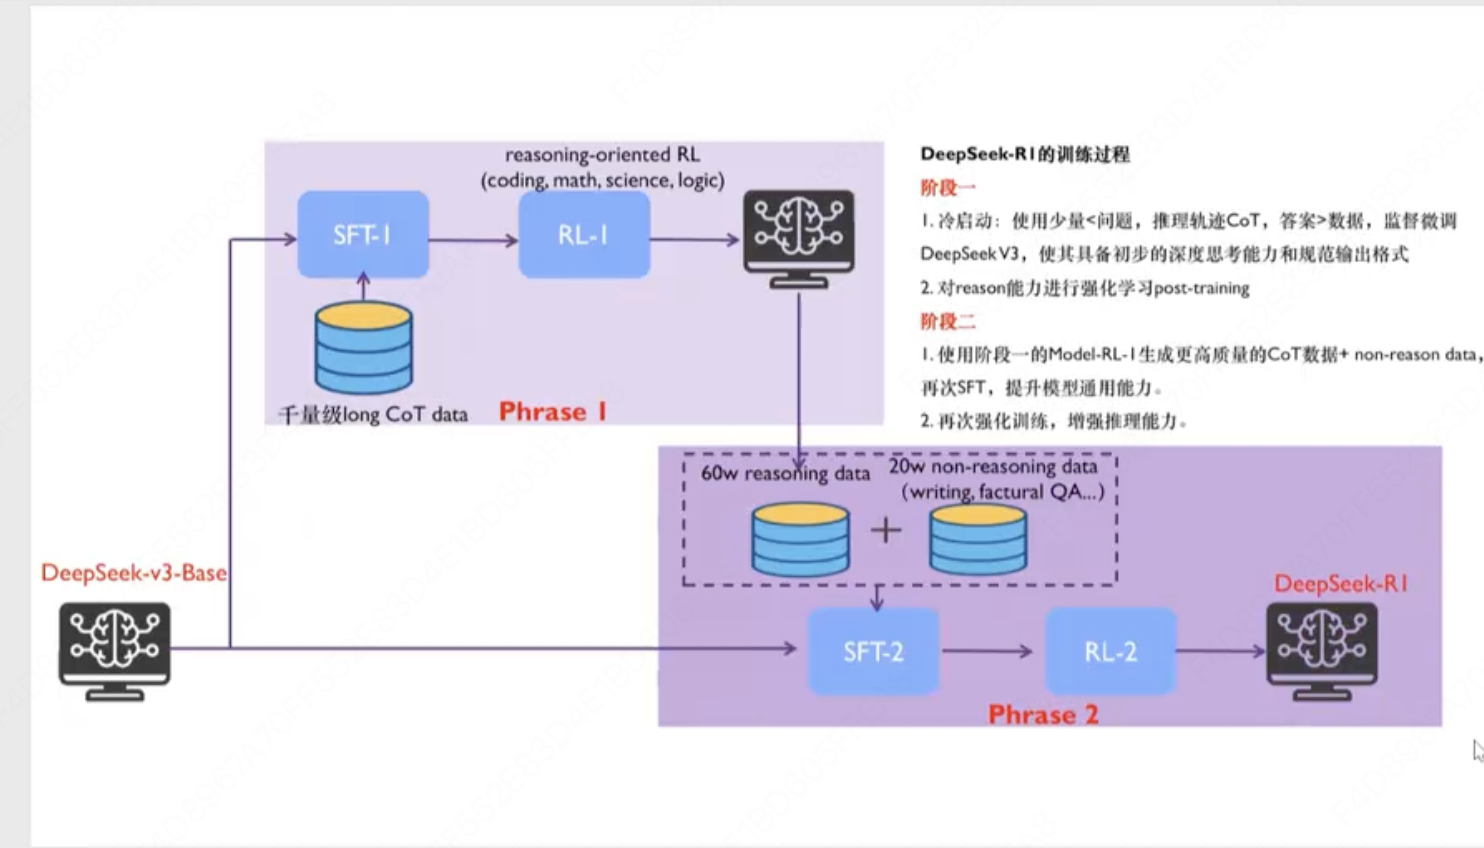
  1. DeepSeek-R1训练过程
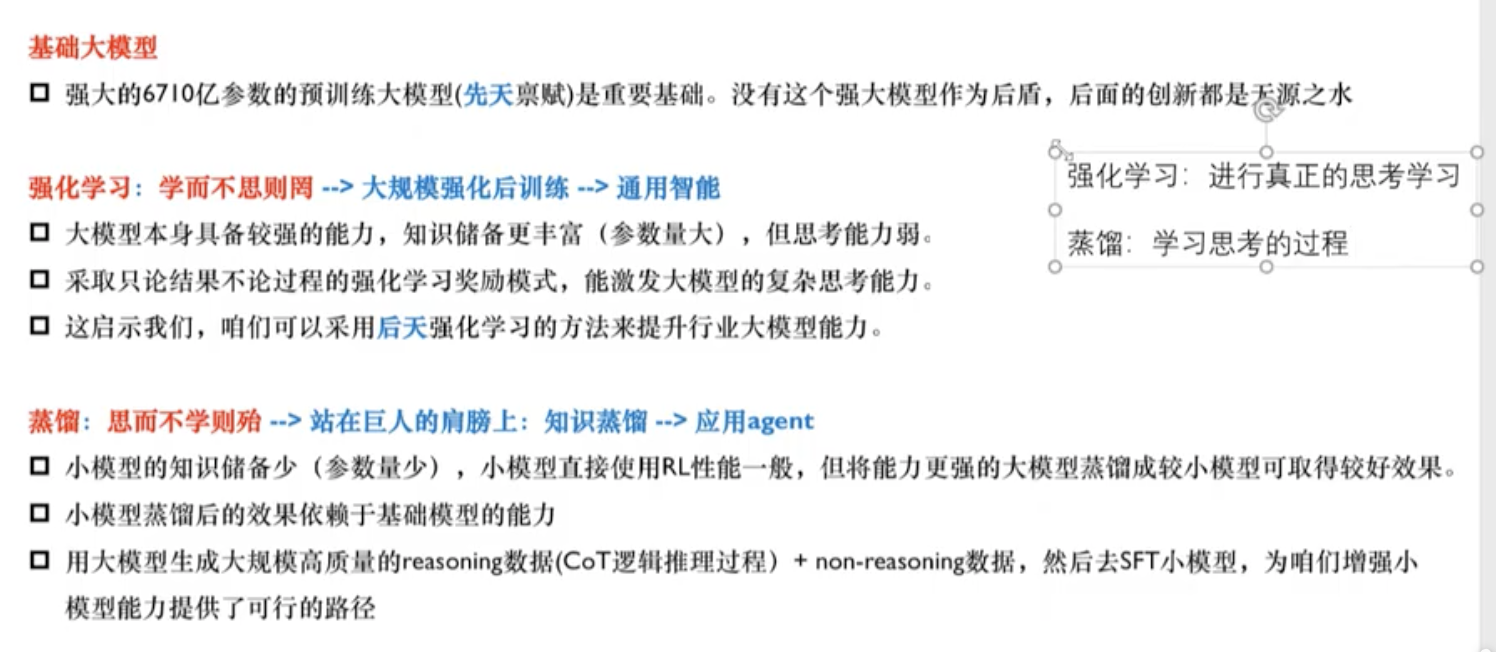
  1. 强化学习与蒸馏技术

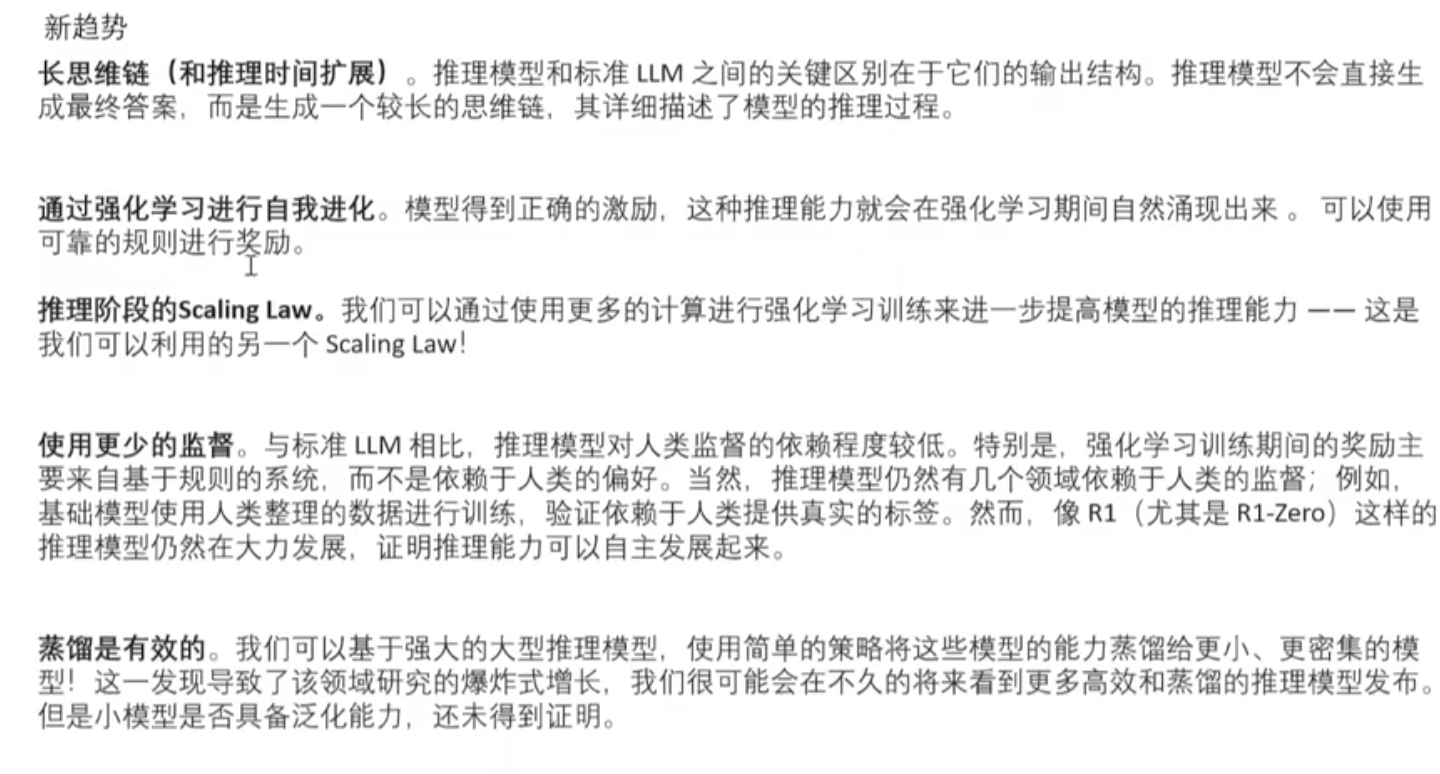
5.推理模型的未来趋势

相关推荐
九卷41 分钟前
本体(Ontology)是什么?在 AI 中,本体的作用到底是什么?.md
大模型·agent
佛系18915 小时前
从服务端日志精确分离搜索抓取、监控探测与真实流量的实操清单
ai·大模型·seo·geo·结构化数据·indexnow
MSTcheng.17 小时前
【AI应用实战】用 FastAPI + SSE 做一个自己的 AI 聊天网页:流式输出、多轮对话与完整源码
人工智能·python·大模型·fastapi·sse·ai聊天助手
LiaoWL12319 小时前
从零搭一个 RAG 知识库(二):换上语义 Embedding——BGE 实测与阈值重校准
python·大模型·numpy·embedding·向量检索·rag
深蓝学院2 天前
机器人控制算法 MPC 的预测模型从哪来?完整公式推导
机器人·强化学习·机器人控制
草履虫AI课3 天前
强化学习从零到一 06|同策略与异策略:探路的和学习的,可以不是同一个
强化学习
小七-七牛开发者3 天前
PACE:代码通过率从 42% 到 97%, 让长程 Agent 在有限 KV Cache 下用好历史 Token
大模型·claude·token·工作流·长程agent
小七-七牛开发者3 天前
周 1 上线 | DSH 喜提原神进场动画,Anthropic 启动 IPO 路演;黄仁勋辞任;微软全球大宕机超 24 小时
ai·大模型·agent·token·工作流·claudecode·ai coding
M--Y4 天前
LangGraph 架构基石:持久化与运行控制
python·langchain·大模型·llm·持久化·langgraph
梯度下降者4 天前
让AI的“隐形思维“也能越练越强,这项突破或将重写推理效率的边界
ai·强化学习·潜在推理·代理概率·停止门