1. 下载和解压
下载:https://archive.apache.org/dist/kafka/3.6.0/kafka_2.13-3.6.0.tgz
shell
tar -zxvf kafka_2.13-3.6.0.tgz -C /opt/module/
cd /opt/module/
mv kafka_2.13-3.6.0/ kafka-3.6.0-cluster
2. 部署
2.1 生成集群唯一 Cluster ID
shell
cd /opt/module/kafka-3.6.0-cluster/
./bin/kafka-storage.sh random-uuid
所有节点必须使用同一个 Cluster ID
2.2 编写配置文件
节点规划如下:
节点1:端口 9092(broker),端口 9192(controller)
节点2:端口 9093(broker),端口 9193(controller)
节点3:端口 9094(broker),端口 9194(controller)
shell
cd /opt/module/kafka-3.6.0-cluster/注意,下面配置文件的 cluster.id 要和上面生成的一致
2.2.1 kraft-node1.properties
shell
vim kraft-node1.properties
properties
process.roles=broker,controller
node.id=1
controller.quorum.voters=1@localhost:9192,2@localhost:9193,3@localhost:9194
listeners=PLAINTEXT://:9092,CONTROLLER://:9192
advertised.listeners=PLAINTEXT://localhost:9092
controller.listener.names=CONTROLLER
inter.broker.listener.name=PLAINTEXT
listener.security.protocol.map=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
num.network.threads=3
num.io.threads=8
socket.send.buffer.bytes=102400
socket.receive.buffer.bytes=102400
socket.request.max.bytes=104857600
log.dirs=/opt/module/kafka-3.6.0-cluster/log/kraft-node1
cluster.id=_05JYFwOTm6_JtPKPhQB3g
2.2.2 kraft-node2.properties
shell
vim kraft-node2.properties
properties
process.roles=broker,controller
node.id=2
controller.quorum.voters=1@localhost:9192,2@localhost:9193,3@localhost:9194
listeners=PLAINTEXT://:9093,CONTROLLER://:9193
advertised.listeners=PLAINTEXT://localhost:9093
controller.listener.names=CONTROLLER
inter.broker.listener.name=PLAINTEXT
listener.security.protocol.map=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
num.network.threads=3
num.io.threads=8
socket.send.buffer.bytes=102400
socket.receive.buffer.bytes=102400
socket.request.max.bytes=104857600
log.dirs=/opt/module/kafka-3.6.0-cluster/log/kraft-node2
cluster.id=_05JYFwOTm6_JtPKPhQB3g
2.2.3 kraft-node3.properties
shell
vim kraft-node3.properties
properties
process.roles=broker,controller
node.id=3
controller.quorum.voters=1@localhost:9192,2@localhost:9193,3@localhost:9194
listeners=PLAINTEXT://:9094,CONTROLLER://:9194
advertised.listeners=PLAINTEXT://localhost:9094
controller.listener.names=CONTROLLER
inter.broker.listener.name=PLAINTEXT
listener.security.protocol.map=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
num.network.threads=3
num.io.threads=8
socket.send.buffer.bytes=102400
socket.receive.buffer.bytes=102400
socket.request.max.bytes=104857600
log.dirs=/opt/module/kafka-3.6.0-cluster/log/kraft-node3
cluster.id=_05JYFwOTm6_JtPKPhQB3g
2.3 格式化各个节点的日志目录
shell
cd /opt/module/kafka-3.6.0-cluster/
./bin/kafka-storage.sh format -t _05JYFwOTm6_JtPKPhQB3g -c ./config/kraft-node1.properties
./bin/kafka-storage.sh format -t _05JYFwOTm6_JtPKPhQB3g -c ./config/kraft-node2.properties
./bin/kafka-storage.sh format -t _05JYFwOTm6_JtPKPhQB3g -c ./config/kraft-node3.properties 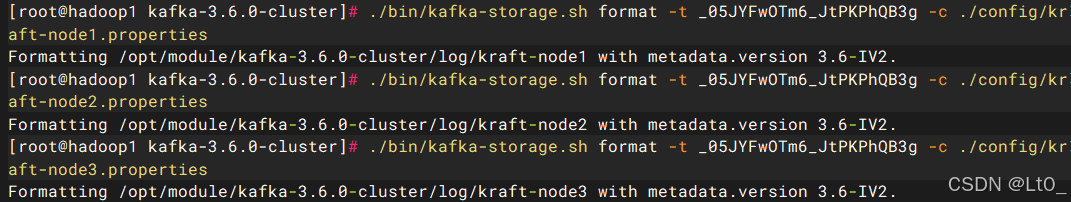
2.4 启动三个节点
shell
cd /opt/module/kafka-3.6.0-cluster/
nohup ./bin/kafka-server-start.sh ./config/kraft-node1.properties > /opt/module/kafka-3.6.0-cluster/log/kraft-node1.log 2>&1 &
nohup ./bin/kafka-server-start.sh ./config/kraft-node2.properties > /opt/module/kafka-3.6.0-cluster/log/kraft-node2.log 2>&1 &
nohup ./bin/kafka-server-start.sh ./config/kraft-node3.properties > /opt/module/kafka-3.6.0-cluster/log/kraft-node3.log 2>&1 &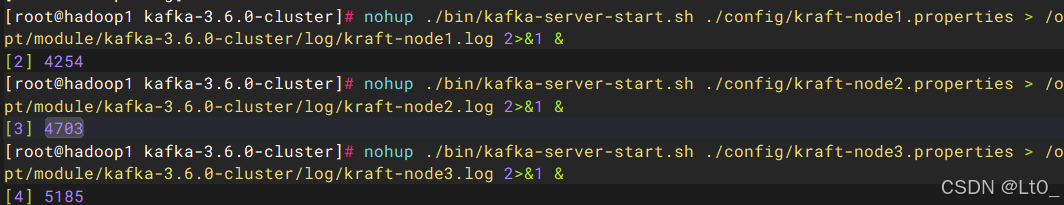
3. 测试
3.1 新建topic并查看
shell
cd /opt/module/kafka-3.6.0-cluster/
./bin/kafka-topics.sh --create --topic kafka-test --partitions 3 --replication-factor 3 --bootstrap-server localhost:9092,localhost:9093,localhost:9094
./bin/kafka-topics.sh --list --bootstrap-server localhost:9092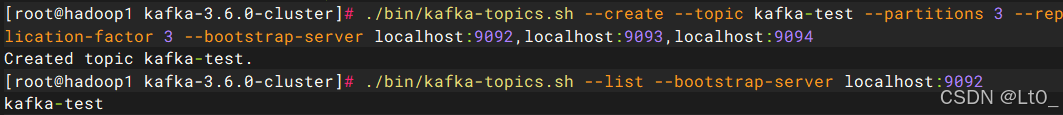
3.2 收发消息测试
打开两个终端,一个用于发消息,一个用于接受消息
3.2.1 发消息
shell
cd /opt/module/kafka-3.6.0-cluster/
./bin/kafka-console-producer.sh --topic kafka-test --bootstrap-server localhost:9092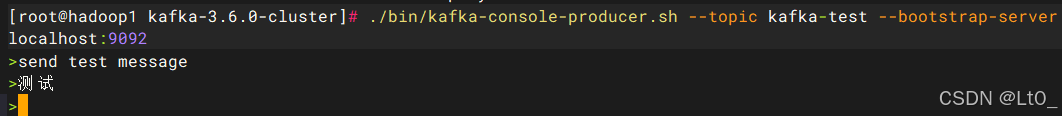
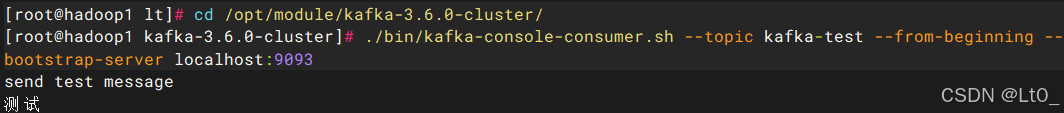
3.2.2 收消息
shell
cd /opt/module/kafka-3.6.0-cluster/
./bin/kafka-console-consumer.sh --topic kafka-test --from-beginning --bootstrap-server localhost:9093