本文记录一次完整、可复现的工程实践:
在 RK3576 平台上,将多模态大模型 Qwen3-VL-2B 拆分并部署到 NPU 上运行。
目标不是介绍工具功能,而是让读者:
按照本文步骤执行代码,最终在板端成功跑起多模态推理 Demo。
一、整体部署流程总览(先看全局)
在 RK 平台上,多模态模型无法以单一模型部署,必须拆分为两个子模型:
- Vision Encoder →
.rknn - LLM Decoder →
.rkllm
整体流程如下:
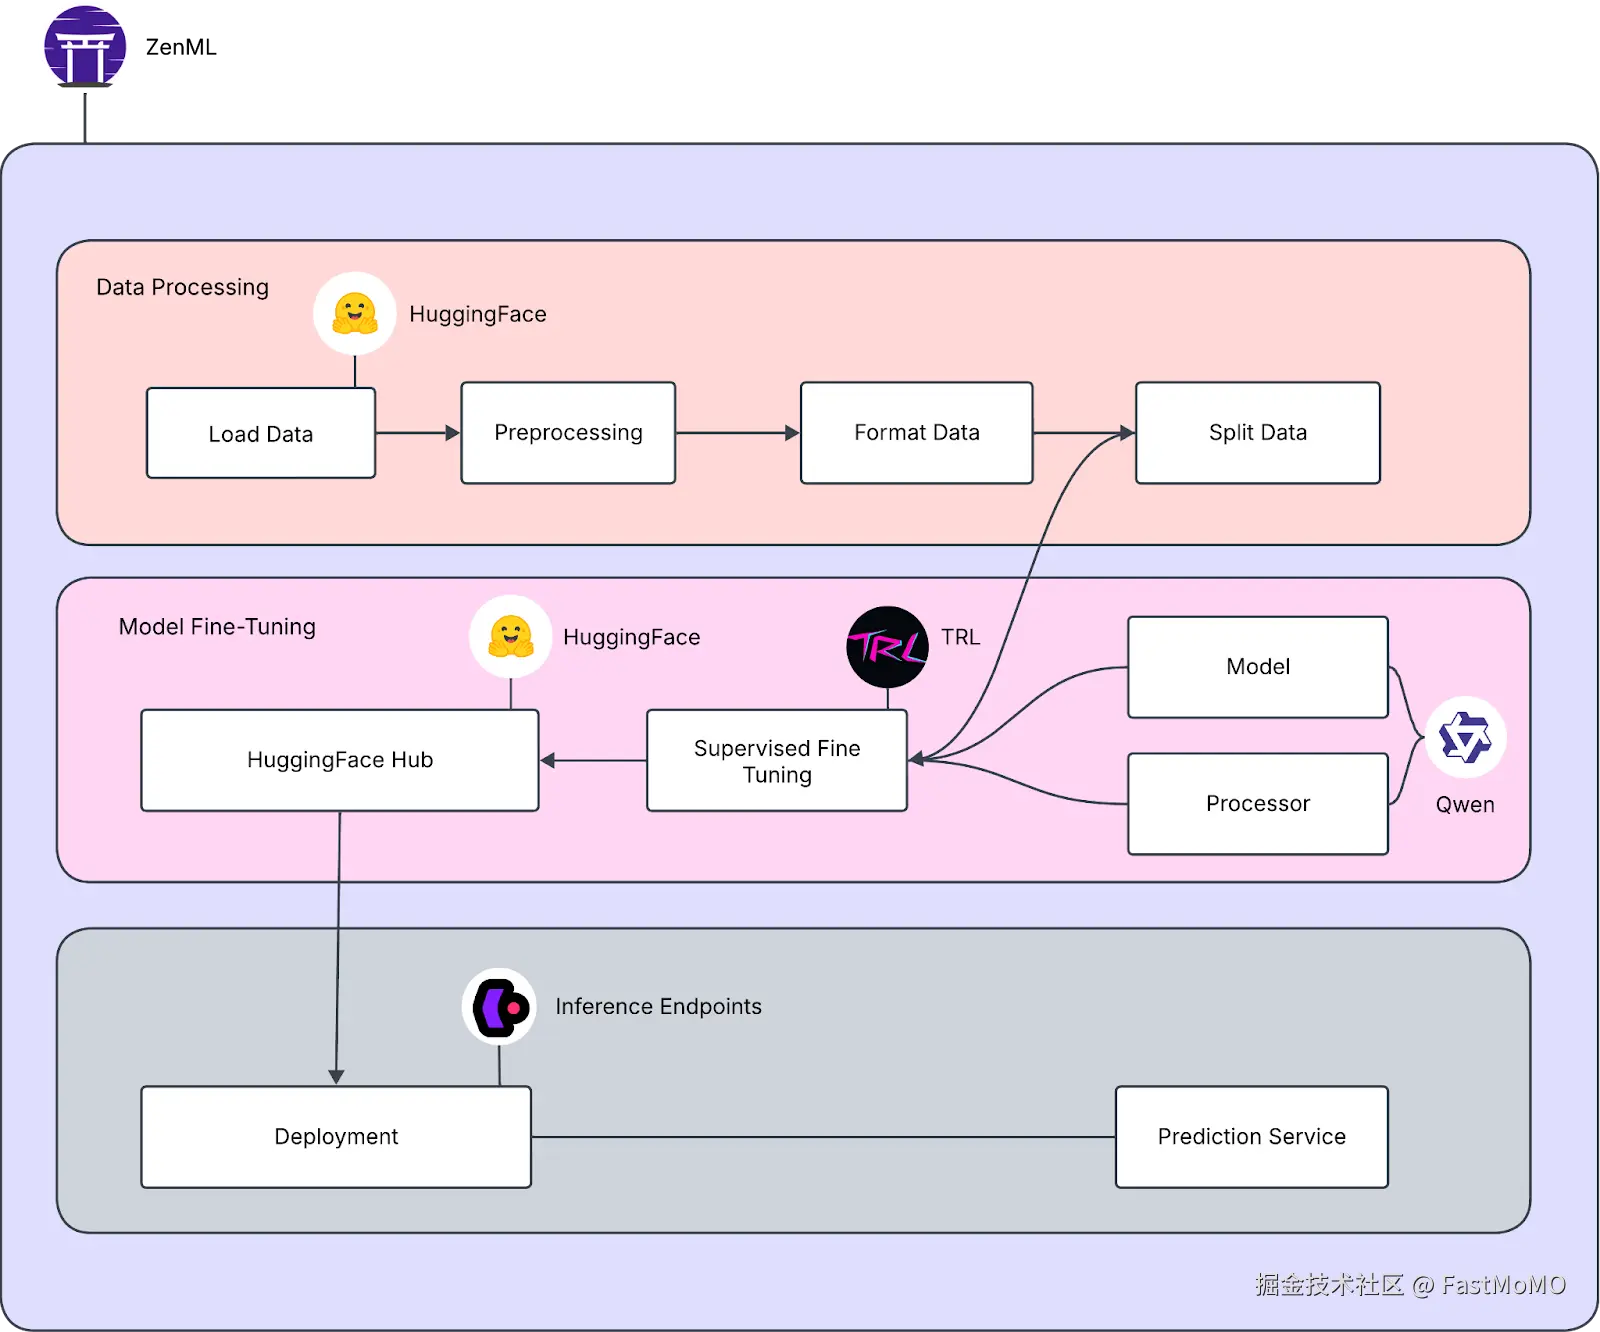
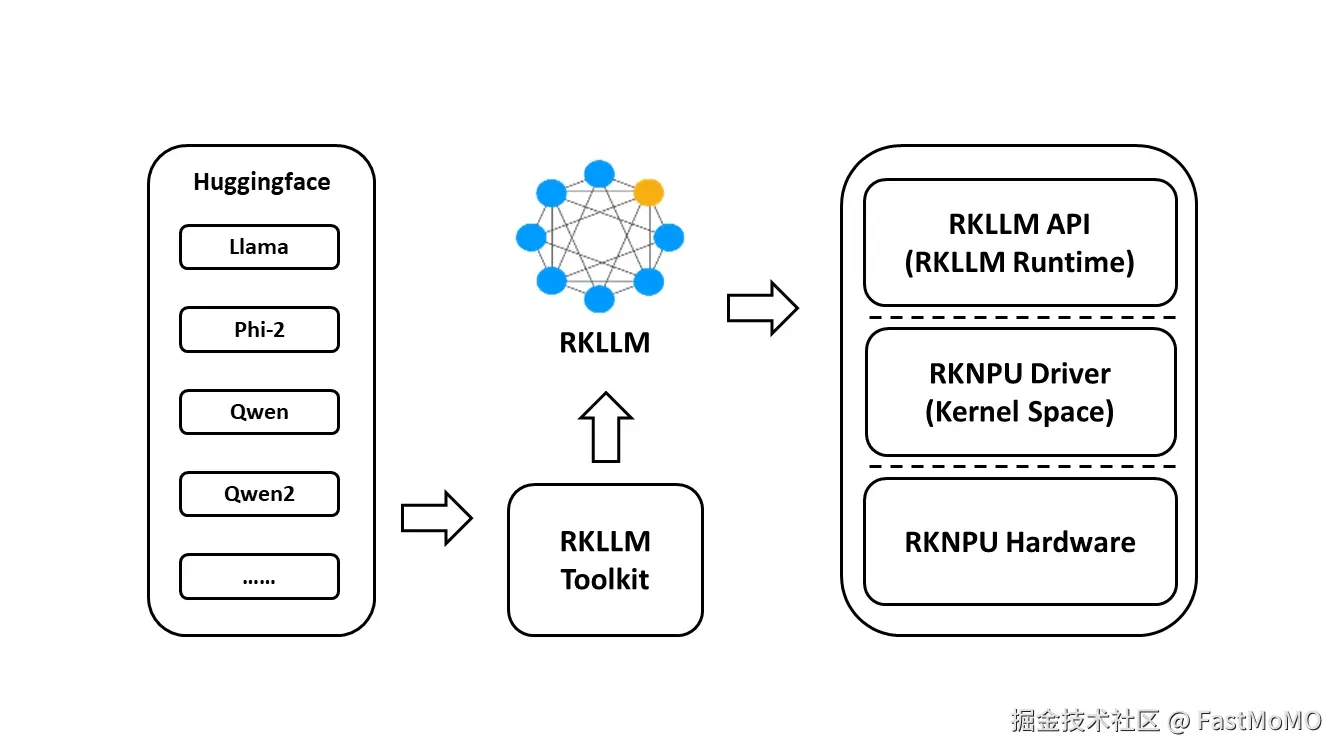
本文最终产物:
qwen3-vl_vision_rk3576.rknn
qwen3-vl-2b-instruct_w8a8_rk3576.rkllm
二、环境准备(必须一致)
1️⃣ 主机环境(模型转换)
| 项目 | 版本 |
|---|---|
| OS | Ubuntu 22.04 x86_64 |
| Python | 3.10 |
| 工具 | Miniforge / Conda |
2️⃣ 开发板环境
| 项目 | 说明 |
|---|---|
| 芯片 | RK3576 |
| 系统 | Linux |
| 推理 | NPU |
三、模型准备
拉取 Qwen3-VL-2B 模型(HuggingFace / ModelScope 均可):
bash
git clone https://huggingface.co/Qwen/Qwen3-VL-2B-Instruct假设模型路径为:
bash
/workspace/Qwen3-VL-2B-Instruct四、LLM 部分:RKLLM 转换与量化(核心)
4.1 加载模型
ini
from rkllm.api import RKLLM

llm = RKLLM()

ret = llm.load_huggingface(
    model="/workspace/Qwen3-VL-2B-Instruct",
    device="cpu",
    dtype="float16",
)

if ret != 0:
    raise RuntimeError("load_huggingface failed")
说明:
- 使用 CPU 转换,避免显存不足
- FP16 对 w8a8 量化足够
4.2 构建量化数据集(关键步骤)
多模态模型不能直接量化原始图像输入,需要先构造 inputs_embeds。
ini
inputs_embeds = model.get_input_embeddings()(inputs["input_ids"])

image_mask = inputs["input_ids"] == model.config.image_token_id
image_embeds = model.visual(
    inputs["pixel_values"],
    grid_thw=inputs["image_grid_thw"]
)

inputs_embeds[image_mask] = image_embeds
将 inputs_embeds 保存为 numpy,用于量化校准:
javascript
import numpy as np
np.save("inputs_embeds.npy", inputs_embeds.cpu().numpy())
最终生成 inputs.json,作为 RKLLM 的校准数据集。
4.3 构建并导出 RKLLM 模型
ini
ret = llm.build(
    do_quantization=True,
    quantized_dtype="w8a8",
    quantized_algorithm="normal",
    target_platform="RK3576",
    num_npu_core=2,
    dataset="data/inputs.json"
)

if ret != 0:
    raise RuntimeError("build failed")

llm.export_rkllm(
    "qwen3-vl-2b-instruct_w8a8_rk3576.rkllm"
)
五、Vision 部分:ONNX → RKNN
5.1 导出 Vision ONNX
css
python export_vision.py \
  --path /workspace/Qwen3-VL-2B-Instruct \
  --model_name qwen3-vl \
  --height 448 \
  --width 448
输出:
qwen3-vl_vision.onnx5.2 ONNX 转 RKNN
css
python export_vision_rknn.py \
  --path qwen3-vl_vision.onnx \
  --target-platform rk3576 \
  --height 448 \
  --width 448
输出:
qwen3-vl_vision_rk3576.rknn六、板端部署与运行
6.1 拷贝文件到开发板
vbnet
qwen3-vl_vision_rk3576.rknn
qwen3-vl-2b-instruct_w8a8_rk3576.rkllm
demo
lib/
6.2 设置运行环境
bash
export LD_LIBRARY_PATH=./lib:$LD_LIBRARY_PATH6.3 运行 Demo
bash
./demo demo.jpg \
  qwen3-vl_vision_rk3576.rknn \
  qwen3-vl-2b-instruct_w8a8_rk3576.rkllm \
  256 2048 2 \
  "<|vision_start|>" "<|vision_end|>" "<|image_pad|>"
参数说明:
vision_start / vision_end:标识视觉 embedding 边界image_pad:多图或补齐占位符
七、结果验证
运行成功后,终端会输出模型对图片内容的描述或回答。
至此,一个 完整的端侧多模态推理流程部署完成。
八、实践总结
- RK 平台多模态模型必须拆分
- RKLLM 的核心是量化与运行时管理
- 量化数据准备是成功关键
- w8a8 是当前最稳妥的工程选择