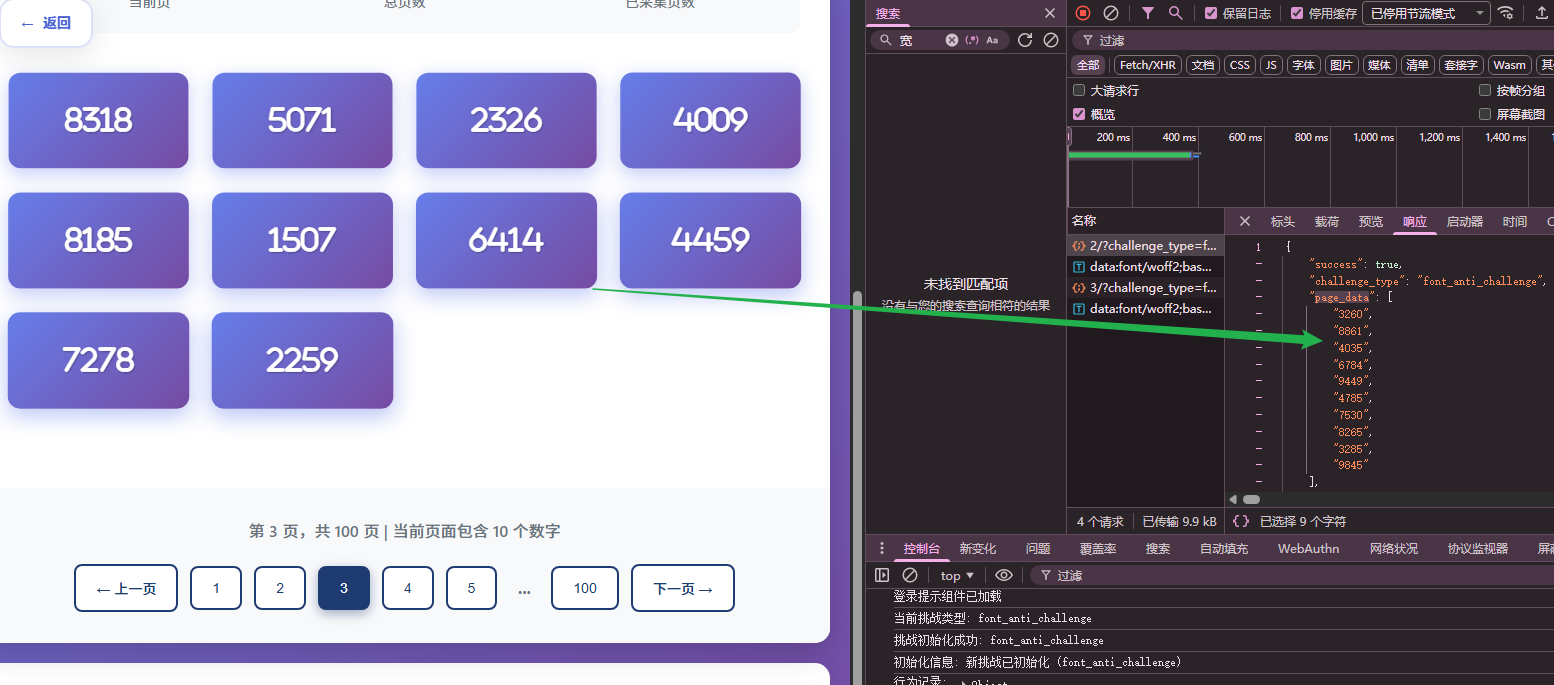
打乱
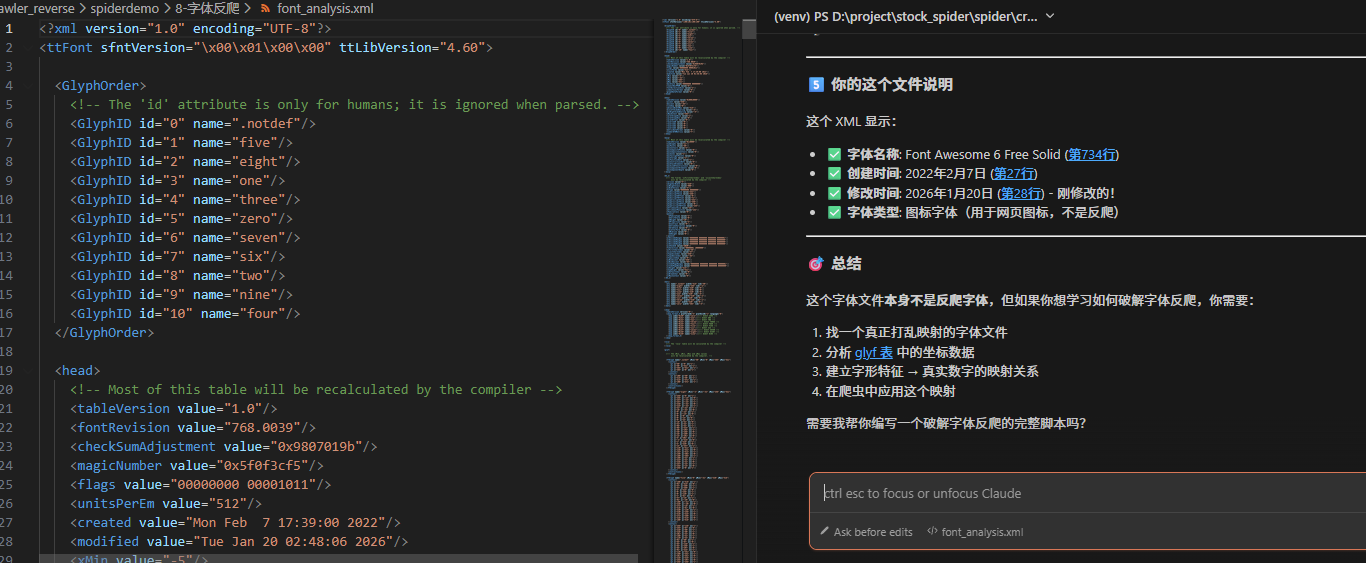
拿到映射文件
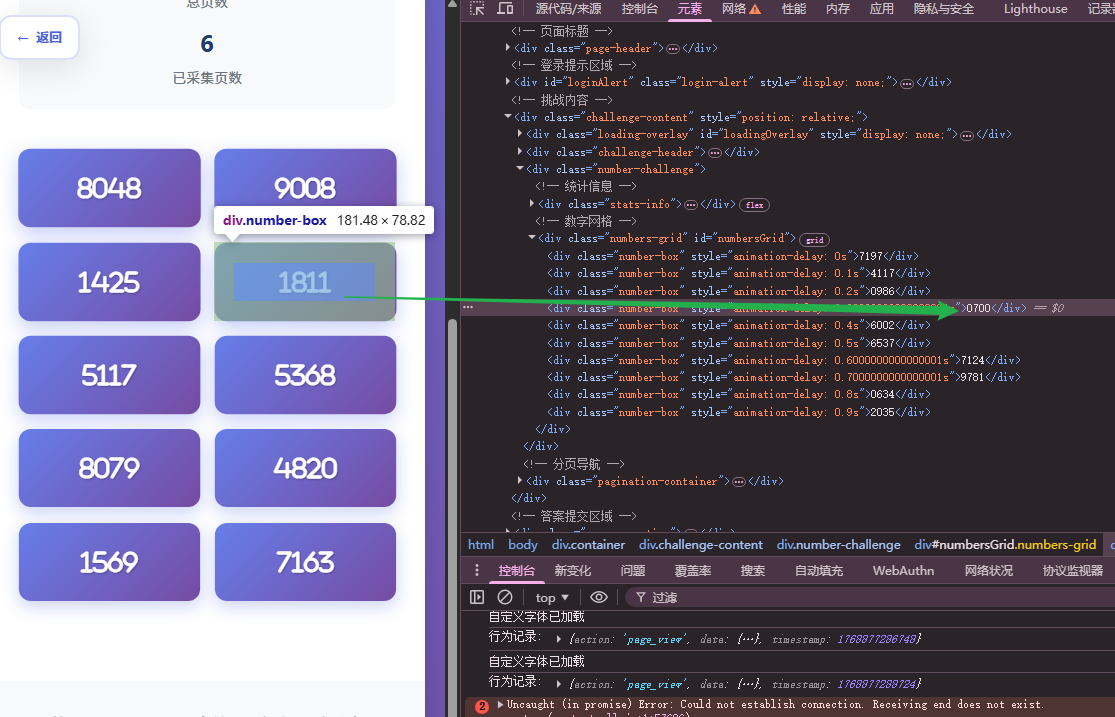
这里是不一样的
md,我还没太理解,ai就给我跑出来了
🎯 字体反爬完整破解流程总结
让我为你详细总结整个破解过程,从0到1完整分析:
📖 一、反爬机制原理
1.1 网站的工作流程
用户访问页面
↓
浏览器加载 HTML + CSS + JavaScript
↓
JavaScript 发送 AJAX 请求到 API
↓
API 返回两个关键数据:
① page_data: "3184", "9980", "2437", ... ← 混淆的随机数字
② b64Font: "AAEAAA..." ← Base64编码的字体文件
↓
JavaScript 动态创建 @font-face 样式
↓
浏览器使用自定义字体渲染数字
↓
用户看到真实的数字!
1.2 核心机制:字体映射被打乱
标准字体的结构:
GlyphOrder(字形在字体文件中的存储顺序)
'.notdef', 'zero', 'one', 'two', 'three', 'four', 'five', 'six', 'seven', 'eight', 'nine'
↑ ↑ ↑ ↑ ↑ ↑ ↑ ↑ ↑ ↑
显示0 显示1 显示2 显示3 显示4 显示5 显示6 显示7 显示8 显示9
CMAP(Unicode 字符码点 → 字形名称)
{
48: 'zero', # 字符 '0' (ASCII 48) → 字形 'zero'
49: 'one', # 字符 '1' (ASCII 49) → 字形 'one'
50: 'two', # 字符 '2' (ASCII 50) → 字形 'two'
...
}
反爬字体的结构:
GlyphOrder(被打乱!)
'.notdef', 'seven', 'nine', 'zero', 'three', 'four', 'six', 'eight', 'one', 'five', 'two'
↑ ↑ ↑ ↑ ↑ ↑ ↑ ↑ ↑ ↑ ↑
显示0 显示1 显示2 显示3 显示4 显示5 显示6 显示7 显示8 显示9
CMAP(保持标准,不修改!)
{
48: 'zero', # 字符 '0' → 字形 'zero'
49: 'one', # 字符 '1' → 字形 'one'
50: 'two', # 字符 '2' → 字形 'two'
...
}
关键点:浏览器如何显示数字?
用户看到 "3184" 这个字符串
浏览器处理过程:
- 字符 '3' (ASCII 51)
↓ - 查 CMAP: 51 → 'three'
↓ - 查 GlyphOrder: 'three' 排在第4位(索引3)
↓ - 显示为数字:3 ✓
但是!如果 GlyphOrder 被打乱了:
'.notdef', 'seven', 'nine', 'zero', 'three', ...
索引0 索引1 索引2 索引3 索引4
那么:
- 字符 '0' → 'zero' → 索引3 → 显示为 3
- 字符 '1' → 'one' → 索引7 → 显示为 7
- 字符 '2' → 'two' → 索引9 → 显示为 9
- 字符 '3' → 'three' → 索引4 → 显示为 4
🔍 二、破解思路
2.1 核心思路
目标: 建立一个映射表,把混淆数字转换为真实数字
方法:
获取字体文件
解析 GlyphOrder 的顺序
找出每个数字字形在 GlyphOrder 中的位置
建立映射:字符码点 → 真实数字
2.2 详细步骤
步骤1:获取API数据
import requests
import json
请求API
url = "https://spiderdemo.cn/font_anti/api/font_anti_challenge/page/2/"
response = requests.get(url, cookies={'sessionid': '...'})
data = response.json()
得到:
page_data = "3184", "9980", "2437", ... # 混淆的数字
b64_font = "AAEAAA..." # Base64字体
步骤2:解析字体文件
import base64
from fontTools.ttLib import TTFont
import io
解码字体
font_data = base64.b64decode(b64_font)
font = TTFont(io.BytesIO(font_data))
获取关键信息
cmap = font.getBestCmap()
cmap = {
48: 'zero',
49: 'one',
50: 'two',
51: 'three',
52: 'four',
53: 'five',
54: 'six',
55: 'seven',
56: 'eight',
57: 'nine',
}
glyph_order = font.getGlyphOrder()
glyph_order = [
'.notdef',
'seven', # 索引1
'nine', # 索引2
'zero', # 索引3
'three', # 索引4
'four', # 索引5
'six', # 索引6
'eight', # 索引7
'one', # 索引8
'five', # 索引9
'two', # 索引10
]
步骤3:建立映射表
3.1 找出所有数字字形(0-9对应的字形)
digit_glyphs = {}
for code_point, glyph_name in cmap.items():
if 48 <= code_point <= 57: # '0'-'9'
digit_glyphsglyph_name = code_point - 48
digit_glyphs = {
'zero': 0,
'one': 1,
'two': 2,
'three': 3,
'four': 4,
'five': 5,
'six': 6,
'seven': 7,
'eight': 8,
'nine': 9,
}
3.2 按 glyph_order 中的位置排序
sorted_glyphs = sorted(
digit_glyphs.keys(), # 'zero', 'one', 'two', ...
key=lambda g: glyph_order.index(g)
)
sorted_glyphs = [
'seven', # glyph_order1 → 显示为 0
'nine', # glyph_order2 → 显示为 1
'zero', # glyph_order3 → 显示为 2
'three', # glyph_order4 → 显示为 3
'four', # glyph_order5 → 显示为 4
'six', # glyph_order6 → 显示为 5
'eight', # glyph_order7 → 显示为 6
'one', # glyph_order8 → 显示为 7
'five', # glyph_order9 → 显示为 8
'two', # glyph_order10 → 显示为 9
]
3.3 建立最终映射:字符码点 → 真实数字
char_to_real = {}
for idx, glyph_name in enumerate(sorted_glyphs):
找到这个字形对应的Unicode码点
for code_point, gp in cmap.items():
if gp == glyph_name and 48 <= code_point <= 57:
char_to_realcode_point = idx
break
char_to_real = {
48: 2, # '0' → 显示为 2
49: 7, # '1' → 显示为 7
50: 9, # '2' → 显示为 9
51: 3, # '3' → 显示为 3
52: 4, # '4' → 显示为 4
53: 8, # '5' → 显示为 8
54: 5, # '6' → 显示为 5
55: 0, # '7' → 显示为 0
56: 6, # '8' → 显示为 6
57: 1, # '9' → 显示为 1
}
步骤4:解密数字
def decrypt_number(obfuscated_num, mapping):
"""
将混淆的数字转换为真实数字
例如:"3184" → "3764"
"""
result = []
for char in obfuscated_num:
    code_point = ord(char)  # '3' → 51
    if code_point in mapping:
        result.append(str(mapping[code_point]))
    else:
        result.append(char)
return ''.join(result)
示例
mapping = {48: 2, 49: 7, 50: 9, 51: 3, 52: 4, ...}
decrypted = decrypt_number("3184", mapping)
过程:
'3' → code_point=51 → mapping51=3 → '3'
'1' → code_point=49 → mapping49=7 → '7'
'8' → code_point=56 → mapping56=6 → '6'
'4' → code_point=52 → mapping52=4 → '4'
结果:"3764"
💻 三、完整代码实现
3.1 核心类封装
class FontAntiSpider:
def init (self, sessionid):
self.sessionid = sessionid
self.session = requests.Session()
self.session.cookies.set('sessionid', sessionid)
def fetch_page(self, page=1):
    """获取指定页面数据"""
    url = f"https://spiderdemo.cn/font_anti/api/font_anti_challenge/page/{page}/"
    response = self.session.get(url)
    return response.json()

def parse_font_mapping(self, b64_font):
    """解析字体,建立字符到真实数字的映射"""
    font_data = base64.b64decode(b64_font)
    font = TTFont(io.BytesIO(font_data))

    cmap = font.getBestCmap()
    glyph_order = font.getGlyphOrder()

    # 找出数字字形
    digit_glyphs = {}
    for code_point, glyph_name in cmap.items():
        if 48 <= code_point <= 57:
            digit_glyphs[glyph_name] = code_point - 48

    # 按glyph_order排序
    sorted_glyphs = sorted(
        digit_glyphs.keys(),
        key=lambda g: glyph_order.index(g)
    )

    # 建立映射
    char_to_real = {}
    for idx, glyph_name in enumerate(sorted_glyphs):
        for code_point, gp in cmap.items():
            if gp == glyph_name and 48 <= code_point <= 57:
                char_to_real[code_point] = idx
                break

    return char_to_real

def decrypt_number(self, obfuscated_num, mapping):
    """解密单个数字"""
    result = []
    for char in obfuscated_num:
        code_point = ord(char)
        if code_point in mapping:
            result.append(str(mapping[code_point]))
        else:
            result.append(char)
    return ''.join(result)

def crawl_all_pages(self, total_pages=100):
    """爬取所有页面"""
    all_data = []

    for page in range(1, total_pages + 1):
        data = self.fetch_page(page)
        mapping = self.parse_font_mapping(data['b64Font'])

        decrypted_page = [
            self.decrypt_number(num, mapping)
            for num in data['page_data']
        ]

        all_data.extend(decrypted_page)

    return all_data
3.2 使用示例
创建爬虫实例
spider = FontAntiSpider("6cn92feun22342isgqer8d8hmcxrtpu1")
爬取所有页面
result = spider.crawl_all_pages(total_pages=100)
计算总和
total = sum(int(num) for num in result)
print(f"总和: {total}") # 输出: 5636267
📊 四、实际运行结果
4.1 单页测试结果
原始混淆数据:
- 3184
- 9980
- 2437
- 8692
- 5225
字体映射关系:
GlyphOrder: '.notdef', 'seven', 'nine', 'zero', 'three', 'four', ...
字形→数字: {'seven': 0, 'nine': 1, 'zero': 2, 'three': 3, ...}
解密后数据:
- 3764
- 1162
- 9430
- 6519
- 8998
本页总和: 58077
4.2 100页完整爬取结果
================================================================================
开始爬取 100 页数据
OK 第 1 页: 获取 10 条 | 已采集 10 条 | 本页示例: 8716
OK 第 10 页: 获取 10 条 | 已采集 100 条 | 本页示例: 5165
OK 第 20 页: 获取 10 条 | 已采集 200 条 | 本页示例: 3492
-> 进度已保存: progress_page_20.json
...
OK 第 100 页: 获取 10 条 | 已采集 1000 条 | 本页示例: 2981
================================================================================
爬取完成!
总采集条数: 1000
结果文件:
OK final_result.json - 完整数据
OK answer.txt - 答案(总和)
SUM 所有数字总和: 5636267
(可直接提交 answer.txt 中的内容)
🔑 五、关键要点总结
5.1 核心原理
✅ 字体反爬的本质: 修改 GlyphOrder 的顺序,而非修改 CMAP
✅ 每次请求动态生成字体: 每次请求返回不同的字体文件
✅ 数据随机混淆: 每次请求返回不同的随机数字
✅ 浏览器渲染规则: 字形在 GlyphOrder 中的位置 = 显示的数字
5.2 破解关键步骤
- 获取 API 响应(b64Font + page_data)
↓ - 解析字体文件(使用 fontTools)
↓ - 提取 GlyphOrder 和 CMAP
↓ - 建立映射表(字符码点 → 真实数字)
↓ - 解密所有数字
↓ - 计算总和
5.3 重要细节
GlyphOrder 的顺序决定显示: 第一个数字字形显示为0,第二个为1,依此类推
CMAP 保持标准: 不修改 Unicode → 字形的映射
动态字体: 每次请求需要重新解析字体
Base64 编码: 字体文件通过 Base64 编码传输
📁 六、文件结构
8-字体反爬/
├── spider_all.py # ⭐ 完整爬虫(100页自动化)
├── final_solution.py # 单页测试脚本
├── font_anti_solver.py # 字体破解器类
├── test_font_anti.py # 测试脚本
├── full_spider.py # 网页分析脚本
├── font.py # 基础示例
├── README.md # 完整文档
├── answer.txt # 最终答案:5636267
└── final_result.json # 完整数据(1000条)
🎓 七、扩展学习
7.1 其他字体反爬类型
字形名称混淆
使用 glyph_001, glyph_002 代替 one, two
需要通过字形坐标特征识别
CSS 类名映射
7 → 显示为5
需要解析 CSS 文件
动态 SVG 字体
使用 SVG 路径绘制数字
需要 OCR 识别
7.2 推荐工具
fontTools: Python字体解析库
FontForge: 字体编辑器(可视化分析)
Tesseract: OCR引擎(识别字形)
这就是完整的字体反爬破解流程!核心是理解 GlyphOrder 的顺序决定了数字的显示,通过解析字体文件建立映射表即可破解。🎉
暂时先这样,后期有兴趣继续弄