深度学习(16)YOLO中的置信度和IOU阈值在训练中及推理中后处理结果的影响
- 详细解释一下YOLO(以v3及之后的版本为主)中置信度 和IOU阈值 在训练 和推理(后处理) 两个关键阶段的作用与影响。这两者是理解YOLO如何工作的核心,也是调优模型性能的关键参数。
核心概念速览
-
置信度:一个0到1之间的数值,表示模型对"这个预测框里包含一个目标物体"以及"这个物体的类别是什么"这两件事的综合把握程度。
-
在公式上,置信度 = 物体存在概率 × 预测框与真实框的IOU。
-
训练时:它是损失函数的一部分,模型被训练去预测这个值。
-
推理时:它是第一道过滤器,用来剔除那些"把握不大"的预测框。
-
-
IOU阈值:
-
训练时:用于匹配预测框和真实框,决定哪个预测框负责学习哪个真实目标。
-
推理时:主要用于非极大值抑制,解决同一物体被多个框重复检测的问题。
-
第一部分:训练阶段的影响
在训练阶段,模型通过反向传播学习如何调整权重。置信度和IOU阈值在这里扮演了"老师"和"裁判"的角色,指导模型应该学习什么。
- 置信度在训练中的角色
-
学习目标:对于每一个预定义的锚框,模型需要预测一个置信度分数。这个分数的学习目标是:
-
如果这个锚框匹配到了一个真实物体(通过IOU阈值判断),那么它的置信度学习目标就是该预测框与真实框的IOU值。
-
如果这个锚框没有匹配到任何真实物体,那么它的置信度学习目标就是 0。
-
损失函数:置信度预测的误差是置信度损失的重要组成部分。它通常使用二元交叉熵损失。
模型被"鼓励"去为匹配到物体的框预测高置信度(接近其与真实框的IOU),为背景框预测低置信度(接近0)。
影响:
阈值设置的影响:用于匹配的IOU阈值(如YOLOv3常设为0.5)决定了什么样的预测框有资格去学习一个真实物体。提高这个匹配阈值(如设为0.6),意味着只有预测得更准的框才被赋予学习责任,这会让模型对定位精度的要求更严格,但可能使正样本(需要学习的框)减少,训练难度增加。
学习效果:通过这个机制,模型学会了两个关键能力:(1) 区分前景(有物体)和背景(无物体);(2) 评估自己预测的框的位置质量。
- IOU阈值在训练中的角色(主要指匹配阈值)
锚框与真实框的匹配:这是训练开始的关键步骤。系统需要决定由哪个尺度的哪个锚框(及其对应的预测)来负责学习当前这个真实标签。
常用规则是:对于每个真实框,选择与之IOU最大的那个锚框作为"正样本"进行学习。
同时,YOLO也使用一个IOU阈值(如ignore_thresh,通常设为0.5-0.7)来处理"模棱两可"的预测框:如果一个预测框与任何真实框的IOU大于此阈值,但又不是最大那个(即它不是被选中的正样本),则忽略它------既不把它当正样本学,也不把它当负样本(背景)学。这避免了让模型去学习那些"半对半错"的困难案例,使训练更稳定。
影响:
ignore_thresh设置过高:更多预测框会被视为负样本(背景),模型可能变得更"保守",召回率可能下降。
ignore_thresh设置过低:更多"质量不高"的预测框也会参与损失计算,可能引入噪声,干扰模型学习,影响定位精度。
第二部分:推理阶段(后处理)的影响
在推理阶段,模型已经训练完成,输出大量原始的预测框。此时,置信度和IOU阈值是"筛选官"和"清理工",负责将杂乱的原生态预测变成干净、最终的检测结果。
- 置信度阈值
作用:第一步过滤。直接剔除所有置信度低于预设阈值(如 conf_thresh=0.25 或 0.5)的预测框。这些被认为极有可能是背景或噪声。
影响:
阈值设置过高:过滤非常严格,只有把握极大的预测才会被保留。这会导致高精度,低召回率------很多真实的物体(尤其是小、模糊或遮挡的物体)可能因为得分不高而被漏检。
阈值设置过低:过滤宽松,大量预测框(包括很多错误的背景预测)会进入下一环节。这会导致高召回率,低精度------最终结果中包含大量误报(假阳性),画面中可能出现很多根本不存在的"幽灵"框。
应用:通常根据任务需求在精度和召回率之间进行权衡调整。在追求安全性的场景(如自动驾驶)可能设低一些以提高召回;在需要结果干净的场景可能设高一些。
- IOU阈值(主要用于NMS)
作用:在应用置信度阈值初步筛选后,通常会剩下很多重叠的框检测同一个物体。非极大值抑制 算法使用IOU阈值来解决这个问题。
NMS步骤:1)将所有框按置信度排序。2)选出置信度最高的框A,将其加入最终结果。3)计算其他所有框与框A的IOU。4)剔除所有与框A的IOU超过设定阈值(如 nms_thresh=0.45)的框(因为它们很可能和框A检测的是同一个物体)。5)对剩余的框重复步骤2-4。
影响:
阈值设置过高(如0.8):意味着只有当两个框重叠程度非常高时,才认为它们是同一个物体并剔除低分框。这可能导致对同一个物体保留多个检测框,输出冗余结果。
阈值设置过低(如0.3):意味着即使两个框只有部分重叠,也会剔除低分框。这可能导致漏检紧密相邻的不同物体(比如一群站在一起的人),因为其中一个高分框会抑制掉旁边物体的正确预测。
应用:对于常规物体,0.4-0.5是一个常用范围。对于密集、小目标检测(如行人、细胞),可能需要适当调低以防止误抑制。
总结与关系
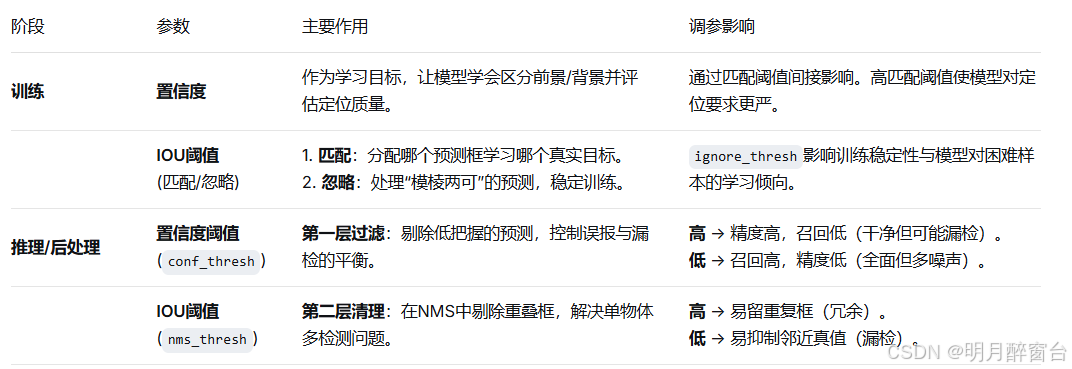
相互关系:
在推理流水线中,这两个阈值顺序工作、共同决定最终输出。首先,conf_thresh砍掉一大片"差生";然后,nms_thresh在剩下的"优等生"里,把那些扎堆报同一答案的只留一个最好的。调整它们中的任何一个,都会直接影响模型的精度-召回率曲线,是模型部署前必须根据实际场景精细调节的超参数。通常的做法是,先在验证集上固定一个IOU阈值(如0.5)绘制P-R曲线,选择满意的置信度阈值,再根据检测结果的密集程度微调NMS的IOU阈值。