在企业知识建设过程中,90% 以上的信息都以非结构化形式存在 :文档、制度、报告、网页、说明书......
这些内容信息密度高,却长期沉睡在文件系统中,难以被计算、难以被复用,更难支撑智能应用。
本期《qKnow 知识平台核心能力解析》,我们将聚焦 非结构化抽取能力,带你系统了解:
qKnow 是如何借助大模型技术,将"看得懂的文档",转化为"用得上的知识图谱"的。
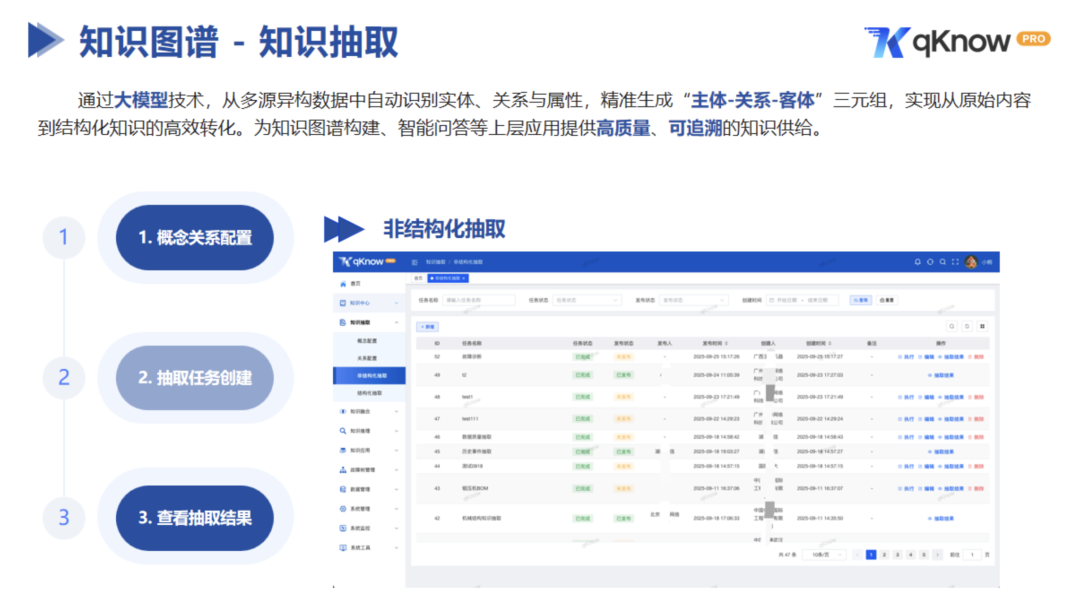
一、什么是非结构化抽取?
非结构化抽取 ,是指通过大模型与知识工程技术,从多源异构的非结构化数据中,自动识别实体、关系与属性,并生成标准化的:
「主体 -- 关系 -- 客体」三元组
从而实现从原始文本 → 结构化知识 → 知识图谱的高效转化。
在 qKnow 中,非结构化抽取并不是"简单的信息识别",而是:
- 以 图谱模型 为约束
- 以 业务语义 为导向
- 以 可追溯、可校验、可发布 为目标
为后续的 知识图谱构建、智能问答、知识检索、推理分析等上层应用,持续提供高质量、可信任的知识供给。
二、多格式知识文件支持|打好知识抽取的"原材料"基础
想要解锁高效的非结构化抽取,第一步一定是:
搞定核心"原材料"------知识文档。
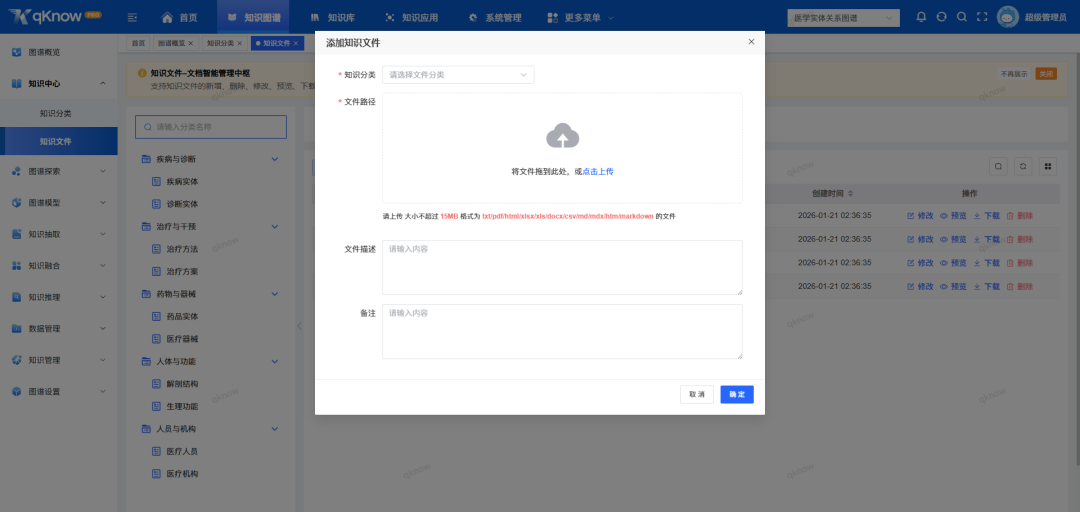
qKnow 在知识抽取阶段,全面支持多种主流非结构化文件格式,包括但不限于:
TXTPDFHTML- 以及常见的结构化/半结构化文本内容
无论是规范制度、技术文档、业务方案,还是网页内容、说明材料,都可以作为抽取对象统一纳入管理。
📌 价值点 :
多格式统一接入,避免重复整理、手工转换,为后续自动抽取打下稳定基础。
三、任务精细化管理|让"抽什么、怎么抽"完全可控
非结构化抽取并非"一键全抽"越多越好,真正高质量的知识抽取,一定是有目标、有边界、有约束的。
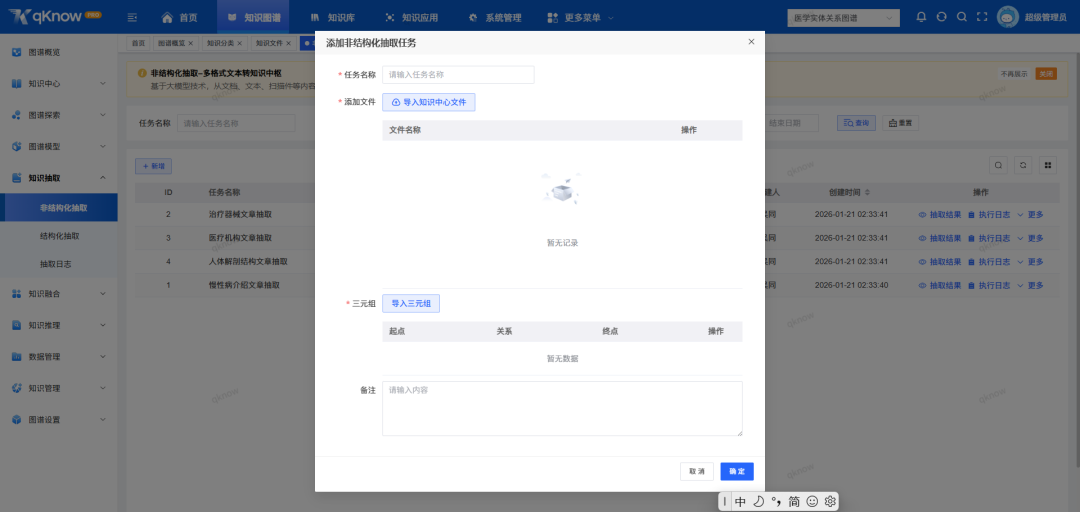
qKnow 支持 非结构化抽取任务的全流程精细化配置:
- 自定义抽取任务名称,便于管理与追溯
- 按需选择本次参与抽取的知识文件
- 精准绑定图谱模型中的概念与关系
- 明确抽取范围,避免无效、冗余或偏离业务语义的结果
通过模型约束 + 任务配置双重机制,让抽取结果更贴合业务真实需求。
📌 价值点 :
从"能抽取"升级为"抽得准、抽得对、抽得有用"。
四、异步抽取能力|高效运行,不打断你的工作节奏
在实际使用过程中,非结构化抽取往往涉及:
- 文档数量多
- 内容体量大
- 抽取过程耗时不确定
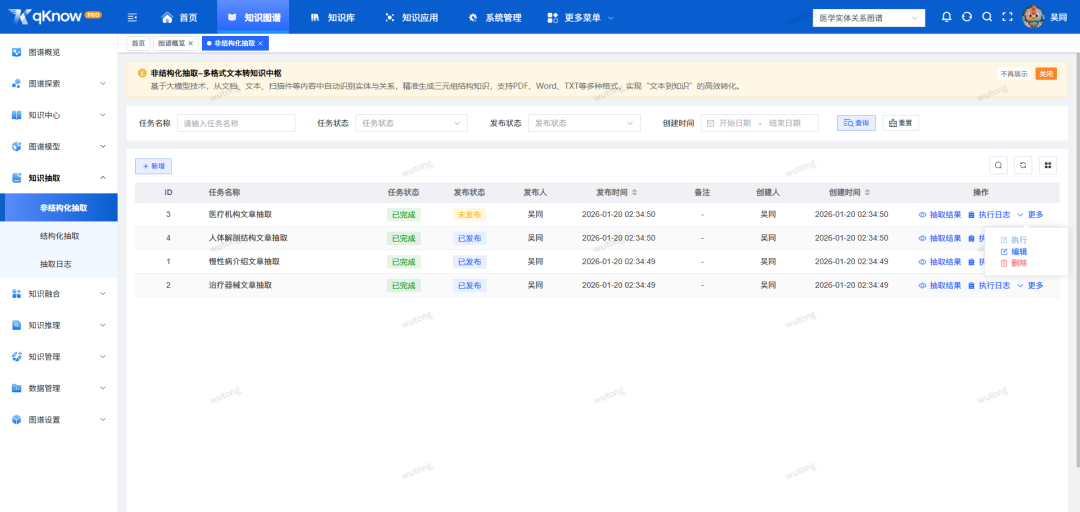
为此,qKnow 提供 异步抽取执行机制:
- 抽取任务提交后即可离开页面
- 不占用人工操作时间
- 可同步处理其他工作事务
- 通过任务状态实时掌握执行进度
真正做到 "后台跑任务,前台不停工"。
📌 价值点 :
提升整体使用体验,让知识工程从"等待型工作"变为"并行型能力"。
五、抽取结果可视化|从"机器结果"到"可信知识"
抽取完成并不代表结束,校验与修正,才是知识可信的关键一步。
qKnow 将抽取结果以 图谱可视化形式 进行集中呈现:
- 实体、关系一目了然
- 支持人工审查与一键修改
- 快速修正个别偏差,避免整体返工
更重要的是,系统支持 实体溯源能力:
- 可查看每条知识对应的原始文本分段
- 精准定位来源文件
- 确保每一条知识"有据可查、有源可溯"
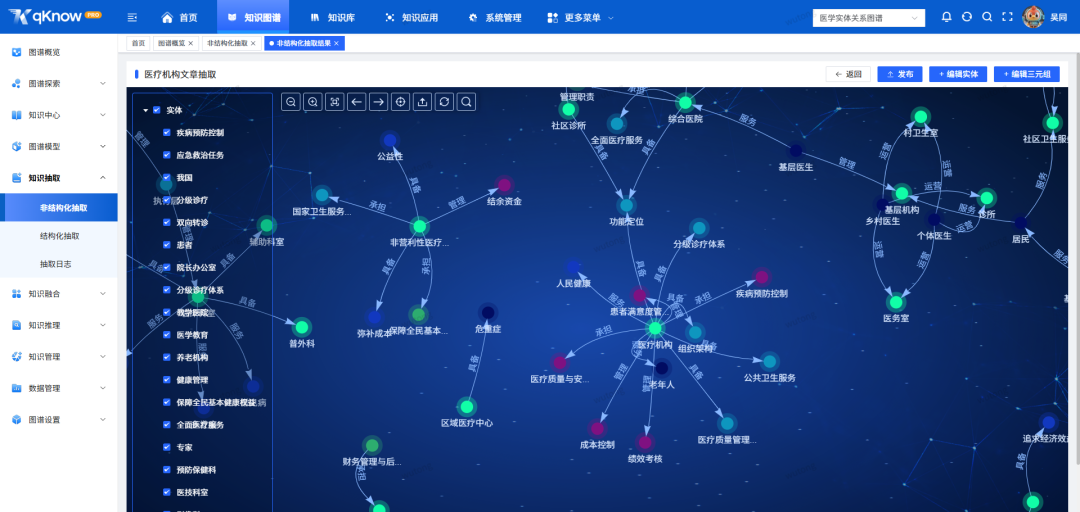
完成核验后的知识图谱,只需 一键发布,即可正式上线,投入实际业务应用。
📌 价值点 :
从"模型产出"到"业务可用",构建可信知识闭环。
六、完整抽取日志|让问题定位不再靠猜
在规模化使用过程中,抽取异常、效果波动是不可避免的。
qKnow 为此提供了 完整、自动留存的抽取日志机制:
- 记录每一次抽取任务的执行过程
- 清晰呈现异常信息与关键节点
- 快速定位问题根源,无需反复排查
无论是模型问题、数据问题,还是配置问题,都可以通过日志快速定位,大幅降低运维和排错成本。
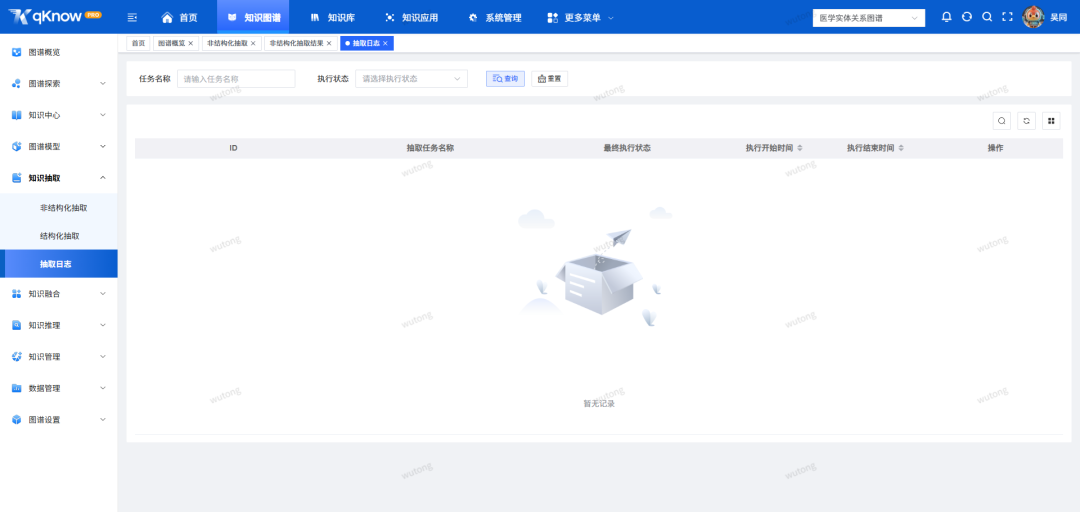
📌 价值点 :
让非结构化抽取从"黑盒过程"变成"可观测系统"。
七、总结|让非结构化数据真正"活"起来
通过以上能力,qKnow 构建了一条完整的非结构化知识抽取闭环:
多格式接入 → 精细化配置 → 异步执行 → 可视化校验 → 溯源发布 → 日志保障
让原本零散、不可计算的非结构化内容,
真正转化为 结构化、可信、可复用的知识资产。
下期预告
下一期《qKnow 知识平台核心能力解析》,我们将带来更偏技术向的深度内容:
《基于 DeepKE,如何进行非结构化抽取》
从底层框架、能力选型到工程实践,带你深入理解 qKnow 非结构化抽取背后的技术实现逻辑。
感谢大家的阅读,我们下期再见 👋