1.获取正负样本长度散点分布
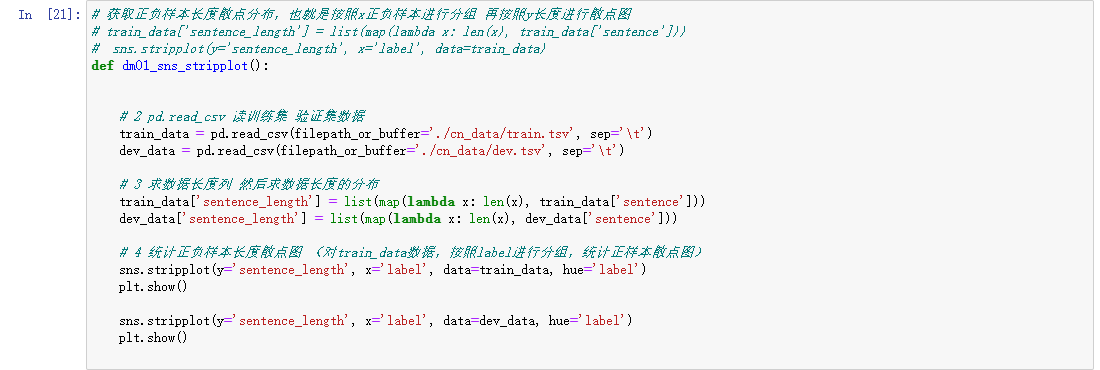
训练集上正负样本的长度散点分布
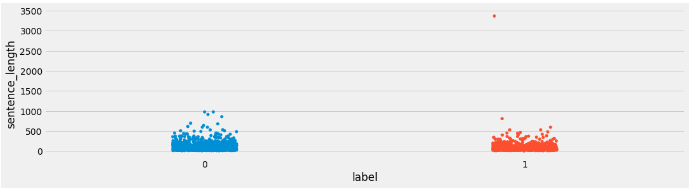
验证集上正负样本的长度散点分布:
分析:
通过查看正负样本长度散点图, 可以有效定位异常点的出现位置, 帮助我们更准确进行人工语料审查. 上图中在训练集正样本中出现了异常点, 它的句子长度近3500左右, 需要我们人工审查.
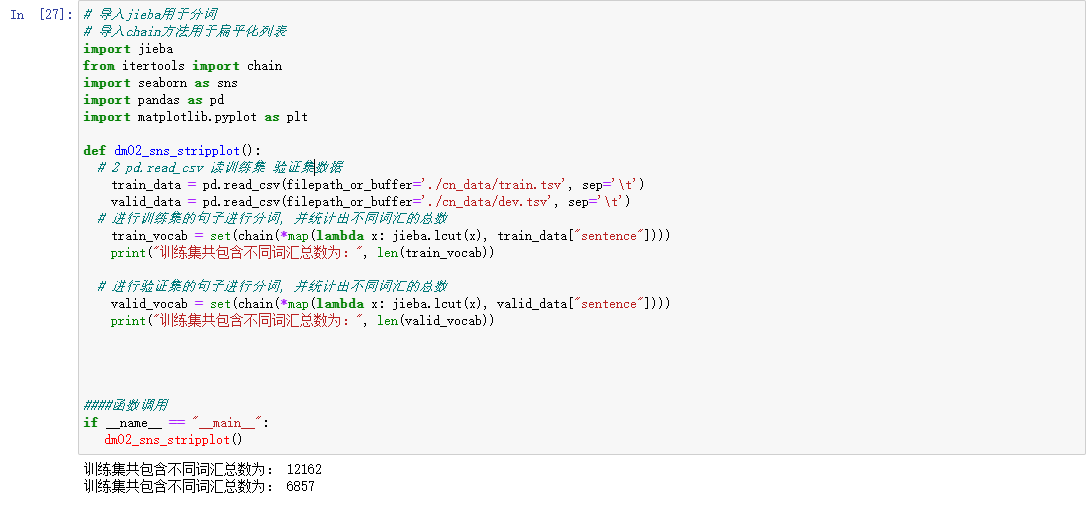
2.获取不同词汇总数统计
3. 获取训练集高频形容词词
思路分析:
1 获得训练集上正样本 p_train_data
eg: 先使用逻辑==操作检索符合正样本 train_datatrain_data\['label' == 1]
2 获取正样本的每个句子的形容词 p_a_train_vocab = chain(*map(a,b))
3 调用绘制词云函数
代码片段:
python
# 使用jieba中的词性标注功能
import jieba.posseg as pseg
from wordcloud import WordCloud

# 每句话产生形容词列表
def get_a_list(text):
    r = []

    # 使用jieba的词性标注方法切分文本 找到形容词存入到列表中返回
    for g in pseg.lcut(text):
        if g.flag == "a":
            r.append(g.word)
    return r

# 根据词云列表产生词云
def  get_word_cloud(keywords_list):
    # 实例化词云生成器对象
    wordcloud = WordCloud(font_path="./SimHei.ttf", max_words=100, background_color='white')
    # 准备数据
    keywords_string = " ".join (keywords_list)
    # 产生词云
    wordcloud.generate(keywords_string)

    # 画图
    plt.figure()
    plt.imshow(wordcloud, interpolation="bilinear")
    plt.axis('off')
    plt.show()
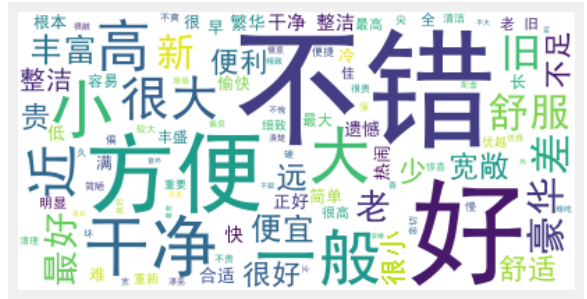
训练集正样本形容词词云:
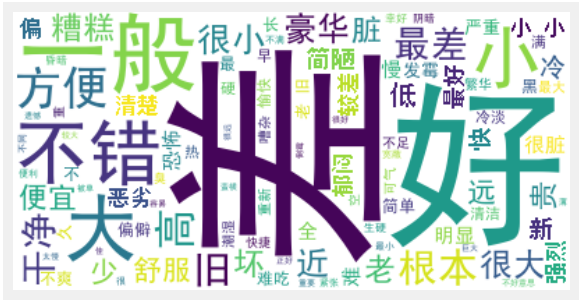
训练集负样本形容词词云:
4 获取验证集形容词词云
python
# 获得验证集上正样本
# 这部分获取的数据有问题,根据自己的路径更改
valid_data = pd.read_csv(filepath_or_buffer='./cn_data/train.tsv', sep='\t')
p_valid_data = valid_data[valid_data["label"]==1]["sentence"]

# 对正样本的每个句子的形容词
valid_p_a_vocab = chain(*map(lambda x: get_a_list(x), p_valid_data))
#print(train_p_n_vocab)

# 获得验证集上负样本
n_valid_data = valid_data[valid_data["label"]==0]["sentence"]

# 获取负样本的每个句子的形容词
valid_n_a_vocab = chain(*map(lambda x: get_a_list(x), n_valid_data))

# 调用绘制词云函数
get_word_cloud(valid_p_a_vocab)
get_word_cloud(valid_n_a_vocab)
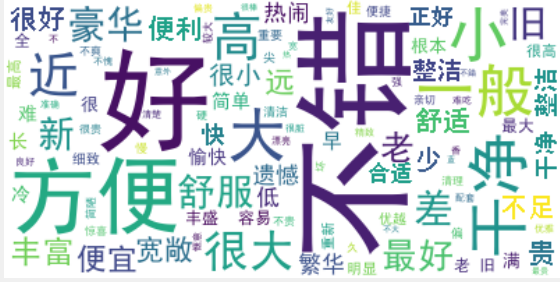
验证集正样本形容词词云
验证集负样本形容词词云:
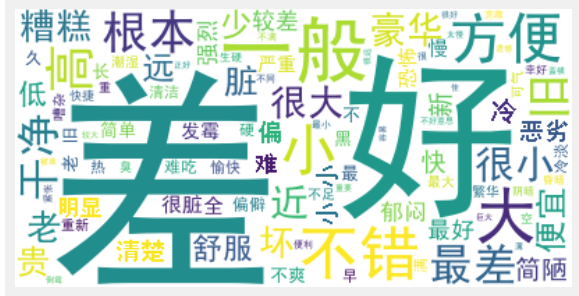
分析:
根据高频形容词词云显示, 我们可以对当前语料质量进行简单评估, 同时对违反语料标签含义的词汇进行人工审查和修正, 来保证绝大多数语料符合训练标准. 上图中的正样本大多数是褒义词, 而负样本大多数是贬义词, 基本符合要求, 但是负样本词云中也存在"便利"这样的褒义词, 因此可以人工进行审查
5.小结
学习了文本数据分析的作用: * 文本数据分析能够有效帮助我们理解数据语料, 快速检查出语料可能存在的问题, 并指导之后模型训练过程中一些超参数的选择.
学习了常用的几种文本数据分析方法: * 标签数量分布 * 句子长度分布 * 词频统计与关键词词云
学习了基于真实的中文酒店评论语料进行几种文本数据分析方法. * 获得训练集和验证集的标签数量分布 * 获取训练集和验证集的句子长度分布 * 获取训练集和验证集的正负样本长度散点分布 * 获得训练集与验证集不同词汇总数统计 * 获得训练集上正负的样本的高频形容词词云