本博客将详细介绍TopK算法的核心
TopK 算法解决的是「从海量数据中找出排名前 K 的元素」的问题(比如前 K 大、前 K 小、前 K 高频),核心目标是在尽可能低的时间 / 空间复杂度下,高效筛选出目标元素
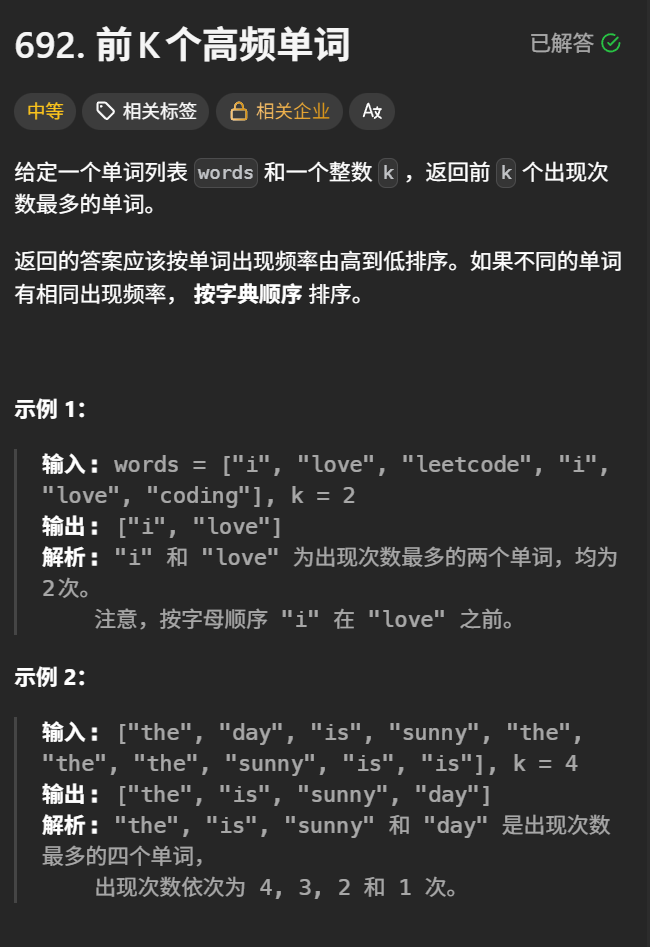
一.第一种解法使用HashMap 类似于全局排序
解法思想:1.通过hashMap统计出 不同单词出现次数
2.循环HashMap.entrySet 去遍历出现次数最多的且当次数一致时单词字典顺序靠前的
3.依次添加到wordList中
这种方法的时间复杂度 是O(N*N) 空间复杂度是O(N)
java
public List<String> topKFrequent(String[] words, int k) {
        List<String>wordList=new ArrayList<>();
        //统计不同 单词出现次数
        HashMap<String,Integer>hashMap=new HashMap<>();
        for(int i=0;i<words.length;i++){
            if(hashMap.containsKey(words[i])){
                int tmp=hashMap.get(words[i]);
               hashMap.put(words[i] ,++tmp);
            }
            else{
                hashMap.put(words[i] ,1);
            }
        }
        //统计完成
        while(k>0){
            int count=0;
            String keyTmp="";
        for(Map.Entry<String,Integer>map:hashMap.entrySet()){
            if(map.getValue()>count){
                count=map.getValue();
                keyTmp=(String)map.getKey();
            }
            else if(map.getValue()==count){
                keyTmp=keyTmp.compareTo(map.getKey())>0?map.getKey():keyTmp;
            }
        }
        wordList.add(keyTmp);
        hashMap.remove(keyTmp);
        k--;
        }

    return wordList;
    }
时间复杂度是O(k*N)
二.使用TopK算法 (使用小根堆)
解法思想:1.hashMap统计单词出现频率
2.使用小跟堆重写compare接口指定比较规则
3.先往小跟堆中添加k个元素 后面按照规则决定是否堆中去除添加新的元素
4.最后 逆置一下数组元素
这中方式的时间复杂度是O(N*lgK) 空间复杂度 是O(N)
java
 public static List<String> topKFrequent(String[] words, int k) {
        List<String>wordList=new ArrayList<>();
        //统计不同 单词出现次数
        HashMap<String,Integer>hashMap=new HashMap<>();
        for(int i=0;i<words.length;i++){
            if(hashMap.containsKey(words[i])){
                int tmp=hashMap.get(words[i]);
                hashMap.put(words[i] ,++tmp);
            }
            else{
                hashMap.put(words[i] ,1);
            }
        }
        //统计完成
        //重写compare接口设定小根堆排序如何比较 比较频率 频率相同比较字典顺序
        //使最开始在 加入堆的时候 堆会按照规则进行排序 避免元素顺序出错
        PriorityQueue<Map.Entry<String,Integer>>minheap=new PriorityQueue<>(new Comparator<Map.Entry<String,Integer>>() {
            @Override
            public int compare(Map.Entry<String, Integer> o1, Map.Entry<String, Integer> o2) {
                if(o1.getValue().compareTo(o2.getValue())==0){//保证频率相同 按照字典顺序小的排在前面
                    return o2.getKey().compareTo(o1.getKey());
                }
                return o1.getValue().compareTo(o2.getValue());
            }
        });
        for(Map.Entry<String,Integer>map:hashMap.entrySet()){
            if(minheap.size()<k){
                minheap.offer(map);
            }
            else{
                if(map.getValue().compareTo(minheap.peek().getValue())>0){
                    minheap.poll();
                    minheap.offer(map);
                }
                else if(map.getValue().compareTo(minheap.peek().getValue())==0){
                    if(map.getKey().compareTo(minheap.peek().getKey())<0){
                        minheap.poll();
                        minheap.offer(map);
                    }
                }
            }
        }
        while(!minheap.isEmpty()){
            wordList.add(minheap.poll().getKey());
        }
        //因为是小跟堆 每次出的堆顶元素都是最小的 需要逆置一下
        Collections.reverse(wordList);
        return wordList;
    }