人工智能学习-AI入试相关题目练习-第十五次
- 1-前言
- 3-问题题目训练
- 【模擬問題①】(既出近似:探索アルゴリズム)
- 【模擬問題②】(既出近似:教師あり学習・最適化)
- 【予測問題①】(新傾向:強化学習・方策の性質)
- 【予測問題②】(新傾向:確率的推論・フィルタリング)
-
- 問題4
- [🔎 出题意图(你自己把握用)](#🔎 出题意图(你自己把握用))
- 4-练习(日语版本)解析
- 【模擬問題①】問題1(探索アルゴリズム)
-
-
- [(a) **最良優先**](#(a) 最良優先)
- [(b) **オープンリスト**](#(b) オープンリスト)
- [(c) **クローズドリスト**](#(c) クローズドリスト)
- [(d) **空**](#(d) 空)
- [(e) **小さい**](#(e) 小さい)
- [(f) **g(s)**](#(f) g(s))
- [(g) **h(s)**](#(g) h(s))
- [(h) **f(s)**](#(h) f(s))
- [(i) **昇順**](#(i) 昇順)
-
- 【模擬問題②】問題2(教師あり学習)
-
-
- [(a) **正解ラベル**](#(a) 正解ラベル)
- [(b) **損失関数**](#(b) 損失関数)
- [(c) **勾配**](#(c) 勾配)
- [(d) **学習率**](#(d) 学習率)
- [(e) **局所最小値**](#(e) 局所最小値)
- [(f) **正則化**](#(f) 正則化)
- [(g) **早期終了**](#(g) 早期終了)
-
- 【予測問題①】問題3(強化学習・方策)
-
-
- [(a) **方策**](#(a) 方策)
- [(b) **グリーディ**](#(b) グリーディ)
- [(c) **ε**](#(c) ε)
- [(d) **1−ε**](#(d) 1−ε)
- [(e) **ε-グリーディ**](#(e) ε-グリーディ)
- [(f) **ボルツマン**](#(f) ボルツマン)
- [(g) **確率的**](#(g) 確率的)
-
- 【予測問題②】問題4(確率的推論)
-
-
- [(a) **ノイズ**](#(a) ノイズ)
- [(b) **確率分布**](#(b) 確率分布)
- [(c) **予測**](#(c) 予測)
- [(d) **観測更新**](#(d) 観測更新)
- [(e) **状態遷移モデル**](#(e) 状態遷移モデル)
- [(f) **尤度**](#(f) 尤度)
- [(g) **正規化**](#(g) 正規化)
-
- 5-练习(日语版本)
- 6-总结
1-前言
为了应对大学院考试,我们来学习相关人工智能相关知识,并做各种练习。
通过学习,也算是做笔记,让自己更理解些。
3-问题题目训练
【模擬問題①】(既出近似:探索アルゴリズム)
問題1
探索問題において,評価値に基づいて探索順序を決定する手法を (a) 探索という。
この探索では,探索候補を保持する (b) と,すでに展開済みのノードを保持する © を用いる。
初期状態は (b) に追加され,© は (d) に初期化される。
各反復では,(b) から評価値が最も (e) ノードを取り出し,© に追加する。
ノードの評価値は,一般に実コスト (f) と
ヒューリスティック関数 (g) に基づいて定義され,
探索候補は評価値 (h) の (i) 順に並べ替えられる。
(a)~(i) に入る最も適切な語句を記せ。
【模擬問題②】(既出近似:教師あり学習・最適化)
問題2
教師あり学習では,入力データとそれに対応する (a) の組を用いて学習を行う。
モデルの学習は,出力と正解との差を表す (b) を最小化する問題として定式化される。
この最適化においては,誤差関数の © を計算し,
更新量を制御する (d) を用いてパラメータを更新する。
しかし,誤差関数が非凸である場合,学習は (e) に収束する可能性がある。
この問題を抑制するため,(f) を導入する手法や,
学習途中で更新を停止する (g) が用いられる。
(a)~(g) に入る語句を記せ。
【予測問題①】(新傾向:強化学習・方策の性質)
問題3
強化学習において,エージェントは状態に応じて行動を選択するための
方策 (a) を用いて行動を決定する。
常に最も価値の高い行動を選択する方策を (b) 法といい,
探索を全く行わないという特徴を持つ。
一方,確率 © でランダムに行動を選択し,
確率 (d) で (b) 法に基づく行動選択を行う手法を (e) 法という。
さらに,行動価値に基づいて確率分布を構成し,
確率的に行動を選択する手法では,(f) 分布が用いられる。
この分布は,行動価値の差を (g) に反映する特徴を持つ。
(a)~(g) に入る最も適切な語句を記せ。
【予測問題②】(新傾向:確率的推論・フィルタリング)
問題4
実世界における状態推定問題では,観測情報に (a) が含まれるため,
現在の状態を一意に決定できない場合が多い。
このような場合,状態を単一の値ではなく (b) として表現し,
観測が得られるたびにその分布を更新する手法が用いられる。
この更新は,© ステップと (d) ステップから構成され,
前者では (e) に基づいて状態分布を推定する。
後者では観測モデルを用いて (f) を計算し,
分布の総和が 1 となるように (g) を行う。
(a)~(g) に入る語句を記せ。
🔎 出题意图(你自己把握用)
-
模擬①②
→ 探索アルゴリズム / 勾配最適化
→ 立命馆"反复出现的安全区"
-
予測③④
→ 方策の性質(exploration vs exploitation)
→ 確率的状態推定(フィルタ構造理解)
4-练习(日语版本)解析
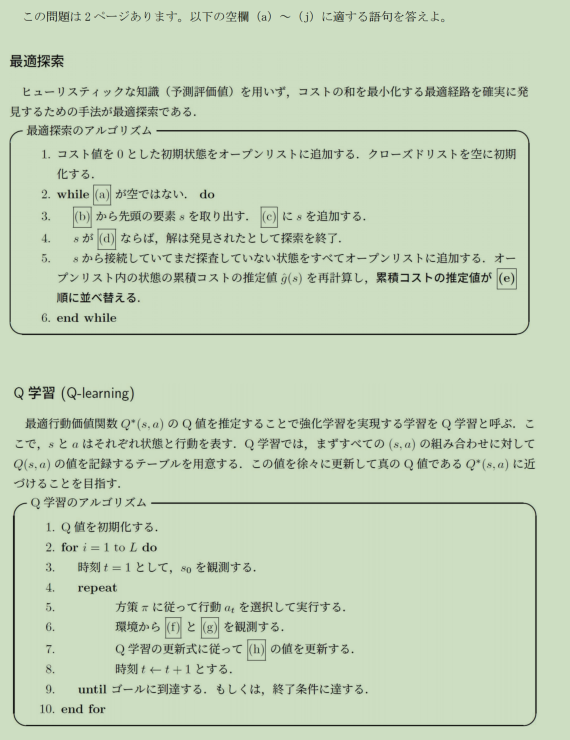
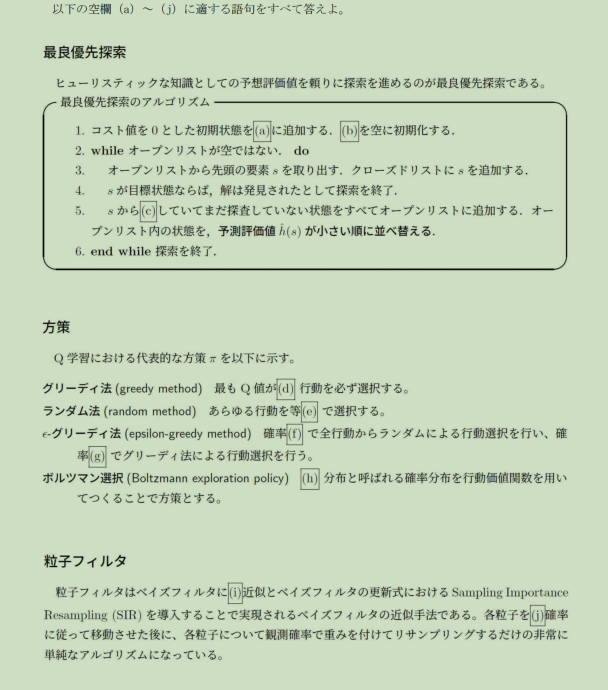
【最良優先探索】
- (a) オープンリスト
- (b) オープンリスト
- © クローズドリスト
- (d) 目標状態
- (e) 小さい
【Q学習:方策】
- (f) ε
- (g) 1−ε
- (h) ボルツマン
【粒子フィルタ】
- (i) 近似
- (j) 確率
【ベイズフィルタ】
- (i) a_{t-1}
- (j) 正規化
✅ 一覧(答案だけまとめ)
(a) オープンリスト
(b) オープンリスト
(c) クローズドリスト
(d) 目標状態
(e) 小さい
(f) ε
(g) 1−ε
(h) ボルツマン
(i) 近似
(j) 確率
(i) a_{t-1}
(j) 正規化
【模擬問題①】問題1(探索アルゴリズム)
(a) 最良優先
なぜ?
题干写的是「評価値に基づいて探索順序を決定 」,
这是 最良優先探索(Best-first search) 的定义用语。
如果是幅優先或深さ優先,就不会提评价值。
(b) オープンリスト
なぜ?
「探索候補を保持する」列表在搜索算法中固定称呼 就是
オープンリスト(未展开节点集合)。
© クローズドリスト
なぜ?
「すでに展開済みのノード」
→ 已处理过、不再展开
→ 标准术语只能是 クローズドリスト。
(d) 空
なぜ?
初始时尚未展开任何节点,
所以「クローズドリストは空に初期化」是固定句型。
(e) 小さい
なぜ?
最良優先探索的基本规则是
評価値が最も小さいノードを優先
写「大きい」会直接变成错误算法。
(f) g(s)
なぜ?
题干中明确写「実コスト 」
在搜索算法中,实际累计代价的标准记号是 g(s)。
(g) h(s)
なぜ?
「ヒューリスティック関数」在 AI 课程中
统一用 h(s) 表示,不可换成别的符号。
(h) f(s)
なぜ?
后文说「評価値」,
在最良优先 / A* 系算法中,
评价值统一写作 f(s)。
(i) 昇順
なぜ?
评价值越小越优先,
所以列表排序方式只能是
「小さい順 = 昇順」。
【模擬問題②】問題2(教師あり学習)
(a) 正解ラベル
なぜ?
教师学习的定义就是
入力データ+正解
"正解"在日文标准术语中就是 正解ラベル。
(b) 損失関数
なぜ?
题干说「出力と正解との差」
这是损失函数的教科书定义。
© 勾配
なぜ?
参数更新方向由
(\partial L / \partial \theta) 决定,
这在日文中只能叫 勾配。
(d) 学習率
なぜ?
「更新量を制御する」
→ 控制一步走多远
→ 学習率 的定义。
(e) 局所最小値
なぜ?
非凸函数 → 可能停在"不是全局最优"的点,
标准表述只能是 局所最小値。
(f) 正則化
なぜ?
抑制模型复杂度、避免过拟合
→ 教科书中唯一标准术语是 正則化。
(g) 早期終了
なぜ?
"学習途中で停止"
→ 这在日文中固定叫 早期終了(Early Stopping)。
【予測問題①】問題3(強化学習・方策)
(a) 方策
なぜ?
状态 → 行动的规则
→ 在强化学习中唯一术语是 方策(policy)。
(b) グリーディ
なぜ?
"常に最も価値の高い行動"
这是 greedy policy 的定义句。
© ε
なぜ?
ε-greedy 中
"随机的概率"固定用 ε 表示。
(d) 1−ε
なぜ?
随机 ε + 贪婪 1−ε
这是必成对出现的概率。
(e) ε-グリーディ
なぜ?
题干完整描述了 ε-greedy 的行为规则,
名称只能填 ε-グリーディ。
(f) ボルツマン
なぜ?
"根据价值构成概率分布"
→ 指的是 Boltzmann exploration。
(g) 確率的
なぜ?
Boltzmann 的核心特征是
"价值差 平滑地反映到概率 ",
不是确定性选择。
【予測問題②】問題4(確率的推論)
(a) ノイズ
なぜ?
观测不可靠 → 原因是噪声
→ 标准术语 ノイズ。
(b) 確率分布
なぜ?
"不是单一值,而是整体可能性"
→ 只能用 確率分布。
© 予測
なぜ?
利用前一状态 + 行动
→ Bayes filter 中第一步固定叫 予測。
(d) 観測更新
なぜ?
用观测修正预测
→ 第二步固定叫 観測更新。
(e) 状態遷移モデル
なぜ?
预测阶段"基づく模型"
→ 状态怎么变 → 状態遷移モデル。
(f) 尤度
なぜ?
观测模型计算的是
"在该状态下看到该观测的可能性"
→ 尤度。
(g) 正規化
なぜ?
概率之和必须为 1
→ 必须进行 正規化。
5-练习(日语版本)
6-总结
知识一点点记录吧,最后应对考试,打下基础