开篇引言:为什么数据结构是你的编程基石?
大家好,我是你们的朋友老赵。回想我初学编程时,最让我头疼的就是数据结构------那些抽象的数组、链表、哈希表,就像一堆没有拼图说明的碎片。但当我真正理解它们后,才发现数据结构是编程世界的乐高积木,掌握它们,你就能构建出任何复杂的系统。
为什么数据结构如此重要?
-
面试必考:90%的技术面试都会考察数据结构
-
性能关键:选错数据结构,系统可能慢10倍、100倍
-
思维训练:培养你的计算思维和问题分解能力
-
框架基础:所有流行框架(Spring、MyBatis)底层都基于这些数据结构
学习路线图:
第1步:理解基础概念(2天) → 第2步:掌握核心类使用(3天) →
第3步:深入源码原理(5天) → 第4步:实战应用(持续练习)
一、数据结构分类体系:Collection和Map的家族图谱
在Java中,所有数据结构可以分为两大阵营,它们的关系如下:
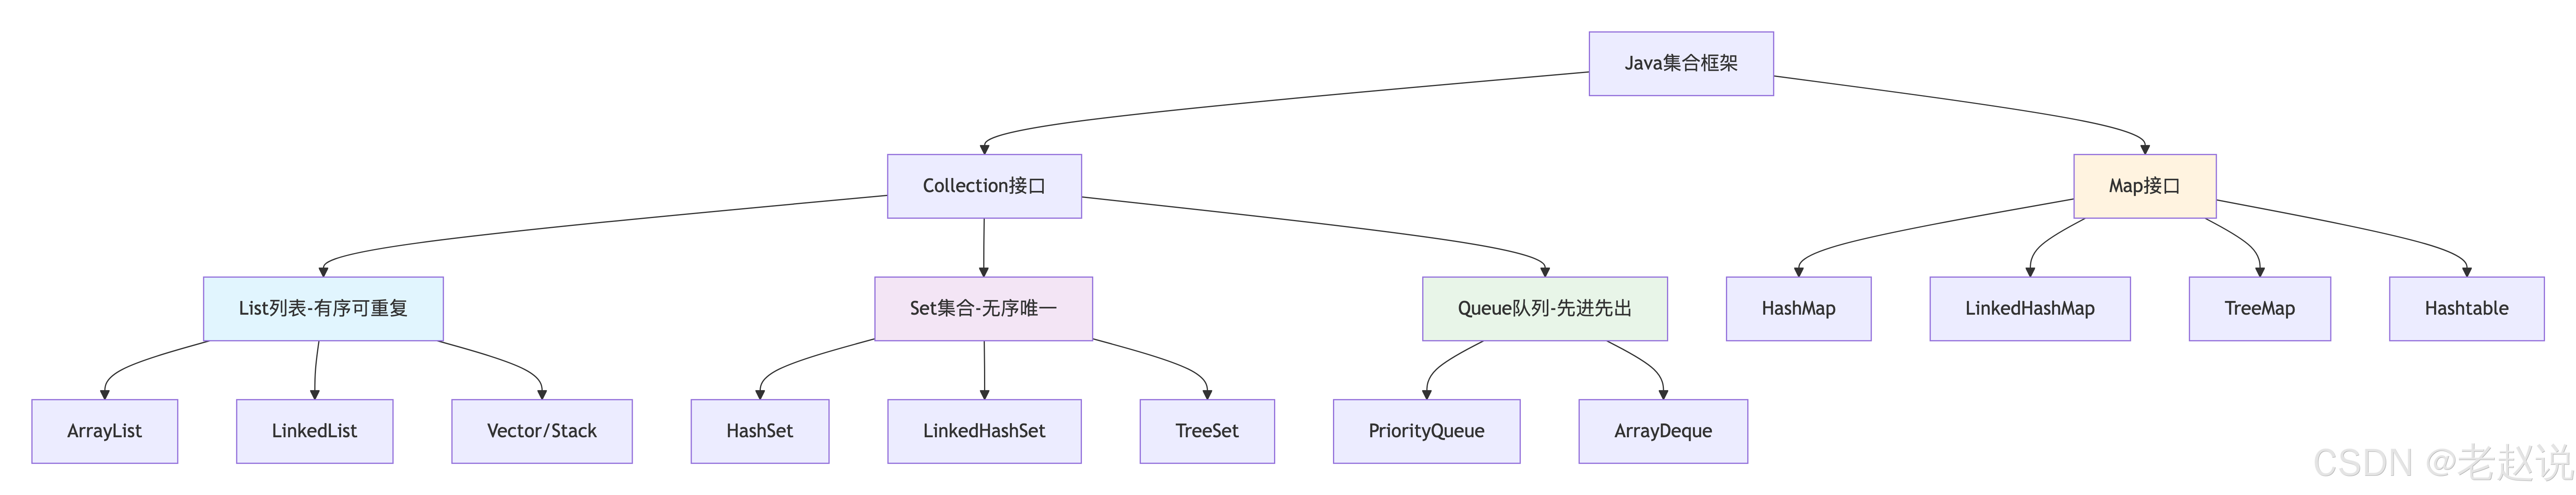
关键点总结:
-
Collection:存储单个元素的集合,分为List、Set、Queue
-
Map:存储键值对(key-value)的映射表
-
虚线框表示已过时或不推荐使用的类
二、线性结构详解:数组、ArrayList、LinkedList
2.1 数组:最基础的连续存储结构
生活化比喻:数组就像电影院的座位,每个座位有固定编号(索引),按顺序排列,可以直接通过座位号找到人。
public class ArrayDemo {
    public static void main(String[] args) {
        // 1. 数组的声明和初始化
        int[] seats = new int[10]; // 创建10个座位的电影院
        String[] movieNames = {"复仇者联盟", "流浪地球", "泰坦尼克号"};

        // 2. 基本操作:增删改查
        // 查:根据索引快速访问 O(1)
        System.out.println("第一个电影:" + movieNames[0]);

        // 改:修改指定位置的值 O(1)
        movieNames[1] = "流浪地球2";

        // 增:数组大小固定,"增"需要创建新数组
        String[] newMovies = new String[movieNames.length + 1];
        System.arraycopy(movieNames, 0, newMovies, 0, movieNames.length);
        newMovies[newMovies.length - 1] = "阿凡达";

        // 删:同样需要创建新数组
        String[] deletedMovies = new String[movieNames.length - 1];
        System.arraycopy(movieNames, 0, deletedMovies, 0, 1);
        System.arraycopy(movieNames, 2, deletedMovies, 1, deletedMovies.length - 1);

        // 3. 遍历数组
        System.out.println("\n所有电影:");
        for (int i = 0; i < movieNames.length; i++) {
            System.out.println("座位 " + i + ": " + movieNames[i]);
        }

        // 4. 数组的局限性
        // 大小固定,无法动态扩容
        // 插入/删除中间元素效率低,需要移动大量元素
    }
}
内存布局图:
栈内存                 堆内存
┌─────────┐         ┌─────────┐
│ arr引用 │ ------> │ 索引0   │ → "A"
├─────────┤         ├─────────┤
│         │         │ 索引1   │ → "B"
│         │         ├─────────┤
│         │         │ 索引2   │ → "C"
│         │         ├─────────┤
│         │         │ ...     │
└─────────┘         └─────────┘
连续内存空间,支持随机访问
2.2 ArrayList:动态数组的王者
核心特点:基于数组实现,但可以动态扩容。
import java.util.ArrayList;
import java.util.Arrays;

public class ArrayListDemo {
    public static void main(String[] args) {
        // 示例1:基础用法
        System.out.println("=== 示例1:ArrayList基础操作 ===");
        ArrayList<String> shoppingCart = new ArrayList<>();

        // 添加商品到购物车
        shoppingCart.add("iPhone 15");
        shoppingCart.add("MacBook Pro");
        shoppingCart.add("AirPods");
        System.out.println("购物车商品:" + shoppingCart);

        // 随机访问:O(1)
        System.out.println("第二件商品:" + shoppingCart.get(1));

        // 中间插入:需要移动元素 O(n)
        shoppingCart.add(1, "iPad Pro");
        System.out.println("插入后购物车:" + shoppingCart);

        // 删除:同样需要移动元素 O(n)
        shoppingCart.remove("AirPods");
        System.out.println("删除后购物车:" + shoppingCart);

        // 示例2:自动扩容机制演示
        System.out.println("\n=== 示例2:ArrayList扩容演示 ===");
        ArrayList<Integer> numbers = new ArrayList<>(3); // 初始容量3
        System.out.println("初始容量:" + getCapacity(numbers) + ",大小:" + numbers.size());

        for (int i = 1; i <= 10; i++) {
            numbers.add(i);
            if (i % 3 == 0) {
                System.out.println("添加" + i + "个元素后,容量:" + getCapacity(numbers) +
                                 ",大小:" + numbers.size());
            }
        }

        // 示例3:常见错误和正确写法
        System.out.println("\n=== 示例3:常见陷阱 ===");
        ArrayList<Integer> list1 = new ArrayList<>(Arrays.asList(1, 2, 3, 4, 5));

        // ❌ 错误:在遍历时删除元素(可能抛出ConcurrentModificationException)
        // for (Integer num : list1) {
        //     if (num % 2 == 0) {
        //         list1.remove(num);
        //     }
        // }

        // ✅ 正确:使用迭代器或从后往前遍历
        for (int i = list1.size() - 1; i >= 0; i--) {
            if (list1.get(i) % 2 == 0) {
                list1.remove(i);
            }
        }
        System.out.println("删除偶数后:" + list1);
    }

    // 反射获取ArrayList的容量(实际开发中不建议使用反射)
    private static int getCapacity(ArrayList<?> list) {
        try {
            java.lang.reflect.Field field = ArrayList.class.getDeclaredField("elementData");
            field.setAccessible(true);
            Object[] elementData = (Object[]) field.get(list);
            return elementData.length;
        } catch (Exception e) {
            return -1;
        }
    }
}
ArrayList源码解析:自动扩容机制
// JDK中的关键源码解析
public boolean add(E e) {
    modCount++; // 结构修改次数,用于快速失败机制
    add(e, elementData, size);
    return true;
}

private void add(E e, Object[] elementData, int s) {
    if (s == elementData.length)  // 如果数组已满
        elementData = grow();      // 触发扩容
    elementData[s] = e;
    size = s + 1;
}

private Object[] grow() {
    return grow(size + 1);
}

private Object[] grow(int minCapacity) {
    int oldCapacity = elementData.length;
    if (oldCapacity > 0 || elementData != DEFAULTCAPACITY_EMPTY_ELEMENTDATA) {
        // 核心扩容逻辑:新容量 = 旧容量 * 1.5
        int newCapacity = ArraysSupport.newLength(oldCapacity,
                minCapacity - oldCapacity,  // 最小增长量
                oldCapacity >> 1);           // 首选增长量:旧容量的一半
        return elementData = Arrays.copyOf(elementData, newCapacity);
    } else {
        // 第一次扩容:默认容量10
        return elementData = new Object[Math.max(DEFAULT_CAPACITY, minCapacity)];
    }
}
扩容过程图示:
初始状态:容量=3,size=0
[null, null, null]

添加3个元素后:容量=3,size=3(已满)
[A, B, C]

添加第4个元素时触发扩容:
旧容量=3 → 计算新容量=3 + (3 >> 1) = 3 + 1 = 4
但minCapacity=size+1=4,取max(4,4)=4
实际扩容后容量=4
[A, B, C, D, null, null]
2.3 LinkedList:双向链表的灵活实现
生活化比喻:LinkedList就像一列火车,每节车厢(节点)都连接着前后车厢,可以轻松在任意位置插入或移除车厢。
import java.util.LinkedList;

public class LinkedListDemo {
    public static void main(String[] args) {
        // 示例1:基础操作
        System.out.println("=== 示例1:LinkedList基础操作 ===");
        LinkedList<String> train = new LinkedList<>();

        // 添加车厢
        train.add("车头");
        train.add("客厢1");
        train.add("客厢2");
        train.add("车尾");
        System.out.println("初始列车:" + train);

        // 在头部和尾部快速插入
        train.addFirst("动力厢");
        train.addLast("行李厢");
        System.out.println("添加头尾后:" + train);

        // 中间插入:不需要移动元素,只需改变指针
        train.add(3, "餐车");
        System.out.println("插入餐车后:" + train);

        // 随机访问效率低:需要遍历 O(n)
        System.out.println("第4节车厢:" + train.get(3));

        // 示例2:实现队列和栈的功能
        System.out.println("\n=== 示例2:作为队列和栈使用 ===");

        // 作为队列(先进先出)
        LinkedList<String> queue = new LinkedList<>();
        queue.offer("任务1"); // 入队
        queue.offer("任务2");
        queue.offer("任务3");
        System.out.println("队列:" + queue);
        System.out.println("出队:" + queue.poll() + ",剩余:" + queue);

        // 作为栈(后进先出)
        LinkedList<String> stack = new LinkedList<>();
        stack.push("页面1"); // 入栈
        stack.push("页面2");
        stack.push("页面3");
        System.out.println("栈:" + stack);
        System.out.println("出栈:" + stack.pop() + ",剩余:" + stack);

        // 示例3:实际应用 - 浏览器历史记录
        System.out.println("\n=== 示例3:浏览器历史记录模拟 ===");
        BrowserHistory browser = new BrowserHistory();
        browser.visit("https://www.google.com");
        browser.visit("https://www.github.com");
        browser.visit("https://www.stackoverflow.com");

        System.out.println("当前页面:" + browser.getCurrent());
        System.out.println("后退:" + browser.back());
        System.out.println("再后退:" + browser.back());
        System.out.println("前进:" + browser.forward());
    }
}

class BrowserHistory {
    private LinkedList<String> history = new LinkedList<>();
    private int currentIndex = -1;

    public void visit(String url) {
        // 清除当前页面之后的历史记录
        while (history.size() > currentIndex + 1) {
            history.removeLast();
        }
        history.add(url);
        currentIndex++;
        System.out.println("访问:" + url);
    }

    public String back() {
        if (currentIndex > 0) {
            currentIndex--;
            return history.get(currentIndex);
        }
        return null;
    }

    public String forward() {
        if (currentIndex < history.size() - 1) {
            currentIndex++;
            return history.get(currentIndex);
        }
        return null;
    }

    public String getCurrent() {
        return currentIndex >= 0 ? history.get(currentIndex) : null;
    }
}
LinkedList节点结构图:
双向链表节点结构:
┌──────────┬─────────┬──────────┐
│ prev指针 │ 数据data │ next指针 │
└──────────┴─────────┴──────────┘
    ↑           ↑           ↑
指向前一节点  存储数据   指向后一节点

完整链表示意图:
头节点 ↔ 节点1 ↔ 节点2 ↔ 节点3 ↔ 尾节点
2.4 Vector:线程安全的动态数组(已过时)
// Vector与ArrayList的主要区别:
// 1. Vector是线程安全的(方法用synchronized修饰)
// 2. Vector默认扩容为2倍,ArrayList是1.5倍
// 3. 现代开发中推荐使用Collections.synchronizedList或CopyOnWriteArrayList替代

import java.util.Vector;
import java.util.Collections;

public class VectorDemo {
    public static void main(String[] args) {
        // 不推荐直接使用Vector
        Vector<String> oldVector = new Vector<>();

        // 推荐替代方案1:使用synchronizedList包装
        java.util.List<String> syncList =
            Collections.synchronizedList(new ArrayList<>());

        // 推荐替代方案2:读多写少场景用CopyOnWriteArrayList
        java.util.concurrent.CopyOnWriteArrayList<String> copyOnWriteList =
            new java.util.concurrent.CopyOnWriteArrayList<>();
    }
}
三、栈和队列:LIFO和FIFO的经典结构
3.1 Stack:后进先出的栈结构
生活化比喻:就像一叠盘子,你只能从最上面取放(后放上去的盘子先被取走)。
import java.util.Stack;

public class StackDemo {
    public static void main(String[] args) {
        // 示例1:基础操作
        System.out.println("=== 示例1:栈的基本操作 ===");
        Stack<String> plateStack = new Stack<>();

        plateStack.push("盘子1"); // 入栈
        plateStack.push("盘子2");
        plateStack.push("盘子3");

        System.out.println("栈内容:" + plateStack);
        System.out.println("栈顶元素:" + plateStack.peek()); // 查看栈顶
        System.out.println("出栈:" + plateStack.pop());     // 出栈
        System.out.println("出栈后:" + plateStack);

        // 示例2:实际应用 - 括号匹配检查
        System.out.println("\n=== 示例2:括号匹配检查 ===");
        String[] testCases = {
            "((()))",      // 有效
            "(()()())",    // 有效
            "(()",         // 无效
            "())(",        // 无效
            "({[]})"       // 有效
        };

        for (String expr : testCases) {
            boolean isValid = checkParentheses(expr);
            System.out.println(expr + " : " + (isValid ? "✓ 有效" : "✗ 无效"));
        }

        // 示例3:表达式求值(逆波兰表达式)
        System.out.println("\n=== 示例3:逆波兰表达式求值 ===");
        String[] rpnExpression = {"2", "1", "+", "3", "*"};
        int result = evaluateRPN(rpnExpression);
        System.out.println("表达式: 2 1 + 3 * = " + result); // (2+1)*3 = 9
    }

    // 括号匹配算法
    public static boolean checkParentheses(String expression) {
        Stack<Character> stack = new Stack<>();

        for (char ch : expression.toCharArray()) {
            if (ch == '(' || ch == '{' || ch == '[') {
                stack.push(ch);
            } else if (ch == ')' || ch == '}' || ch == ']') {
                if (stack.isEmpty()) return false;

                char top = stack.pop();
                if (!isMatchingPair(top, ch)) {
                    return false;
                }
            }
        }

        return stack.isEmpty();
    }

    private static boolean isMatchingPair(char left, char right) {
        return (left == '(' && right == ')') ||
               (left == '{' && right == '}') ||
               (left == '[' && right == ']');
    }

    // 逆波兰表达式求值
    public static int evaluateRPN(String[] tokens) {
        Stack<Integer> stack = new Stack<>();

        for (String token : tokens) {
            if (token.equals("+")) {
                stack.push(stack.pop() + stack.pop());
            } else if (token.equals("-")) {
                int b = stack.pop();
                int a = stack.pop();
                stack.push(a - b);
            } else if (token.equals("*")) {
                stack.push(stack.pop() * stack.pop());
            } else if (token.equals("/")) {
                int b = stack.pop();
                int a = stack.pop();
                stack.push(a / b);
            } else {
                stack.push(Integer.parseInt(token));
            }
        }

        return stack.pop();
    }
}
3.2 Queue和Deque:队列和双端队列
生活化比喻:队列就像超市收银台排队,先来的顾客先结账(FIFO);双端队列就像地铁车厢,可以从任意门上下车。
import java.util.*;

public class QueueDemo {
    public static void main(String[] args) {
        // 示例1:普通队列(LinkedList实现)
        System.out.println("=== 示例1:队列Queue使用 ===");
        Queue<String> supermarketQueue = new LinkedList<>();

        // 入队
        supermarketQueue.offer("顾客A");
        supermarketQueue.offer("顾客B");
        supermarketQueue.offer("顾客C");
        System.out.println("当前队列:" + supermarketQueue);

        // 出队
        System.out.println("服务:" + supermarketQueue.poll());
        System.out.println("剩余队列:" + supermarketQueue);

        // 查看队首
        System.out.println("下一位:" + supermarketQueue.peek());

        // 示例2:优先级队列(堆实现)
        System.out.println("\n=== 示例2:优先级队列PriorityQueue ===");
        PriorityQueue<Task> taskQueue = new PriorityQueue<>(
            Comparator.comparingInt(Task::getPriority)
        );

        taskQueue.offer(new Task("写周报", 3));
        taskQueue.offer(new Task("修复紧急bug", 1));
        taskQueue.offer(new Task("技术分享", 5));
        taskQueue.offer(new Task("代码评审", 2));

        System.out.println("按优先级处理任务:");
        while (!taskQueue.isEmpty()) {
            System.out.println("处理:" + taskQueue.poll());
        }

        // 示例3:双端队列Deque
        System.out.println("\n=== 示例3:双端队列Deque ===");
        Deque<String> deque = new ArrayDeque<>();

        // 可以从两端操作
        deque.addFirst("头部1"); // 头部添加
        deque.addLast("尾部1");  // 尾部添加
        deque.offerFirst("头部2");
        deque.offerLast("尾部2");

        System.out.println("双端队列:" + deque);
        System.out.println("移除头部:" + deque.removeFirst());
        System.out.println("移除尾部:" + deque.removeLast());
        System.out.println("剩余队列:" + deque);

        // 示例4:实际应用 - 滑动窗口最大值
        System.out.println("\n=== 示例4:滑动窗口最大值 ===");
        int[] nums = {1, 3, -1, -3, 5, 3, 6, 7};
        int k = 3;
        int[] maxValues = maxSlidingWindow(nums, k);
        System.out.println("数组:" + Arrays.toString(nums));
        System.out.println("窗口大小" + k + "的最大值:" + Arrays.toString(maxValues));
    }

    static class Task {
        String name;
        int priority; // 数字越小优先级越高

        public Task(String name, int priority) {
            this.name = name;
            this.priority = priority;
        }

        public int getPriority() {
            return priority;
        }

        @Override
        public String toString() {
            return String.format("Task[%s, 优先级:%d]", name, priority);
        }
    }

    // 滑动窗口最大值算法(使用双端队列)
    public static int[] maxSlidingWindow(int[] nums, int k) {
        if (nums == null || nums.length == 0) return new int[0];

        int n = nums.length;
        int[] result = new int[n - k + 1];
        Deque<Integer> deque = new ArrayDeque<>(); // 存储索引

        for (int i = 0; i < n; i++) {
            // 移除超出窗口范围的元素
            while (!deque.isEmpty() && deque.peekFirst() < i - k + 1) {
                deque.pollFirst();
            }

            // 移除比当前元素小的元素,保持队列递减
            while (!deque.isEmpty() && nums[deque.peekLast()] < nums[i]) {
                deque.pollLast();
            }

            // 添加当前元素索引
            deque.offerLast(i);

            // 记录窗口最大值
            if (i >= k - 1) {
                result[i - k + 1] = nums[deque.peekFirst()];
            }
        }

        return result;
    }
}
栈和队列对比图:
栈(Stack) - LIFO(后进先出)
    压栈(push) →     出栈(pop)
        ↓                ↓
    ┌─────┐          ┌─────┐
    │  3  │ ← 栈顶   │  3  │ ← 栈顶
    ├─────┤          ├─────┤
    │  2  │          │  2  │
    ├─────┤          ├─────┤
    │  1  │ ← 栈底   │  1  │ ← 栈底
    └─────┘          └─────┘

队列(Queue) - FIFO(先进先出)
    入队(offer) →    出队(poll)
        ↓                ↓
    ┌─────┐          ┌─────┐
    │  3  │ ← 队尾   │     │
    ├─────┤          ├─────┤
    │  2  │          │  3  │ ← 队尾
    ├─────┤          ├─────┤
    │  1  │ ← 队首   │  2  │ ← 队首
    └─────┘          └─────┘
四、集合框架:Set系列的去重艺术
4.1 HashSet:基于哈希表的无序集合
生活化比喻:就像图书馆的索引系统,每本书有唯一的ISBN号,通过这个号码可以快速找到书的位置,但不能保证书是按顺序摆放的。
import java.util.*;

public class SetDemo {
    public static void main(String[] args) {
        // 示例1:HashSet基础操作
        System.out.println("=== 示例1:HashSet基础操作 ===");
        Set<String> bookShelf = new HashSet<>();

        // 添加图书(自动去重)
        bookShelf.add("Java编程思想");
        bookShelf.add("Effective Java");
        bookShelf.add("算法导论");
        bookShelf.add("Java编程思想"); // 重复,不会被添加

        System.out.println("书架图书:" + bookShelf);
        System.out.println("是否有算法书:" + bookShelf.contains("算法导论"));
        System.out.println("书架大小:" + bookShelf.size());

        // 遍历(顺序不确定)
        System.out.println("\n遍历书架:");
        for (String book : bookShelf) {
            System.out.println("- " + book);
        }

        // 示例2:实际应用 - 用户标签去重
        System.out.println("\n=== 示例2:用户标签去重 ===");
        List<String> userTags = Arrays.asList(
            "科技", "编程", "Java", "科技", "算法", "编程", "大数据"
        );

        Set<String> uniqueTags = new HashSet<>(userTags);
        System.out.println("原始标签:" + userTags);
        System.out.println("去重后标签:" + uniqueTags);

        // 示例3:集合运算
        System.out.println("\n=== 示例3:集合运算 ===");
        Set<Integer> setA = new HashSet<>(Arrays.asList(1, 2, 3, 4, 5));
        Set<Integer> setB = new HashSet<>(Arrays.asList(4, 5, 6, 7, 8));

        // 并集
        Set<Integer> union = new HashSet<>(setA);
        union.addAll(setB);
        System.out.println("A ∪ B (并集):" + union);

        // 交集
        Set<Integer> intersection = new HashSet<>(setA);
        intersection.retainAll(setB);
        System.out.println("A ∩ B (交集):" + intersection);

        // 差集
        Set<Integer> difference = new HashSet<>(setA);
        difference.removeAll(setB);
        System.out.println("A - B (差集):" + difference);

        // 示例4:常见陷阱
        System.out.println("\n=== 示例4:自定义对象的HashSet ===");
        Set<Student> studentSet = new HashSet<>();
        studentSet.add(new Student("张三", "001"));
        studentSet.add(new Student("李四", "002"));
        studentSet.add(new Student("张三", "001")); // 应该是重复的

        System.out.println("学生集合大小(错误实现):" + studentSet.size()); // 应该是2,但可能是3

        // 正确做法:重写equals和hashCode
        Set<Student2> studentSet2 = new HashSet<>();
        studentSet2.add(new Student2("张三", "001"));
        studentSet2.add(new Student2("李四", "002"));
        studentSet2.add(new Student2("张三", "001")); // 会被识别为重复

        System.out.println("学生集合大小(正确实现):" + studentSet2.size()); // 正确为2
    }

    // 错误示例:没有重写equals和hashCode
    static class Student {
        String name;
        String id;

        public Student(String name, String id) {
            this.name = name;
            this.id = id;
        }
    }

    // 正确示例:重写equals和hashCode
    static class Student2 {
        String name;
        String id;

        public Student2(String name, String id) {
            this.name = name;
            this.id = id;
        }

        @Override
        public boolean equals(Object o) {
            if (this == o) return true;
            if (o == null || getClass() != o.getClass()) return false;
            Student2 student = (Student2) o;
            return Objects.equals(name, student.name) &&
                   Objects.equals(id, student.id);
        }

        @Override
        public int hashCode() {
            return Objects.hash(name, id);
        }
    }
}
4.2 LinkedHashSet:有序的HashSet
public class LinkedHashSetDemo {
    public static void main(String[] args) {
        // LinkedHashSet保持插入顺序
        Set<String> orderedSet = new LinkedHashSet<>();

        orderedSet.add("第一步");
        orderedSet.add("第二步");
        orderedSet.add("第三步");
        orderedSet.add("第一步"); // 重复,不会添加

        System.out.println("LinkedHashSet(保持插入顺序):");
        for (String step : orderedSet) {
            System.out.println("- " + step);
        }

        // 与HashSet对比
        Set<String> hashSet = new HashSet<>(Arrays.asList("A", "B", "C", "A"));
        System.out.println("\nHashSet(顺序不确定):" + hashSet);
    }
}
4.3 TreeSet:基于红黑树的有序集合
import java.util.*;

public class TreeSetDemo {
    public static void main(String[] args) {
        // 示例1:自然排序
        System.out.println("=== 示例1:TreeSet自然排序 ===");
        Set<Integer> sortedNumbers = new TreeSet<>();

        sortedNumbers.add(5);
        sortedNumbers.add(2);
        sortedNumbers.add(8);
        sortedNumbers.add(1);
        sortedNumbers.add(5); // 重复

        System.out.println("自动排序的数字:" + sortedNumbers);

        // 示例2:自定义排序
        System.out.println("\n=== 示例2:自定义排序 ===");
        // 按字符串长度排序
        Set<String> lengthSortedSet = new TreeSet<>(
            Comparator.comparingInt(String::length)
                     .thenComparing(Comparator.naturalOrder())
        );

        lengthSortedSet.add("Apple");
        lengthSortedSet.add("Banana");
        lengthSortedSet.add("Cat");
        lengthSortedSet.add("Dog");
        lengthSortedSet.add("Elephant");

        System.out.println("按长度排序:" + lengthSortedSet);

        // 示例3:范围查询
        System.out.println("\n=== 示例3:TreeSet范围查询 ===");
        TreeSet<Integer> scores = new TreeSet<>(Arrays.asList(65, 78, 92, 85, 70, 88, 95));

        System.out.println("所有分数:" + scores);
        System.out.println("最高分:" + scores.last());
        System.out.println("最低分:" + scores.first());
        System.out.println("大于等于80的分数:" + scores.tailSet(80));
        System.out.println("小于80的分数:" + scores.headSet(80));
        System.out.println("80到90之间的分数:" + scores.subSet(80, 90));

        // 示例4:实际应用 - 排行榜
        System.out.println("\n=== 示例4:游戏玩家排行榜 ===");
        TreeSet<Player> leaderboard = new TreeSet<>(
            Comparator.comparingInt(Player::getScore).reversed()
                     .thenComparing(Player::getName)
        );

        leaderboard.add(new Player("Alice", 1500));
        leaderboard.add(new Player("Bob", 1800));
        leaderboard.add(new Player("Charlie", 1500));
        leaderboard.add(new Player("David", 2000));

        System.out.println("玩家排行榜:");
        int rank = 1;
        for (Player player : leaderboard) {
            System.out.printf("第%d名: %s - %d分%n", rank++, player.getName(), player.getScore());
        }
    }

    static class Player {
        String name;
        int score;

        public Player(String name, int score) {
            this.name = name;
            this.score = score;
        }

        public String getName() { return name; }
        public int getScore() { return score; }
    }
}
五、工具类详解:Arrays和Collections的魔法
5.1 Arrays工具类:数组的瑞士军刀
Arrays类提供了操作数组的各种静态方法,包括排序、搜索、比较、填充等。
import java.util.*;

public class ArraysDemo {
    public static void main(String[] args) {
        System.out.println("=== Arrays工具类详解 ===\n");

        // 示例1:数组排序和搜索
        System.out.println("示例1:数组排序和二分查找");
        int[] numbers = {5, 2, 9, 1, 7, 3, 8, 4, 6};

        System.out.println("原始数组:" + Arrays.toString(numbers));

        // 排序(快速排序实现)
        Arrays.sort(numbers);
        System.out.println("排序后:" + Arrays.toString(numbers));

        // 二分查找(必须先排序)
        int index = Arrays.binarySearch(numbers, 7);
        System.out.println("查找7的位置:" + index);

        // 示例2:数组填充和复制
        System.out.println("\n示例2:数组填充和复制");
        int[] filledArray = new int[5];
        Arrays.fill(filledArray, 42); // 全部填充为42
        System.out.println("填充数组:" + Arrays.toString(filledArray));

        // 部分填充
        int[] partialFill = new int[10];
        Arrays.fill(partialFill, 3, 7, 99);
        System.out.println("部分填充:" + Arrays.toString(partialFill));

        // 数组复制
        int[] original = {1, 2, 3, 4, 5};
        int[] copy = Arrays.copyOf(original, 7); // 扩展到7个元素
        System.out.println("扩展复制:" + Arrays.toString(copy));

        int[] rangeCopy = Arrays.copyOfRange(original, 1, 4); // [1,4)
        System.out.println("范围复制:" + Arrays.toString(rangeCopy));

        // 示例3:数组比较和深度比较
        System.out.println("\n示例3:数组比较");
        int[] arr1 = {1, 2, 3};
        int[] arr2 = {1, 2, 3};
        int[] arr3 = {1, 2, 4};

        System.out.println("arr1 equals arr2: " + arr1.equals(arr2)); // false
        System.out.println("Arrays.equals(arr1, arr2): " + Arrays.equals(arr1, arr2)); // true
        System.out.println("Arrays.equals(arr1, arr3): " + Arrays.equals(arr1, arr3)); // false

        // 多维数组比较
        int[][] deepArr1 = {{1, 2}, {3, 4}};
        int[][] deepArr2 = {{1, 2}, {3, 4}};
        int[][] deepArr3 = {{1, 2}, {3, 5}};

        System.out.println("Arrays.equals(deepArr1, deepArr2): " + Arrays.equals(deepArr1, deepArr2)); // false
        System.out.println("Arrays.deepEquals(deepArr1, deepArr2): " + Arrays.deepEquals(deepArr1, deepArr2)); // true
        System.out.println("Arrays.deepEquals(deepArr1, deepArr3): " + Arrays.deepEquals(deepArr1, deepArr3)); // false

        // 示例4:流操作(Java 8+)
        System.out.println("\n示例4:数组流操作");
        int[] nums = {1, 2, 3, 4, 5};

        // 转换为流并处理
        int sum = Arrays.stream(nums)
                       .filter(n -> n % 2 == 0)
                       .sum();
        System.out.println("偶数和:" + sum);

        // 转换为列表(重要!)
        List<Integer> list = Arrays.asList(1, 2, 3, 4, 5);
        System.out.println("数组转List:" + list);

        // 注意:Arrays.asList返回的列表是固定大小的!
        try {
            list.add(6); // 会抛出UnsupportedOperationException
        } catch (Exception e) {
            System.out.println("不能向Arrays.asList创建的列表添加元素");
        }

        // 如果需要可变列表
        List<Integer> mutableList = new ArrayList<>(Arrays.asList(1, 2, 3));
        mutableList.add(4); // 这样可以
        System.out.println("可变列表:" + mutableList);

        // 示例5:并行排序(大数据量)
        System.out.println("\n示例5:并行排序");
        int[] largeArray = new int[100000];
        Random rand = new Random();
        for (int i = 0; i < largeArray.length; i++) {
            largeArray[i] = rand.nextInt(1000000);
        }

        int[] serialCopy = Arrays.copyOf(largeArray, largeArray.length);
        int[] parallelCopy = Arrays.copyOf(largeArray, largeArray.length);

        long start = System.currentTimeMillis();
        Arrays.sort(serialCopy);
        long serialTime = System.currentTimeMillis() - start;

        start = System.currentTimeMillis();
        Arrays.parallelSort(parallelCopy);
        long parallelTime = System.currentTimeMillis() - start;

        System.out.printf("串行排序时间:%,d ms%n", serialTime);
        System.out.printf("并行排序时间:%,d ms%n", parallelTime);
        System.out.printf("并行排序加速比:%.2f倍%n", (double)serialTime / parallelTime);
    }
}
5.2 Collections工具类:集合操作的利器
Collections类提供了操作集合的各种静态方法,包括排序、搜索、同步包装、不可变包装等。
import java.util.*;

public class CollectionsDemo {
    public static void main(String[] args) {
        System.out.println("=== Collections工具类详解 ===\n");

        // 示例1:排序和搜索
        System.out.println("示例1:List排序和二分查找");
        List<Integer> numbers = new ArrayList<>(Arrays.asList(5, 2, 9, 1, 7, 3, 8, 4, 6));

        System.out.println("原始列表:" + numbers);

        // 排序(修改原集合)
        Collections.sort(numbers);
        System.out.println("排序后:" + numbers);

        // 自定义排序
        Collections.sort(numbers, Collections.reverseOrder());
        System.out.println("逆序排序:" + numbers);

        // 二分查找
        int index = Collections.binarySearch(numbers, 7);
        System.out.println("查找7的位置:" + index);

        // 示例2:同步包装(线程安全)
        System.out.println("\n示例2:线程安全包装");
        List<String> unsafeList = new ArrayList<>();
        List<String> safeList = Collections.synchronizedList(unsafeList);

        Set<Integer> unsafeSet = new HashSet<>();
        Set<Integer> safeSet = Collections.synchronizedSet(unsafeSet);

        Map<String, Integer> unsafeMap = new HashMap<>();
        Map<String, Integer> safeMap = Collections.synchronizedMap(unsafeMap);

        System.out.println("包装后的集合是线程安全的");

        // 示例3:不可变集合
        System.out.println("\n示例3:不可变(只读)集合");
        List<String> mutableList = new ArrayList<>(Arrays.asList("A", "B", "C"));
        List<String> unmodifiableList = Collections.unmodifiableList(mutableList);

        System.out.println("不可变列表:" + unmodifiableList);

        try {
            unmodifiableList.add("D"); // 抛出UnsupportedOperationException
        } catch (Exception e) {
            System.out.println("不能修改不可变集合");
        }

        // 但原列表修改会影响不可变视图
        mutableList.add("D");
        System.out.println("修改原列表后,不可变视图:" + unmodifiableList);

        // 创建真正的不可变集合(Java 9+)
        List<String> trulyImmutable = List.of("A", "B", "C");
        System.out.println("真正的不可变列表:" + trulyImmutable);

        // 示例4:集合操作
        System.out.println("\n示例4:常用集合操作");
        List<Integer> list1 = new ArrayList<>(Arrays.asList(1, 2, 3, 4, 5));

        // 反转
        Collections.reverse(list1);
        System.out.println("反转后:" + list1);

        // 随机打乱
        Collections.shuffle(list1);
        System.out.println("打乱后:" + list1);

        // 填充
        Collections.fill(list1, 0);
        System.out.println("填充0后:" + list1);

        // 替换所有
        List<String> words = new ArrayList<>(Arrays.asList("apple", "banana", "apple", "cherry"));
        Collections.replaceAll(words, "apple", "orange");
        System.out.println("替换后:" + words);

        // 示例5:极值和频率
        System.out.println("\n示例5:查找极值和频率");
        List<Integer> nums = Arrays.asList(3, 7, 2, 8, 2, 9, 1, 2, 5);

        System.out.println("列表:" + nums);
        System.out.println("最大值:" + Collections.max(nums));
        System.out.println("最小值:" + Collections.min(nums));
        System.out.println("2出现的频率:" + Collections.frequency(nums, 2));

        // 自定义比较器查找极值
        List<String> strList = Arrays.asList("apple", "banana", "cherry", "date");
        String maxByLength = Collections.max(strList, Comparator.comparingInt(String::length));
        System.out.println("最长的字符串:" + maxByLength);

        // 示例6:集合转换和初始化
        System.out.println("\n示例6:集合转换");
        List<String> sourceList = Arrays.asList("A", "B", "C", "D", "E");

        // 转换为数组
        String[] array = sourceList.toArray(new String[0]);
        System.out.println("List转数组:" + Arrays.toString(array));

        // 数组转List(注意:返回的List是Arrays的内部类,固定大小)
        List<String> fromArray = Arrays.asList(array);
        System.out.println("数组转List:" + fromArray);

        // 转换为Set(去重)
        List<String> withDuplicates = Arrays.asList("A", "B", "A", "C", "B");
        Set<String> uniqueSet = new HashSet<>(withDuplicates);
        System.out.println("List转Set(去重):" + uniqueSet);

        // Set转List
        List<String> setToList = new ArrayList<>(uniqueSet);
        System.out.println("Set转List:" + setToList);

        // 示例7:空集合和单元素集合
        System.out.println("\n示例7:空集合和单元素集合");
        List<String> emptyList = Collections.emptyList();
        Set<Integer> emptySet = Collections.emptySet();
        Map<String, String> emptyMap = Collections.emptyMap();

        System.out.println("空列表:" + emptyList);
        System.out.println("空集合:" + emptySet);
        System.out.println("空映射:" + emptyMap);

        // 单元素集合
        List<String> singletonList = Collections.singletonList("唯一元素");
        Set<String> singletonSet = Collections.singleton("唯一元素");
        Map<String, String> singletonMap = Collections.singletonMap("key", "value");

        System.out.println("单元素列表:" + singletonList);
        System.out.println("单元素集合:" + singletonSet);
        System.out.println("单元素映射:" + singletonMap);

        // 示例8:检查集合的共性
        System.out.println("\n示例8:集合共性检查");
        List<String> listA = Arrays.asList("A", "B", "C", "D");
        List<String> listB = Arrays.asList("C", "D", "E", "F");

        // 是否有共同元素
        boolean hasCommon = !Collections.disjoint(listA, listB);
        System.out.println("listA和listB有共同元素:" + hasCommon);

        // 示例9:rotate和swap
        System.out.println("\n示例9:旋转和交换");
        List<Integer> rotateList = new ArrayList<>(Arrays.asList(1, 2, 3, 4, 5));
        Collections.rotate(rotateList, 2); // 向右旋转2位
        System.out.println("旋转2位后:" + rotateList);

        Collections.swap(rotateList, 0, rotateList.size() - 1);
        System.out.println("交换首尾后:" + rotateList);
    }
}
5.3 数据结构转换大全
import java.util.*;
import java.util.stream.Collectors;

public class DataStructureConversion {
    public static void main(String[] args) {
        System.out.println("=== 数据结构转换大全 ===\n");

        // 1. 数组 ↔ List
        System.out.println("1. 数组 ↔ List 转换");

        // 数组转List
        String[] array = {"A", "B", "C"};
        List<String> listFromArray = Arrays.asList(array); // 固定大小
        List<String> mutableListFromArray = new ArrayList<>(Arrays.asList(array)); // 可变

        System.out.println("数组: " + Arrays.toString(array));
        System.out.println("转List(固定): " + listFromArray);
        System.out.println("转List(可变): " + mutableListFromArray);

        // List转数组
        List<String> list = Arrays.asList("X", "Y", "Z");
        String[] arrayFromList = list.toArray(new String[0]);
        System.out.println("List: " + list);
        System.out.println("转数组: " + Arrays.toString(arrayFromList));

        // 2. 数组 ↔ Set
        System.out.println("\n2. 数组 ↔ Set 转换");

        // 数组转Set(去重)
        Integer[] numsWithDup = {1, 2, 3, 2, 1, 4};
        Set<Integer> setFromArray = new HashSet<>(Arrays.asList(numsWithDup));
        System.out.println("数组(有重复): " + Arrays.toString(numsWithDup));
        System.out.println("转Set(去重): " + setFromArray);

        // Set转数组
        Set<String> set = new HashSet<>(Arrays.asList("Apple", "Banana", "Cherry"));
        String[] arrayFromSet = set.toArray(new String[0]);
        System.out.println("Set: " + set);
        System.out.println("转数组: " + Arrays.toString(arrayFromSet));

        // 3. List ↔ Set
        System.out.println("\n3. List ↔ Set 转换");

        // List转Set(去重)
        List<String> listWithDup = Arrays.asList("A", "B", "A", "C", "B");
        Set<String> setFromList = new HashSet<>(listWithDup);
        System.out.println("List(有重复): " + listWithDup);
        System.out.println("转Set(去重): " + setFromList);

        // Set转List
        Set<Integer> numSet = new HashSet<>(Arrays.asList(1, 2, 3, 4, 5));
        List<Integer> listFromSet = new ArrayList<>(numSet);
        System.out.println("Set: " + numSet);
        System.out.println("转List: " + listFromSet);

        // 4. Map ↔ 其他结构
        System.out.println("\n4. Map ↔ 其他结构转换");

        // Map转Set(键集合)
        Map<String, Integer> map = new HashMap<>();
        map.put("Alice", 25);
        map.put("Bob", 30);
        map.put("Charlie", 35);

        Set<String> keySet = map.keySet();
        Collection<Integer> values = map.values();
        Set<Map.Entry<String, Integer>> entrySet = map.entrySet();

        System.out.println("Map: " + map);
        System.out.println("键集合: " + keySet);
        System.out.println("值集合: " + values);
        System.out.println("键值对集合: " + entrySet);

        // List转Map
        List<Student> students = Arrays.asList(
            new Student("S001", "张三", 85),
            new Student("S002", "李四", 92),
            new Student("S003", "王五", 78)
        );

        Map<String, Student> studentMap = students.stream()
            .collect(Collectors.toMap(Student::getId, s -> s));
        System.out.println("\nStudent List: " + students);
        System.out.println("转Map(key=id): " + studentMap);

        // 5. 二维结构转换
        System.out.println("\n5. 二维结构转换");

        // Map<String, List<String>> 结构
        Map<String, List<String>> categories = new HashMap<>();
        categories.put("水果", Arrays.asList("苹果", "香蕉", "橙子"));
        categories.put("蔬菜", Arrays.asList("胡萝卜", "菠菜", "西红柿"));

        System.out.println("分类Map: " + categories);

        // 扁平化:所有值合并成一个List
        List<String> allItems = categories.values().stream()
            .flatMap(List::stream)
            .collect(Collectors.toList());
        System.out.println("所有物品: " + allItems);

        // 6. 使用Stream API转换
        System.out.println("\n6. 使用Stream API转换");

        List<Integer> numbers = Arrays.asList(1, 2, 3, 4, 5, 6, 7, 8, 9, 10);

        // 过滤并收集到List
        List<Integer> evenNumbers = numbers.stream()
            .filter(n -> n % 2 == 0)
            .collect(Collectors.toList());
        System.out.println("偶数List: " + evenNumbers);

        // 转换为Set
        Set<Integer> numberSet = numbers.stream()
            .collect(Collectors.toSet());
        System.out.println("数字Set: " + numberSet);

        // 转换为Map
        Map<Integer, String> numberMap = numbers.stream()
            .collect(Collectors.toMap(
                n -> n,                     // key
                n -> "Number-" + n,         // value
                (existing, replacement) -> existing  // 解决键冲突
            ));
        System.out.println("数字Map: " + numberMap);

        // 7. 特殊转换:排序和去重
        System.out.println("\n7. 排序和去重转换");

        List<Integer> unsorted = Arrays.asList(5, 3, 8, 1, 3, 7, 5, 2);

        // 去重
        List<Integer> distinct = unsorted.stream()
            .distinct()
            .collect(Collectors.toList());
        System.out.println("去重后: " + distinct);

        // 排序
        List<Integer> sorted = unsorted.stream()
            .sorted()
            .collect(Collectors.toList());
        System.out.println("排序后: " + sorted);

        // 去重并排序
        List<Integer> distinctAndSorted = unsorted.stream()
            .distinct()
            .sorted()
            .collect(Collectors.toList());
        System.out.println("去重并排序: " + distinctAndSorted);

        // 8. 并发集合转换
        System.out.println("\n8. 并发集合转换");

        List<String> largeList = new ArrayList<>();
        for (int i = 0; i < 10000; i++) {
            largeList.add("Item-" + i);
        }

        // 并行流转换
        List<String> parallelResult = largeList.parallelStream()
            .filter(s -> s.endsWith("0"))  // 以0结尾
            .map(String::toUpperCase)
            .collect(Collectors.toList());
        System.out.println("并行处理结果数量: " + parallelResult.size());

        // 转换为并发集合
        Map<String, Integer> concurrentMap = largeList.parallelStream()
            .collect(Collectors.toConcurrentMap(
                s -> s,
                String::length,
                (v1, v2) -> v1  // 合并函数
            ));
        System.out.println("并发Map大小: " + concurrentMap.size());
    }

    static class Student {
        String id;
        String name;
        int score;

        public Student(String id, String name, int score) {
            this.id = id;
            this.name = name;
            this.score = score;
        }

        public String getId() { return id; }
        public String getName() { return name; }
        public int getScore() { return score; }

        @Override
        public String toString() {
            return name + "(" + score + ")";
        }
    }
}
六、映射框架:Map系列的键值对存储
6.1 HashMap:最常用的哈希映射表
生活化比喻:就像电话簿,通过姓名(键)快速找到电话号码(值),内部使用哈希函数快速定位。
import java.util.*;

public class HashMapDemo {
    public static void main(String[] args) {
        // 示例1:基础操作
        System.out.println("=== 示例1:HashMap基础操作 ===");
        Map<String, Integer> phoneBook = new HashMap<>();

        // 添加联系人
        phoneBook.put("张三", 13800138000);
        phoneBook.put("李四", 13900139000);
        phoneBook.put("王五", 13700137000);

        System.out.println("电话簿:" + phoneBook);
        System.out.println("李四的电话:" + phoneBook.get("李四"));
        System.out.println("是否有张三:" + phoneBook.containsKey("张三"));

        // 更新值
        phoneBook.put("张三", 13800138001); // 更新
        System.out.println("更新后:" + phoneBook);

        // 遍历方式
        System.out.println("\n遍历电话簿:");
        System.out.println("1. 遍历所有键:");
        for (String name : phoneBook.keySet()) {
            System.out.println("   " + name);
        }

        System.out.println("2. 遍历所有值:");
        for (Integer number : phoneBook.values()) {
            System.out.println("   " + number);
        }

        System.out.println("3. 遍历键值对:");
        for (Map.Entry<String, Integer> entry : phoneBook.entrySet()) {
            System.out.println("   " + entry.getKey() + " -> " + entry.getValue());
        }

        // 示例2:实际应用 - 单词统计
        System.out.println("\n=== 示例2:单词频率统计 ===");
        String text = "java is a programming language java is widely used";
        String[] words = text.toLowerCase().split("\\s+");

        Map<String, Integer> wordCount = new HashMap<>();
        for (String word : words) {
            wordCount.put(word, wordCount.getOrDefault(word, 0) + 1);
        }

        System.out.println("单词频率:");
        wordCount.forEach((word, count) ->
            System.out.printf("  %s: %d次%n", word, count));

        // 示例3:缓存系统模拟
        System.out.println("\n=== 示例3:简单缓存系统 ===");
        Cache<String, Object> cache = new Cache<>(3); // 最大容量3

        cache.put("user:1001", "张三");
        cache.put("product:p001", "iPhone 15");
        cache.put("config:theme", "dark");
        System.out.println("添加3个后:" + cache);

        cache.put("config:language", "zh-CN"); // 触发淘汰
        System.out.println("添加第4个后:" + cache);

        System.out.println("获取user:1001:" + cache.get("user:1001"));
    }

    // 简单的LRU缓存实现
    static class Cache<K, V> extends LinkedHashMap<K, V> {
        private final int maxSize;

        public Cache(int maxSize) {
            super(16, 0.75f, true); // accessOrder=true表示按访问顺序排序
            this.maxSize = maxSize;
        }

        @Override
        protected boolean removeEldestEntry(Map.Entry<K, V> eldest) {
            return size() > maxSize; // 当大小超过maxSize时,移除最老的条目
        }
    }
}
6.2 HashMap源码深度解析:put方法的奥秘
// HashMap的put方法核心流程分析
public V put(K key, V value) {
    return putVal(hash(key), key, value, false, true);
}

final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) {
    Node<K,V>[] tab; // 哈希桶数组
    Node<K,V> p;     // 目标位置当前节点
    int n, i;        // n:数组长度,i:索引位置

    // 1. 如果表为空或长度为0,进行初始化
    if ((tab = table) == null || (n = tab.length) == 0)
        n = (tab = resize()).length;

    // 2. 计算索引:(n-1) & hash,如果该位置为空,直接放入新节点
    if ((p = tab[i = (n - 1) & hash]) == null)
        tab[i] = newNode(hash, key, value, null);
    else {
        // 3. 发生哈希碰撞
        Node<K,V> e; // 已存在的节点
        K k;

        // 3.1 检查第一个节点是否就是目标
        if (p.hash == hash &&
            ((k = p.key) == key || (key != null && key.equals(k))))
            e = p;
        // 3.2 如果是树节点,使用红黑树查找
        else if (p instanceof TreeNode)
            e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
        else {
            // 3.3 链表遍历查找
            for (int binCount = 0; ; ++binCount) {
                if ((e = p.next) == null) {
                    // 没找到,创建新节点
                    p.next = newNode(hash, key, value, null);
                    // 链表长度达到8,转为红黑树
                    if (binCount >= TREEIFY_THRESHOLD - 1)
                        treeifyBin(tab, hash);
                    break;
                }
                // 找到相同key
                if (e.hash == hash &&
                    ((k = e.key) == key || (key != null && key.equals(k))))
                    break;
                p = e;
            }
        }

        // 4. 找到已存在的key,更新值
        if (e != null) {
            V oldValue = e.value;
            if (!onlyIfAbsent || oldValue == null)
                e.value = value;
            afterNodeAccess(e);
            return oldValue;
        }
    }

    // 5. 修改计数检查扩容
    ++modCount;
    if (++size > threshold)
        resize();
    afterNodeInsertion(evict);
    return null;
}

// 哈希函数:让高位也参与运算,减少碰撞
static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
HashMap解决哈希碰撞图示:
哈希表结构(JDK8+):
索引0: 空
索引1: Node1 → Node2 → Node3 (链表长度<8)
索引2: TreeNode ↔ TreeNode ↔ TreeNode (红黑树,链表长度≥8时转换)
索引3: 空
...
索引15: NodeA

put("key", value)流程:
1. 计算hash = hash("key")
2. 计算索引 = (table.length-1) & hash
3. 如果该位置为空,直接放入
4. 如果不为空(碰撞):
   a. 检查第一个节点key是否相同
   b. 如果是树节点,走红黑树查找
   c. 否则遍历链表查找
   d. 如果链表长度≥8,转为红黑树
6.3 LinkedHashMap和TreeMap
public class OtherMapDemo {
    public static void main(String[] args) {
        // LinkedHashMap:保持插入顺序
        System.out.println("=== LinkedHashMap:保持插入顺序 ===");
        Map<String, Integer> linkedMap = new LinkedHashMap<>();
        linkedMap.put("一月", 1);
        linkedMap.put("三月", 3);
        linkedMap.put("二月", 2);
        System.out.println("LinkedHashMap:" + linkedMap); // 保持插入顺序

        // TreeMap:按键的自然顺序排序
        System.out.println("\n=== TreeMap:按键排序 ===");
        Map<String, Integer> treeMap = new TreeMap<>();
        treeMap.put("orange", 3);
        treeMap.put("apple", 1);
        treeMap.put("banana", 2);
        System.out.println("TreeMap:" + treeMap); // 按键字母顺序排序

        // Hashtable:线程安全但性能较差(已过时)
        System.out.println("\n=== Hashtable vs ConcurrentHashMap ===");
        // 不推荐:Hashtable
        Hashtable<String, String> oldTable = new Hashtable<>();

        // 推荐:ConcurrentHashMap(分段锁,性能更好)
        ConcurrentHashMap<String, String> concurrentMap = new ConcurrentHashMap<>();

        // 实际应用:配置管理
        System.out.println("\n=== 实际应用:配置管理 ===");
        ConfigManager config = new ConfigManager();

        config.set("app.name", "MyApp");
        config.set("app.version", "1.0.0");
        config.set("db.url", "jdbc:mysql://localhost:3306/test");

        System.out.println("所有配置(按字母排序):");
        config.getAllConfig().forEach((k, v) ->
            System.out.printf("  %s = %s%n", k, v));

        System.out.println("获取app.name:" + config.get("app.name"));
    }

    static class ConfigManager {
        private final TreeMap<String, String> configs = new TreeMap<>();

        public void set(String key, String value) {
            configs.put(key, value);
        }

        public String get(String key) {
            return configs.get(key);
        }

        public Map<String, String> getAllConfig() {
            return new TreeMap<>(configs);
        }
    }
}
七、源码深度解析:理解设计精髓
7.1 ArrayList自动扩容机制详解
// 深入理解ArrayList.grow()方法
private Object[] grow(int minCapacity) {
    int oldCapacity = elementData.length;

    // 如果旧容量大于0,或者不是默认的空数组
    if (oldCapacity > 0 || elementData != DEFAULTCAPACITY_EMPTY_ELEMENTDATA) {
        // 计算新容量:新容量 = 旧容量 + (旧容量 >> 1)
        // 也就是扩大为原来的1.5倍
        int newCapacity = ArraysSupport.newLength(
            oldCapacity,
            minCapacity - oldCapacity,  // 最小增长量:至少增长这么多
            oldCapacity >> 1            // 首选增长量:旧容量的一半
        );

        // 关键:Arrays.copyOf创建新数组并复制数据
        return elementData = Arrays.copyOf(elementData, newCapacity);
    } else {
        // 第一次扩容:使用默认容量10
        return elementData = new Object[Math.max(
            DEFAULT_CAPACITY,  // 默认10
            minCapacity
        )];
    }
}

// 实际扩容策略演示
public class ArrayListGrowthDemo {
    public static void main(String[] args) {
        ArrayList<Integer> list = new ArrayList<>();
        System.out.println("初始:容量=0(延迟初始化)");

        for (int i = 1; i <= 20; i++) {
            list.add(i);
            if (i == 1 || i == 10 || i == 11 || i == 16 || i == 17) {
                System.out.printf("添加第%2d个元素后:size=%2d, 容量=%2d%n",
                    i, list.size(), getCapacityReflection(list));
            }
        }
    }

    private static int getCapacityReflection(ArrayList<?> list) {
        try {
            java.lang.reflect.Field field = ArrayList.class.getDeclaredField("elementData");
            field.setAccessible(true);
            Object[] elementData = (Object[]) field.get(list);
            return elementData.length;
        } catch (Exception e) {
            return -1;
        }
    }
}
/* 输出结果:
初始:容量=0(延迟初始化)
添加第 1个元素后:size= 1, 容量=10  ← 第一次add触发扩容到10
添加第10个元素后:size=10, 容量=10  ← 满了,但还没触发扩容
添加第11个元素后:size=11, 容量=15  ← 触发扩容:10 + (10 >> 1) = 15
添加第16个元素后:size=16, 容量=15  ← 又满了
添加第17个元素后:size=17, 容量=22  ← 触发扩容:15 + (15 >> 1) = 22(向下取整)
*/
7.2 HashMap树化机制解析
// HashMap链表转红黑树的阈值分析
public class HashMapTreeifyDemo {
    public static void main(String[] args) {
        // 验证HashMap的树化条件
        System.out.println("HashMap树化条件:");
        System.out.println("1. 链表长度 ≥ TREEIFY_THRESHOLD(8)");
        System.out.println("2. 哈希桶数组长度 ≥ MIN_TREEIFY_CAPACITY(64)");
        System.out.println("两个条件同时满足才会树化");

        // 模拟哈希碰撞,演示树化过程
        Map<BadHashKey, Integer> map = new HashMap<>(64);

        System.out.println("\n添加16个相同哈希码的键:");
        for (int i = 0; i < 16; i++) {
            map.put(new BadHashKey(i), i);
            if (i == 7 || i == 8 || i == 9) {
                System.out.printf("添加第%d个元素后: size=%d%n", i+1, map.size());
                // 这里可以查看内部结构(需要反射)
            }
        }

        System.out.println("\n退化条件:");
        System.out.println("红黑树节点数 ≤ UNTREEIFY_THRESHOLD(6) 时会退化为链表");
    }

    // 产生相同哈希码的键,用于演示哈希碰撞
    static class BadHashKey {
        int id;

        public BadHashKey(int id) {
            this.id = id;
        }

        @Override
        public int hashCode() {
            return 1; // 所有对象哈希码相同,强制碰撞
        }

        @Override
        public boolean equals(Object obj) {
            if (this == obj) return true;
            if (obj == null || getClass() != obj.getClass()) return false;
            BadHashKey that = (BadHashKey) obj;
            return id == that.id;
        }
    }
}
八、性能对比实验:数据说话
import java.util.*;

public class PerformanceBenchmark {
    private static final int TEST_SIZE = 100000;

    public static void main(String[] args) {
        System.out.println("=== 数据结构性能对比测试 (数据量:" + TEST_SIZE + ") ===");
        System.out.println();

        // 测试1:ArrayList vs LinkedList 随机访问
        System.out.println("测试1:随机访问性能对比");
        List<Integer> arrayList = new ArrayList<>();
        List<Integer> linkedList = new LinkedList<>();

        // 填充数据
        for (int i = 0; i < TEST_SIZE; i++) {
            arrayList.add(i);
            linkedList.add(i);
        }

        long startTime = System.nanoTime();
        for (int i = 0; i < 1000; i++) {
            arrayList.get(TEST_SIZE / 2); // 访问中间元素
        }
        long arrayTime = System.nanoTime() - startTime;

        startTime = System.nanoTime();
        for (int i = 0; i < 1000; i++) {
            linkedList.get(TEST_SIZE / 2); // 访问中间元素
        }
        long linkedTime = System.nanoTime() - startTime;

        System.out.printf("ArrayList 随机访问 1000次: %,.3f ms%n", arrayTime / 1_000_000.0);
        System.out.printf("LinkedList随机访问 1000次: %,.3f ms%n", linkedTime / 1_000_000.0);
        System.out.printf("ArrayList比LinkedList快: %.1f倍%n", (double)linkedTime / arrayTime);

        // 测试2:插入性能对比
        System.out.println("\n测试2:中间插入性能对比");

        startTime = System.nanoTime();
        for (int i = 0; i < 1000; i++) {
            arrayList.add(TEST_SIZE / 2, i); // 在中间插入
        }
        arrayTime = System.nanoTime() - startTime;

        startTime = System.nanoTime();
        for (int i = 0; i < 1000; i++) {
            linkedList.add(TEST_SIZE / 2, i); // 在中间插入
        }
        linkedTime = System.nanoTime() - startTime;

        System.out.printf("ArrayList 中间插入 1000次: %,.3f ms%n", arrayTime / 1_000_000.0);
        System.out.printf("LinkedList中间插入 1000次: %,.3f ms%n", linkedTime / 1_000_000.0);
        System.out.printf("LinkedList比ArrayList快: %.1f倍%n", (double)arrayTime / linkedTime);

        // 测试3:HashMap vs TreeMap 查找性能
        System.out.println("\n测试3:Map查找性能对比");
        Map<Integer, String> hashMap = new HashMap<>();
        Map<Integer, String> treeMap = new TreeMap<>();

        // 填充数据
        for (int i = 0; i < TEST_SIZE; i++) {
            hashMap.put(i, "Value" + i);
            treeMap.put(i, "Value" + i);
        }

        startTime = System.nanoTime();
        for (int i = 0; i < 10000; i++) {
            hashMap.get(i % TEST_SIZE);
        }
        long hashMapTime = System.nanoTime() - startTime;

        startTime = System.nanoTime();
        for (int i = 0; i < 10000; i++) {
            treeMap.get(i % TEST_SIZE);
        }
        long treeMapTime = System.nanoTime() - startTime;

        System.out.printf("HashMap 查找 10000次: %,.3f ms%n", hashMapTime / 1_000_000.0);
        System.out.printf("TreeMap 查找 10000次: %,.3f ms%n", treeMapTime / 1_000_000.0);
        System.out.printf("HashMap比TreeMap快: %.1f倍%n", (double)treeMapTime / hashMapTime);

        // 测试4:HashSet去重性能
        System.out.println("\n测试4:去重性能对比");
        List<Integer> duplicateList = new ArrayList<>();
        Random random = new Random();

        for (int i = 0; i < TEST_SIZE; i++) {
            duplicateList.add(random.nextInt(TEST_SIZE / 10)); // 大量重复
        }

        startTime = System.nanoTime();
        Set<Integer> hashSet = new HashSet<>(duplicateList);
        long hashSetTime = System.nanoTime() - startTime;

        startTime = System.nanoTime();
        Set<Integer> treeSet = new TreeSet<>(duplicateList);
        long treeSetTime = System.nanoTime() - startTime;

        System.out.printf("原始列表大小: %,d%n", duplicateList.size());
        System.out.printf("HashSet去重后大小: %,d (用时: %,.3f ms)%n",
            hashSet.size(), hashSetTime / 1_000_000.0);
        System.out.printf("TreeSet去重后大小: %,d (用时: %,.3f ms)%n",
            treeSet.size(), treeSetTime / 1_000_000.0);
    }
}
九、实战场景指南:如何选择数据结构
9.1 电商系统场景
public class ECommerceExample {
    public static void main(String[] args) {
        System.out.println("=== 电商系统数据结构选择指南 ===\n");

        // 场景1:商品目录 - 需要快速查找
        System.out.println("场景1:商品目录(需要快速按ID查找)");
        System.out.println("选择:HashMap<Integer, Product>");
        System.out.println("原因:O(1)的查找时间,适合商品ID到商品的映射");

        Map<Integer, Product> productCatalog = new HashMap<>();
        productCatalog.put(1001, new Product("iPhone 15", 7999.0));
        productCatalog.put(1002, new Product("MacBook Pro", 12999.0));

        // 场景2:购物车 - 需要保持顺序且频繁增删
        System.out.println("\n场景2:购物车(需要保持添加顺序)");
        System.out.println("选择:LinkedHashMap<Integer, CartItem> 或 ArrayList<CartItem>");
        System.out.println("原因:保持商品添加顺序,方便展示");

        Map<Integer, CartItem> shoppingCart = new LinkedHashMap<>();
        shoppingCart.put(1001, new CartItem(productCatalog.get(1001), 2));
        shoppingCart.put(1002, new CartItem(productCatalog.get(1002), 1));

        // 场景3:商品分类 - 需要层次结构
        System.out.println("\n场景3:商品分类树(层次结构)");
        System.out.println("选择:自定义树结构 或 Map<String, List<Product>>");

        Map<String, List<Product>> categoryMap = new HashMap<>();
        categoryMap.put("手机", Arrays.asList(
            new Product("iPhone 15", 7999.0),
            new Product("华为P60", 5999.0)
        ));
        categoryMap.put("电脑", Arrays.asList(
            new Product("MacBook Pro", 12999.0),
            new Product("ThinkPad", 8999.0)
        ));

        // 场景4:用户订单历史 - 需要按时间排序
        System.out.println("\n场景4:用户订单历史(按时间倒序)");
        System.out.println("选择:TreeSet<Order>(自定义比较器按时间排序)");
        System.out.println("或:PriorityQueue<Order>(按优先级处理)");

        TreeSet<Order> orderHistory = new TreeSet<>(
            Comparator.comparing(Order::getOrderTime).reversed()
        );
        orderHistory.add(new Order("ORD001", new Date(), 17998.0));

        // 场景5:库存管理 - 需要线程安全
        System.out.println("\n场景5:库存管理(并发场景)");
        System.out.println("选择:ConcurrentHashMap<Integer, Integer>");
        System.out.println("原因:线程安全,高并发性能好");

        ConcurrentHashMap<Integer, Integer> inventory = new ConcurrentHashMap<>();
        inventory.put(1001, 50); // 商品ID: 库存数量
        inventory.put(1002, 30);

        // 自动扣减库存(线程安全)
        inventory.computeIfPresent(1001, (k, v) -> v > 0 ? v - 1 : 0);
    }

    static class Product {
        String name;
        double price;

        public Product(String name, double price) {
            this.name = name;
            this.price = price;
        }
    }

    static class CartItem {
        Product product;
        int quantity;

        public CartItem(Product product, int quantity) {
            this.product = product;
            this.quantity = quantity;
        }
    }

    static class Order {
        String orderId;
        Date orderTime;
        double amount;

        public Order(String orderId, Date orderTime, double amount) {
            this.orderId = orderId;
            this.orderTime = orderTime;
            this.amount = amount;
        }

        public Date getOrderTime() { return orderTime; }
    }
}
9.2 社交网络场景
public class SocialNetworkExample {
    public static void main(String[] args) {
        System.out.println("=== 社交网络数据结构选择 ===\n");

        // 场景1:用户关系 - 图结构
        System.out.println("场景1:用户好友关系(图结构)");
        System.out.println("选择:Map<User, Set<User>> 表示邻接表");

        Map<User, Set<User>> friendGraph = new HashMap<>();
        User alice = new User("Alice", 1);
        User bob = new User("Bob", 2);
        User charlie = new User("Charlie", 3);

        friendGraph.put(alice, new HashSet<>(Arrays.asList(bob, charlie)));
        friendGraph.put(bob, new HashSet<>(Arrays.asList(alice)));
        friendGraph.put(charlie, new HashSet<>(Arrays.asList(alice)));

        // 场景2:用户动态时间线 - 需要按时间排序
        System.out.println("\n场景2:朋友圈时间线(按时间倒序)");
        System.out.println("选择:PriorityQueue<Post> 或 TreeSet<Post>");

        PriorityQueue<Post> newsFeed = new PriorityQueue<>(
            Comparator.comparing(Post::getTimestamp).reversed()
        );

        newsFeed.add(new Post("Hello world!", new Date(), alice));
        newsFeed.add(new Post("Good morning!",
            new Date(System.currentTimeMillis() - 1000), bob));

        // 场景3:消息队列 - 私信系统
        System.out.println("\n场景3:私信系统(消息队列)");
        System.out.println("选择:ConcurrentLinkedQueue<Message>");

        ConcurrentLinkedQueue<Message> messageQueue = new ConcurrentLinkedQueue<>();
        messageQueue.offer(new Message(alice, bob, "Hello!"));
        messageQueue.offer(new Message(bob, alice, "Hi there!"));

        // 场景4:用户搜索 - 前缀匹配
        System.out.println("\n场景4:用户搜索(前缀自动补全)");
        System.out.println("选择:Trie树(前缀树)");

        Trie trie = new Trie();
        trie.insert("alice");
        trie.insert("alex");
        trie.insert("bob");
        trie.insert("charlie");

        System.out.println("搜索 'al' 前缀:" + trie.searchPrefix("al"));
    }

    static class User {
        String name;
        int id;

        public User(String name, int id) {
            this.name = name;
            this.id = id;
        }

        @Override
        public boolean equals(Object o) {
            if (this == o) return true;
            if (o == null || getClass() != o.getClass()) return false;
            User user = (User) o;
            return id == user.id;
        }

        @Override
        public int hashCode() {
            return Objects.hash(id);
        }
    }

    static class Post {
        String content;
        Date timestamp;
        User author;

        public Post(String content, Date timestamp, User author) {
            this.content = content;
            this.timestamp = timestamp;
            this.author = author;
        }

        public Date getTimestamp() { return timestamp; }
    }

    static class Message {
        User from;
        User to;
        String content;

        public Message(User from, User to, String content) {
            this.from = from;
            this.to = to;
            this.content = content;
        }
    }

    // 简单的Trie树实现
    static class TrieNode {
        Map<Character, TrieNode> children = new HashMap<>();
        boolean isEndOfWord;
    }

    static class Trie {
        private TrieNode root = new TrieNode();

        public void insert(String word) {
            TrieNode current = root;
            for (char ch : word.toCharArray()) {
                current = current.children.computeIfAbsent(ch, c -> new TrieNode());
            }
            current.isEndOfWord = true;
        }

        public List<String> searchPrefix(String prefix) {
            List<String> results = new ArrayList<>();
            TrieNode node = findNode(prefix);
            if (node != null) {
                collectWords(node, new StringBuilder(prefix), results);
            }
            return results;
        }

        private TrieNode findNode(String prefix) {
            TrieNode current = root;
            for (char ch : prefix.toCharArray()) {
                current = current.children.get(ch);
                if (current == null) return null;
            }
            return current;
        }

        private void collectWords(TrieNode node, StringBuilder prefix, List<String> results) {
            if (node.isEndOfWord) {
                results.add(prefix.toString());
            }
            for (char ch : node.children.keySet()) {
                prefix.append(ch);
                collectWords(node.children.get(ch), prefix, results);
                prefix.deleteCharAt(prefix.length() - 1);
            }
        }
    }
}
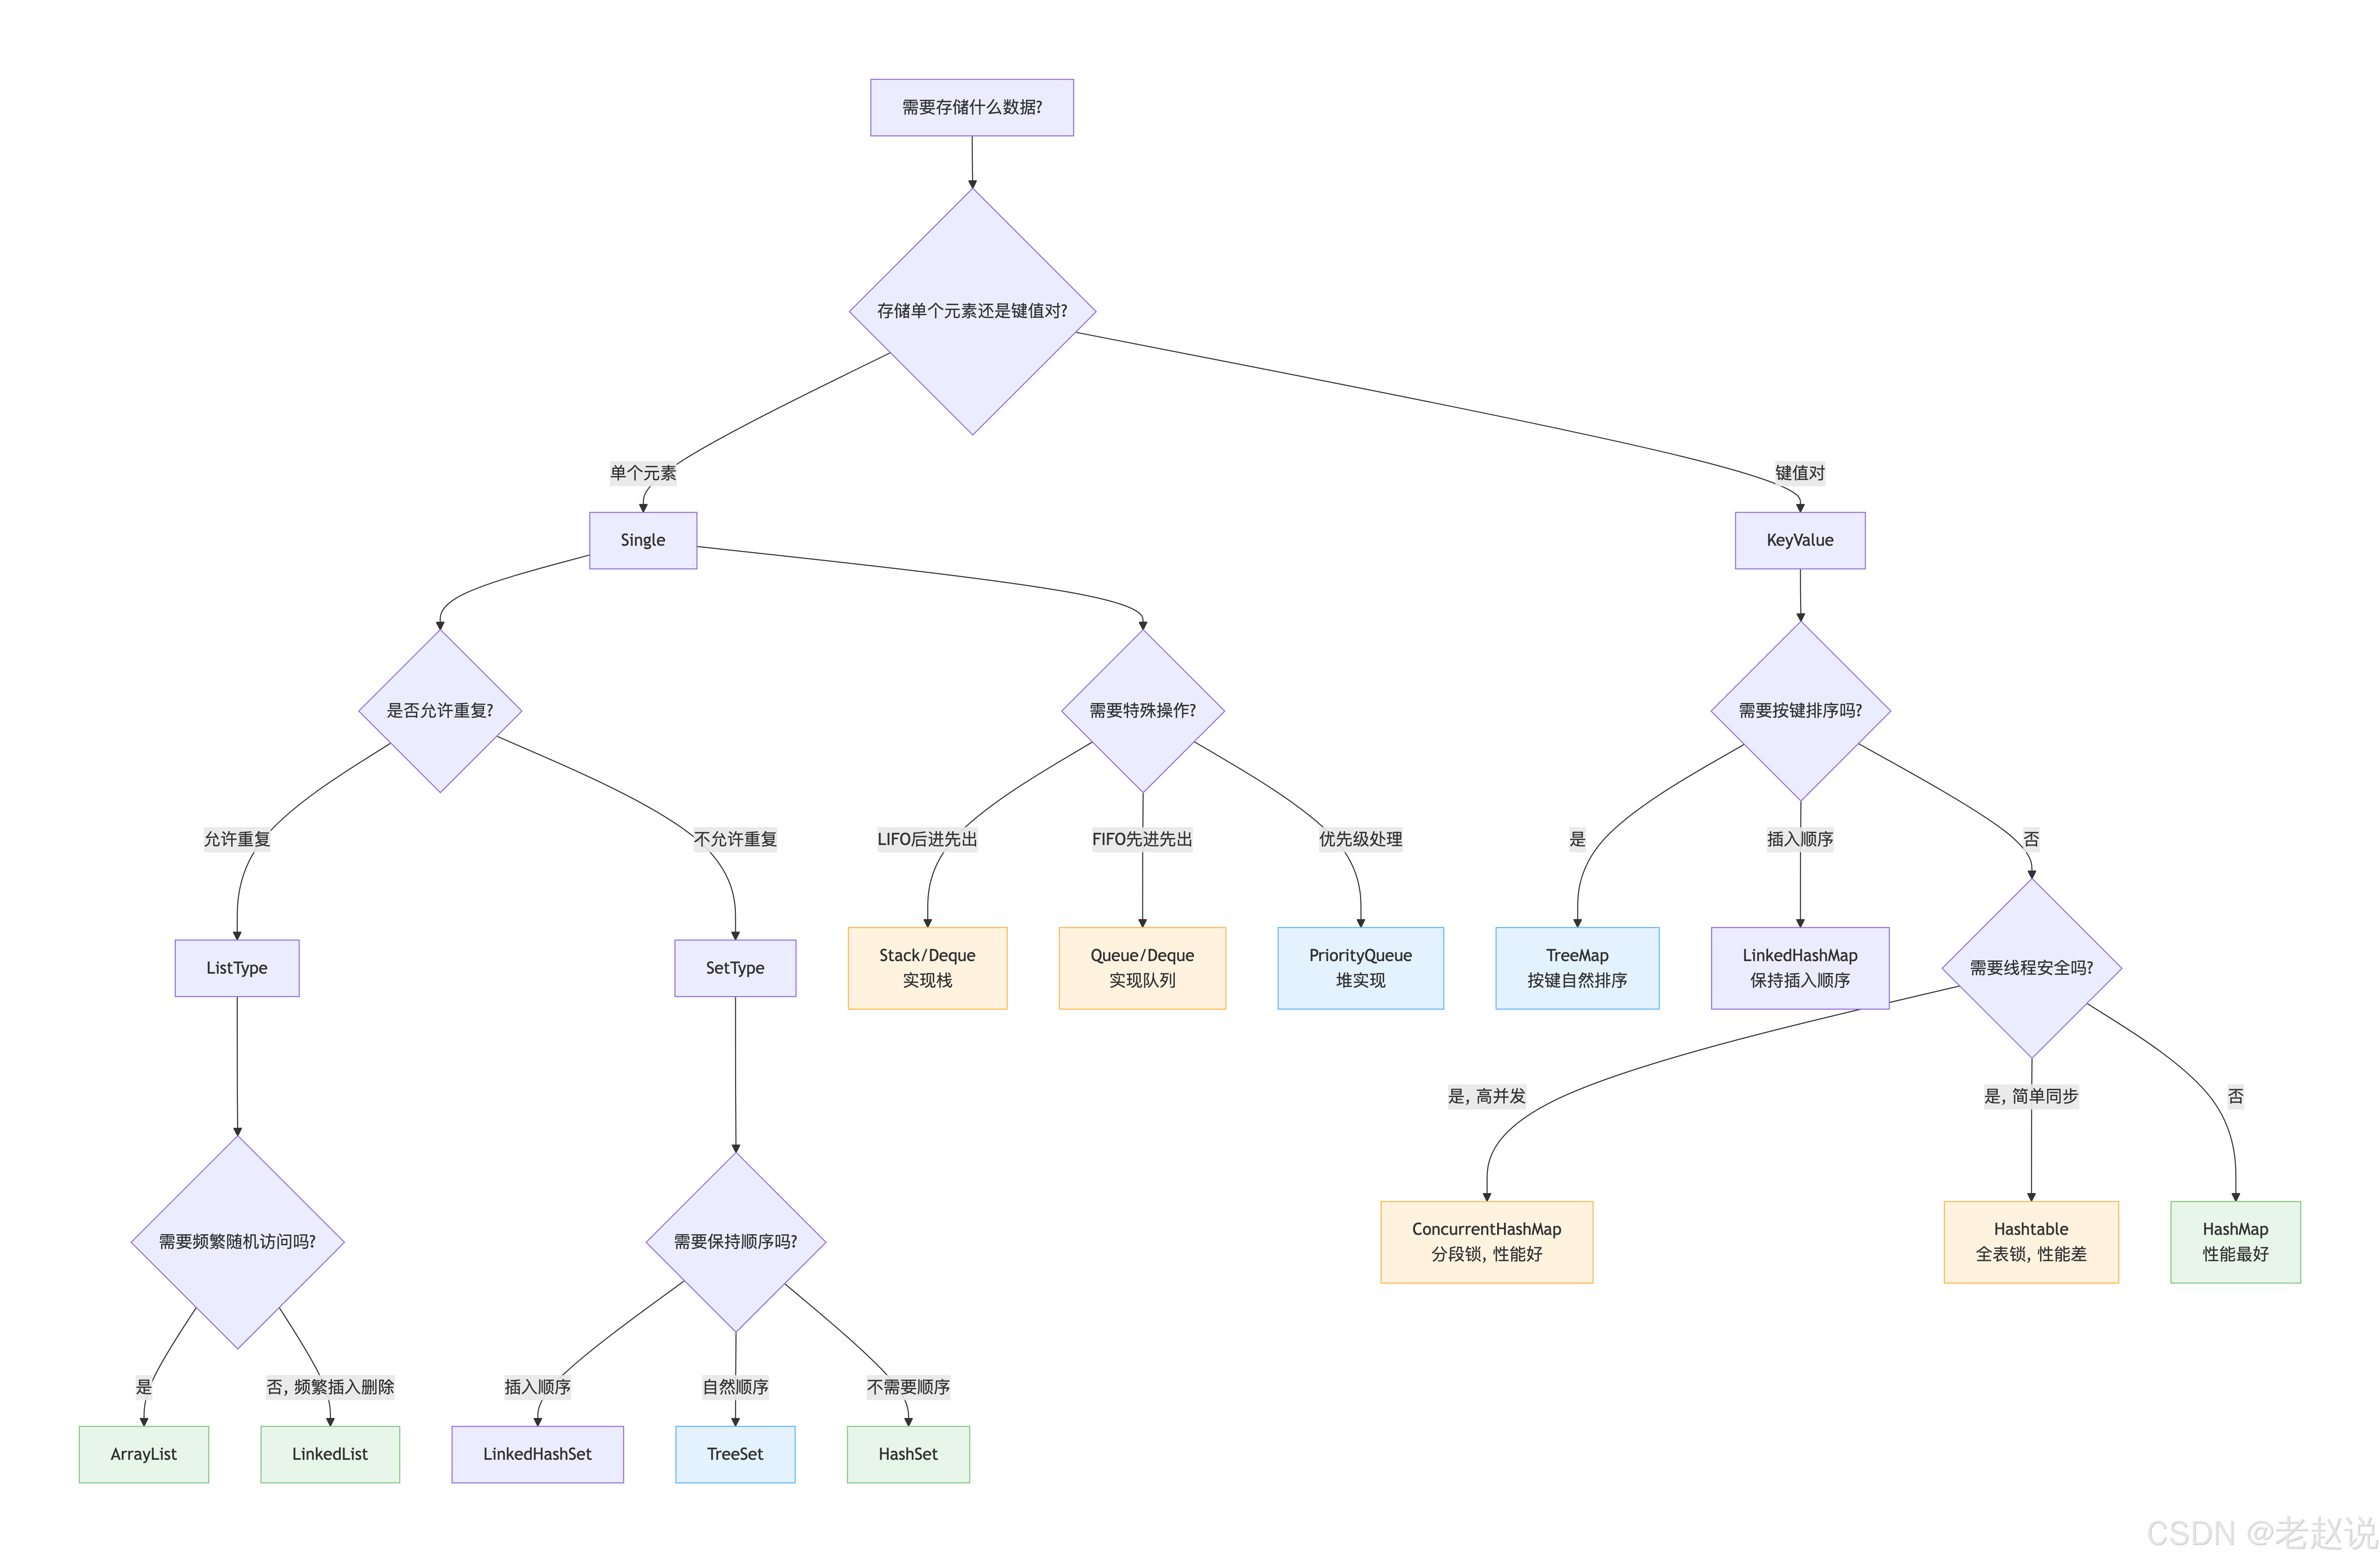
十、数据结构选择决策树
十一、数据结构转换指南
11.1 常用转换方法总结表
| 转换类型 | 方法 | 注意事项 |
|---|---|---|
| 数组 → List | Arrays.asList(array) |
返回的List固定大小,不能增删 |
| 数组 → 可变List | new ArrayList<>(Arrays.asList(array)) |
可变的ArrayList |
| List → 数组 | list.toArray(new T[0]) |
类型安全的转换 |
| 数组 → Set | new HashSet<>(Arrays.asList(array)) |
自动去重 |
| Set → 数组 | set.toArray(new T[0]) |
保持Set的无序性 |
| List → Set | new HashSet<>(list) |
去重,丢失顺序 |
| Set → List | new ArrayList<>(set) |
保持Set的元素 |
| Map → Key Set | map.keySet() |
键的视图,修改会影响原Map |
| Map → Value List | new ArrayList<>(map.values()) |
值的集合 |
| Map → Entry Set | map.entrySet() |
键值对的集合 |
| List → Map | list.stream().collect(Collectors.toMap(...)) |
需要指定key和value提取器 |
| 集合 → 不可变集合 | Collections.unmodifiableXxx(collection) |
只读视图,原集合修改会反映 |
| 集合 → 同步集合 | Collections.synchronizedXxx(collection) |
线程安全包装 |
11.2 转换最佳实践
import java.util.*;
import java.util.stream.Collectors;

public class ConversionBestPractices {
    public static void main(String[] args) {
        System.out.println("=== 数据结构转换最佳实践 ===\n");

        // 1. 数组转List的最佳实践
        System.out.println("1. 数组转List的最佳实践");
        String[] array = {"A", "B", "C"};

        // ❌ 不好:返回的List不能增删
        List<String> badList = Arrays.asList(array);

        // ✅ 好:创建可变的ArrayList
        List<String> goodList = new ArrayList<>(Arrays.asList(array));
        goodList.add("D"); // 可以添加

        // ✅ 更好:Java 8+ 使用Stream
        List<String> bestList = Arrays.stream(array)
            .collect(Collectors.toList());

        System.out.println("原始数组: " + Arrays.toString(array));
        System.out.println("可变List: " + goodList);

        // 2. List转数组的最佳实践
        System.out.println("\n2. List转数组的最佳实践");
        List<Integer> list = Arrays.asList(1, 2, 3, 4, 5);

        // ✅ 最佳:使用toArray(T[] a) 传入正确大小的数组
        Integer[] array1 = list.toArray(new Integer[0]); // 简洁,性能好

        // ✅ 如果知道大小:传入正确大小的数组
        Integer[] array2 = list.toArray(new Integer[list.size()]);

        System.out.println("List: " + list);
        System.out.println("数组: " + Arrays.toString(array1));

        // 3. 集合转换的性能考虑
        System.out.println("\n3. 集合转换的性能考虑");

        // 大容量集合转换使用Stream并行处理
        List<Integer> largeList = new ArrayList<>();
        for (int i = 0; i < 1000000; i++) {
            largeList.add(i % 1000); // 有很多重复
        }

        // 普通去重
        long start = System.currentTimeMillis();
        Set<Integer> set1 = new HashSet<>(largeList);
        long time1 = System.currentTimeMillis() - start;

        // 并行流去重(大数据量更快)
        start = System.currentTimeMillis();
        Set<Integer> set2 = largeList.parallelStream()
            .collect(Collectors.toSet());
        long time2 = System.currentTimeMillis() - start;

        System.out.printf("普通HashSet去重: %,d ms, 结果大小: %,d%n",
            time1, set1.size());
        System.out.printf("并行流去重: %,d ms, 结果大小: %,d%n",
            time2, set2.size());

        // 4. 复杂对象转换
        System.out.println("\n4. 复杂对象转换示例");

        List<Person> people = Arrays.asList(
            new Person("Alice", 25, "Engineer"),
            new Person("Bob", 30, "Manager"),
            new Person("Charlie", 28, "Engineer"),
            new Person("David", 35, "Director")
        );

        // List转Map:按职位分组
        Map<String, List<Person>> byJob = people.stream()
            .collect(Collectors.groupingBy(Person::getJob));

        // List转Map:姓名到年龄的映射
        Map<String, Integer> nameToAge = people.stream()
            .collect(Collectors.toMap(
                Person::getName,
                Person::getAge,
                (oldValue, newValue) -> oldValue // 处理重复键
            ));

        // List转Map:职位到人数的统计
        Map<String, Long> jobCount = people.stream()
            .collect(Collectors.groupingBy(
                Person::getJob,
                Collectors.counting()
            ));

        System.out.println("按职位分组: " + byJob);
        System.out.println("姓名到年龄映射: " + nameToAge);
        System.out.println("职位统计: " + jobCount);

        // 5. 双向转换的完整性
        System.out.println("\n5. 保持转换的完整性");

        // 使用LinkedHashSet保持顺序的去重
        List<String> orderedList = Arrays.asList("B", "A", "C", "A", "B", "D");
        Set<String> orderedSet = new LinkedHashSet<>(orderedList);
        List<String> deduplicatedOrderedList = new ArrayList<>(orderedSet);

        System.out.println("原始列表: " + orderedList);
        System.out.println("去重后(保持顺序): " + deduplicatedOrderedList);

        // 使用TreeSet排序的去重
        Set<String> sortedSet = new TreeSet<>(orderedList);
        List<String> deduplicatedSortedList = new ArrayList<>(sortedSet);
        System.out.println("去重后(排序): " + deduplicatedSortedList);
    }

    static class Person {
        String name;
        int age;
        String job;

        public Person(String name, int age, String job) {
            this.name = name;
            this.age = age;
            this.job = job;
        }

        public String getName() { return name; }
        public int getAge() { return age; }
        public String getJob() { return job; }

        @Override
        public String toString() {
            return name + "(" + age + ")";
        }
    }
}
十二、总结
12.1 数据结构对比总结表
| 数据结构 | 底层实现 | 主要操作时间复杂度 | 线程安全 | 内存占用 | 适用场景 |
|---|---|---|---|---|---|
| 数组 | 连续内存 | 访问:O(1), 插入删除:O(n) | 否 | 最小 | 大小固定,频繁随机访问 |
| ArrayList | 动态数组 | 访问:O(1), 尾部增删:O(1)*, 中间增删:O(n) | 否 | 较低 | 大部分List场景首选 |
| LinkedList | 双向链表 | 访问:O(n), 插入删除:O(1) | 否 | 较高 | 频繁在中间插入删除 |
| Vector | 动态数组 | 同ArrayList | 是(synchronized) | 较低 | 历史遗留,不推荐使用 |
| Stack | 基于Vector | 入栈出栈:O(1) | 是 | 较低 | LIFO场景,可用Deque替代 |
| ArrayDeque | 循环数组 | 两端操作:O(1) | 否 | 较低 | 栈和队列的最佳实现 |
| PriorityQueue | 堆(数组) | 入队:O(log n), 出队:O(log n) | 否 | 较低 | 优先级调度 |
| HashSet | HashMap | 增删查:O(1)平均 | 否 | 较高 | 快速去重,不关心顺序 |
| LinkedHashSet | LinkedHashMap | 增删查:O(1)平均 | 否 | 较高 | 去重且保持插入顺序 |
| TreeSet | TreeMap(红黑树) | 增删查:O(log n) | 否 | 高 | 有序集合,范围查询 |
| HashMap | 数组+链表/红黑树 | 增删查:O(1)平均 | 否 | 较高 | 大多数键值对场景 |
| LinkedHashMap | HashMap+双向链表 | 增删查:O(1)平均 | 否 | 高 | 保持插入或访问顺序 |
| TreeMap | 红黑树 | 增删查:O(log n) | 否 | 高 | 按键排序的映射表 |
| Hashtable | 数组+链表 | 增删查:O(1)平均 | 是(synchronized) | 较高 | 历史遗留,不推荐 |
| ConcurrentHashMap | 分段锁/数组+链表 | 增删查:O(1)平均 | 是(分段锁) | 较高 | 高并发键值对存储 |
注:ArrayList尾部增删O(1)指平均复杂度,扩容时会有额外开销
12.2 Arrays和Collections工具类对比
| 功能 | Arrays类 | Collections类 |
|---|---|---|
| 排序 | sort(array) |
sort(list) |
| 二分查找 | binarySearch(array, key) |
binarySearch(list, key) |
| 填充 | fill(array, value) |
fill(list, value) |
| 复制 | copyOf(array, newLength) |
无直接方法,用构造函数 |
| 比较 | equals(array1, array2) |
无,用集合的equals方法 |
| 深度比较 | deepEquals(array1, array2) |
无 |
| 转换为字符串 | toString(array) |
无,用集合的toString |
| 转换为List | asList(array) |
无 |
| 最大值/最小值 | 无 | max(collection), min(collection) |
| 反转 | 无 | reverse(list) |
| 随机打乱 | 无 | shuffle(list) |
| 交换元素 | 无 | swap(list, i, j) |
| 替换所有 | 无 | replaceAll(list, oldVal, newVal) |
| 旋转 | 无 | rotate(list, distance) |
| 频率统计 | 无 | frequency(collection, obj) |
| 同步包装 | 无 | synchronizedXxx(collection) |
| 不可变包装 | 无 | unmodifiableXxx(collection) |
| 空集合 | 无 | emptyList(), emptySet(), emptyMap() |
| 单元素集合 | 无 | singletonList(), singletonSet(), singletonMap() |
结语
数据结构是编程的基石,掌握它们就像建筑师掌握各种建筑材料。通过本文的学习,希望你不仅记住了各种数据结构的特性和用法,更理解了它们背后的设计思想和适用场景。
记住:没有最好的数据结构,只有最适合的数据结构。在实际开发中,要根据具体需求、数据特性和性能要求做出明智选择。
Arrays和Collections工具类是Java程序员的瑞士军刀,熟练使用它们能极大提高开发效率和代码质量。同时,掌握各种数据结构间的转换技巧,能让你在处理复杂数据时游刃有余。
学习建议:
-
先理解,后记忆:理解原理比死记硬背更重要
-
多实践,少空想:动手写代码,观察实际效果
-
读源码,悟思想:JDK源码是最好的学习材料
-
勤总结,善分享:用自己的话总结,教给别人是更好的学习
-
懂工具,会转换:熟练使用工具类,掌握数据结构转换
祝你在Java编程的道路上越走越远,从数据结构的小白成长为架构设计的大师!有任何问题,欢迎在评论区交流讨论。