你好,我是易安,见字如面。 2 月 5 号凌晨两点,Anthropic 放出了 Opus 4.6。
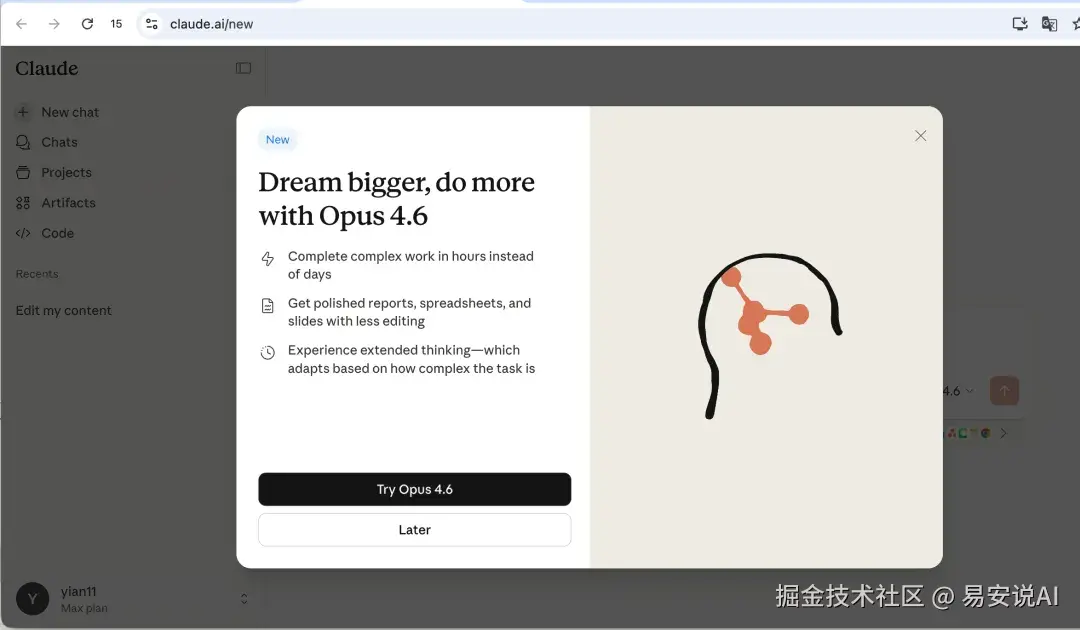
A社还良心的送了一些增金,让付费订阅用户试用最新模型
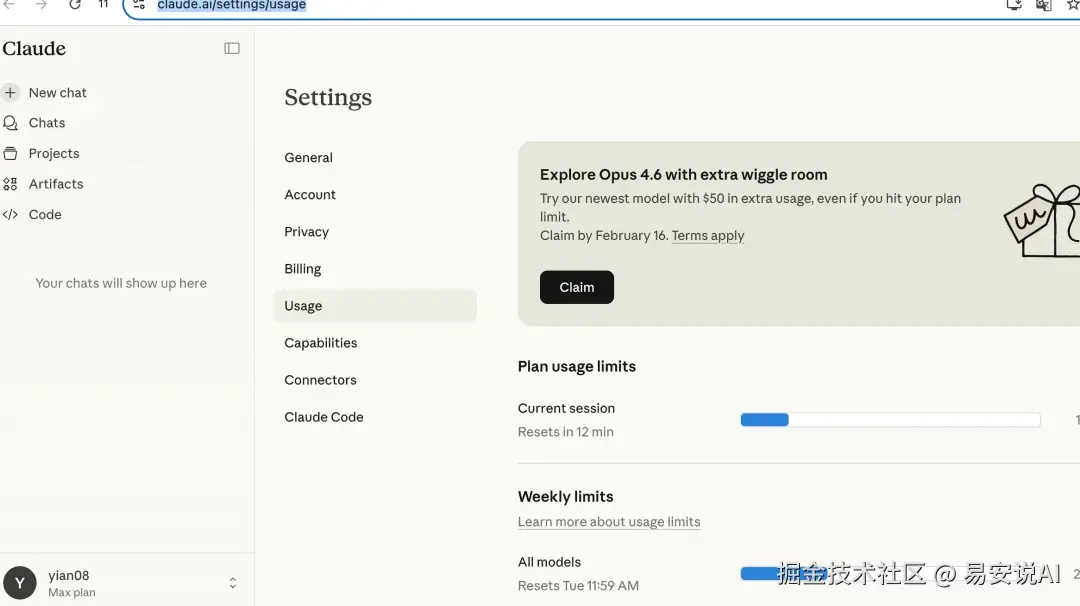
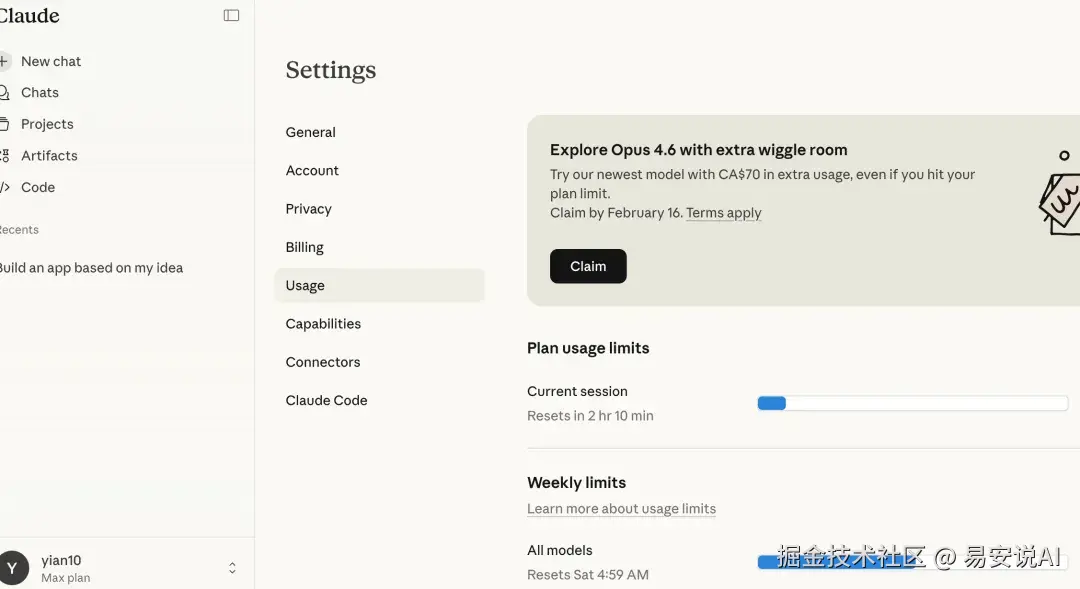
翻译下:试用我们最新的模型,赠送 $50 额外使用额度,即使你已达到套餐用量上限也能继续使用,我看有的帐号有70刀增金
看了一眼更新内容------1M 上下文、Agent Teams、价格不变------睡意全无,刚刚开完会就开始试。
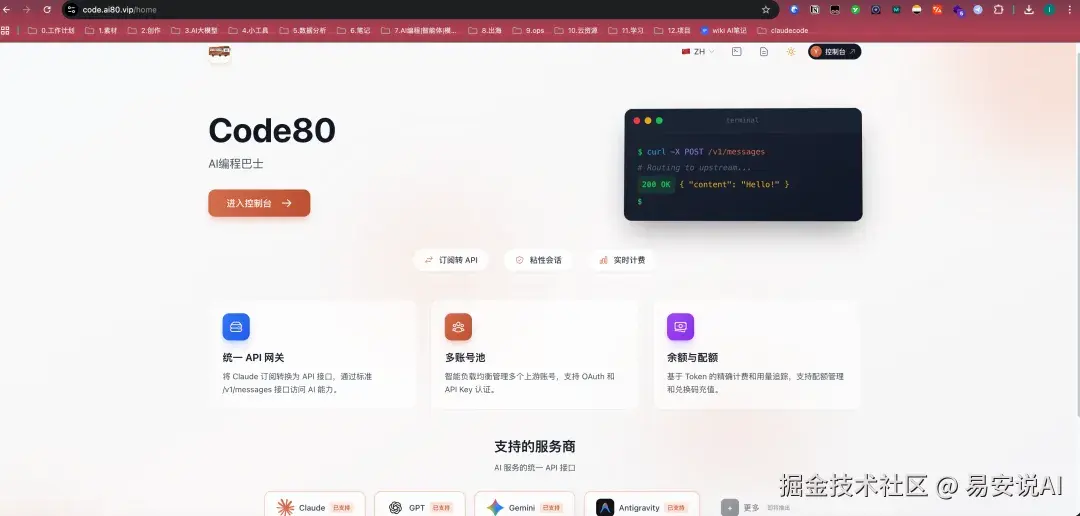
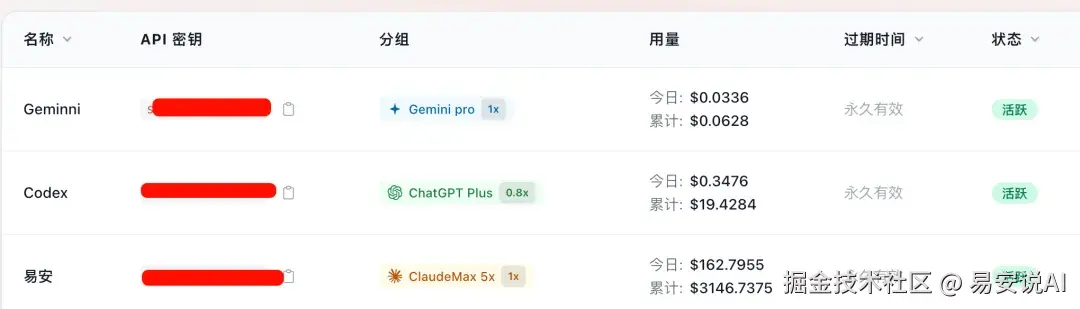
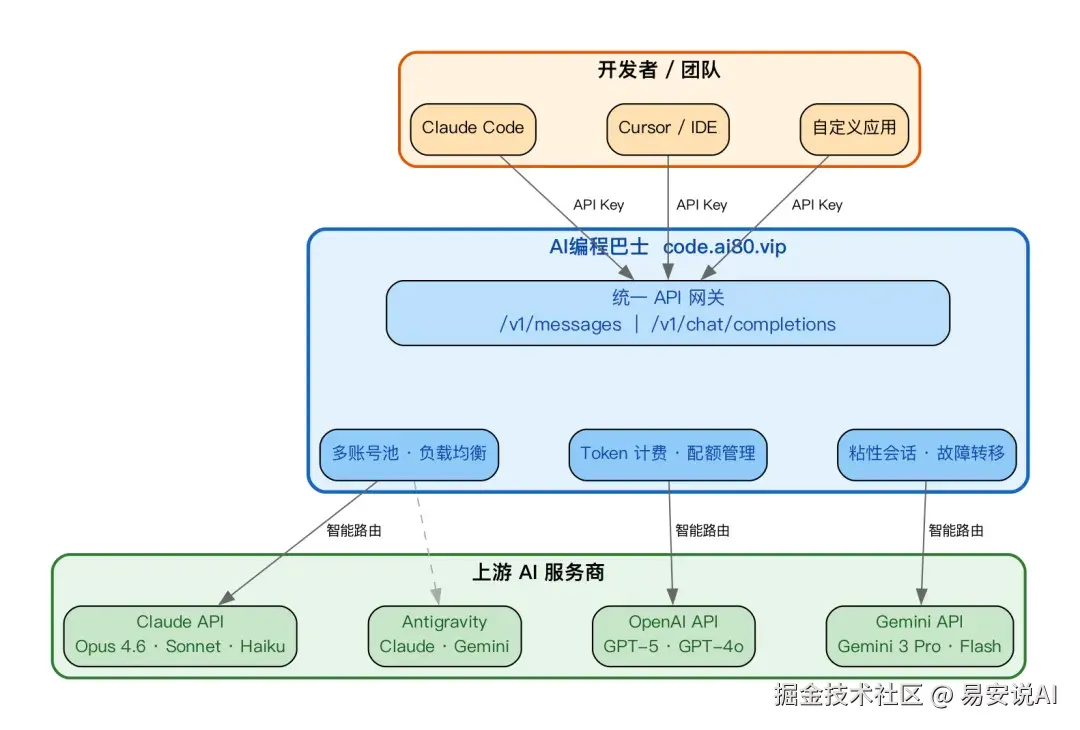
我自己运营着一个 AI API 网关服务(AI编程巴士),

底层是纯血 Claude Max 订阅直连转发,不搞逆向,不掺水,上游给什么就透传什么。
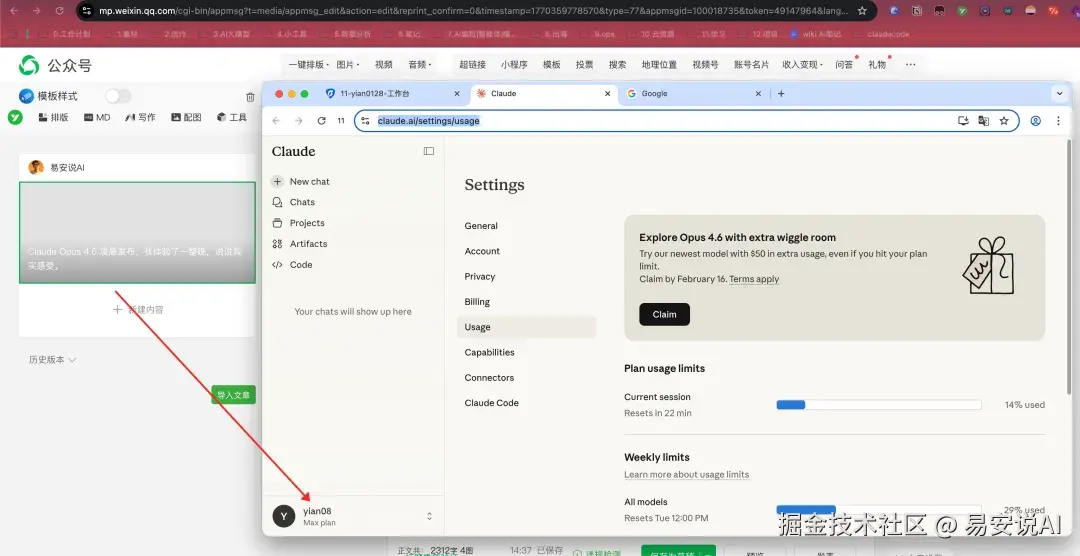
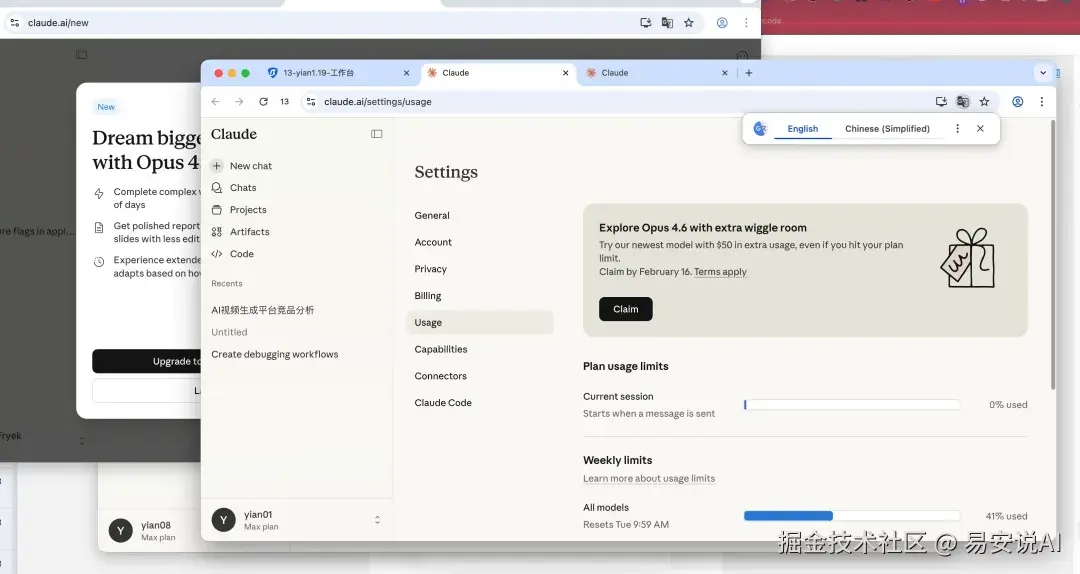
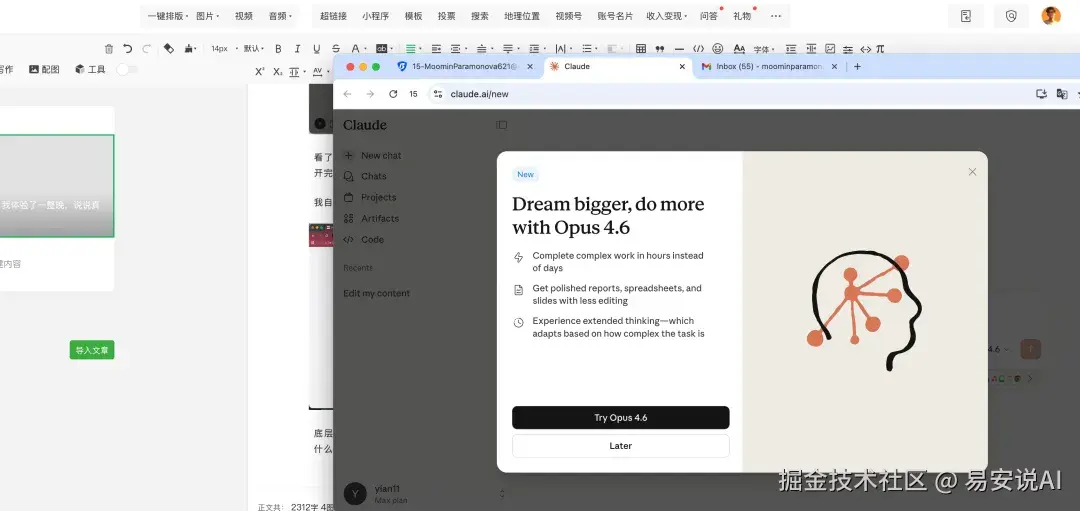
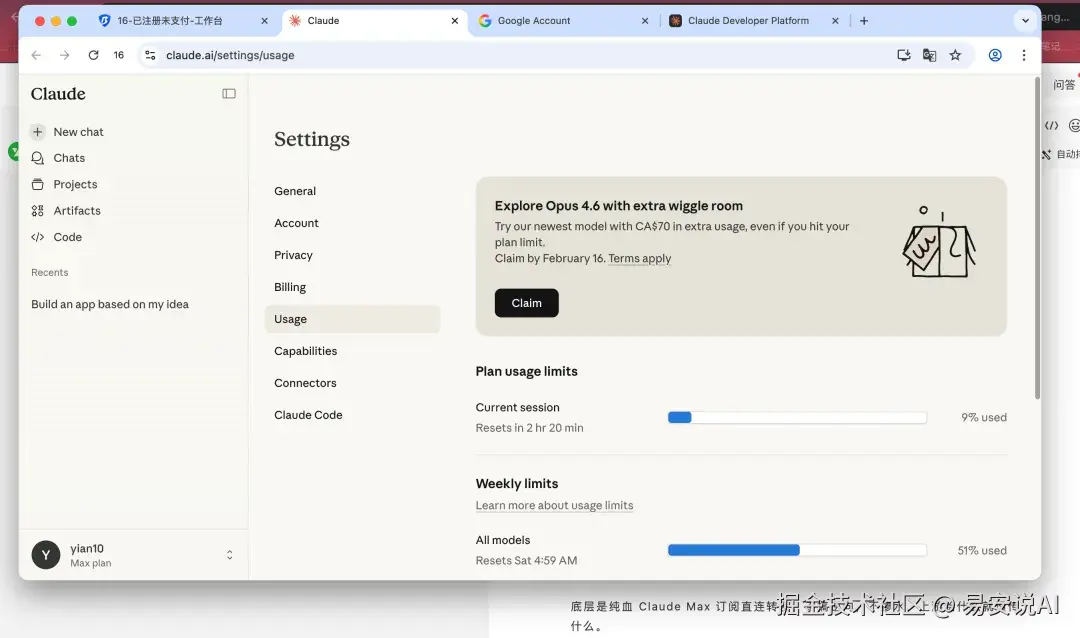
<<<截图了部分ClaudeMax帐号>>>
这个架构的好处是,Anthropic 出了新模型,用户换个模型名就能直接用,我这边不需要做任何改动。所以凌晨两点我不用改代码,直接拿 Opus 4.6 开始跑。
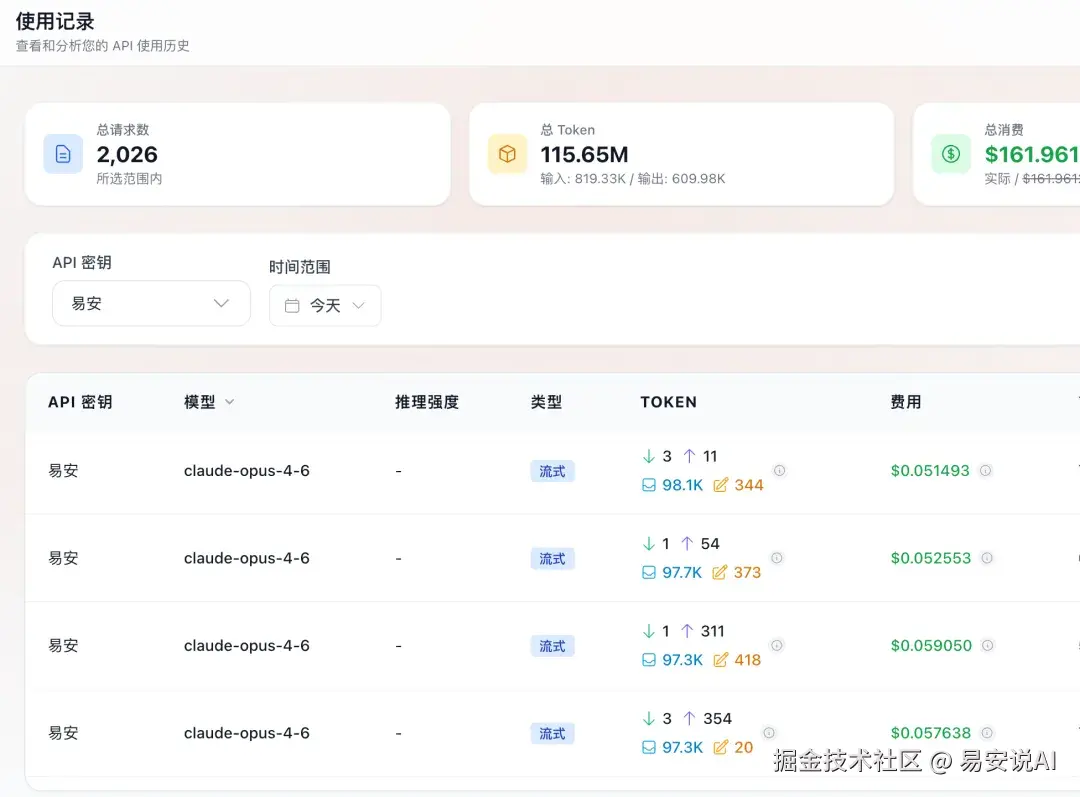
一口气折腾到早上五点,记录一下实际体验。
100 万上下文,终于补上了
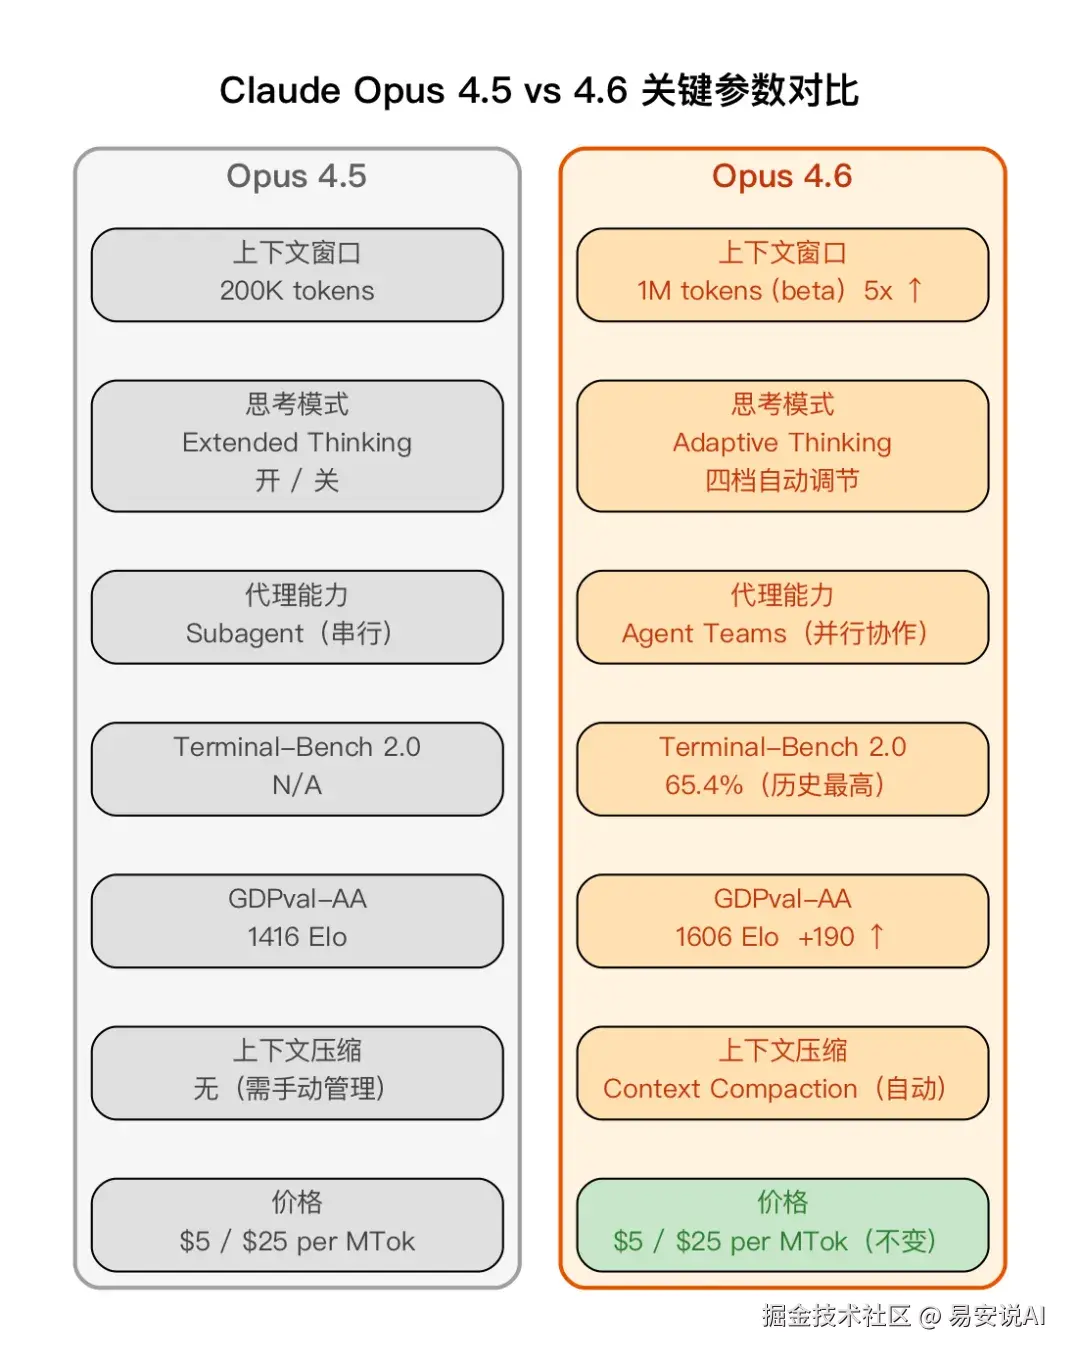
这是 Opus 系列第一次支持 1M token 上下文。之前 Opus 4.5 只有 200K,Sonnet 4.5 倒是早就有 1M 了,但 Sonnet 的推理能力跟 Opus 差了一个量级。
现在 Opus 也有 1M 了。最强大脑配上最大记忆,这个组合之前一直缺。
我拿自己的项目试了一下。后端 Go 加前端 Vue,大概十几万行代码,全部塞进去让它做架构审查。Opus 4.5 做这个事得分批喂,每次都要重新交代上下文。Opus 4.6 一次吃完,从路由层看到 service 层再到数据库 schema,直接指出了两处我没注意到的循环依赖。
这个体验跟之前不是一个级别。
Anthropic 放了个 MRCR v2 测试结果:1M tokens 里藏 8 根针,Opus 4.6 召回率 76%,Sonnet 4.5 只有 18.5%。四倍差距。不只是"能塞进去",而是"塞进去之后还记得住"。
不过 1M 目前还是 beta,需要单独申请。按 $5/MTok 的输入价算,塞满一次就是 5 美金。实际使用得有策略,不是越多越好。
Adaptive Thinking:同一个模型,自动调深度
这个功能我觉得被低估了。
以前的 extended thinking 是开关式的------要么开,要么不开。开了就慢,不开可能想不清楚。Opus 4.6 新增了四档思考深度,模型根据问题复杂度自动切换,开发者也能手动控制。
我在 AI编程巴士上跑了一组对比:
- • 简单任务(改变量名、写注释):响应比 Opus 4.5 快了大概 30%,模型判断不需要深度推理,直接出结果
- • 中等任务(重构函数、解释业务逻辑):速度持平
- • 复杂任务(分析并发 bug、设计系统架构):稍慢,但输出质量明显好了
因为是 Claude Max 直连,thinking 过程完整透传,不会被截断。跑复杂任务的时候能看到模型的思考链一步步展开,流式输出全程无断流。再加上我们做了 prompt 缓存优化,命中率在 95% 以上,重复上下文不用重新算,响应速度比直连 API 还快一截。
以前很多人为了省钱会手动分流------简单问题用 Haiku,复杂问题用 Opus。现在一个 Opus 4.6 就够了,模型自己决定花多少算力。同样的预算能做更多事。
Agent Teams:从串行到并行
之前 Claude Code 的 subagent 是串行的------主代理分配任务,子代理做完了回来汇报,再分配下一个。
Agent Teams 变成了并行协作,代理之间能直接通信。
我试了一个场景:让它审查一个全栈 API 变更。它自动拆成三条线------后端路由校验、前端调用检查、测试覆盖分析------同时跑。后端那条线发现我改了一个字段名,直接通知前端线去定位没更新的调用点,不用回到主代理中转。
以前是"你去干活,干完了告诉我"。现在是"你们几个商量着来"。
这个功能目前主要在 Claude Code 里体现,API 层面还没完全开放。后续 Anthropic 可能会把多代理能力以 tool_use 的形式开放出来,到时候玩法会多很多。
价格不变,成本反而可能降
5输入/25 输出 / MTok,和 Opus 4.5 一样。
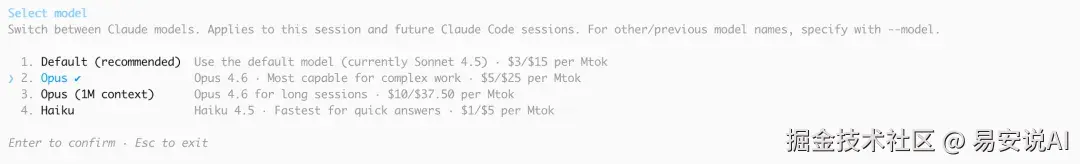
旗舰模型升级不涨价,这个我没想到。AI编程巴士上用户的使用成本完全不受影响,模型名换一下就行。
但实际开销可能还会降------Adaptive Thinking 让简单任务消耗更少的 token。如果你日常七八成是编码辅助,只有两三成需要深度推理,总成本大概率比之前低。
我打算跑一周数据,统计一下新老模型的实际 token 消耗差异,到时候再分享。
跑分参考
Terminal-Bench 2.0(代理编码):65.4%,历史最高。不过 20 分钟后 OpenAI 发的 GPT-5.3 Codex 拿了 77.3%,超了 12 个点。
GDPval-AA(综合推理):1606 Elo,比 GPT-5.2 高 144 分,比 Opus 4.5 高 190 分。
Humanity's Last Exam(跨学科推理):领先所有公开模型。
跑分看个大概就行。不同 benchmark 的测试框架、题目集都不一样,跨模型对比本身就不严谨。我更信自己手上跑出来的结果。
值得注意的坑
Reddit 上有人反馈写作能力比 4.5 退步了------"结构工整但没有灵气"。社区猜测是 Anthropic 做了大量 RL 拉编程分数,牺牲了自然语言表达。
另一个 breaking change:assistant message prefilling 被禁了,直接返回 400。依赖这个功能的开发者需要改代码。
场景偏写作的,建议先测再迁移。编程场景可以放心切。
怎么用上 Opus 4.6
直接调 Anthropic API,模型名填 claude-opus-4-6,接口协议和之前完全一样。
如果你没有 Anthropic API 的直接访问权限,或者需要在团队内按量分发配额,可以看看 AI编程巴士。纯血 Claude Max 直连,有思考、无断流、缓存命中 95%+(每天详细调用量发送你的邮箱),新模型发布即可用。Claude、GPT、Gemini 统一接口,按 token 计费,有超级便宜的包月套餐可选。
体验了一整晚,Opus 4.6 在编程方向的提升是实打实的。1M 上下文让大项目不用再分批投喂,Adaptive Thinking 让日常使用更省钱,价格还没变。
作为日常开发的默认模型,可以切了。
如果你也在用 AI 编程,欢迎交流,20133213可以找到我。
易安致力于为高T提供稳定可靠的纯血Claude,GPT,Gemini 模型服务,节省你们的时间,平均才0.5-0.6元一刀,而且是纯血帐号,无逆向,无倍率,性价比拉满。