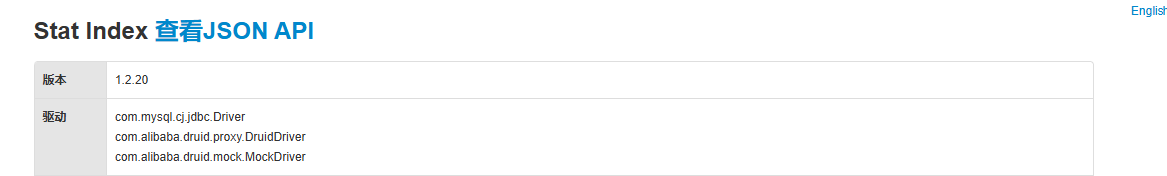
1.导入依赖
<dependency> <groupId>com.alibaba</groupId> <artifactId>druid</artifactId> <version>1.2.20</version> </dependency>
2.修改yml
spring:
datasource:
username: root
password: mahaoxiang123
url: jdbc:mysql://127.0.0.1:3306/boot_demo?useUnicode=true&characterEncoding=UTF-8&useSSL=false&connectTimeout=3000&socketTimeout=3000
driver-class-name: com.mysql.cj.jdbc.Driver
type: com.alibaba.druid.pool.DruidDataSource
spring: datasource: username: root password: mahaoxiang123 url: jdbc:mysql://127.0.0.1:3306/boot_demo?useUnicode=true&characterEncoding=UTF-8&useSSL=false&connectTimeout=3000&socketTimeout=3000 driver-class-name: com.mysql.cj.jdbc.Driver type: com.alibaba.druid.pool.DruidDataSource initialSize: 5 minIdle: 5 maxActive: 20 maxWait: 60000 timeBetweenEvictionRunsMillis: 60000 minEvictableIdleTimeMillis: 300000 validationQuery: SELECT 1 testWhileIdle: true testOnBorrow: false testOnReturn: false poolPreparedStatements: true maxPoolPreparedStatementPerConnectionSize: 20 filters: stat,wall useGlobalDataSourceStat: true connectionProperties: druid.stat.mergeSql=true;druid.stat.slowSqlMillis=500
现在要明确一件事:
只靠 type = DruidDataSource 还不够
Druid 不会像 Hikari 一样被 Spring Boot 完全自动接管
所以 必须写配置类
3.创建 Druid 配置类DruidConfig
@Configuration public class DruidConfig { @ConfigurationProperties(prefix = "spring.datasource") @Bean public DataSource dataSource() { return new DruidDataSource(); } // 1. 配置 Druid 监控后台 Servlet @Bean public ServletRegistrationBean statViewServlet() { ServletRegistrationBean bean = new ServletRegistrationBean(new StatViewServlet(), "/druid/*"); Map<String, String> initParams = new HashMap<>(); initParams.put("loginUsername", "root"); initParams.put("loginPassword", "mahaoxiang123"); initParams.put("allow", ""); initParams.put("deny", "127.0.0.1"); bean.setInitParameters(initParams); return bean; } // 2. 配置 Web 监控 Filter @Bean public FilterRegistrationBean webStatFilter() { FilterRegistrationBean bean = new FilterRegistrationBean(); bean.setFilter(new WebStatFilter()); Map<String, String> initParams = new HashMap<>(); initParams.put("exclusions", "*.js,*.css,/druid/*"); bean.setInitParameters(initParams); bean.setUrlPatterns(Arrays.asList("/*")); return bean; } }
这一刻开始, 你已经不是"自动数据源"了,而是:
- new 了 DruidDataSource
- Spring 只是托管它
- 参数从 yml 自动绑定进来
4.启动验证
启动maven启动类访问
http://localhost:8086/druid