1.流程
flowchart TD
SpringBoot[Spring Boot] --> P6Spy[P6Spy 监控SQL打印纯文本日志]
P6Spy --> Logstash[Logstash 采集并输出 JSON 日志]
Logstash --> Filebeat[Filebeat 采集日志文件]
Filebeat --> Elasticsearch[Elasticsearch 存储索引]
Elasticsearch --> Kibana[Kibana 查询 + 可视化]
2.步骤
①.P6Spy
pom.xml 中引入依赖
xml
<dependency>
    <groupId>p6spy</groupId>
    <artifactId>p6spy</artifactId>
    <version>3.9.1</version>
</dependency>
application.xml 中修改数据源驱动
xml
spring:
  datasource:
    # 数据库连接地址
    # url: jdbc:mysql://localhost:3306/netdisk?useSSL=false&&allowPublicKeyRetrieval=true&serverTimezone=UTC&characterEncoding=UTF-8
    # 数据库用户名
    username: root
    # 数据库密码
    password: 123456
    # MySQL 8.x 驱动
    # driver-class-name: com.mysql.cj.jdbc.Driver

    driver-class-name: com.p6spy.engine.spy.P6SpyDriver
    url: jdbc:p6spy:mysql://localhost:3306/netdisk
配置resources/spy.properties
properties
# 使用日志模块
modulelist=com.p6spy.engine.logging.P6LogFactory

# 使用 Slf4j 输出(交给 Spring Boot 日志系统)
appender=com.p6spy.engine.spy.appender.Slf4JLogger

# 单行格式
logMessageFormat=com.p6spy.engine.spy.appender.SingleLineFormat

# 不排除任何类型(方便调试)
excludecategories=
启动项目,每次执行SQL会有日志输出
②.logstash-logback-encoder
pom.xml 中引入依赖
xml
<dependency>
    <groupId>net.logstash.logback</groupId>
    <artifactId>logstash-logback-encoder</artifactId>
    <version>6.4</version>
</dependency>
配置resources/logback-spring.xml
xml
<configuration>

    <!-- 控制台 JSON 输出 -->
    <appender name="CONSOLE" class="ch.qos.logback.core.ConsoleAppender">
        <encoder class="net.logstash.logback.encoder.LogstashEncoder"/>
    </appender>

    <!-- 文件 JSON 输出 -->
    <appender name="FILE" class="ch.qos.logback.core.rolling.RollingFileAppender">
        <file>logs/netdisk.log</file>

        <rollingPolicy class="ch.qos.logback.core.rolling.TimeBasedRollingPolicy">
            <fileNamePattern>logs/netdisk.%d{yyyy-MM-dd}.log</fileNamePattern>
            <maxHistory>7</maxHistory>
        </rollingPolicy>

        <encoder class="net.logstash.logback.encoder.LogstashEncoder"/>
    </appender>

    <!-- P6Spy 单独提高等级 -->
    <logger name="p6spy" level="INFO"/>

    <!-- MyBatis Mapper -->
    <logger name="com.example.netdisk.mapper" level="DEBUG"/>

    <!-- 根日志 -->
    <root level="INFO">
        <appender-ref ref="CONSOLE"/>
        <appender-ref ref="FILE"/>
    </root>

</configuration>
这样一来输出就变成JSON格式的了。而且根目录/logs/netdisk.log文件里也有日志。
③.Elasticsearch + Kibana + Filebeat
(1).基础设置层部署
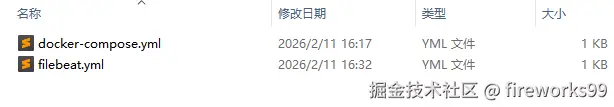
docker-compose.xml
xml
version: '3'
services:
  elasticsearch:
    image: docker.elastic.co/elasticsearch/elasticsearch:8.12.0
    container_name: es
    environment:
      - discovery.type=single-node
      - xpack.security.enabled=false
      - ES_JAVA_OPTS=-Xms1g -Xmx1g
    ports:
      - 9200:9200
    volumes:
      - es_data:/usr/share/elasticsearch/data

  kibana:
    image: docker.elastic.co/kibana/kibana:8.12.0
    container_name: kibana
    ports:
      - 5601:5601
    environment:
      - ELASTICSEARCH_HOSTS=http://elasticsearch:9200
    depends_on:
      - elasticsearch

  filebeat:
    image: docker.elastic.co/beats/filebeat:8.12.0
    container_name: filebeat
    user: root
    command: >
      sh -c "chmod go-w /usr/share/filebeat/filebeat.yml && filebeat -e"
    volumes:
      - ./filebeat.yml:/usr/share/filebeat/filebeat.yml
      - ../netdisk/logs:/logs
    depends_on:
      - elasticsearch

volumes:
es_data:注意这里filebeat的volumes里的相对路径../netdisk/logs:/logs,这里../netdisk是我Spring Boot项目,而/logs是 logstash-logback-encoder 输出日志的位置。
filebeat.yml
xml
filebeat.inputs:
  - type: filestream
    paths:
      - /logs/netdisk.log
    json.keys_under_root: true
    json.add_error_key: true

setup.template.name: "netdisk"
setup.template.pattern: "netdisk-*"
setup.template.enabled: true

output.elasticsearch:
  hosts: ["http://elasticsearch:9200"]
  index: "netdisk-sql-%{+yyyy.MM.dd}"
注意这里的 paths 要对应日志文件的位置。
docker-compose up -d启动容器,然后访问localhost:5601(kibana)。
(2).创建索引 (Index Pattern)
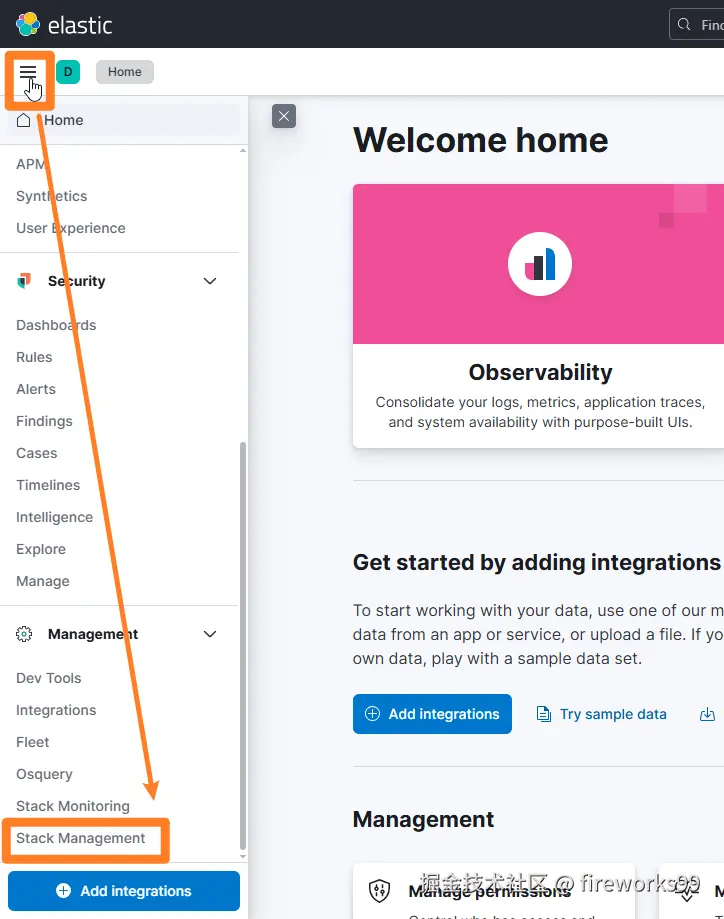
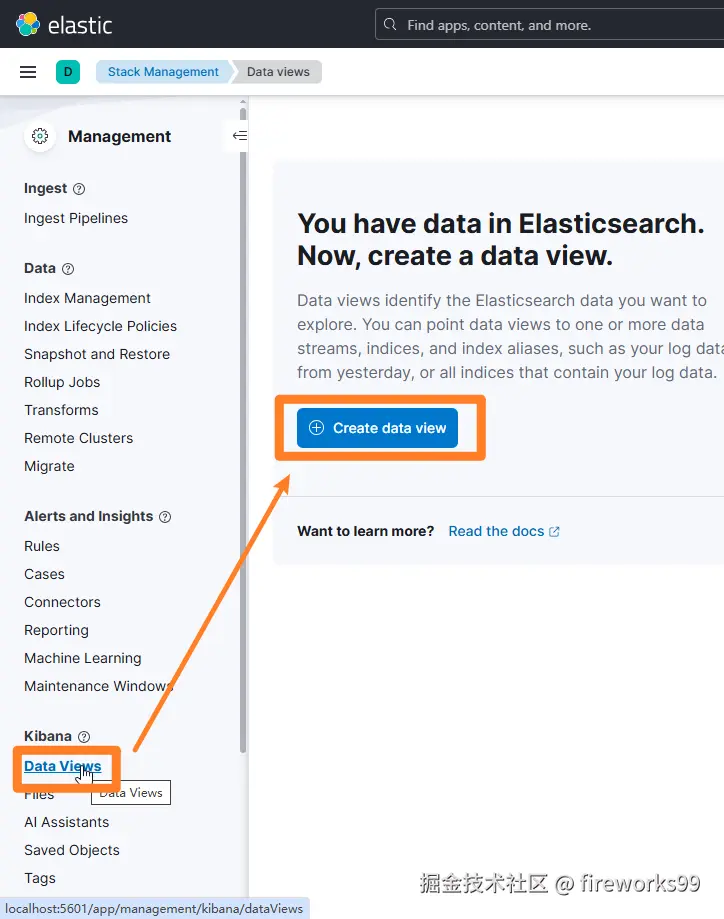
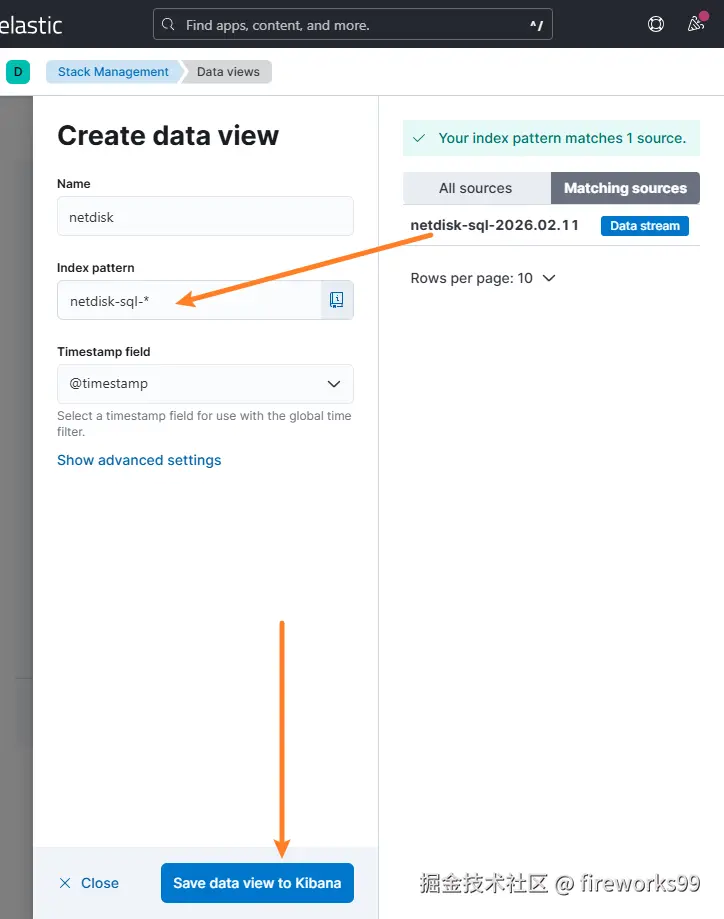
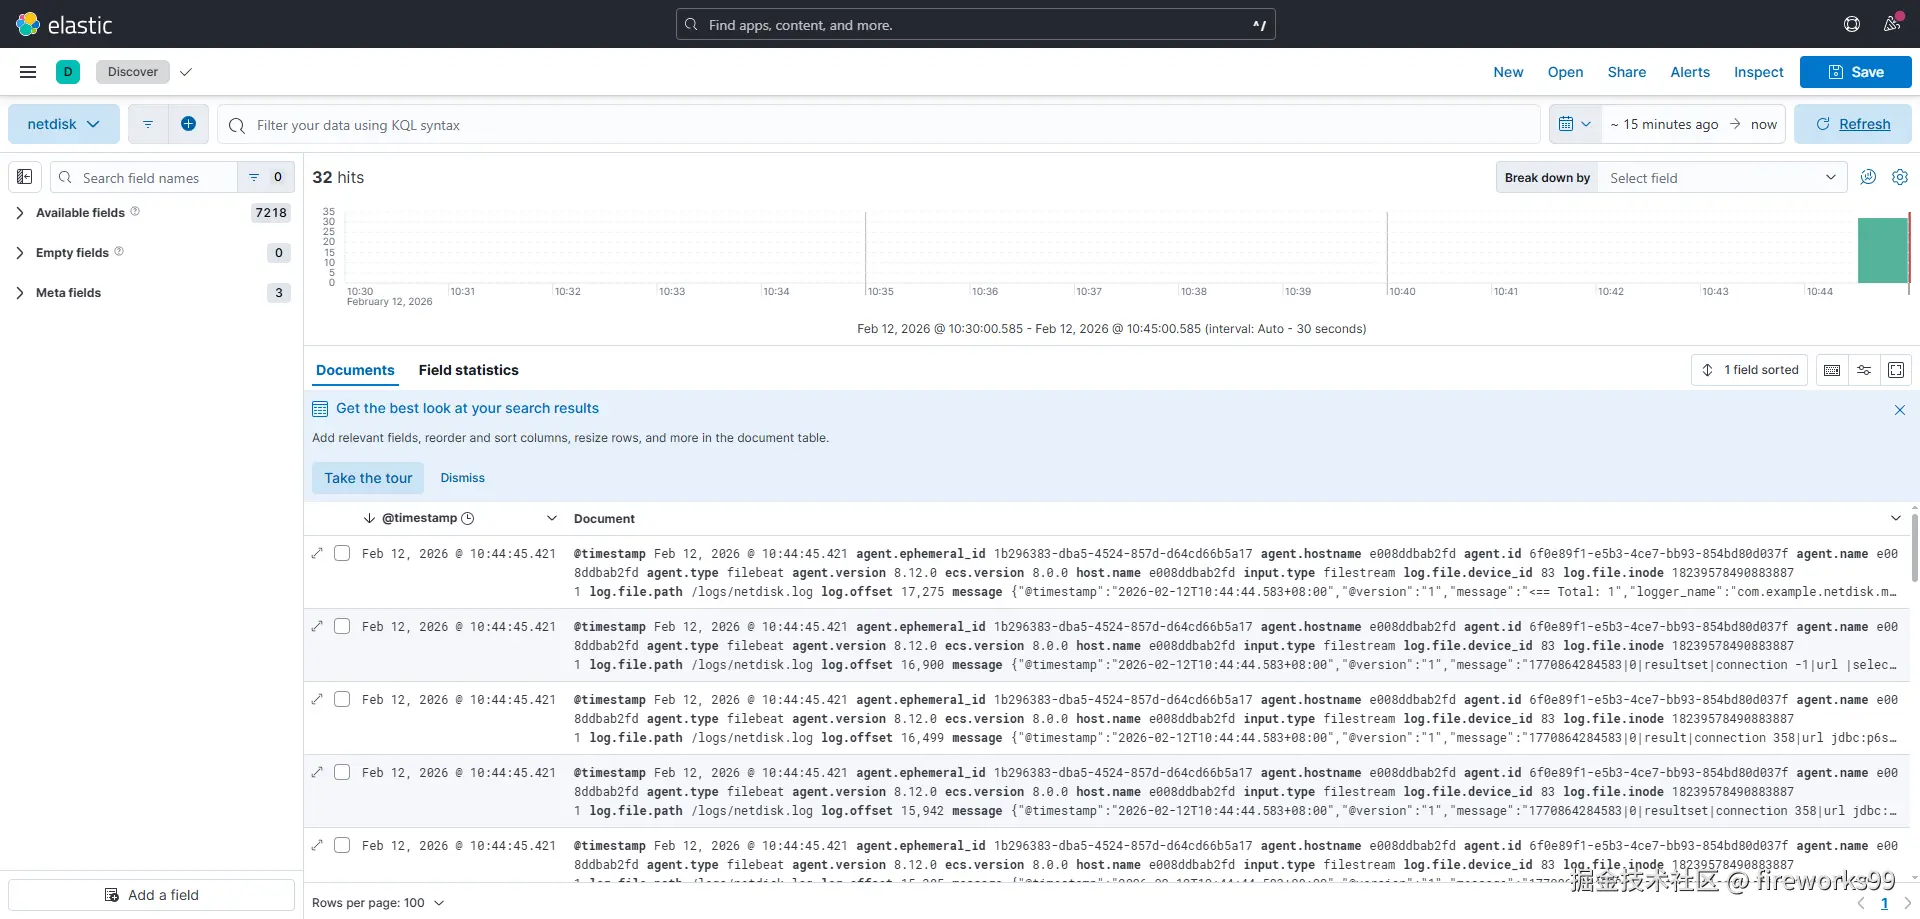
(3).Discover页面查看
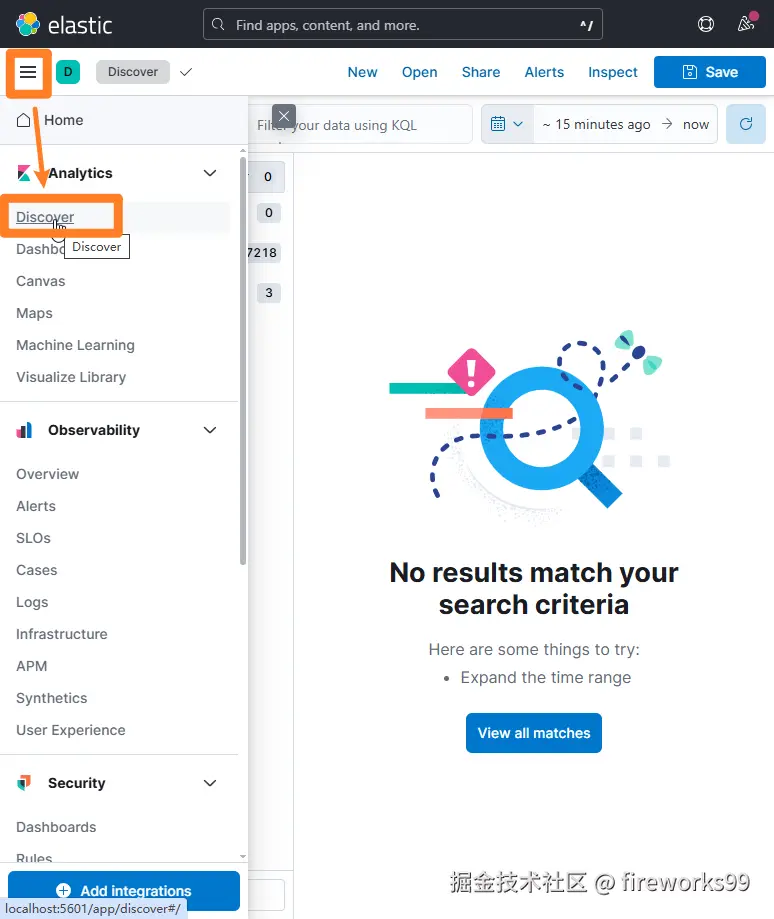
调用SQL便能看到日志: