大模型推理引擎vLLM(14): 什么是MLA多头潜在注意力

文章目录

  • [1 视频1](#1 视频1)
  • [2 疑问和个人理解](#2 疑问和个人理解)
    • [2.1 个人理解:什么是MLA](#2.1 个人理解:什么是MLA)
    • [2.2 疑问:位置信息是怎么优化的](#2.2 疑问:位置信息是怎么优化的)
  • 参考文献

abstract
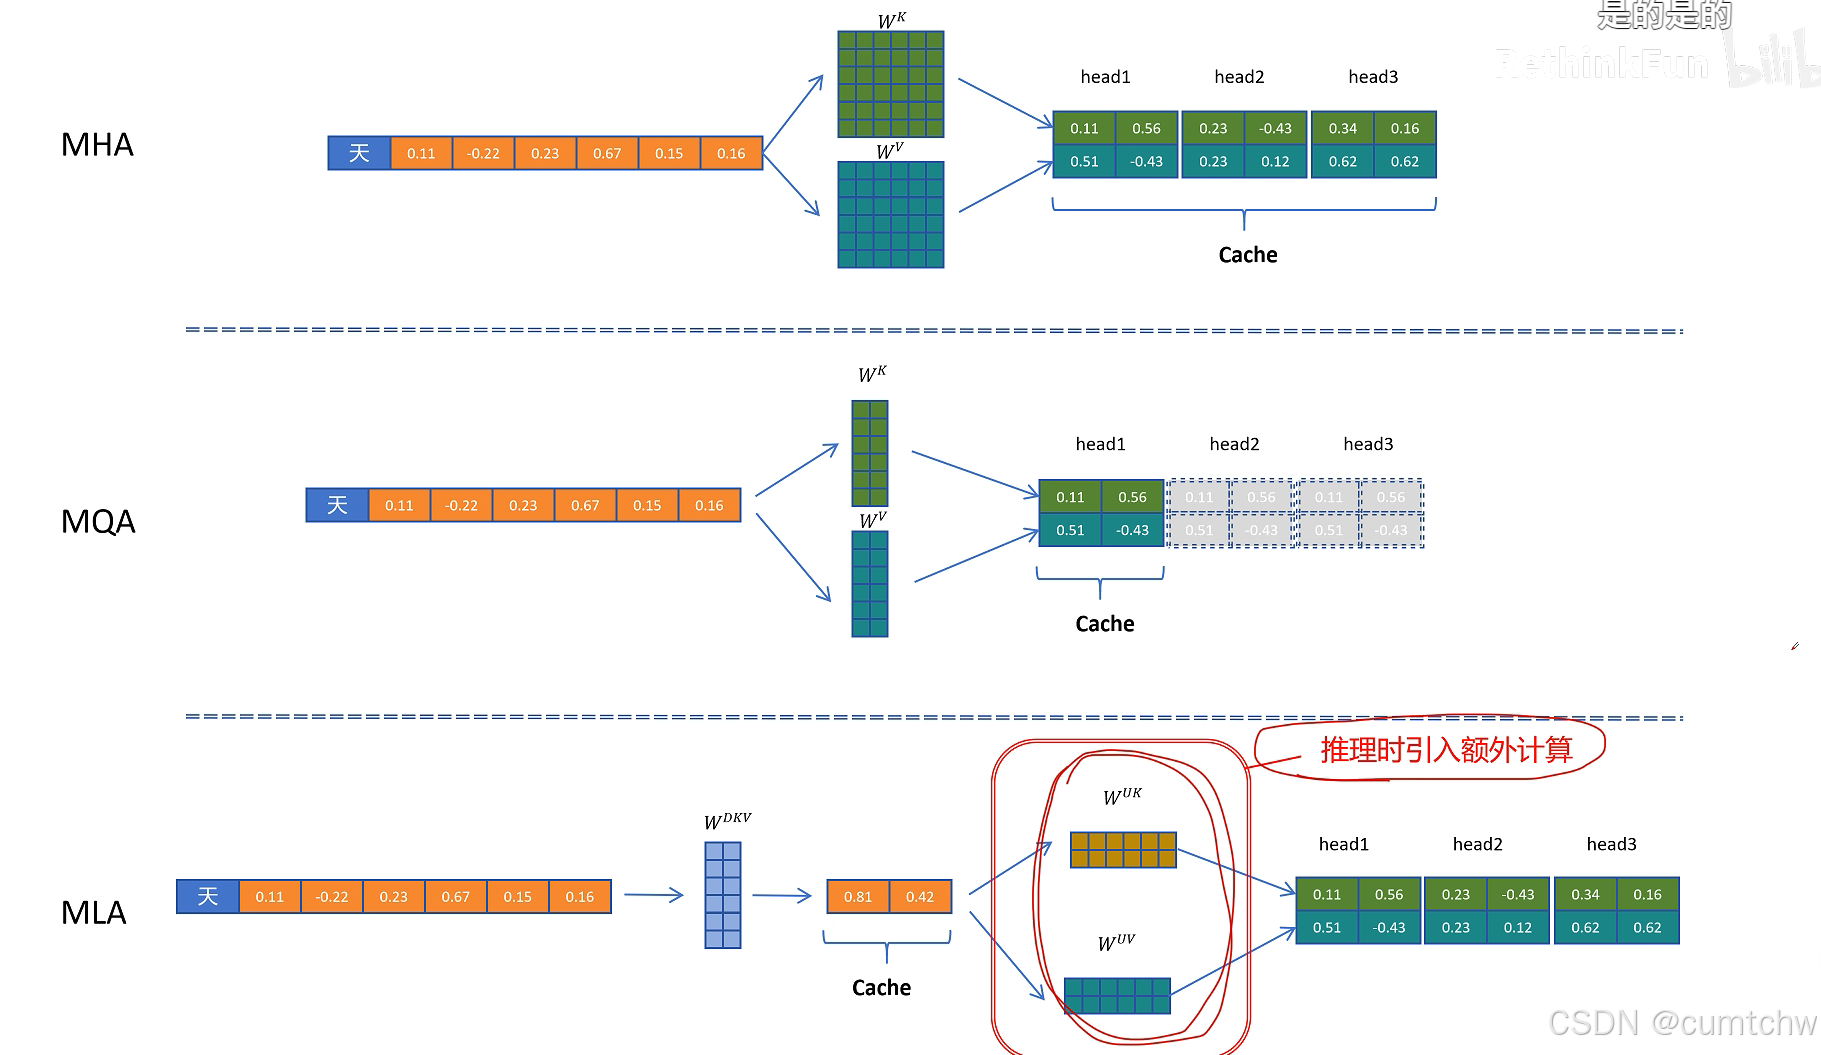
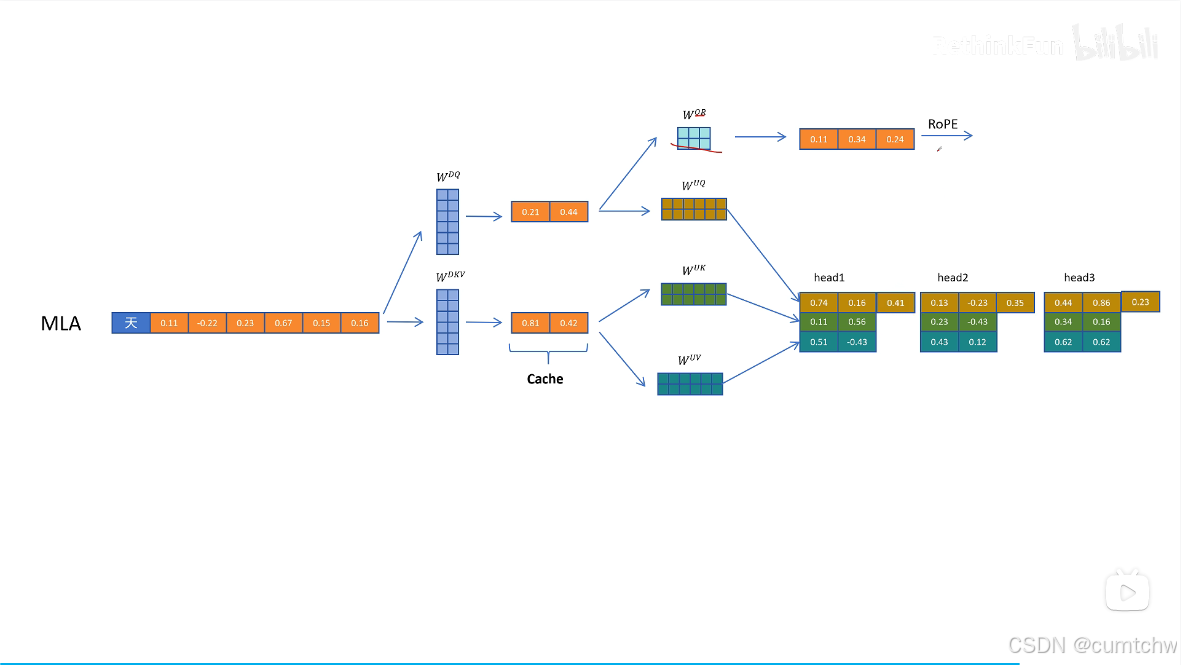
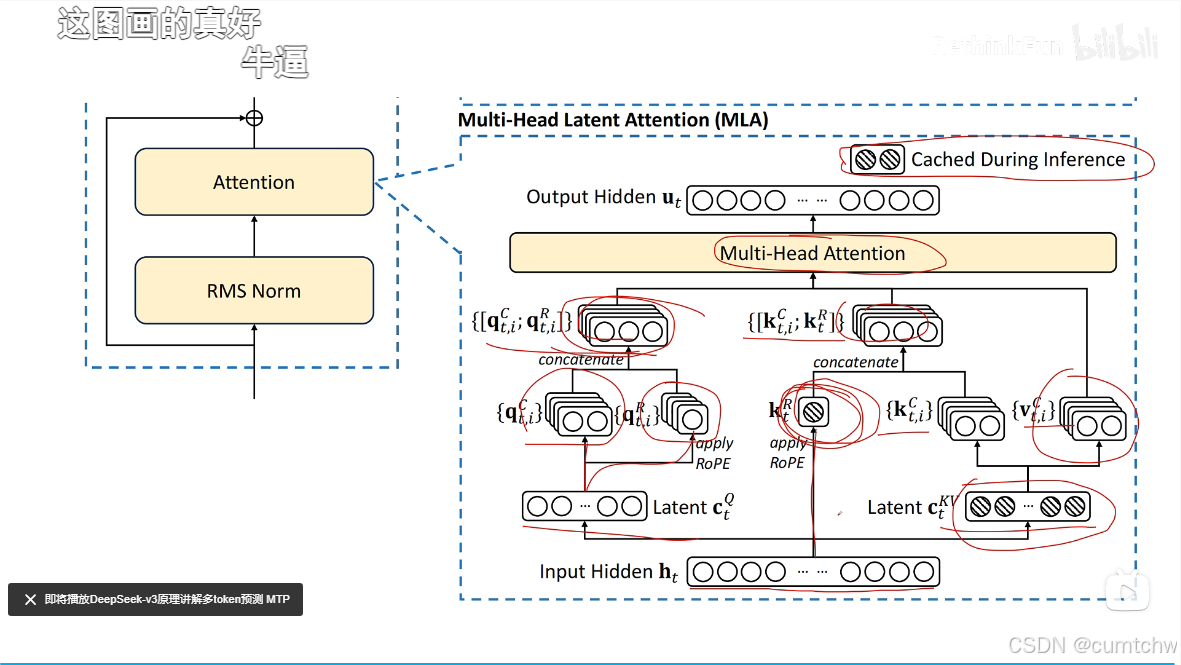
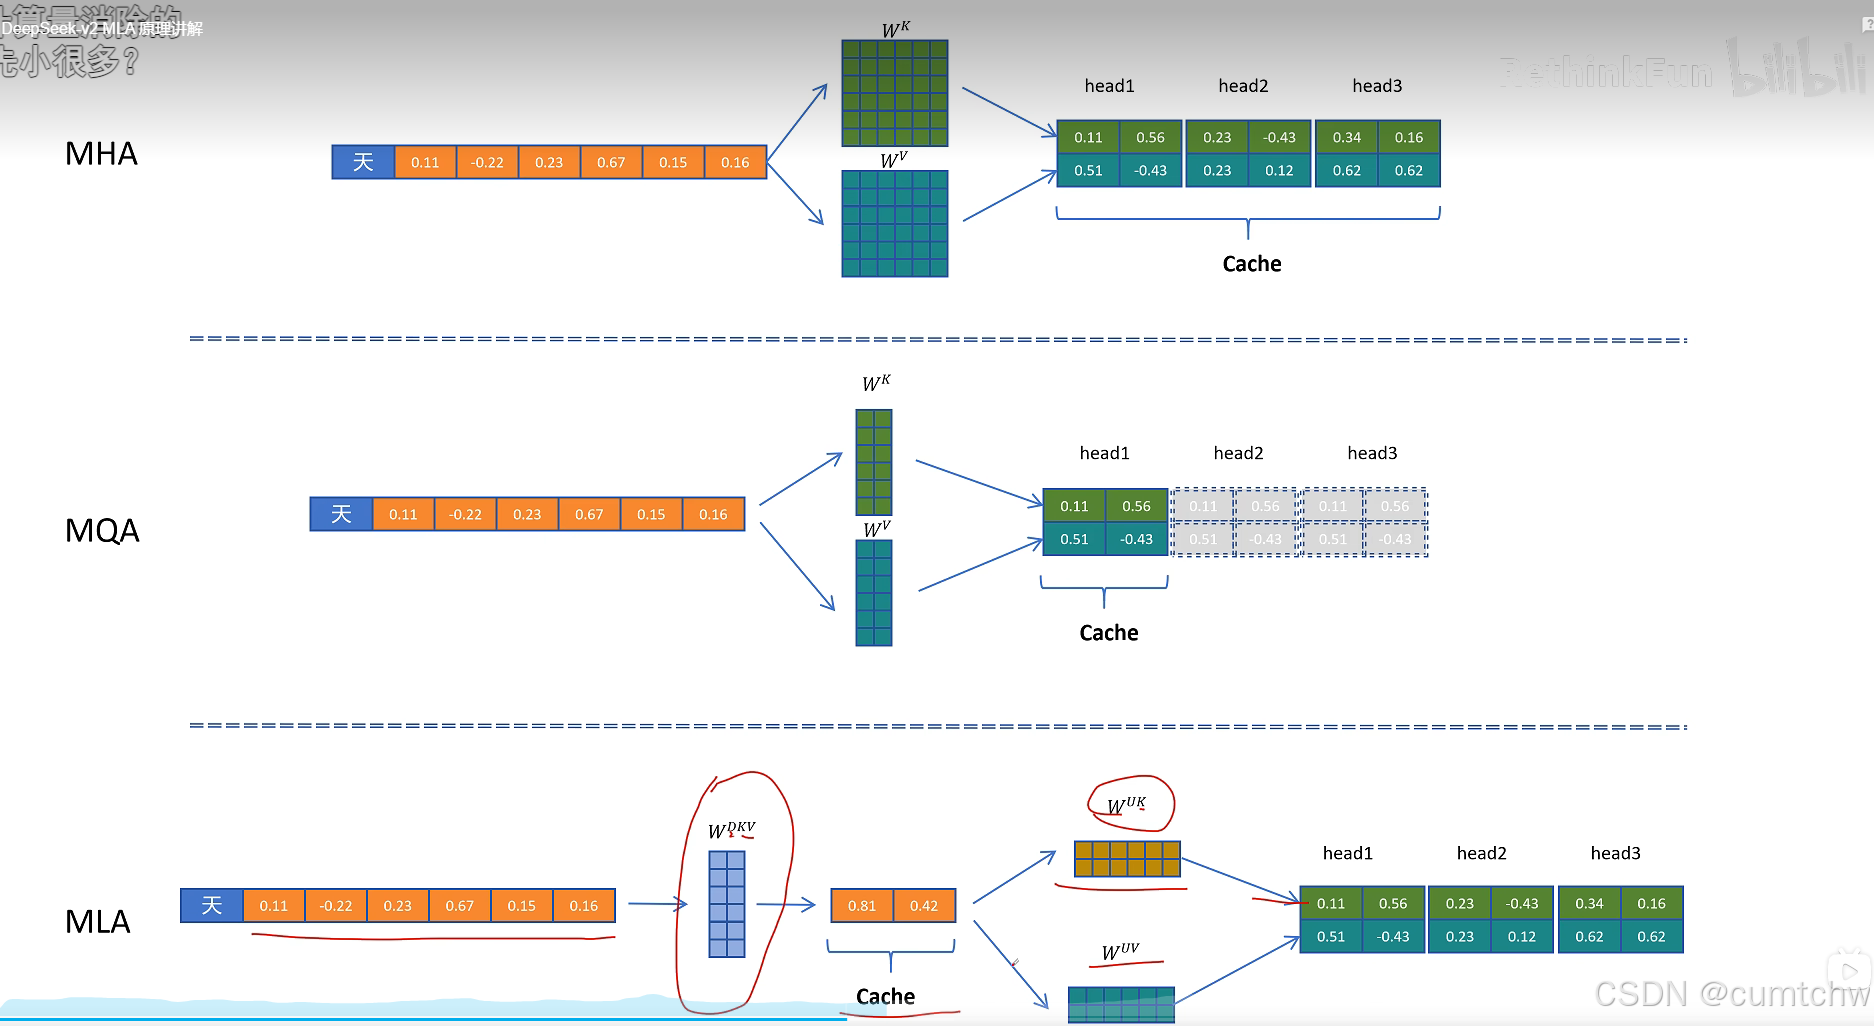
MLA就是压缩KV减少显存占用
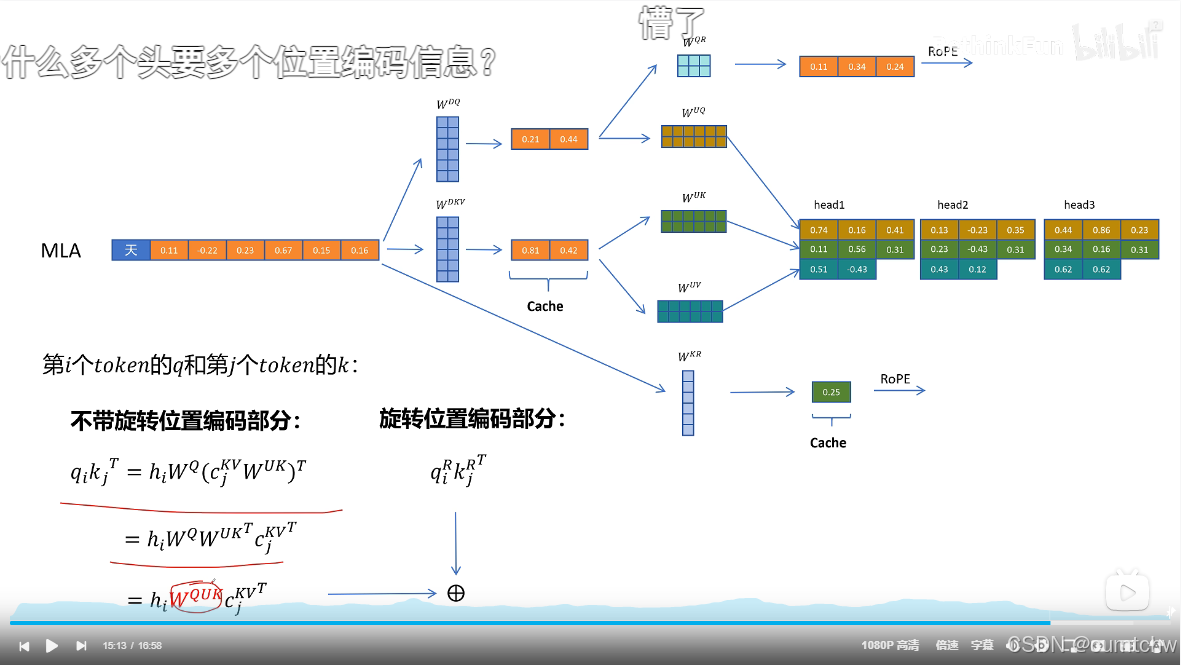
增加向量维度表示位置信息,以支持矩阵乘法融合,

1 视频1

视频地址:DeepSeek-v2 MLA 原理讲解


多头潜在注意力怎么解决旋转位置编码的问题
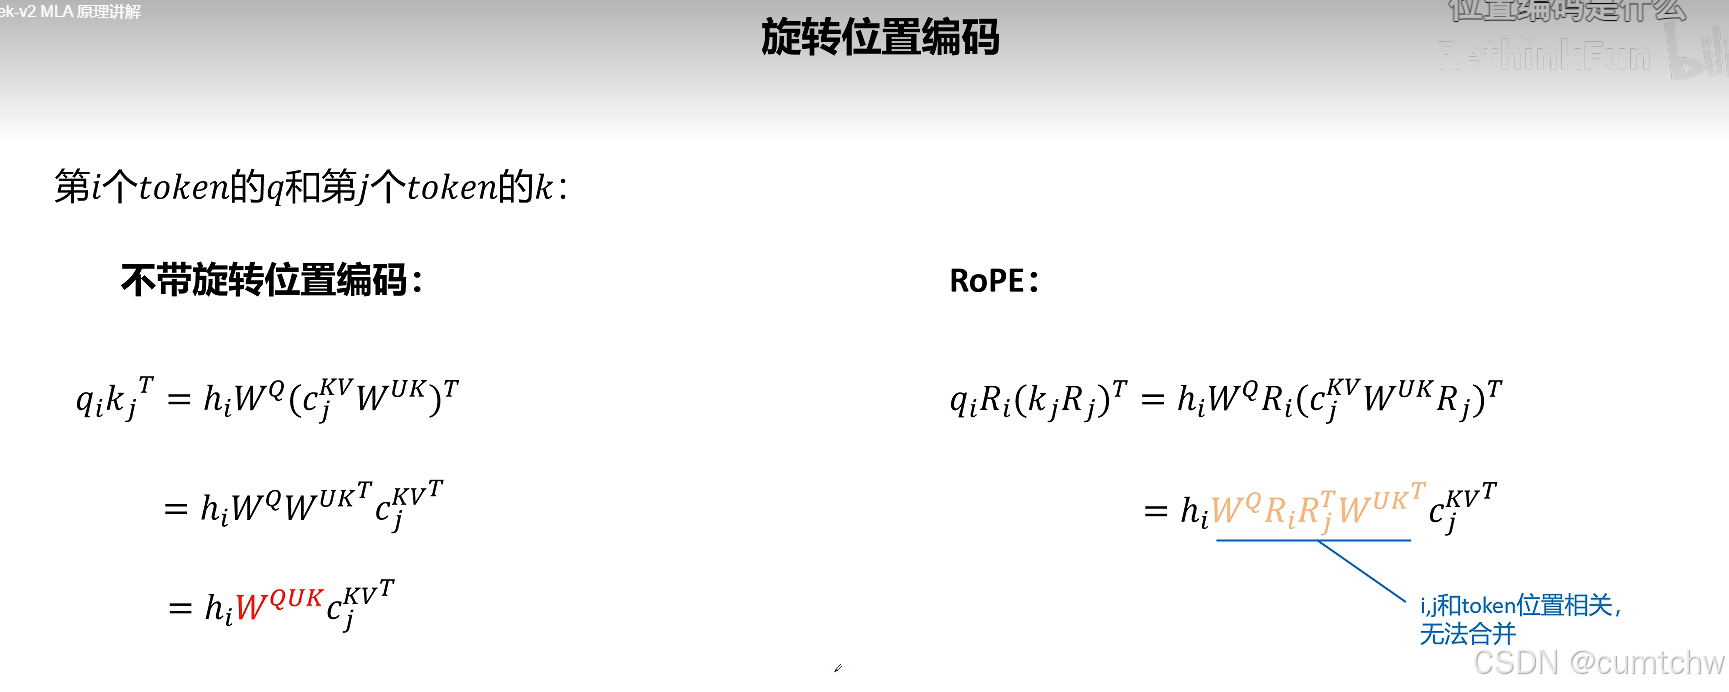
解决方式就是给Q K向量额外增加一些维度来表示位置信息,
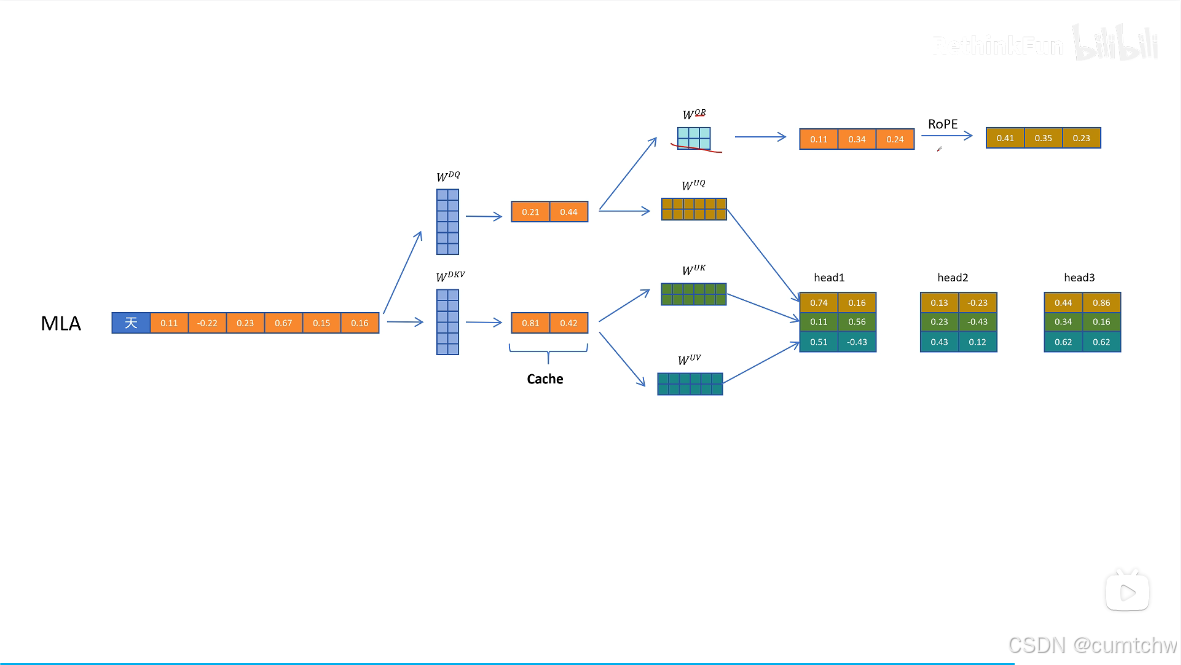


2 疑问和个人理解

2.1 个人理解:什么是MLA

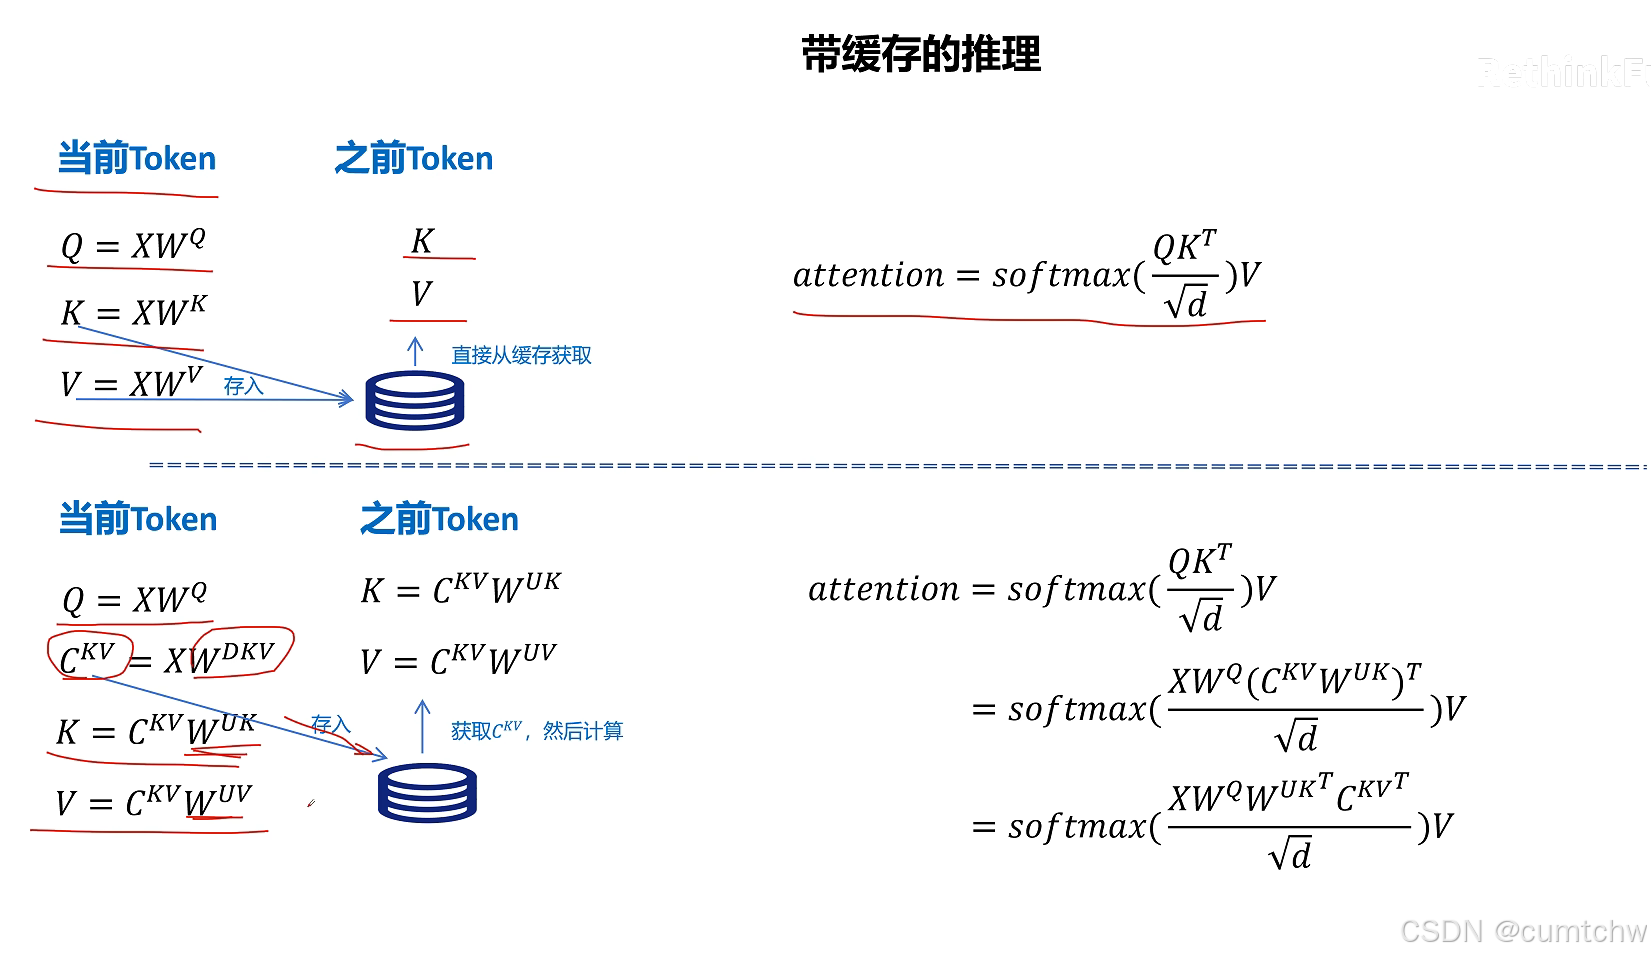
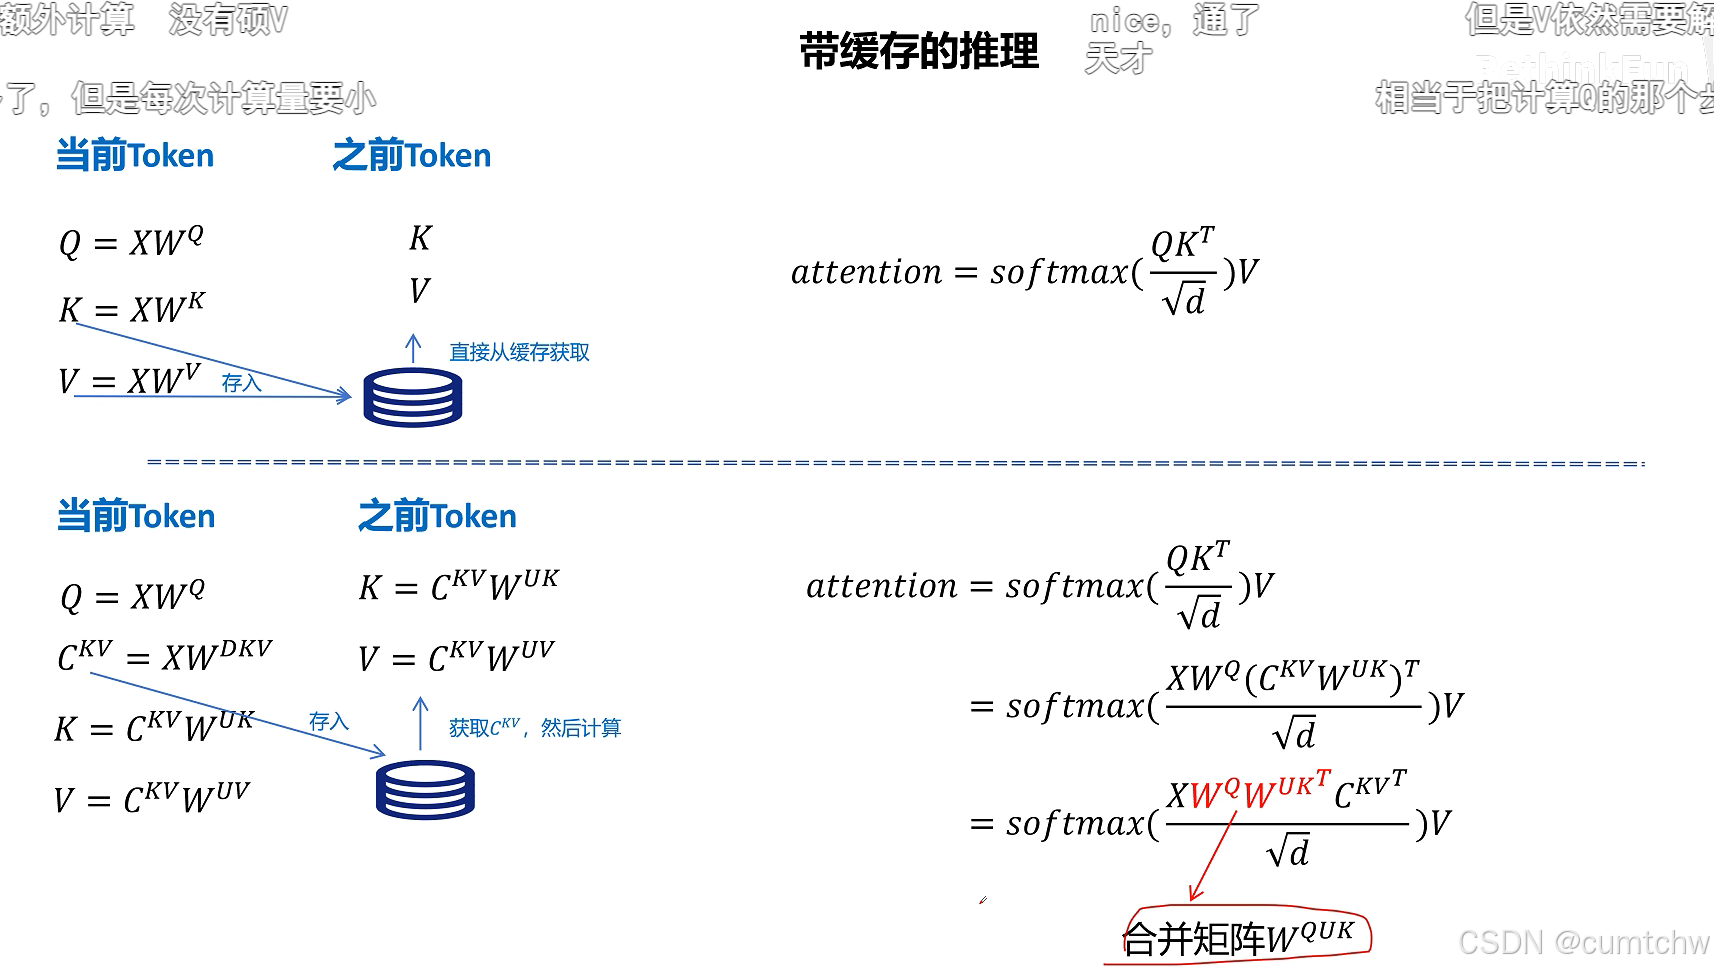
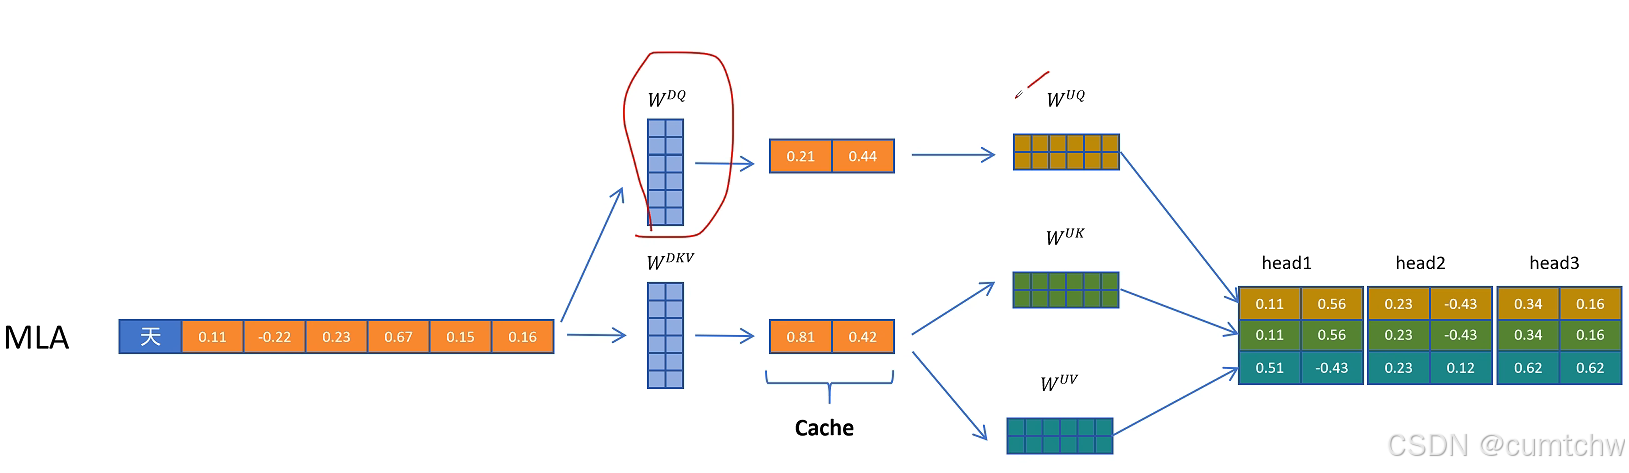
我的理解,什么是MLA,MLA其实就是为了减少KV CACHE的空间占用,用一个矩阵乘以K V然后做了压缩,等后面计算注意力的时候再用一个矩阵乘以压缩后的得到正常的KV,所以所谓的MLA其实一句话总结就是压缩KV节省缓存,其实就跟一个大文件,我压缩包然后放到电脑中,等我真正要看这个文件,我再解压然后去看这个文件,这是一个意思,

2.2 疑问:位置信息是怎么优化的

然后他对位置信息还有个优化,就是之前位置信息是通过将Q K乘以一个旋转位置编码矩阵使Q K的向量中包含了位置信息,但是现在如果还是这么做,那么就没法使用矩阵乘法的融合从而减小 运算了,所以DeepSeek采用了另一个方法,就是现在位置信息我不是去乘以Q K 了,而是我通过一个将Q K 乘以一个矩阵然后再用旋转位置编码,然后接着我把得到的这个位置信息加到前面Q K 的维度上,通过增加维度信息来表示位置编码,这样数学推导上就又可以采用矩阵融合的方式了,那么 也就继续可以用矩阵乘法融合从而减小运算律,

其实我觉得他就是位置信息单独计算了,而不是跟之前一样直接乘到Q K上面,

参考文献

DeepSeek-v2 MLA 原理讲解

相关推荐
智码看视界7 小时前
开源大模型追踪:Qwen3-VL-30B-A3B :30B 总参单卡到底能不能跑?
多模态·视觉语言模型·本地部署·vllm·moe·开源大模型·qwen3-vl
小易老师AI实战7 小时前
多模型融合实战:大模型+轻量小模型混合部署
vllm·大模型部署·模型路由·多模型融合·llm工程化·ai降本增效
chenxy029 小时前
提高大模型推理性能的思路
vllm
吴佳浩 Alben16 小时前
一文讲透推理引擎性能指标:TTFT、TPOT、KV命中率、并发,到底对应 vLLM / SGLang 的哪个参数?
人工智能·python·语言模型·架构·ai编程·vllm·sglang
Light Gao3 天前
从 LoRA 到 vLLM:大模型训练与企业部署名词通识(图解版)
vllm
数据与后端架构提升之路3 天前
四个模型,四条路:一份来自生产环境的 LLM 部署横评与选型框架
gpu算力·vllm·h100
缘友一世4 天前
GLM5.3 flash cybersec本地部署[5]:生产运维与故障恢复
ubuntu·vllm·glm5.3 flash
缘友一世5 天前
GLM5.3 flash cybersec本地部署[4]:基准测试与复现
vllm·glm5.3 flash
rjc_lihui6 天前
NCCL,Tokio ,vLLM ,Vue 3在线书籍
vllm
GPUStack6 天前
一张 A800 80GB,跑通 Qwen-Image-2.1:GPUStack 部署、生成与图像编辑实战
人工智能·开源·github·vllm·大模型部署·gpustack