多模态前沿:从Agent构建到视频AIGC

多模态

对于多模态来讲,他的提示词就不是单纯的文字。图像也是提示词

1,视觉和语言的打通

如何打通,能同时看懂视觉和文字

2,视觉识别和视觉推理

3,视觉生成

视觉推理 通过图片来进行推理。

融合推理 读懂图片读懂文字来进行推理。

二,视觉识别和视觉推理

这种模型没有什么应用层可以做的东西,不想大语言模型可以做rag,可以做agent。大部分只能在模型层标注数据,进行模型训练。进行数据标注

Yolo模型早期版本,v1 是吧图片分为7x7的49个方格。

视觉识别模型

传统的视觉识别,人脸

传统的视觉识别模型: Yolo UNet

Yolo 目标物体识别
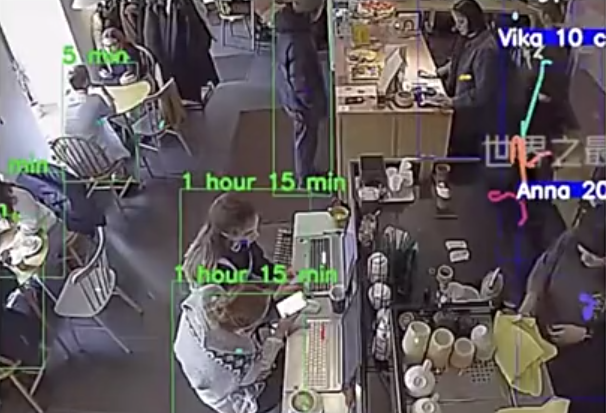
只能识别哪些是顾客,哪些是员工(这种识别即是视觉识别模型)。如果要计算员工做了几杯咖啡Yolo就做不到了,需要用到大语言模型,来截取帧,进行判断,加1

自动驾驶大多也用Yolo模型

YoLO模型知识识别你提前定义好的图像,如果增加识别的图像种类,需要重新进行大预言模型训练。类似于需求变更

标注工作大部分是由人来做的,也可以使用标注软件,

每个图像需要有不同的参数 x y w h c

x y 图中心坐标

wh 图的宽 高

c 自信度

w 概率

概率加起来要等于1
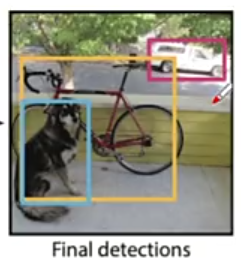
标注工程师,画出这三个图框,我虽然只是花了三个框,但是得到的标注数据是49组数据,但是只有三组数据是由意义的,其他46钟数据没有任何的意思。参数为0.

1

2

3

。。。。。。

49

UNet 区域的分割

比yolo有更高的精度,是像素级别的,会识别图像的大致形状,不想yolo只是画一个框,所以计算量会增加。所以,长用于人脑ct图像识别

使用方法是,在使用大预言模型的时候,在某一个方面使用yolo或者unet,而不是单纯的使用一种。

相关推荐
Sayai1 小时前
让动漫角色复刻真人动作!MiniMax H3 动作控制实战:一段视频驱动角色动画(12G 显存,附模型下载)
人工智能·aigc·音视频·comfyui·动作捕捉·minimax
Dawson Zhu2 小时前
【Runtime推理引擎④】多流并发执行:用Stream+Event让计算与通信重叠
人工智能·语言模型·架构·aigc·agi
AI创界者6 小时前
【AI生视频本地部署】最新 MiniMax-H3 全模态生成模型本地部署与极致优化:N卡 6G 显存流畅跑、无审查加速完整工作流实战
人工智能·aigc·音视频
rich_Chan.6 小时前
【2026 实操】bl vision describe 批量照片核验教程:六字段清单、视频时间轴、三个解析坑与兜底
人工智能·ai·aigc·音视频
柳杉8 小时前
用 Codex 魔改卡神开源的 AIHOT,我做了个 3D 技术雷达
前端·aigc
技灵AI8 小时前
AI 开箱视频怎么做?用创意开场带出商品展示
人工智能·prompt·aigc
小和尚同志16 小时前
54.6k star 的 Multica: 集多 Agent 和看板于一体的 AI 平台
人工智能·aigc·three.js
ServBay1 天前
AI 开发平台出事后,API Key 泄露要怎么办
后端·aigc·ai编程
rich_Chan.1 天前
【2026 实操】bl video edit 教程:已拍素材改风格换颜色全流程,含输出规格、角标自查
人工智能·ai·云计算·aigc
文谦南宁AI普工1 天前
拆解 DeepSeek dsh-superagent:用 60 行代码模拟它的授权门控与 observe 模式
aigc·agent·ai编程