官方文档:https://nightlies.apache.org/flink/flink-docs-stable/docs/ops/debugging/flame_graphs/
示例:
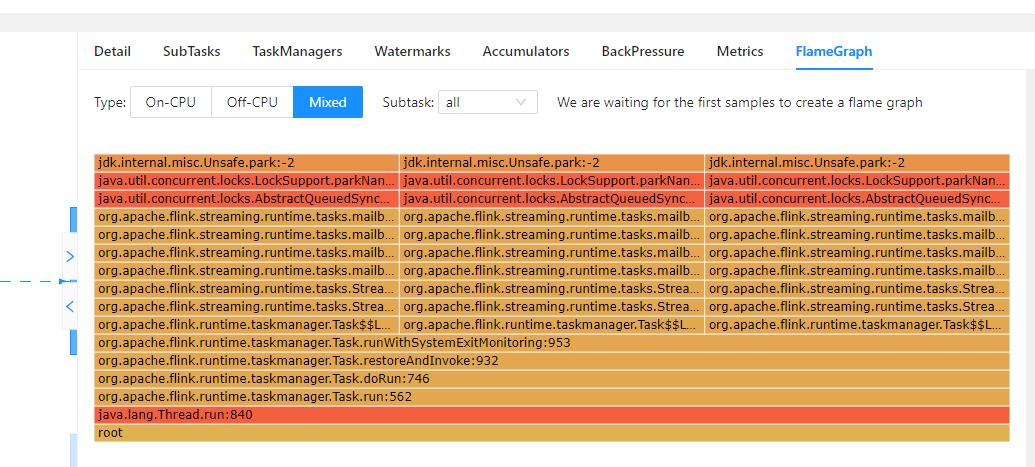
怎么看:
从下往上看。一个方块一般表示的是调用栈中的一个栈帧。
1)先看类型
- On-CPU:谁在耗 CPU
- Off-CPU:谁在等待/阻塞
- Mixed:总时间(算+等)
排查性能问题通常:先 Mixed 全局看,再 On/Off 分开确认。
2)读图基本规则
- 每个方块 = 一个函数栈帧
- 从下到上 = 调用关系(下是调用者,上是被调用)
- 宽度 = 时间占比(最重要)
- 左右位置通常无业务意义(只是排版)
3)先抓"最宽顶部平台"
先找最宽的一段,再一路往下看"它是谁调用来的",往上看"它具体做了什么"。
不要被单个高框迷惑,宽度才是瓶颈权重。
4)在 Flink 里怎么判断
判断是业务问题还是框架问题
1️⃣ 如果是你自己的类
例如:
com.xxx.OrderProcessFunction那说明:
✔ 业务逻辑复杂
✔ 可能有死循环
✔ 有同步阻塞
👉 优化方向:算法 or 缓存
2️⃣ 如果是 Flink Runtime 宽
例如:
org.apache.flink.streaming.runtime.tasks.StreamTask说明:
✔ checkpoint 压力
✔ 反压
✔ watermark 对齐
✔ 网络堆积
3️⃣ 如果是 RocksDB 宽
例如:
org.rocksdb.RocksDB.get说明:
✔ 状态访问频繁
✔ 状态太大
✔ compaction 频繁
👉 优化:
-
增大 write buffer
-
调整 state TTL
-
减少 key 数
-
用 Heap State 看效果
4️⃣ 如果是 GC 宽
例如:
G1YoungCollection说明:
✔ 对象创建太频繁
✔ 序列化对象多
✔ JSON 解析频繁
👉 优化:
-
复用对象
-
用 Kryo 优化
-
减少 new
Flink 火焰图典型场景分析
🎯 场景1:CPU 100%
看是不是:
-
map/flatMap 太重
-
JSON 解析
-
加密解密
-
正则表达式
🎯 场景2:吞吐上不去
火焰图如果显示:
MailboxProcessor.run
通常是:
-
反压
-
下游慢
🎯 场景3:延迟高
如果大量时间在:
StreamTask.invoke
说明:
-
checkpoint 对齐
-
watermark 等待
反压场景下火焰图怎么读?
🔥 情况一:看到大量 park / mailbox
典型栈:
LockSupport.park
MailboxProcessor.run
StreamTask.run
说明:
✔ 线程在等 buffer
✔ 网络反压
✔ 下游没处理完
这时火焰图告诉你:
这层不是根因,继续往下游找。
🔥 情况二:某个业务函数特别宽
例如:
com.xxx.MyProcessFunction.processElement那说明:
✔ 真正瓶颈是业务逻辑
✔ CPU算不过来
常见原因:
-
JSON 解析
-
正则
-
加解密
-
远程 RPC
-
大对象创建
👉 优化代码或加并行度。
🔥 情况三:RocksDB 很宽
例如:
org.rocksdb.RocksDB.get
RocksDB.put
说明:
✔ 状态访问太频繁
✔ key 太多
✔ compaction 压力大
解决方向:
-
减少状态访问次数
-
合并状态
-
调大 write buffer
-
提升并行度
🔥 情况四:Checkpoint 很宽
看到:
AsyncCheckpointRunnable
snapshotState
RocksDB.flush
说明:
✔ checkpoint 卡住
✔ 状态太大
✔ IO 慢
这类反压通常是:
周期性抖动
🔥 情况五:Sink 特别宽
例如:
KafkaProducer.send
ElasticsearchBulkProcessor
HTTP client
说明:
✔ 外部系统写入慢
✔ 下游存储瓶颈
这类是最常见的真实反压源头。
三种模式:
- On-CPU(在 CPU 上)
表示线程真正占用 CPU 执行代码的时间。
- 看的是"谁在烧 CPU"
- 适合定位:计算热点、序列化开销、GC CPU 消耗、热点函数优化
- 宽度越大,说明该调用栈消耗 CPU 越多
2) Off-CPU(不在 CPU 上)
表示线程没有在 CPU 上运行,而是在等待/阻塞。
常见原因:
-
锁竞争(
park,monitor enter) -
I/O 等待(磁盘/网络)
-
条件变量等待、sleep、epoll wait
-
下游慢导致阻塞(流处理里常见)
-
看的是"为什么慢但 CPU 不高"
-
适合定位:卡顿、延迟高、吞吐低但 CPU 利用率不高的问题
3) Mixed(混合)
把 On-CPU + Off-CPU 合在一起看(接近 wall-clock 总体视角)。
- 既能看到"在算什么",也能看到"在等什么"
- 适合先全局排查瓶颈,再切到 on/off 细看
在 Flink 场景怎么用(实战建议)
- CPU 很高 :先看 On-CPU
- 任务慢但 CPU 不高 :看 Off-CPU
- 不确定瓶颈在哪 :先看 Mixed 再分解
一句话总结:
On-CPU = 算得慢;Off-CPU = 等得久;Mixed = 算+等的总账。