通过flux-dsl构建flux查询语句的详细教程可参考 flux-dsl
一、函数属性赋值方式
flux中的每一个,以window函数为例,该函数具有两个属性:
java
window(every: 1m, period: 10s)
//every   窗口创建频率
//period  窗口长度
1、使用内置构造方法
java
Flux flux = Flux
    .from("telegraf")
    .window(15L, ChronoUnit.MINUTES, 20L, ChronoUnit.SECONDS)
.sum();window构造方法为:window(every, everyUnit, period, periodUnit)
2、使用内置属性方法(推荐)
java
Flux.from("telegraf")
    .window()
        .withEvery(15L, ChronoUnit.MINUTES)
        .withPeriod(20L, ChronoUnit.SECONDS)
    .sum();
3、使用通用 property 方法
java
Flux.from("telegraf")
    .window()
        .withPropertyValue("every", 15L, ChronoUnit.MINUTES)
        .withPropertyValue("period", 20L, ChronoUnit.SECONDS)
    .sum();
这种方法较为灵活,但缺点是属性名称出错会导致无法查询。
二、Flux支持的函数
1、form
from是所有查询的起点,定义从哪个存储桶中获取数据。
ini
Flux flux = Flux.from("telegraf");但是只有from函数无法获得数据,需要与其他函数配合使用
2、range
range() 用来指定查询的时间边界,只返回指定时间范围内的数据。其中包含两个参数:
- start 查询开始时间(必须)
- stop 查询结束时间(可选,默认为当前时间)
使用方法如下:
java
// by interval
Flux flux = Flux
    .from("test")
    .range(-12L, -1L, ChronoUnit.HOURS) //查询12小时前到1小时前的数据
使用instant
java
// by Instant
Flux flux = Flux
    .from("test")
    .range(Instant.now().minus(4, ChronoUnit.HOURS),
           Instant.now().minus(15, ChronoUnit.MINUTES)
    );
3、filter
用于筛选记录的函数。该函数必须接受一个参数,即待筛选的记录,并返回一个布尔值。返回值为 true 的记录将被包含在结果中。该方法支持对_measurement、tag、_field等字段筛选:
less
Flux flux = Flux
        .from("test")
        .filter(Restrictions.and(Restrictions.measurement().equal("mem"),
                Restrictions.tag("service").equal("app-server"),
                Restrictions.field().equal("usage_system")))
        .range(-4L, ChronoUnit.HOURS);
4、drop
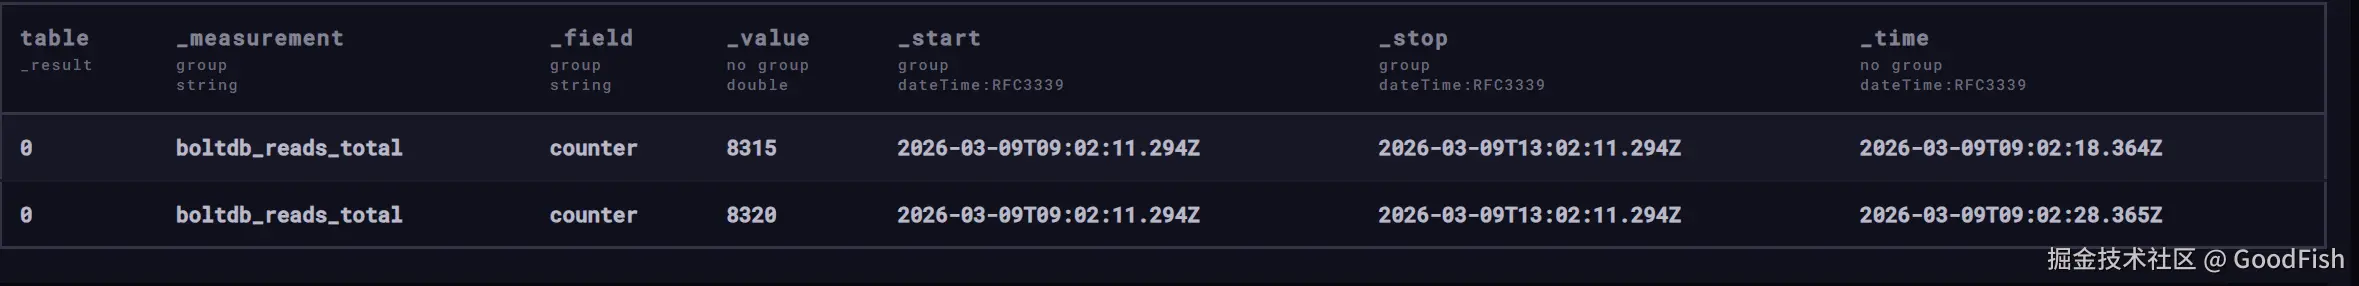
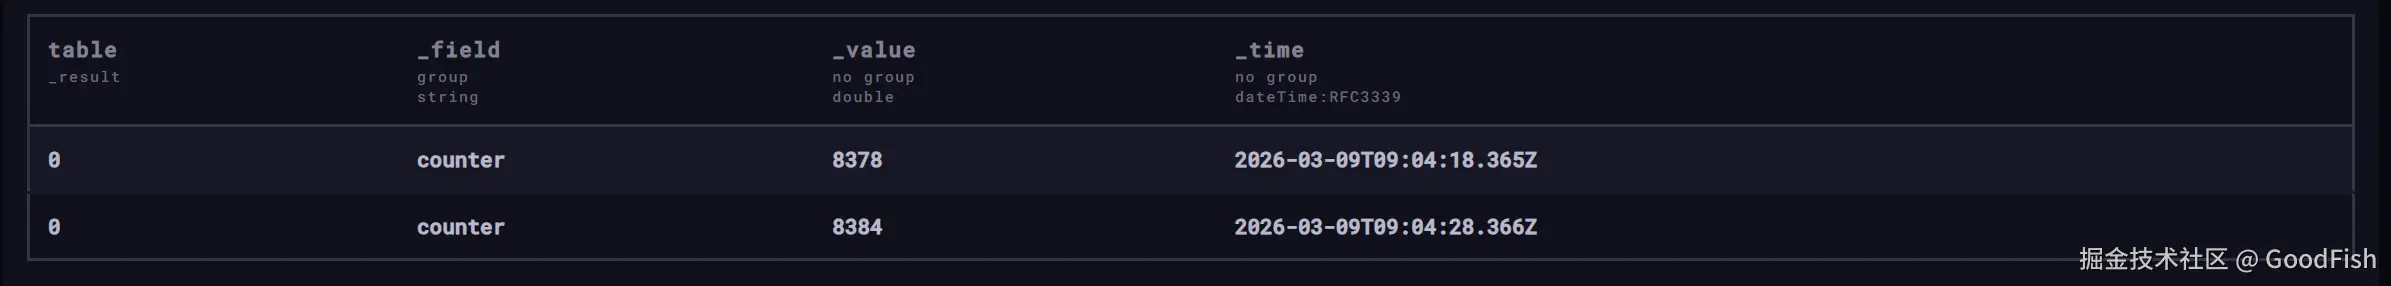
删除操作会将指定的列从表中排除(只会在显示结果中删除某一列,实际数据不会改变):
java
Flux flux = Flux
    .from("test")
    .drop(new String[]{"_start","_stop", "_measurement"});  // 删除_start列、_stop列和_measurement列
使用后效果如下:
- 使用前:
- 使用后:
5、keep
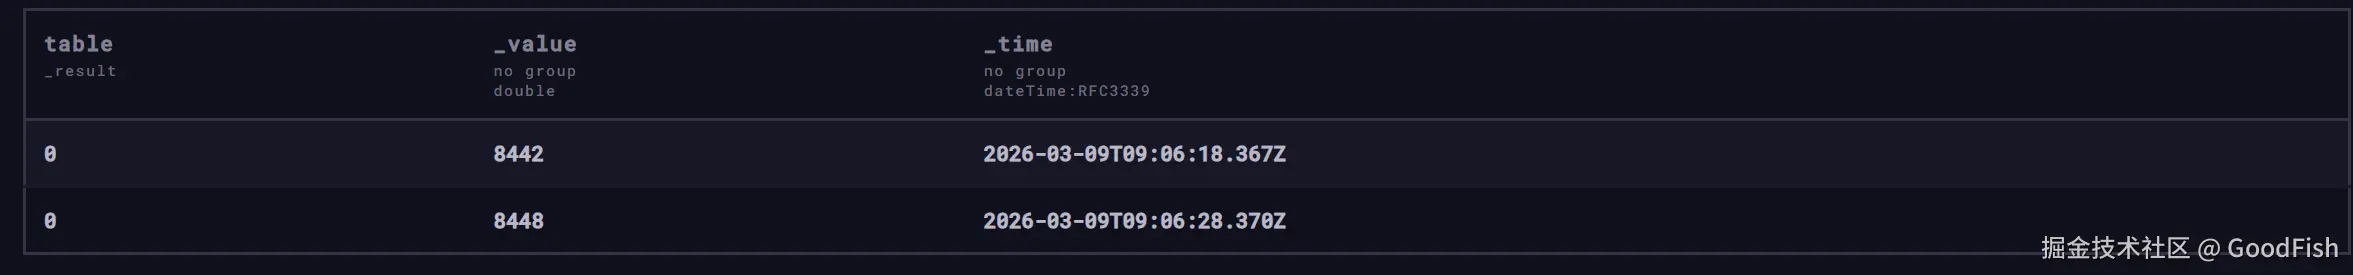
Keep 是 drop 的逆操作。它将返回一个仅包含指定列的表,忽略所有其他列。
java
Flux flux = Flux
    .from("telegraf")
.keep(new String[]{"_time", "_value"}); // 只保留_time和_value- 使用前:
- 使用后:
6、limit
限制结果中返回的行数:
java
Flux flux = Flux
    .from("telegraf")
.limit(100, 10); //n, offsetn: 要输出的最大记录数。offset: 要跳过的记录数。默认值为 0。
7、sort
按指定的列对结果进行排序:
arduino
Flux flux = Flux
    .from("test")
    .sort(new String[]{"_value", "_time"}, true) // columns, desc
//此处为根据_value列和_time列排序,降序排序columns: 用于排序的列列表。优先级从左到右。默认值为空"value"desc: 按降序排列结果。默认为 false(布尔值)
8、聚合函数
- sum() 求和
- mean() 平均
- max() 最大
- min() 最小
- count() 计数
java
Flux flux = Flux
    .from("test")
.sum("_value");column: 用于计算的列
9、window 和 aggregateWindow
aggregateWindow用于将聚合函数或选择器函数(任何带有列参数的函数)应用于固定的时间窗口:
csharp
Flux flux = Flux
    .from("telegraf")
        .aggregateWindow()
            .withEvery("10s")
            .withAggregateFunction("sum")
.withColumn("_value")aggregateWindow查询和window查询的最大区别就是:
aggregateWindow不会分表, 每个时间窗口的结果汇总为一张表, 并且结果必须被聚合函数处理window会将不同的时间窗口分为不同的表, 且只用于汇总, 该函数不会进行聚合处理
window使用方法如下:
sql
Flux flux = Flux
    .from("telegraf")
    .window(15L, ChronoUnit.MINUTES,
            20L, ChronoUnit.SECONDS)
.max();every- 窗口之间的间隔时间。默认为period的值。period- 窗口分区持续时间。