数据倾斜,简而言之,就是在数据处理过程中,数据分布的不均匀性导致大量数据集中于少数机器上进行计算,从而使得这些数据的处理速度明显慢于平均水平,进而影响了整个计算过程的效率。**数据倾斜指数据不均匀导致少数机器负载过重,使处理速度变慢。**数据倾斜问题在数据开发的各个环节中都可能出现,例如,在使用Hive进行数据处理时,reduce阶段可能会长时间停滞在99.99%;或者在使用SparkStreaming进行实时算法处理时,可能会频繁出现executor的内存溢出错误,而其他executor的内存使用率却相对较低。值得注意的是,数据倾斜问题往往与大规模的数据量有关,可能达到千亿级以上。
▲ 数据倾斜的表现
在Hadoop环境下,数据倾斜主要展现在MapReduce程序的reduce阶段,经常出现卡在99.99%无法完成的情况。深入查看日志或监控界面,我们会发现:
-
多个reduce任务陷入停滞
-
各类container频繁报错OOM(内存溢出)
-
涉及的数据读写量异常庞大,远超其他正常运行的reduce任务
同时,数据倾斜还会引发一系列不可预知的问题,如任务被意外终止等。值得注意的是,Hive中的数据倾斜问题通常与Sql语句中的Group和On操作紧密相关,且与数据逻辑深度绑定。
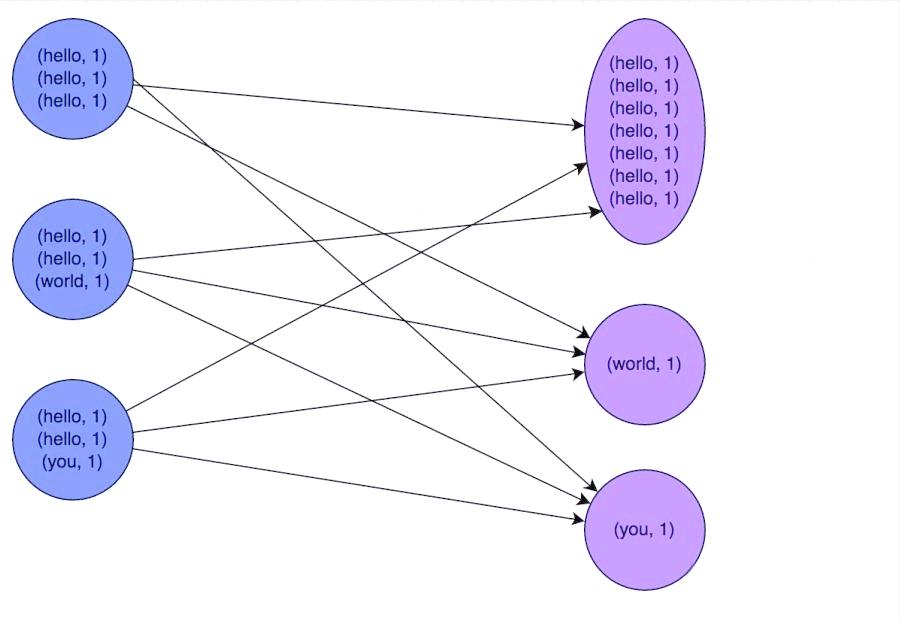
▲ 数据倾斜的原因
在Spark和Hive等大数据处理框架中,进行数据运算时常常会涉及到countdistinct、group by、join等操作。**数据倾斜由shuflle操作引起的键值不均摊导致。**这些操作会触发Shuffle动作,导致所有相同key的值被拉取并聚集到少数几个节点上。这种数据分布的不均衡性,很容易引发单点问题,从而造成数据倾斜。
02数据倾斜在计算平台中的表现
▲ Hadoop中的数据倾斜现象
在Hadoop环境下,**在MapReduce中,reduce阶段常因数据读写量过大而停滞。**数据倾斜主要展现在MapReduce程序的reduce阶段,经常出现卡在99.99%无法完成的情况。深入查看日志或监控界面,我们会发现多个reduce任务陷入停滞,各类container频繁报错OOM(内存溢出),涉及的数据读写量异常庞大,远超其他正常运行的reduce任务。
▲ Spark中的数据倾斜
在Spark环境下,数据倾斜同样是一个不容忽视的问题。无论是Spark Streaming还是Spark Sql,都有可能出现数据倾斜的情况。**Spark中,Executor内存溢出和shuffle错误是常见问题。**其主要表现包括:Executor丢失或OOM(内存溢出),Shuffle过程中出现错误,Driver端OOM,单个Executor执行时间异常长,导致整体任务无法结束,正常运行的任务突然失败。
03数据倾斜的解决方案
▲ 解决思路
解决数据倾斜的问题,**可通过业务逻辑优化、程序调整、参数调节应对数据倾斜。**我们可以从以下几个方面入手:
-
业务逻辑层面优化:通过调整业务逻辑来改善数据倾斜。例如,在上述场景中,我们可以单独对特定城市进行count操作,然后再与其他城市的数据进行整合。
-
程序层面调整:在编程层面,我们可以利用一些技巧来避免数据倾斜。例如,在Hive中执行count(distinct)操作时,由于可能只有一个reduce任务,我们可以先进行group操作,再在外面包裹一层count,从而分散数据倾斜的问题。
-
参数调节:Hadoop和Spark提供了丰富的参数和机制来应对数据倾斜。通过合理配置这些参数,我们往往能够有效地解决大部分数据倾斜问题。
▲ 从业务角度解决
许多数据倾斜问题源于业务场景的数据分布不均。**数据倾斜源于业务场景的数据分布不均。**针对不同场景,我们可以采取以下策略:
-
数据分布不均匀的处理:对于数据分布不均匀的情况,我们可以尝试从设计和业务角度出发进行解决,例如,通过过滤异常数据或对分布不均匀的数据进行单独计算来平衡数据分布。
-
有损与无损的方法:在处理数据倾斜时,我们通常有两种方法可选------有损和无损。有损方法涉及找到并过滤掉异常数据;而无损方法则是对分布不均匀的数据进行单独计算。
▲ Hadoop平台的优化策略
在Hadoop平台上,**调整参数和作业逻辑能有效缓解数据倾斜。**我们可以通过以下方法和思路来进一步优化数据倾斜问题:
-
合理配置参数:通过合理配置Hadoop提供的丰富参数选项,我们可以更好地应对数据倾斜挑战。
-
调整作业逻辑:在作业执行过程中,我们可以根据数据倾斜的情况,灵活调整作业逻辑,例如,通过增加中间计算步骤或改变数据处理的顺序。
-
利用Hadoop生态系统工具:如Hive、Pig等,提供了强大的数据处理和分析能力,我们可以充分利用这些工具更有效地处理和解决数据倾斜问题。
需要注意的是,具体的优化方法和参数选择,需要结合实际的数据倾斜情况和Hadoop平台的特性来进行,建议参考Hadoop官方文档和社区资源。
▲ Spark平台的优化策略
接下来,我们探讨Spark平台的优化方法。**采用mapjoin、RDD压缩等因素可优化Spark平台性能。**这些方法和思路同样适用于其他平台:
-
采用mapjoin技术。
-
对RDD进行压缩设置。
-
合理配置driver的内存资源。
-
Spark Sql的优化策略与Hive相似,可参考Hive的实践。
数据倾斜问题颇具挑战性,其处理需要长期探索。愿本文所提供的思路能助您一臂之力。文中未深入探讨的内容,如Hive Sql的精细优化及数据清洗中的诸多细节,我们将在后续分享中逐一剖析。此外,面对千亿级别的数据量,挑战远不止数据倾斜,更多难点有待我们共同攻克。