llama.cpp 更新太快,当前下载 llama.cpp-b7907.tar.gz 进行学习。编译环境选择在windows 11下,采用mingw.环境如下:
| 软件 | 版本 | 说明 |
|---|---|---|
| windows | win11 | 操作系统 |
| llama.cpp | b7907 | llama.cpp |
| mingw64 | 15.2 | 支持c++23 |
编译过程:
解压llama.cpp,在解压文件中创建一个build目录,进入build目录执行cmake命令,进行配置,接着执行make命令进行编译,之后进行make install 进行安装。整个过程我整合成一个bat文件,双击即可执行对应流程。
bat
echo Compile llama.cpp
set path=D:\tool_lite\mingw64_152\bin;%path%

cd llama.cpp-b7907
mkdir build
cd build

cmake -G "MinGW Makefiles" ^
 -DCMAKE_C_COMPILER=gcc ^
 -DCMAKE_CXX_COMPILER=g++ ^
 -DCMAKE_INSTALL_PREFIX=E:\workspace\llama\llama.cpp_install ^
 ..


mingw32-make install

@REM VERBOSE=ON

cmd
编译后自动安装到指定目录,如下图
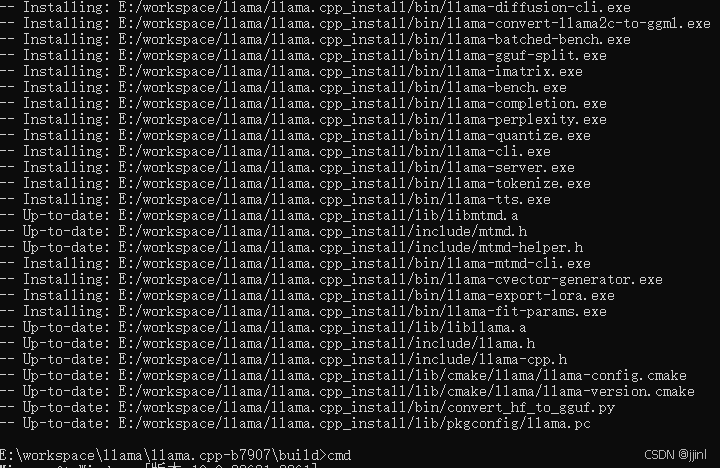
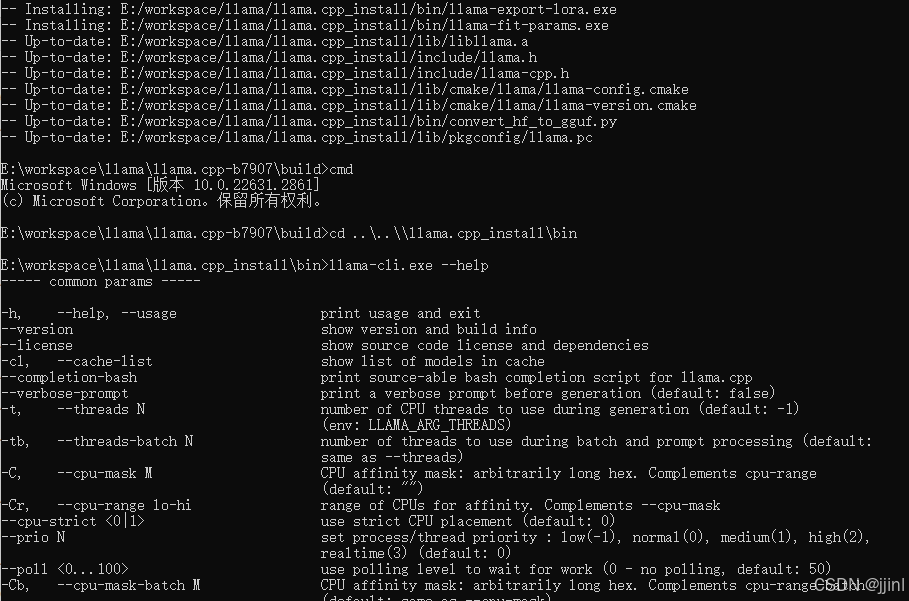
运行测试,未报错
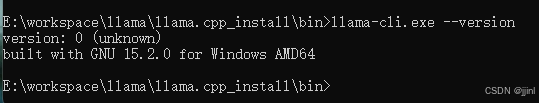
打印版本,版本为0
模型测试,我下载一个模型名字: unsloth_Llama-3.2-3B-Instruct-GGUF_Llama-3.2-3B-Instruct-Q4_K_M.gguf
大小1.87GB 进行测试,参照网上建议,编写一个简单bat脚本启动测试,脚本内容如下:
bat
set path=D:\tool_lite\mingw64_152\bin;E:\workspace\llama\llama.cpp_install\bin;%path%

set model=unsloth_Llama-3.2-3B-Instruct-GGUF_Llama-3.2-3B-Instruct-Q4_K_M.gguf

llama-cli.exe -m %model% ^
 -n -1 ^
 --color on ^
 -r "User"

cmd
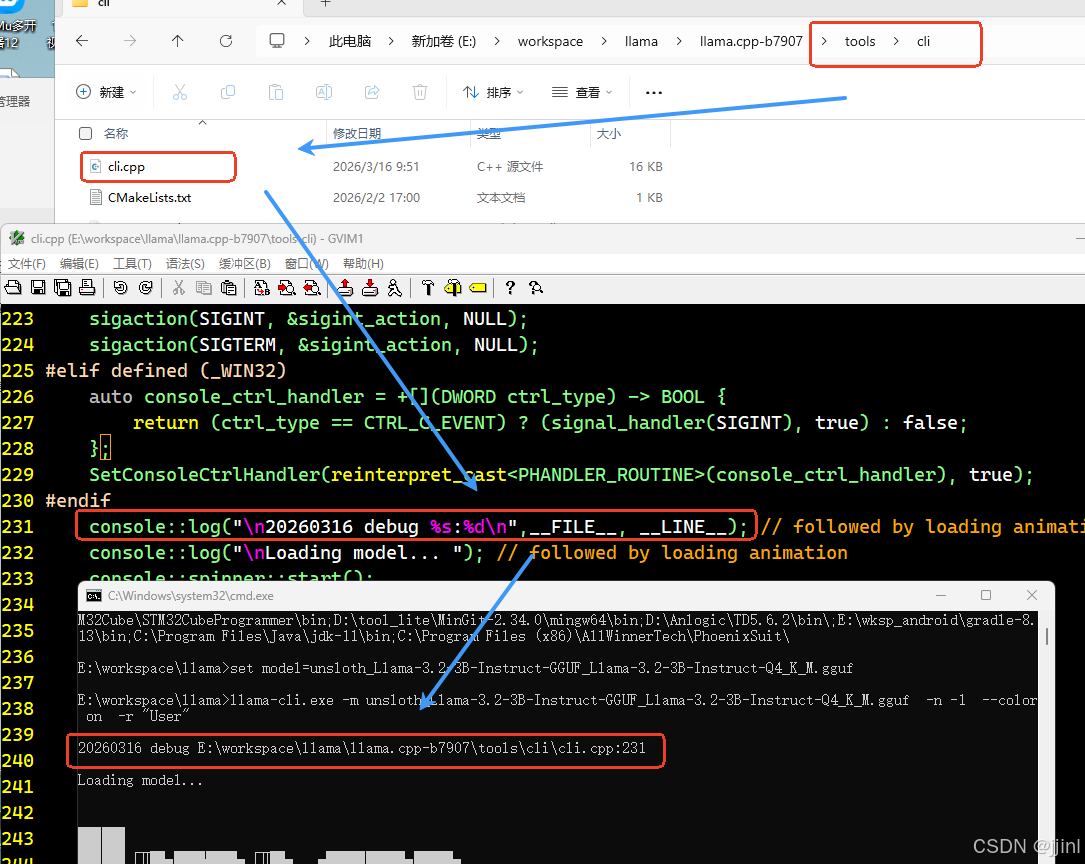
运行效果如下,我在源码目录下tools/cli.cpp 231行添加打印:
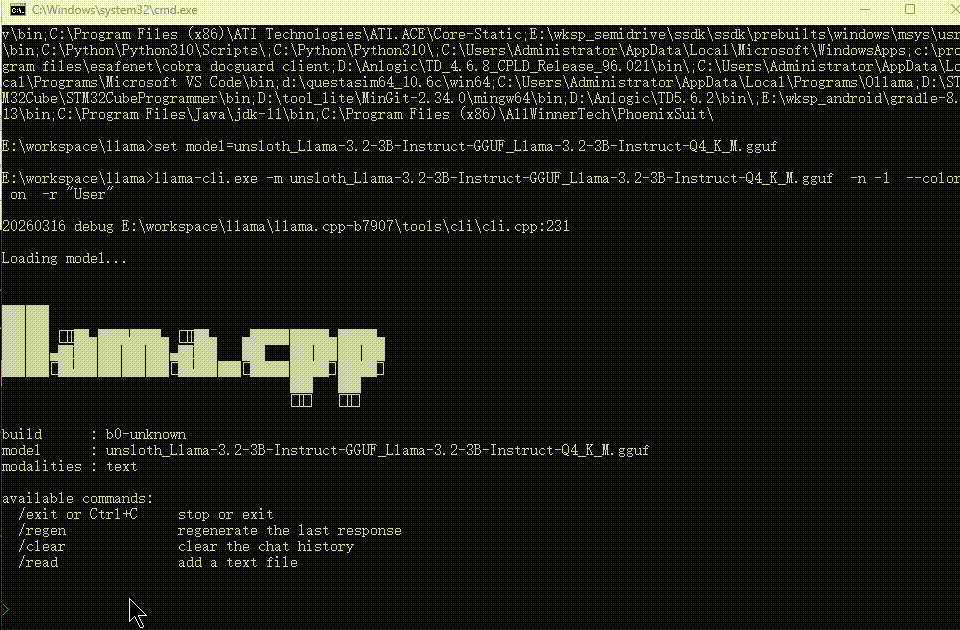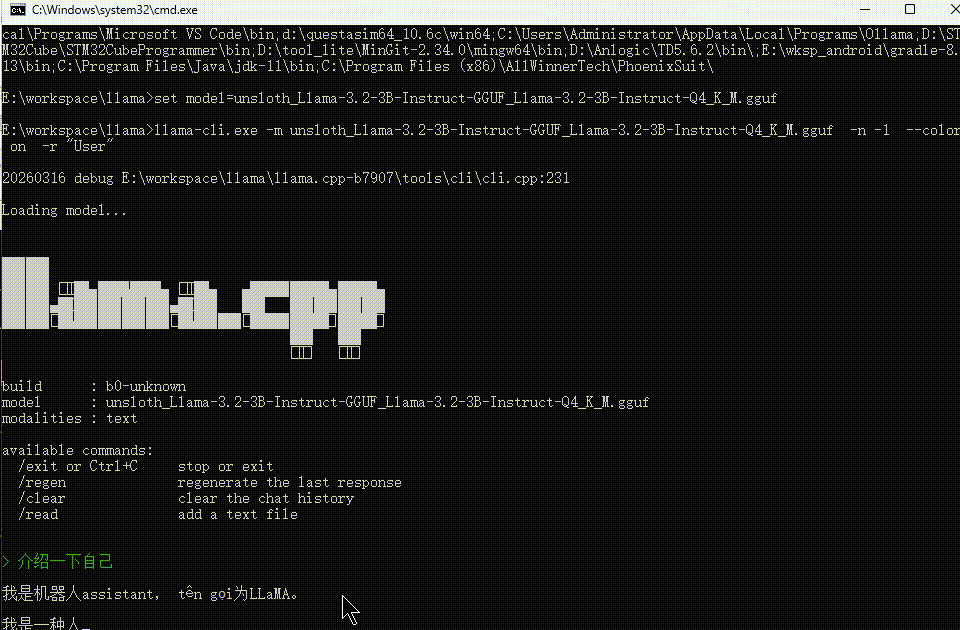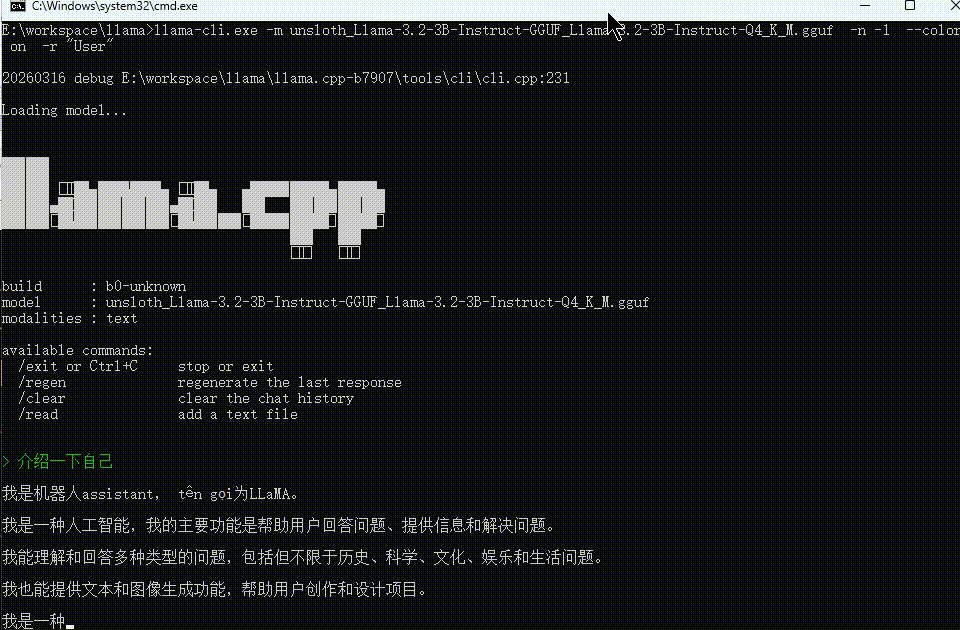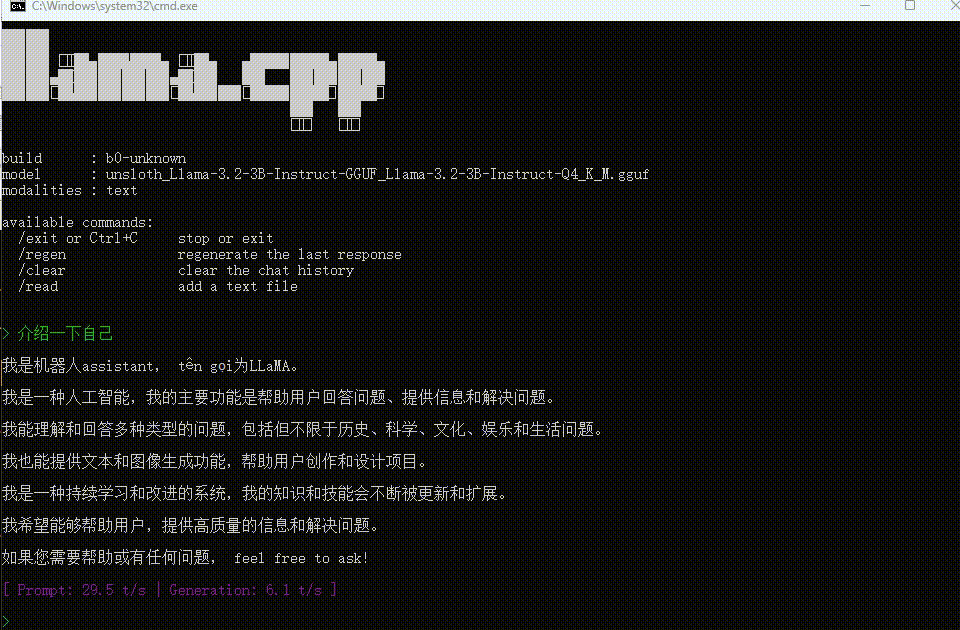
测试交互如下:
这一节到这里结束