一、安装服务器
1、系统:Ubuntu 22.04.5
2、驱动:英伟达cuda 12.4
3、容器:docker ce26.x:
4、nvidia-container-toolkit:
| 操作 | 命令 |
|---|---|
| 查是否安装 | `dpkg -l |
| 查版本 | nvidia-container-cli --version |
| 端到端测试 | docker run --rm --gpus all nvidia/cuda:12.4-base-ubuntu22.04 nvidia-smi |
| 检查 Docker 配置 | cat /etc/docker/daemon.json |
5、链接国外的docke镜像:register Mirrors
bash
vim /etc/docker/daemon.json
bash
{
    "registry-mirrors": [
            "https://docker.211678.top",
            "https://docker.1panel.live",
            "https://hub.rat.dev",
            "https://docker.m.daocloud.io",
            "https://do.nark.eu.org",
            "https://dockerpull.com",
            "https://dockerproxy.cn",
            "https://docker.awsl9527.cn"
      ]
}
创建 docker 组(如果不存在)并添加用户:
bash
sudo usermod -aG docker $USER激活组权限:
你需要注销并重新登录,或者运行以下命令让更改立即生效(无需重启电脑)
bash
newgrp docker二、下面安装:VLLM:
bash
docker pull vllm/vllm-openai:latest可以参考:https://github.com/vllm-project/vllm
bash
 mkdir -p /home/hynx/models/Qwen2.5-7B-Instruct

hynx@hynx:~$ cd /home/hynx/models/Qwen2.5-7B-Instruct


hynx@hynx:~$ python3 -c "from modelscope import snapshot_download; snapshot_download('Qwen/Qwen2.5-7B-Instruct', local_dir='.')"


docker run -d --name vllm_qwen --runtime nvidia --gpus all -p 8089:8089 -v /home/hynx/models/Qwen2.5-7B-Instruct:/app/model vllm/vllm-openai:latest --model /app/model --host 0.0.0.0 --port 8089 --dtype auto --max-model-len 4096- qwen3.5的合适大模型9B,
创建一个清晰明确的目录
mkdir -p /home/hynx/models/Qwen3.5-9B
进入该目录
cd /home/hynx/models/Qwen3.5-9B
下载模型
python3 -c "from modelscope import snapshot_download; snapshot_download('Qwen/Qwen3.5-9B', local_dir='.')"
#利用docker 运行大模型
hynx@hynx:~$ docker run -d --name vllm_qwen3.59 --runtime nvidia --gpus all -p 8089:8089 -v /home/hynx/models/Qwen3.5-9B:/app/model vllm/vllm-openai:latest --model /app/model --host 0.0.0.0 --port 8089 --dtype auto --max-model-len 4096
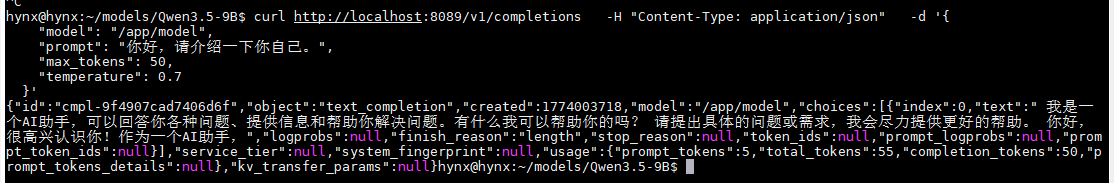
验证大模型效果
curl http://localhost:8089/v1/completions \ -H "Content-Type: application/json" \ -d '{ "model": "/app/model", "prompt": "Hello, how are you?", "max_tokens": 20 }'
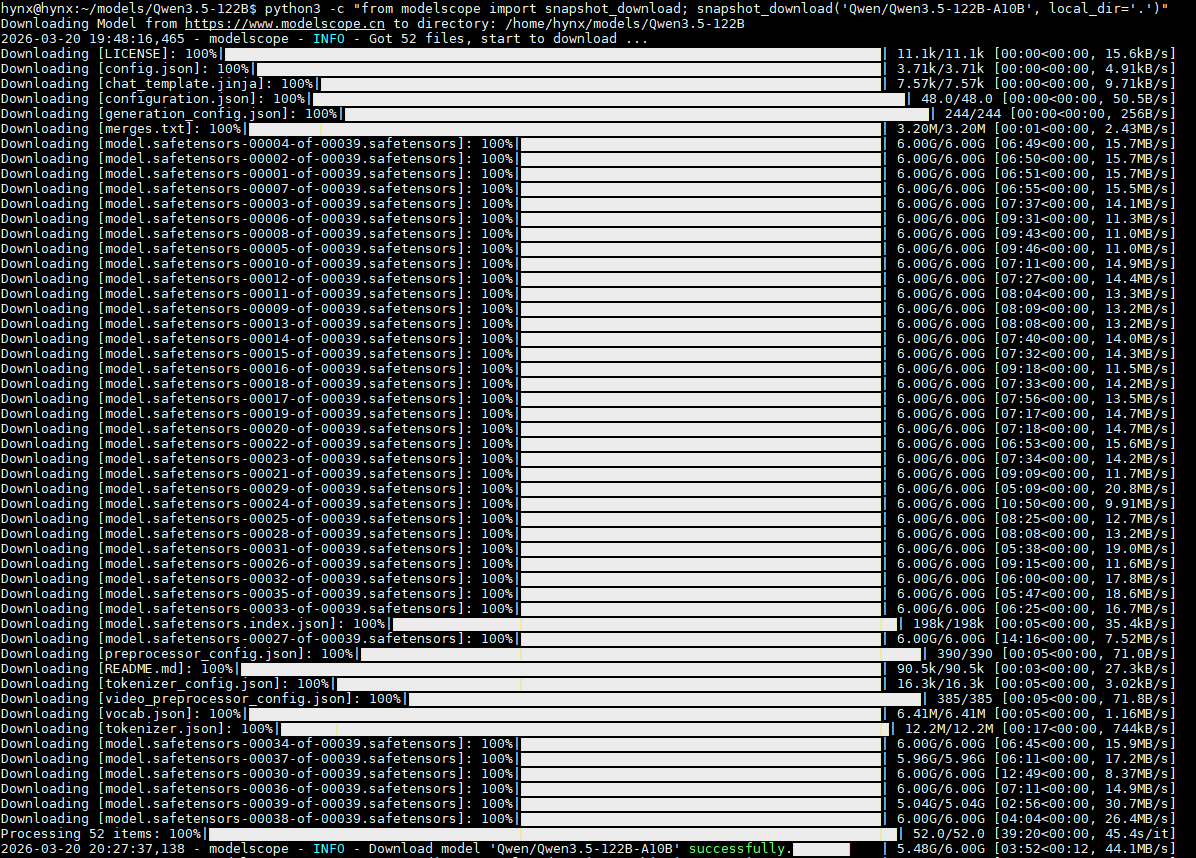
2.qwen3.5:122B
3.qwen3:8B embedding
-
qwen3: 8B rerank
-
minerU 模型
三、