向量数据库
它是专门把文本、图像、音频等非结构化数据转成高维向量后,再进行"语义级"存储、检索与管理的专用数据库。
以「向量」为第一等公民的数据库系统,支持相似度计算(余弦、点积、欧氏距离)和高维索引(HNSW、IVF、PQ )等。
索引结构
HNSW(分层可导航小世界)
把所有向量构建成一个"多层图",搜索时像"导航一样跳来跳去"
其中,每个向量是一个节点,节点之间连"相似边",此图中上层是稀疏图(快速定位),下层是密集图(精细搜索)
搜索流程:从最高层开始,每次走到"更相似的点";一层一层往下,最后找到最近邻。
优点:查询速度快,精度高,工业界常用
缺点:内存占用大,构建索引慢
IVF(倒排索引)
先把数据"分桶",只在相关桶里查。
类似于聚类的流程:
1、用k-means把向量分成N个簇。
2、每个簇就是一个"桶"。
3、查询时,找最近的几个簇,只在这些簇里搜索。
优点:比暴力搜索快,可扩展性强。
缺点:可能漏掉最近邻,精度略低于HNSW
PQ(乘积量化)
核心思想:把向量"压缩编码",用查表代替距离计算。当需要查询时,预先算好距离表,直接查表(速度快)
优点:极大节省内存;适合超大规模(亿级)
缺点:有精度损失,需要训练codebook
Disk ANN(基于磁盘的神经网络)
核心思想:把索引放在磁盘上,同时还能做到接近内存及速度。
相较于HNSW,DISKANN部分在内存,大部分在磁盘。
优点:支持超大规模(10亿+),内存占用极低,性能接近HNSW。
缺点:实现复杂,强依赖磁盘性能(SSD)
常见组合
1、IVF+PQ(最经典):先分桶,再压缩
2、HNSW+PQ:图结构+压缩
3、DiskANN:HNSW+磁盘优化
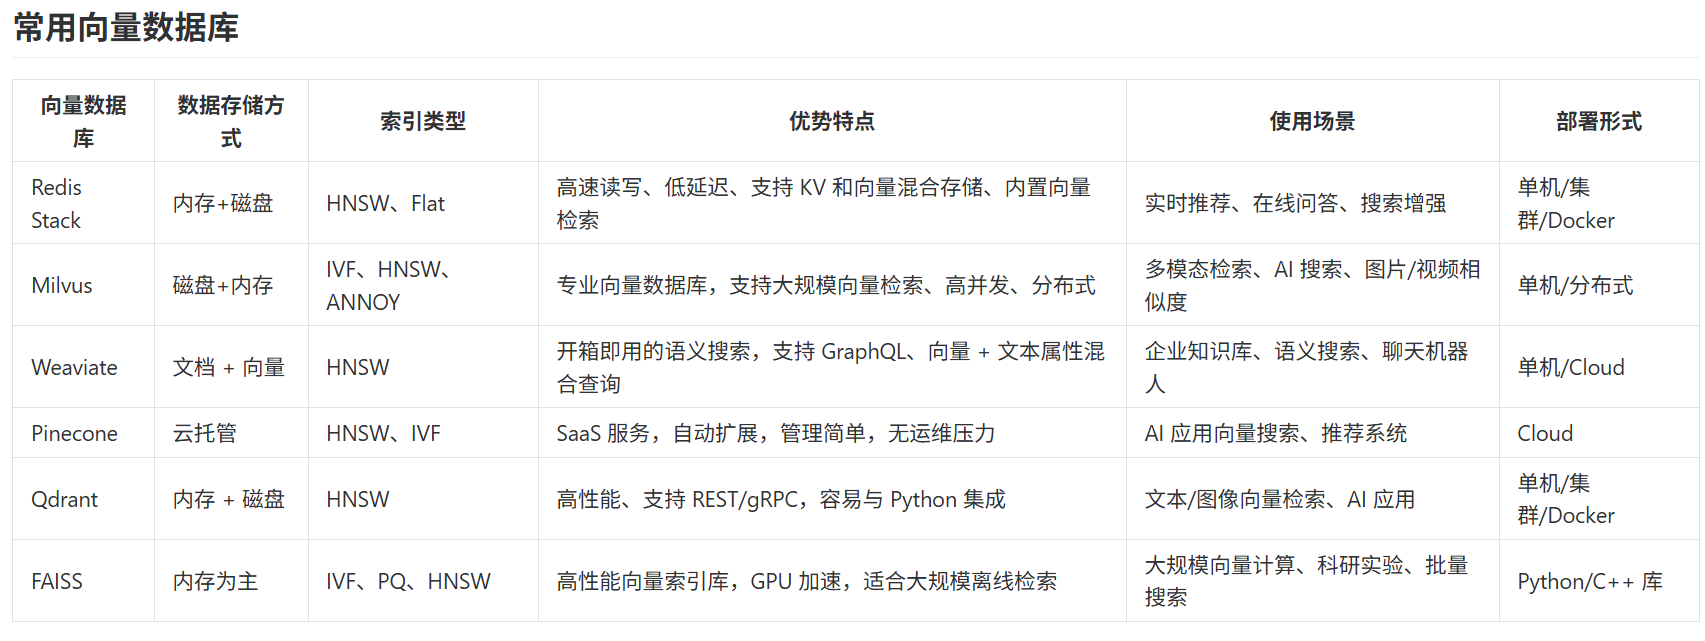
向量检索
核心概念:给定一个「查询向量」,在庞大的向量集合里毫秒级找出与其最相似的 Top-K 个向量,并返回对应原始对象(文本、图片、商品等)的过程。
应用场景 :
1、RAG:把用户问题向量与知识库向量匹配,召回最相关段落。
2、推荐:用用户行为找相似商品/视频
3、以图搜图,异常检测等。