机器学习-多模态大模型(MLLM)

链接:【机器学习大模型-多模态】原理及实操串讲,最好的多模态大模型教程来了,1小时讲透多模态大模型,看完全面理解!机器学习-计算机视觉-人工智能_哔哩哔哩_bilibili

1、clip
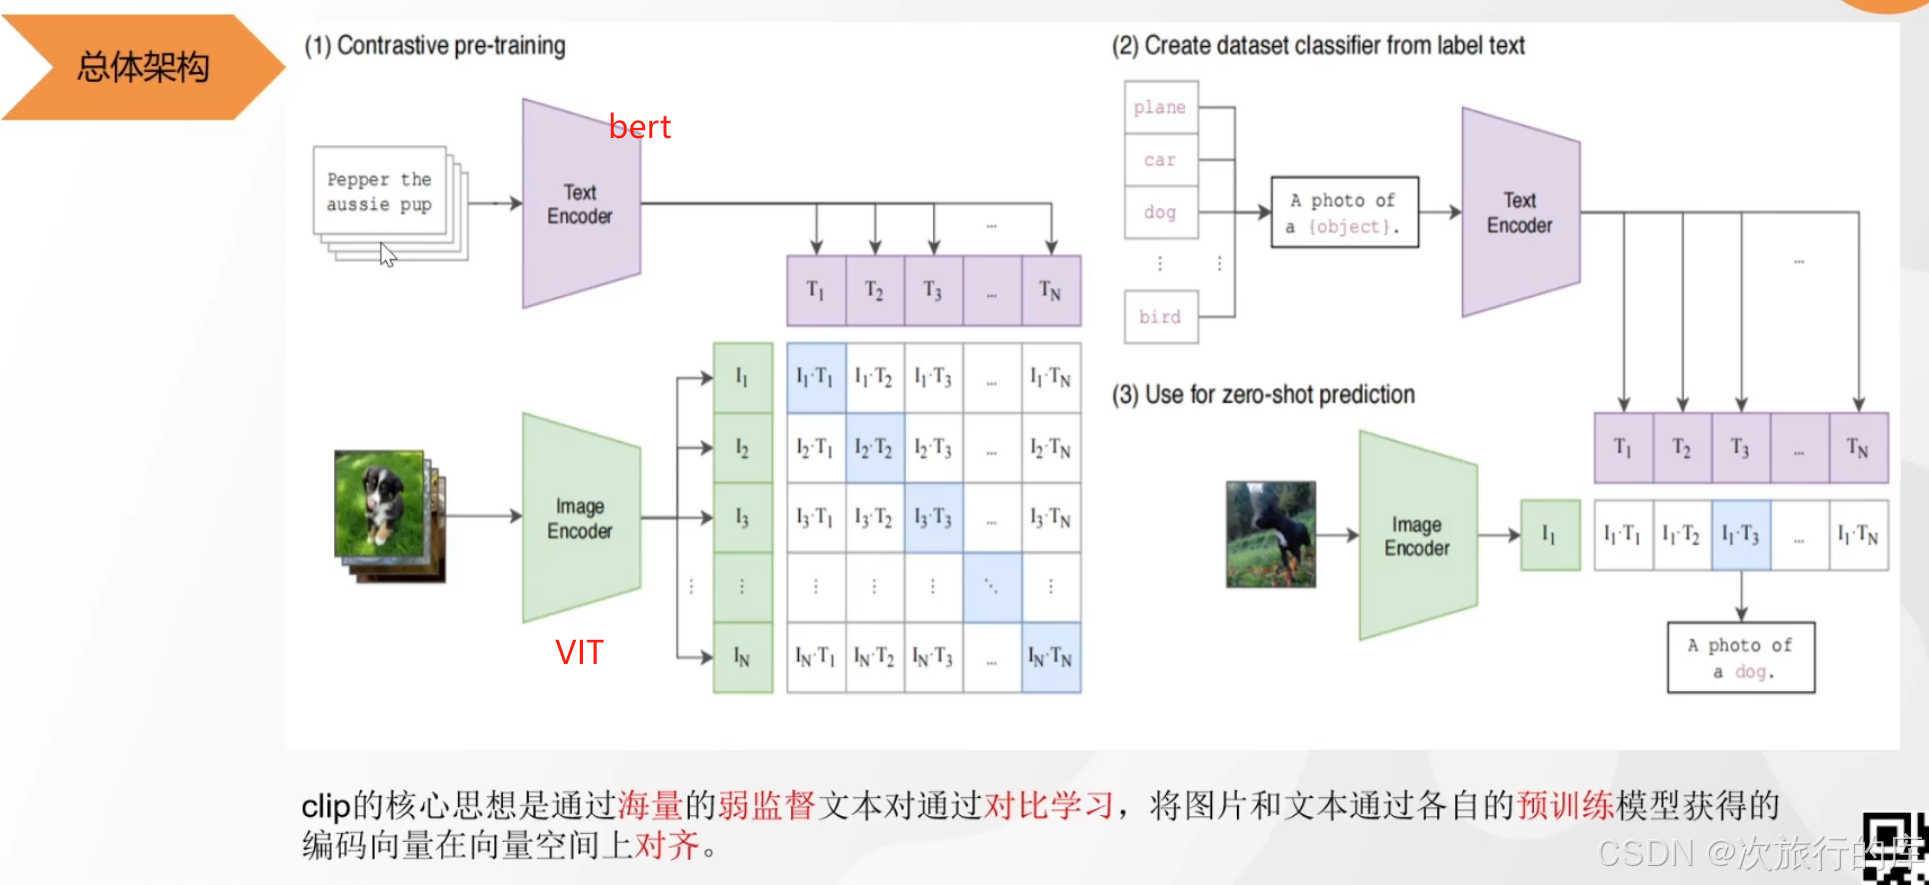
1、原始数据网页爬取来的,有噪声,没有进行处理,是弱对齐

2、只有对角线是对齐的,是正样本,其余为负样本。

2、blip
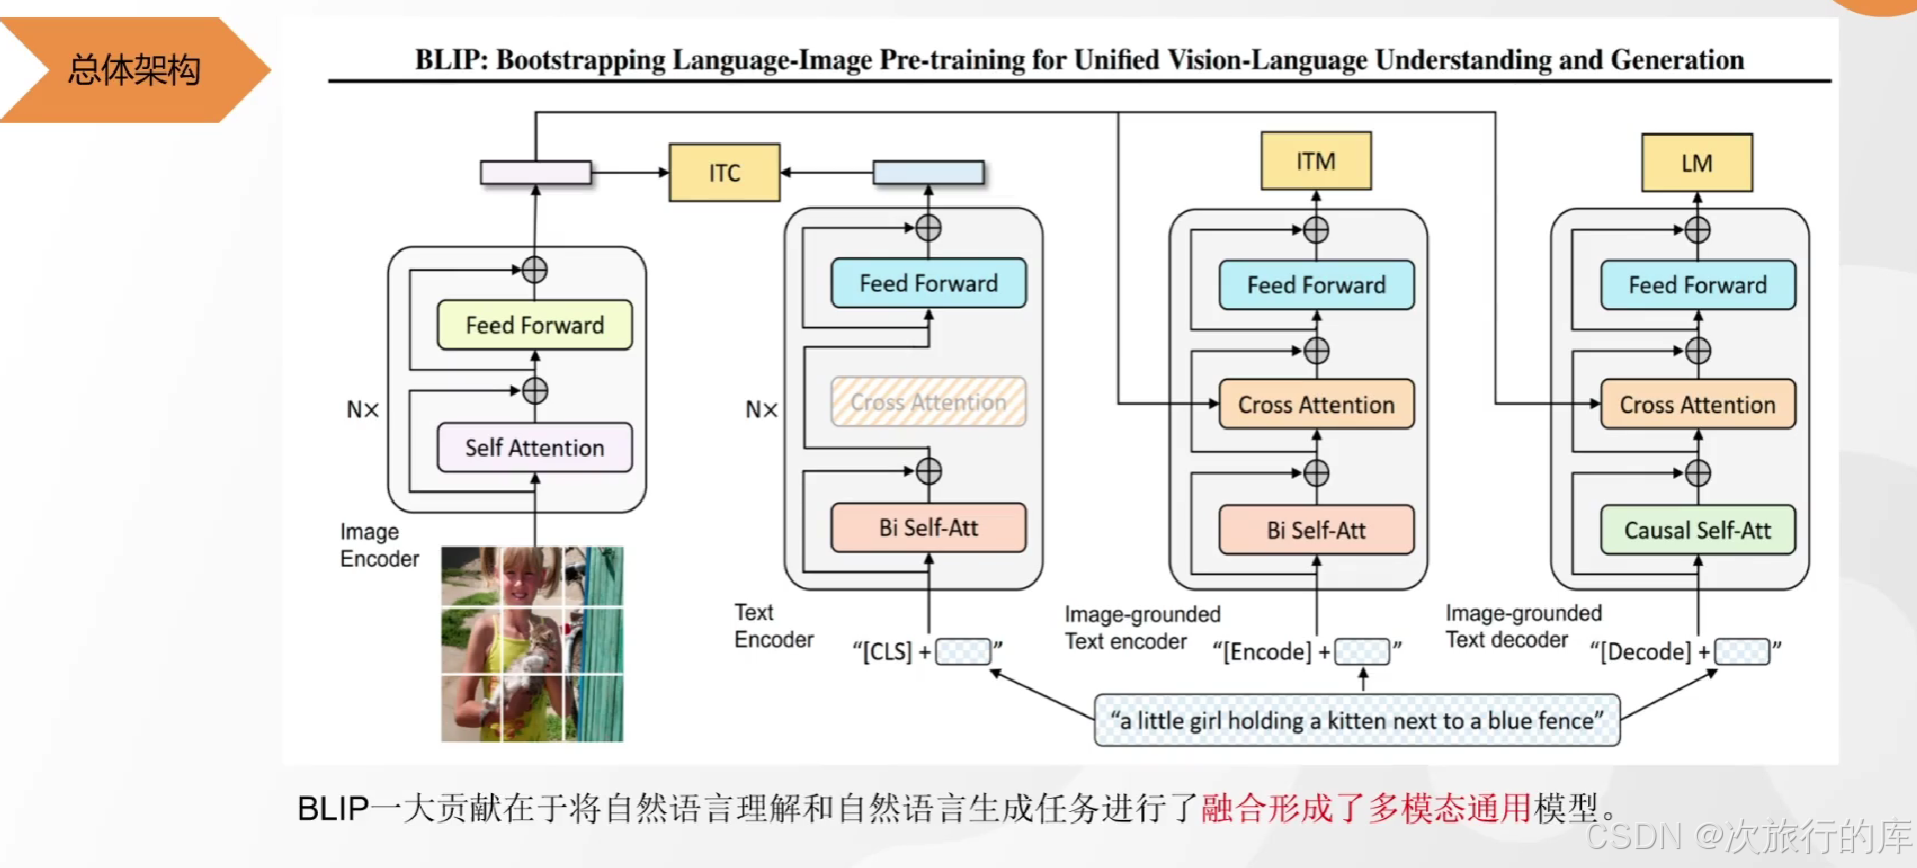
1、相对于clip,增加了自然语言生成能力。

2、先给图片分块编码器得到包含图片特征的向量

3、三塔模型。结构相似的模型跑了三次,颜色相同的模块共享参数。

4、cross attention?

5、ITC(对比学习)

6、ITM(二分类任务)最重要的是构建负样本,如果负样本太过于简单,比如图是小女孩,文字描述是一个动物,那么对于模型来说太过于简单,它能力得不到提高。那么解决办法有,把分类错误的样本整理为负样本,因为分错了说明是比较难的。

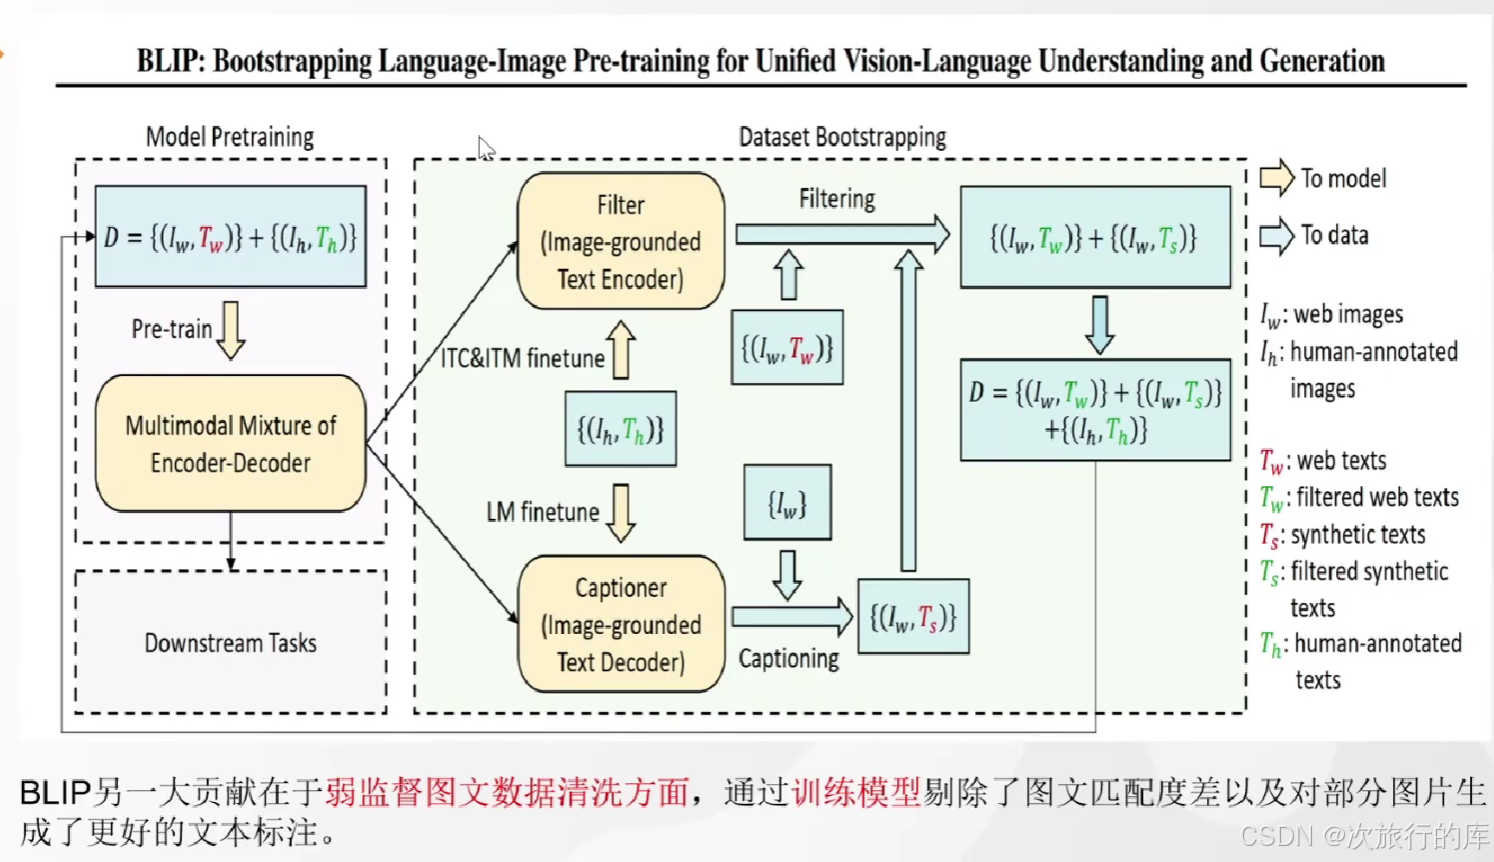
下图是bootstrap对于弱监督数据的一个清洗。
3、blip2
4、visualglm支持图像、中英文的多模态对话模型解读与本地化部署

5、VideoGLaMM

mbzuai-oryx/VideoGLaMM: A Large Multimodal Model for Pixel-Level Visual Grounding in Videos

VideoGLaMM 是一种大型视频多模态视频模型,能够实现像素级视觉接地。该模型响应来自用户的自然语言查询,并在其生成的文本响应中交织时空对象掩码,以提供对视频内容的详细理解。VideoGLaMM 无缝连接三个关键组件:大型语言模型 (LLM);双视觉编码器;以及时空像素解码器。双视觉编码器分别提取空间和时间特征,这些特征共同传递给 LLM 以输出富含空间和时间线索的响应。这可以通过对我们提出的基准接地对话生成 (GCG) 数据集进行端到端训练来实现,该数据集具有 38k 视频 QA 三元组、87k 对象和 671k 细粒度掩码。

6、LLM2CLIP:该模型使用LLM的能力来提高CLIP的表现,通过结合LLM的语义理解和CLIP的视觉特征提取能力,实现了更高效的多模态信息融合和处理。

7、TAP-VL:这是一个将OCR视为单独模态的视觉理解大模型,能够高效地处理文本和图像信息,特别是在视觉问答(VQA)等任务中表现出色。

8、Mixture-of-Transformers(MoT):这是一个稀疏的多模态transformer架构,用于减少pretraining阶段的计算消耗,提高了模型的训练效率和性能。

9、BendVLM:该模型在测试时能够减少visual embedding bias,提高了多模态模型的泛化能力和准确性。

相关推荐
明志数科1 小时前
具身智能产业基础设施换挡:从算力本体到数据层的技术逻辑
人工智能·机器学习
tellmewhoisi4 小时前
机器学习:集成学习1(思想,Bagging,Boosting,随机森林和boosting之adaboost)
机器学习
码农幻想梦6 小时前
机器学习(一)
机器学习
ZPC82106 小时前
YOLO26 识别串番茄果梗
人工智能·深度学习·算法·机器学习
Rocky Ding*7 小时前
【三年面试五年模拟】2026-09-16 字节跳动 Agent 秋招一面全解析:从 Harness、记忆与并发到算法题的系统化解析
论文阅读·人工智能·深度学习·机器学习·aigc·ai-native·ai agent
有Li8 小时前
【AI答疑】MR数据预处理步骤
人工智能·笔记·算法·语言模型·医学生
干就完事了8 小时前
机器学习-音乐艺人流行趋势预测
人工智能·机器学习·阿里云
zzm6289 小时前
从 ERM 到 DRO:机器学习目标函数优化中的公平性保障
机器学习·icml·算法公平性
龙腾AI白云9 小时前
大模型的幻觉怎么治
人工智能·机器学习·知识图谱