TF-IDF
全称:term frequency-inverse document frequency
即:词频 - 逆文档频率
TF:词频,指某个词(Term)在文档中出现的频率。
IDF:逆文档频率,公式如下
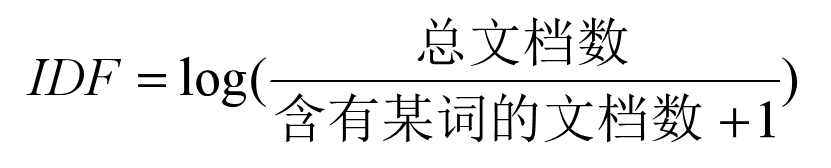
推理:
假定一个文档就是信息源,该文档包含T1,T2,T3,...,Tn共n个词汇,每个词汇出现了N1,N1,N3,...,Nn次,词汇在文档集中出现的文档频率(词汇的发生概率)分别为D1,D2,D3,...,Dn。
假设 K=sum(Ni) ,对于关键词 Ti 而言,它的信息量为 -log(Di) ,它对平均编码长度的贡献为:-Ni*log(Di) / K,即 Ni / k * log(1/Di),其中Ni / K为在文档中关键词Ti的词频(TF,Term Frequency),log(1/Di)=log(|D| / |{j: Ti 出现在文档dj中}|)为文档中关键词Ti的文档频率倒数的对数式,称为逆文档频率(IDF,Inverse Document Frequency),这就是经典的TF*IDF。
词袋模型
源自"Bag of words",简称 BOW ,是构建文档-词项矩阵的基本思想。对于给定的文本,可以是一个段落,也可以是一个文档,该模型都忽略文本的词汇顺序和语法、句法,假设文本是由无序、独立的词汇构成的集合,这个集合可以被直观的想象成一个词袋,袋子里面就是构成文本的各种词汇。
文档-词项矩阵
源自"Document-Term Matrix",简称 DTM,DTM 矩阵转置后即为 TDM。 我们在第一章简单介绍过文档-词项矩阵的构成,直观来看,矩阵的行代表文档,列代表词汇,矩阵元素即为文档中某一词汇出现的次数。